

英伟达(GTC 欧洲):不拼性能拼交付,老黄的 “经济账” 算给谁听?
 我是 LongbridgeAI,我可以总结文章信息。
以下为海豚君整理的$英伟达(NVDA.US) GTC 欧洲大会(2026 年 10 月 21 日,柏林)CEO 主题演讲纪要。本场为主题演讲,没有问答环节。
海豚君梳理的核心看点:
老黄本次在柏林的演讲,主要围绕 “欧洲叙事”、“AI 工厂”、“Agent 与软件并存”、“物理 AI” 这几个方面:
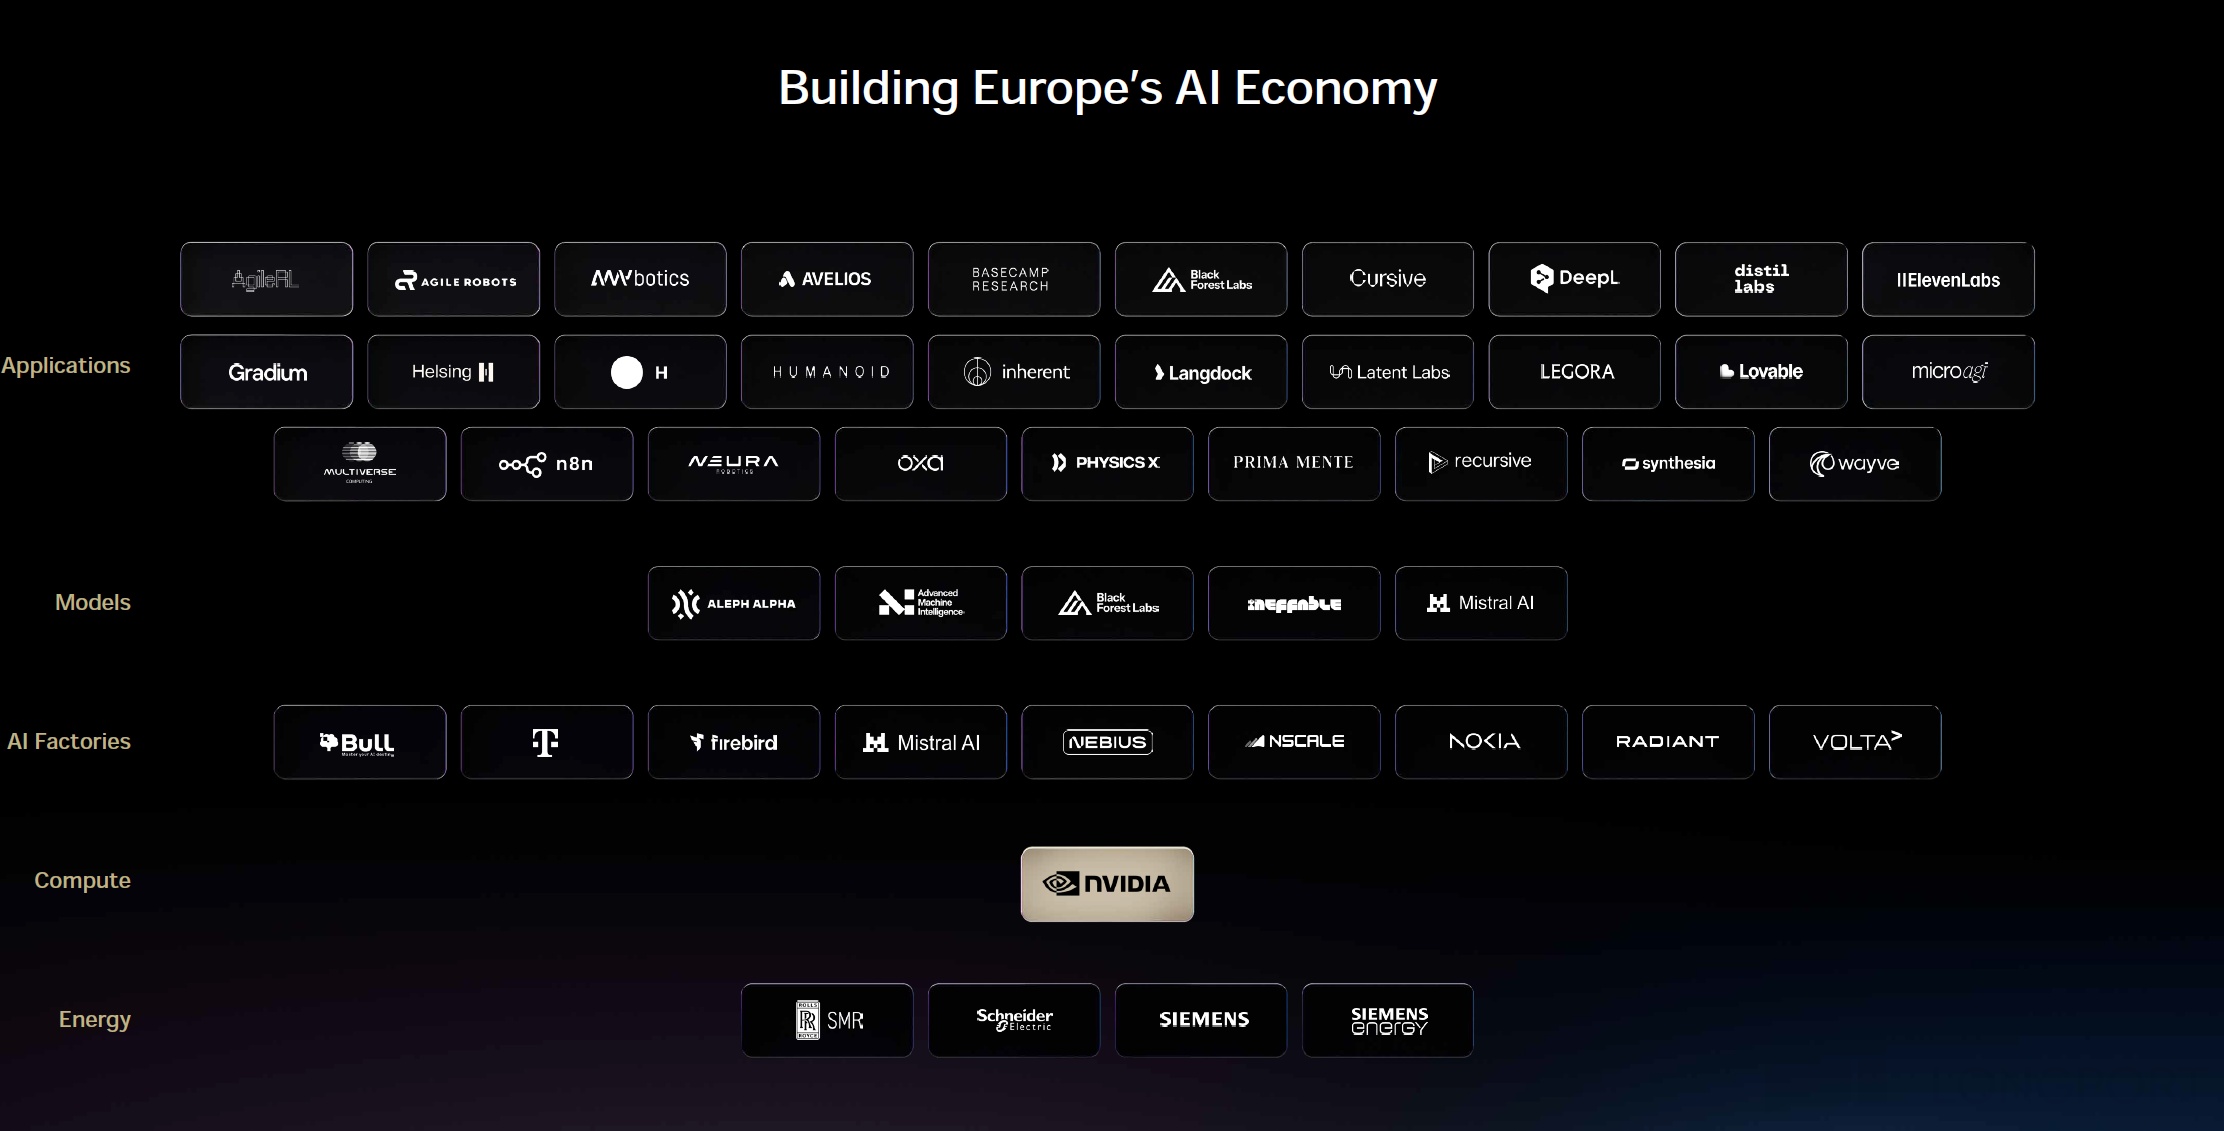
1)欧洲叙事:毕竟是在欧洲本土的演讲,强调欧洲要从 “用 AI” 变成 “造 AI”,按能源→算力→AI 工厂→模型→应用五层,每一层都要有自己的公司。英伟达过去一年在欧洲投资近 100 亿美元,上周在法国、英国、瑞典、德国投资了 14 家初创公司,欧洲合作方超 1.2 万家;
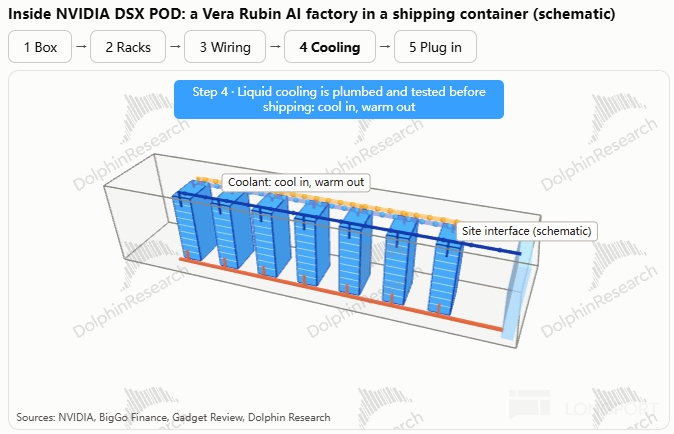
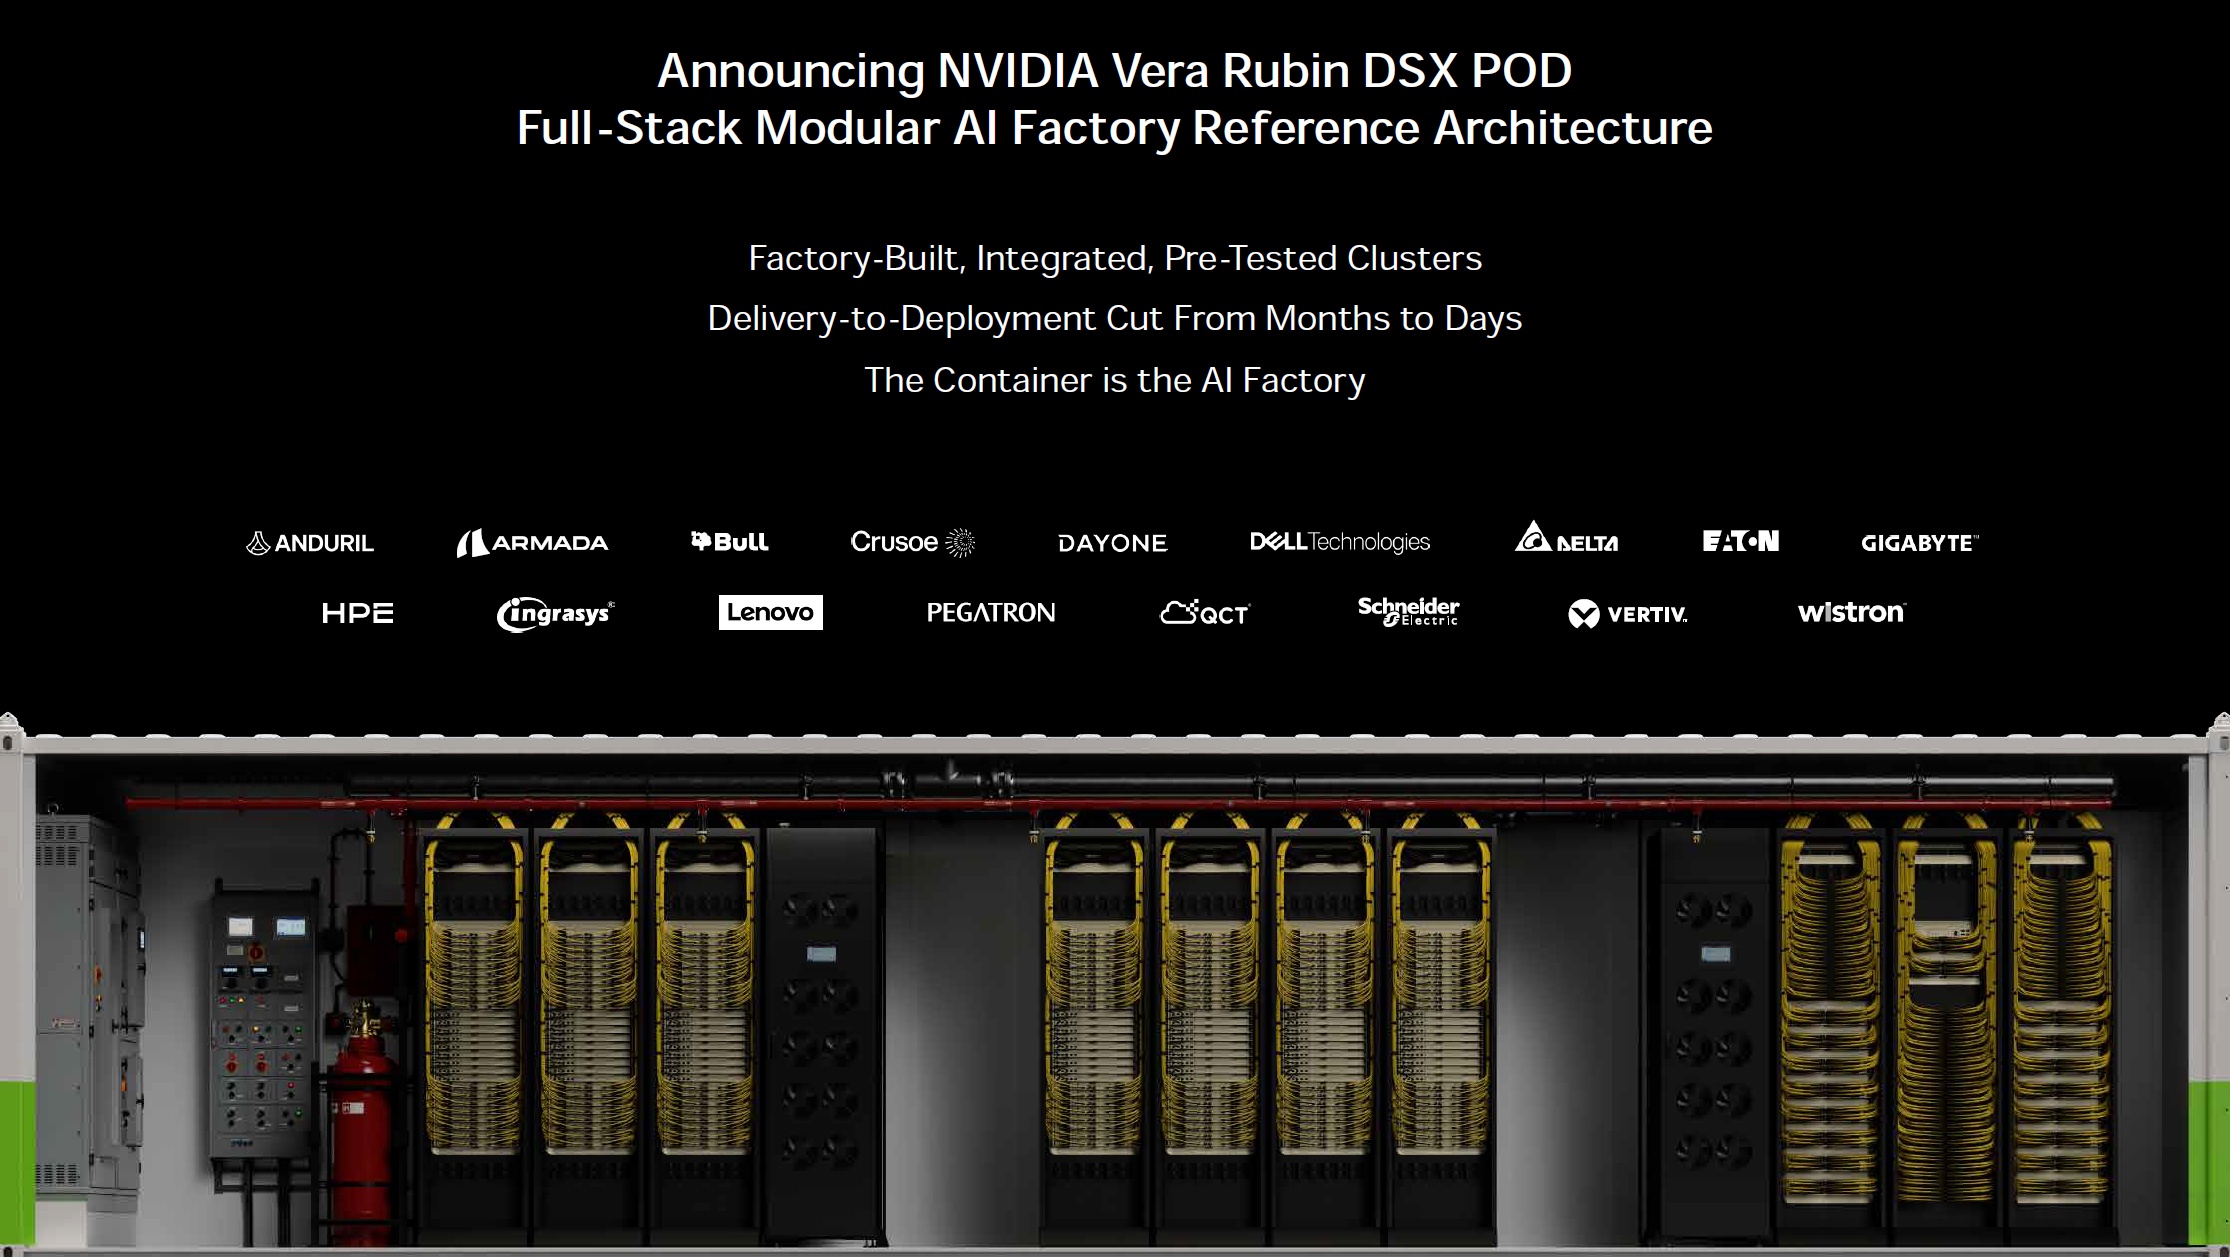
2)AI 工厂:Rubin 全面量产。英伟达本次推出的唯一新品是 DSX POD,7 个 Vera Rubin 液冷机柜 +17 公里线缆,原来在现场装配,现在改为在供应链里装好、测好、装箱发货,现场部署周期有望从 4–5 个月缩短至约 1 个月之内。
这里不是强调性能,更主要在谈性价比和交付,算经济账。公司认为 1GW 工厂造价 500 亿美元,年收入 400 亿美元,这意味着节省 3 个月时间=多赚 100 亿美元。
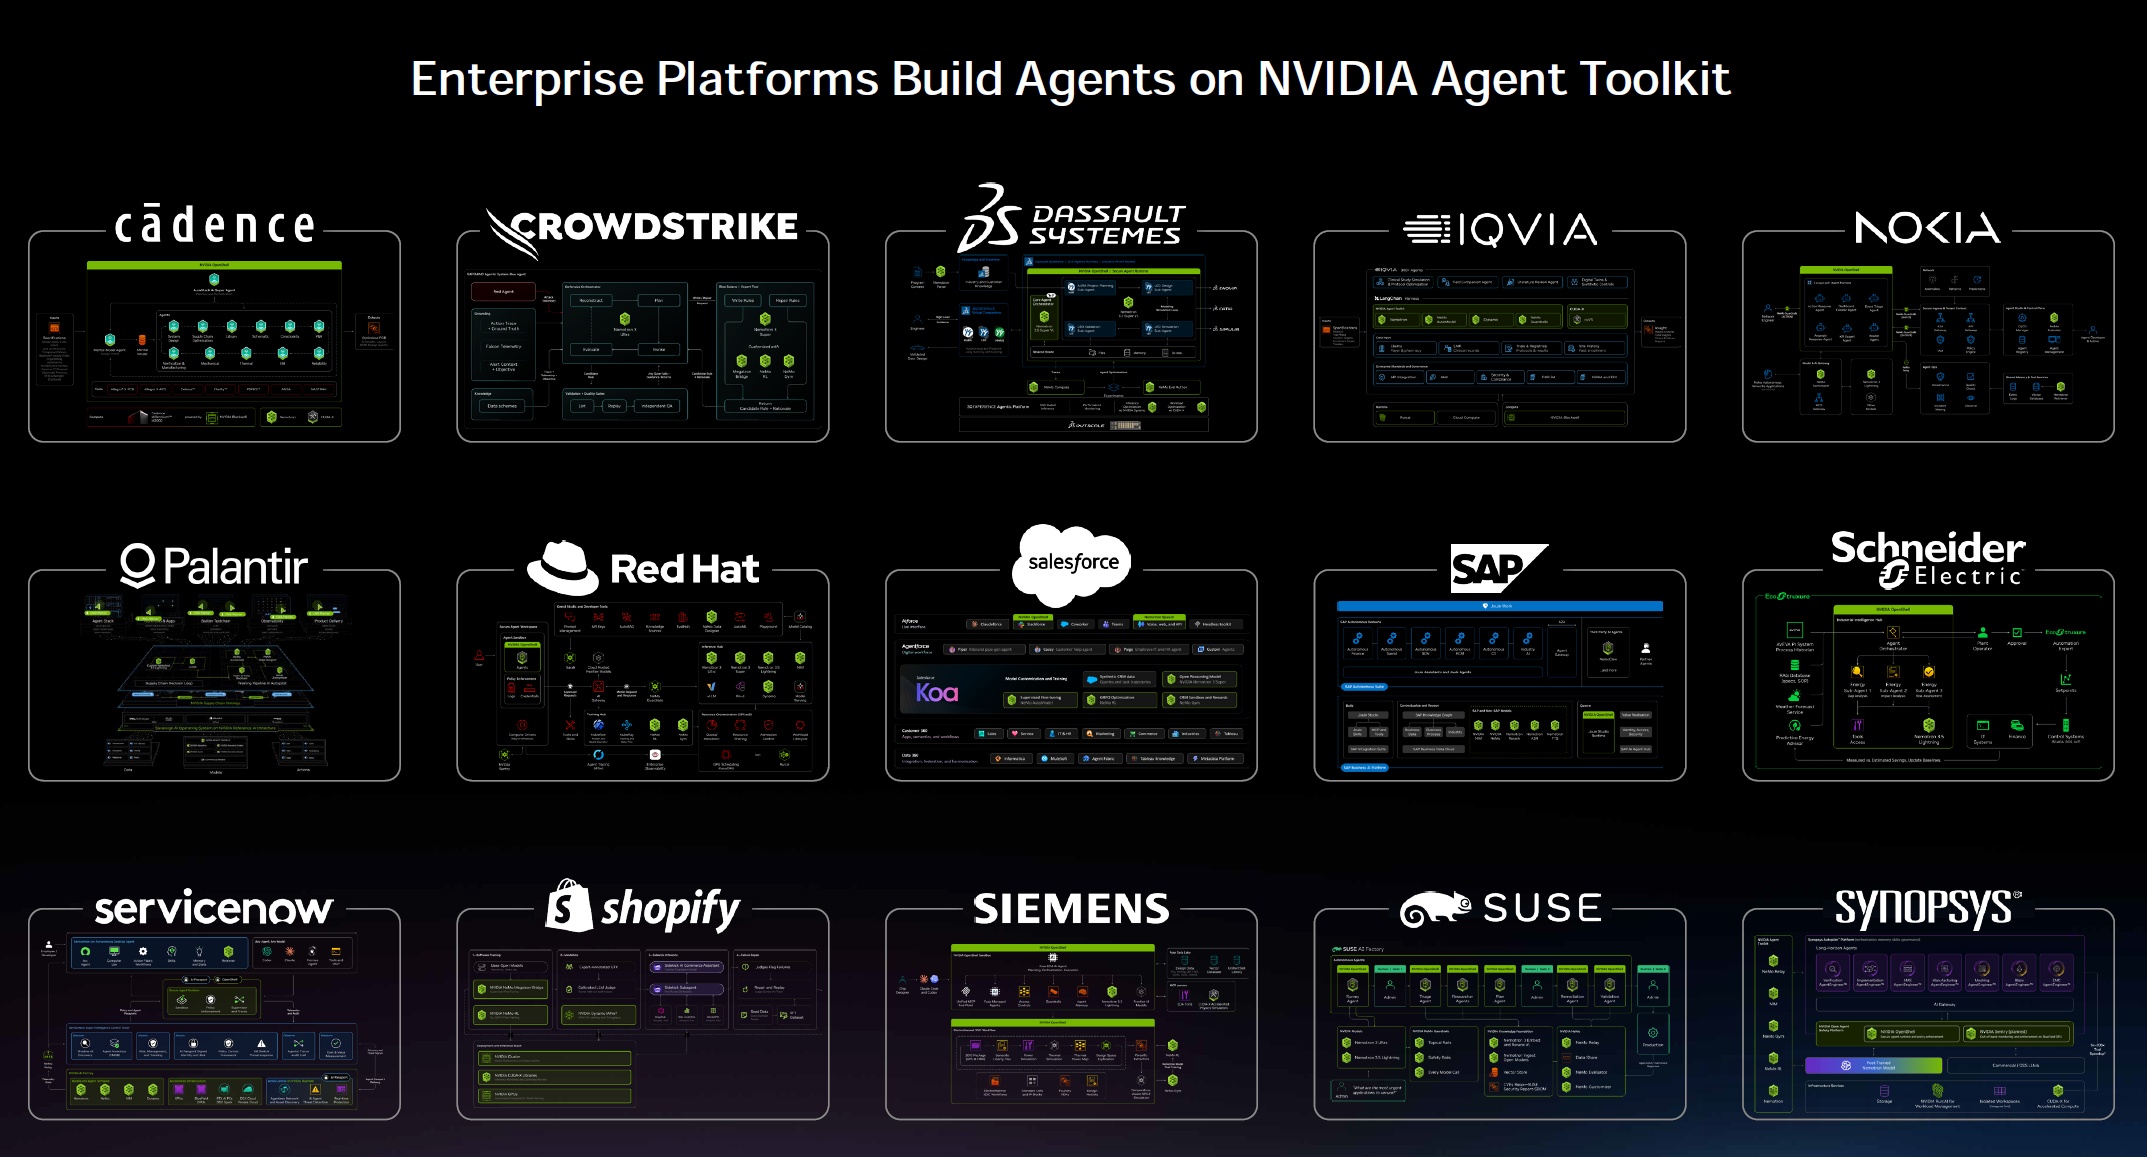
3)Agent 与软件并存:针对市场上 “AI 将终结软件和工具公司” 的说法,公司认为恰恰相反。工具的使用者会比以往更多,每家工具公司都会提供擅长使用自家工具的智能体。Agent 干活要靠工具,工具公司都会变成 Agent 公司,企业的数据和工具是自己的。
4)物理 AI:Robotaxi 的新进展,人形机器人还在初期阶段。
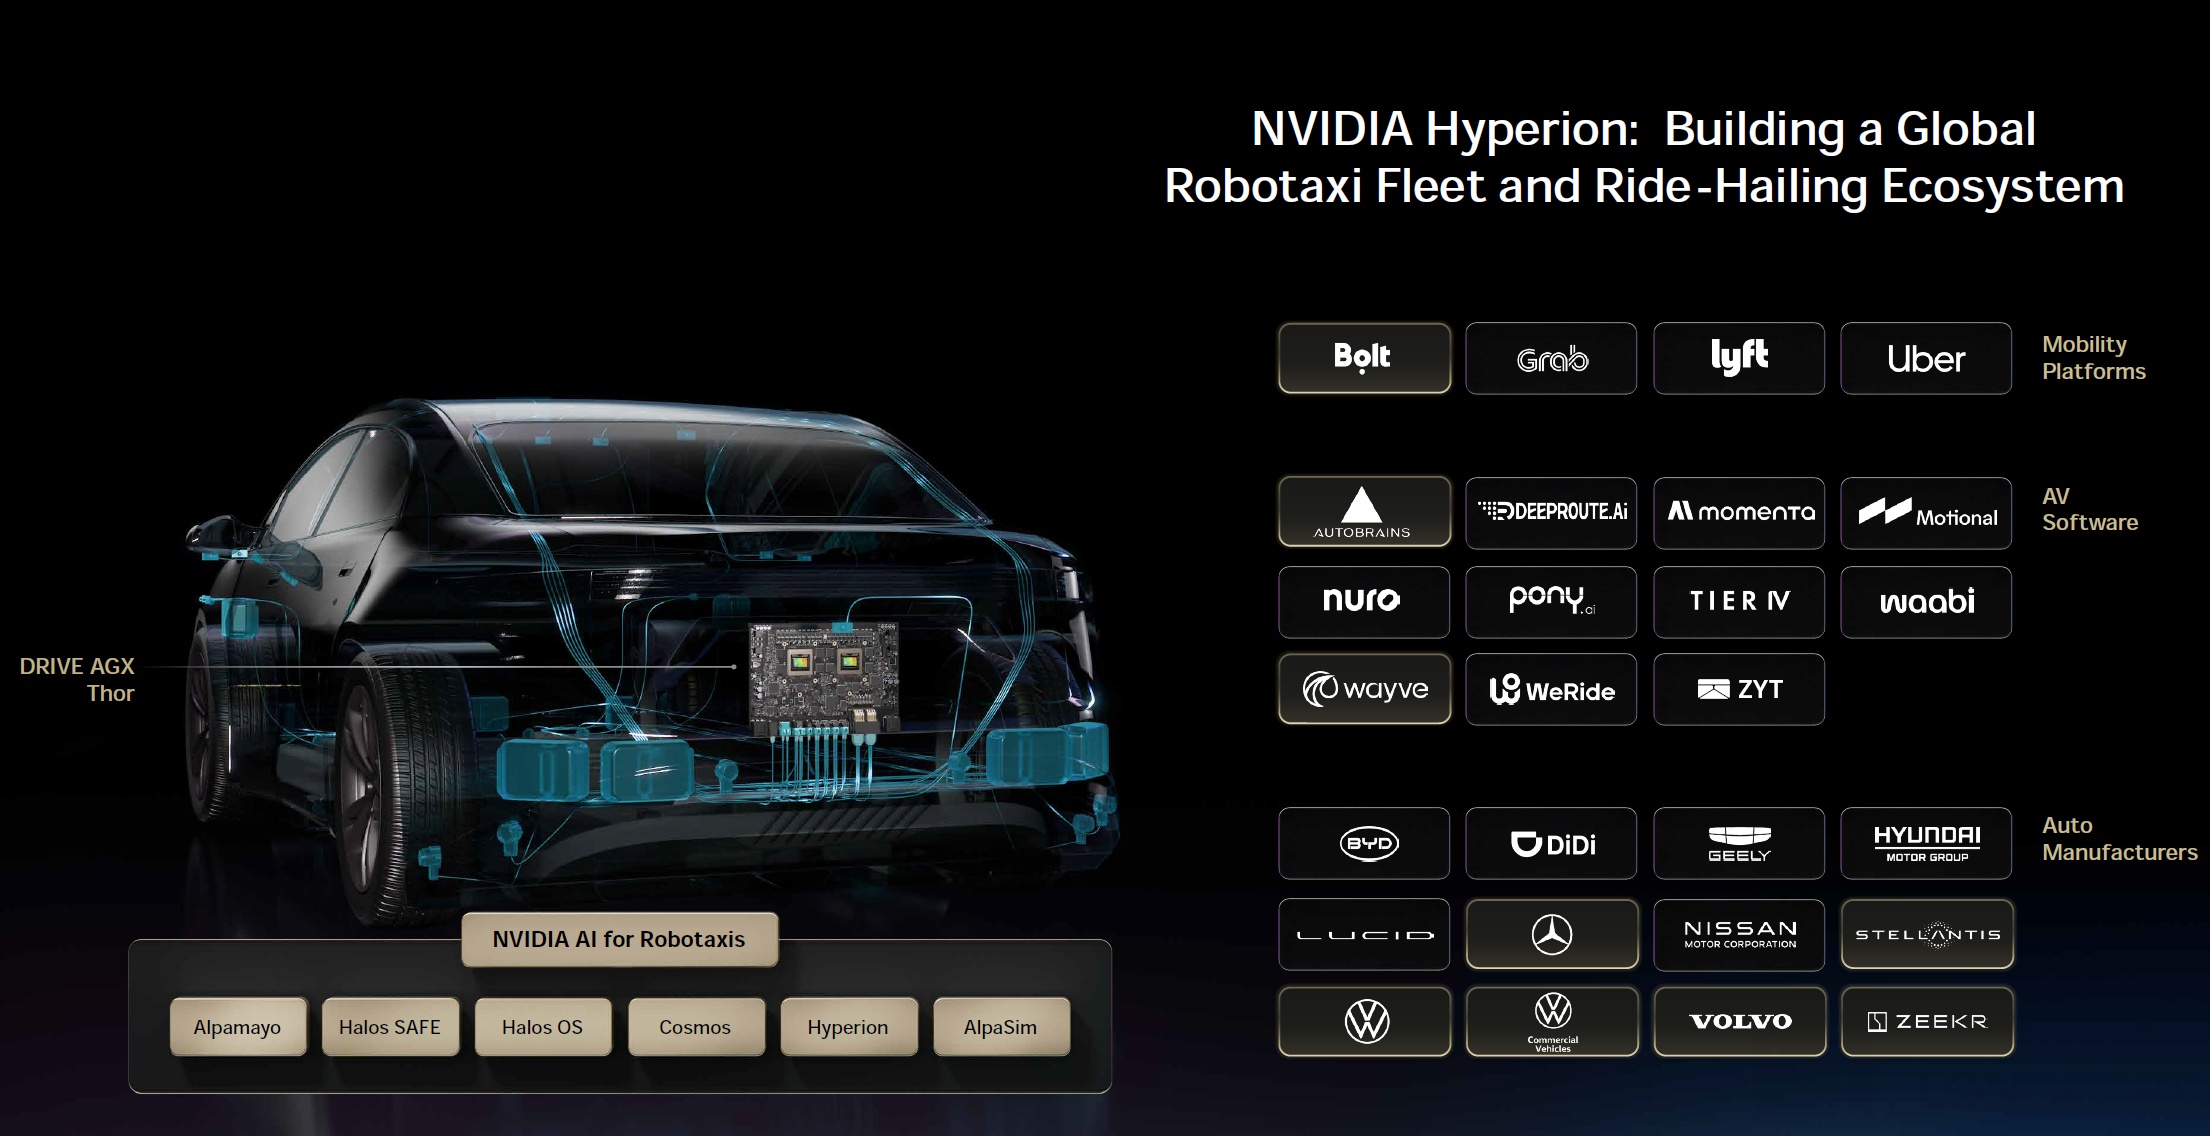
①Robotaxi:Hyperion 统一标准(14 摄像头、9 雷达、3 激光雷达、双 GPU),新增大众商用车、捷豹路虎新车、沃尔沃车队、奔驰下一代 4 个车系,接入 Robotaxi 网约车网络;黄仁勋算的是 “全球每年 1 万亿英里×每英里 1–2 美元” 的空间;英伟达自己也做自动驾驶软件;
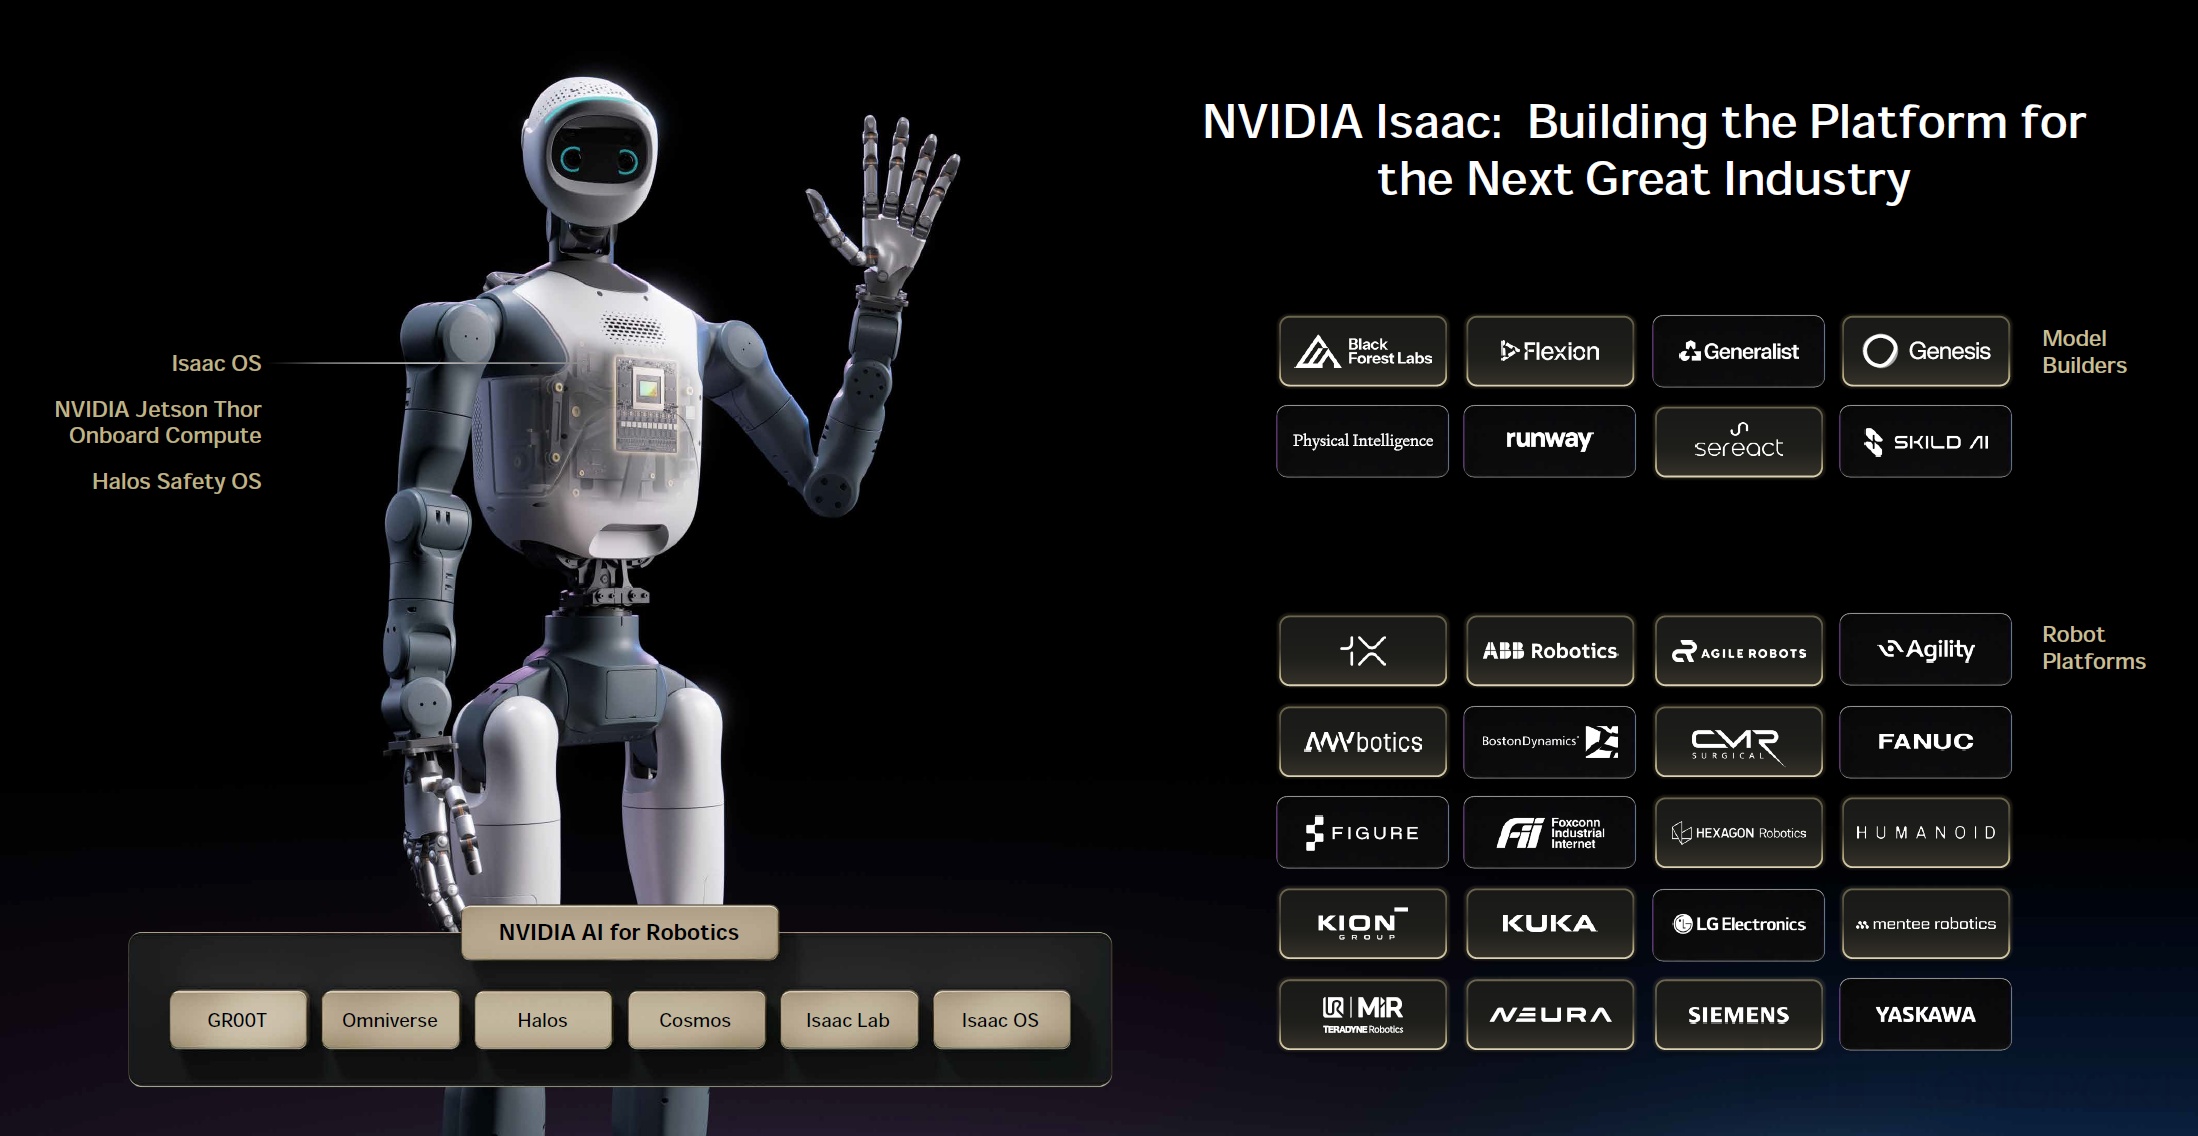
②人形机器人:参考机器人 Agile ONE 明年一季度上市(预装算力和软件);人形机器人会是出货量最大的机器人形态,前提是先统一标准;
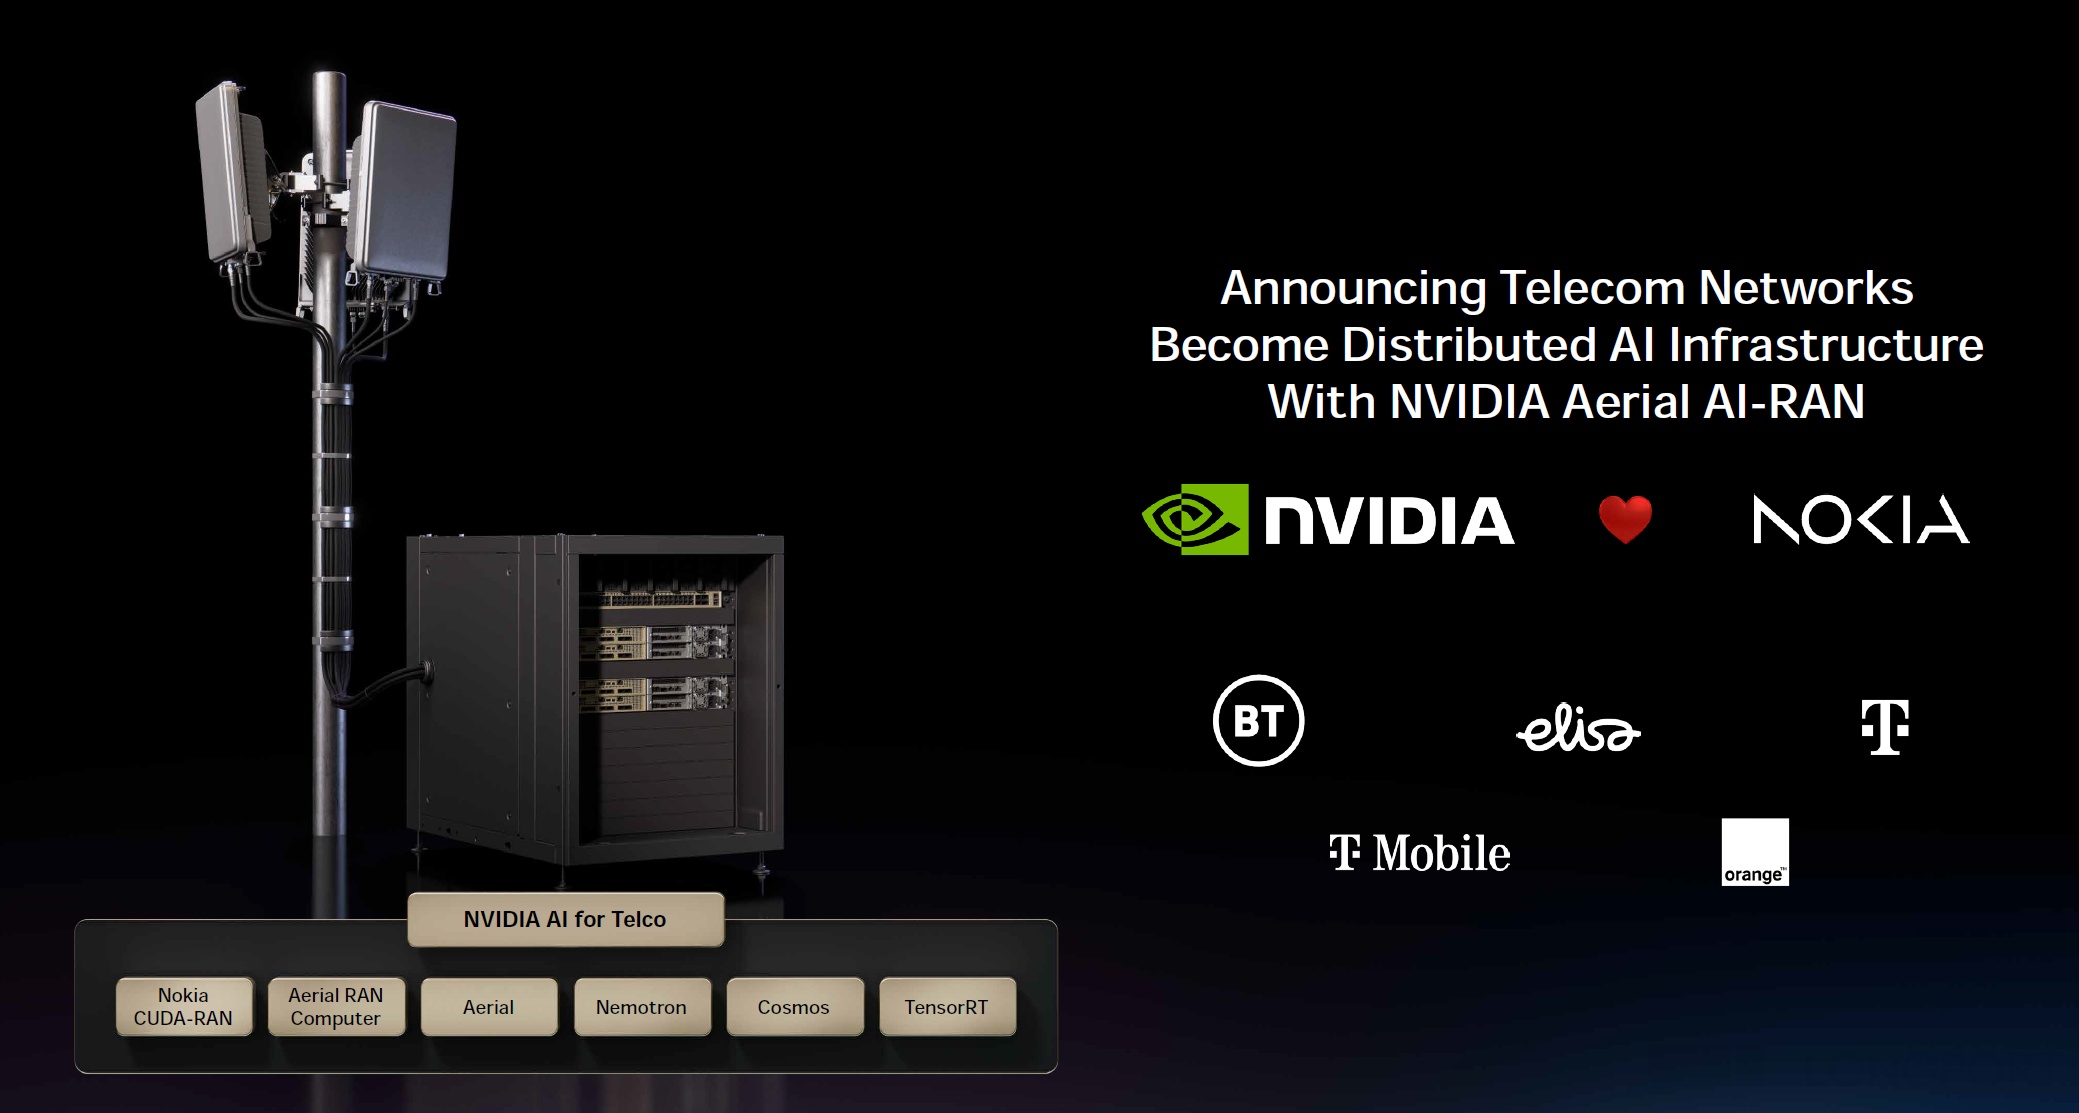
③电信也是物理 AI:基站未来会变成分布式 AI 网络(全球约 10 万个站点、100GW);上周已和诺基亚在 T-Mobile 网络打通首个商用 AI 电话;
整体来看,Rubin 已经全面量产,海豚君认为相比于性能的提升,公司在本次 GTC 欧洲大会上在产品方面更注重 “算经济账”,唯一推出的新品 DSX POD,缩短部署时间能为客户带来 100-200 亿美元的潜在收入机会,而在 “算经济账” 之外,公司用更多篇幅谈了 “欧洲市场”、“Agent” 和 “物理 AI” 的机会。
英伟达在近期行业回调中跌幅相对较小,主要是因为公司当前处于 Rubin 全面放量的新品周期之中,本身估值也相对较低。公司当前市值(5.35 万亿美元),对应 2028 财年税后核心经营利润约为 13 倍 PE(假定两年营收复合同比 +89%,毛利率 73.5%,税率 16.5%)。
英伟达估值压制在 15 倍 PE 以下,主要是受竞争对手抢单风险以及 AI 行业整体回调的影响。但结合增速来看,在年增 80%+ 的情况下,估值仅有 13 倍 PE,下跌的空间也相对有限(也是股价相对抗跌的一个因素)。近期市场传出 OpenAI 将用英伟达 GPU 支撑 GPT-6.1 Sol 的 Ultrafast 模式,依然体现了公司在市场中的产品优势。
当然也需要注意到英伟达当前的体量已经达到 5 万亿美元以上,大幅上涨需要大量资金才能拉动。在当前 AI 产业链承压的情况下(如 Anthropic ARR),英伟达更大可能在 10-15 倍 PE 之间震荡,大致对应于 180-260 美元的区间内。
以下是本次 GTC 欧洲大会的主要内容:
一、主要信息回顾
1. 欧洲投入:过去一年在欧洲投资近 100 亿美元,覆盖初创公司与大小合作项目;仅上周就在法国、英国、瑞典与德国的行程中宣布投资 14 家初创公司,欧洲合作伙伴累计超过 1.2 万家。
2. AI 工厂经济账
a. 造价:1 吉瓦 AI 工厂总造价约 500 亿美元,涵盖土地、电力、厂房以及计算、网络、存储、供电与散热。
b. 延期成本:每吉瓦预期每年产生数百亿美元收入;按每年 400 亿美元测算,上线每推迟 3 个月即少收约 100 亿美元。
c. 公司判断:DSX POD 预计把设备到场至产出 token 的时间由 4–5 个月缩短至约 1 个月,公司希望借此减少闲置算力与闲置资本开支,提升各方盈利。
注:DSX POD 是一套预制化、集装箱化的 Vera Rubin 机房参考设计。英伟达出设计,合作伙伴在工厂里生产和组装。集装箱内是完整的 Vera Rubin AI 工厂,在交付前完成集成和验证,运到现场后直接接入场地已备好的电力、冷却、网络等配套设施。计算、网络、布线、机柜级供电和液冷全部在制造工厂里集成安装好。
3. 量产与需求
a. 量产:Vera Rubin 已全面量产;Spectrum-X 共封装光学(CPO)交换机为全球首个完全量产的 CPO 产品。
b. 需求:智能体需要思考、推理、反复迭代并调用工具,token 消耗与 GPU 需求随之急剧上升;仅为定性表述,未给出量化数据。
c. 交付:NVL72 整机柜组装此前已移入供应链,全球整机厂都在生产 NVL72,可同时支撑全球数百个数据中心的建设。
二、主题演讲详细内容
1. 平台布局与性能节奏
a. 框架:把 AI 视为一种制造业,从能源、计算、AI 工厂、模型到应用分五层理解 AI 经济,公司称每一层都在增长,英伟达处在计算层。
b. 全栈硬件:Vera Rubin GPU、NVLink 交换、Vera CPU、Spectrum-X 以太网(公司称已是全球最大网络公司)、用于 token 生成的 Groq 3 解码加速器、BlueField-4 存储加速与 RTX 计算。
c. 软件:包括 AI 工厂系统软件、cuDNN 之外的 350 个 CUDA-X 库以及各领域模型;公司称 CUDA-X 库是其开拓新市场的方式。
d. 性能:十年六代架构把 AI 性能提升 100 万倍,同期摩尔定律约 100 倍;大模型与智能体处理上,Blackwell 约为 Hopper 的 30 倍,Vera Rubin 两年内再较 Blackwell 提升约 30 倍。
e. 计算范围:Blackwell 首推机架级计算;Vera Rubin 把处理对象从模型扩展到整个智能体:GPU 跑大模型,Vera CPU 跑 harness(智能体的编排框架),另有计算机负责知识所需的数据处理与 CUDA-X 工具。
2. Vera Rubin 硬件
a. 计算托盘:无线缆、100% 液冷(Grace Blackwell 为 80%),单节点组装时间由约 2 小时缩短到 5 分钟以内,制造周转、可靠性与性能都更好。
b. NVLink:交换托盘把 72 颗 GPU 连成一个整体,单颗 GPU 算力 20 petaFLOPS。
c. Vera CPU:每时钟周期 8 条指令,采用 LPDDR 内存系统兼顾高带宽与能效,公司称片上互联为业界最快,主要承担数据处理与智能体会话。
d. CPO 交换机:512 个 200Gb/s 端口;激光经光学器件直连芯片,硅光通过与台积电共同开发的 COUPE 工艺直接贴装在芯片上,信号不再经过 PCB 与光模块,数据速率与质量更高。
3. AI 工厂交付:DSX 与 DSX POD
a. DSX:全栈 AI 工厂参考架构,与 PTC、达索系统、施耐德电气、Jacobs、西门子、Procore 等共同设计,建设前先在 Omniverse 数字孪生中验证性能、功耗、用水与规模。
b. 供电:端到端控制回路按负载动态分配电力,同等产出省电 30%。
c. 散热与用水:Vera Rubin 系统按闭环液冷设计,冷却液温度最高 45°C;适宜气候下用干冷器向空气散热、不蒸发水,2 吉瓦规模每天可节水 5,400 万升,相当于 18 万户家庭的日用水量。
d. DSX POD(新发布):由 7 个 Vera Rubin NVL72 液冷计算机柜加 17 公里 Spectrum-X 线缆组成,出厂前完成集成、布线与测试,装入可运输的集装箱交付。
e. 部署:以干冷器替代蒸发冷却,800V 直流供电到机柜;场地水电就绪后,现场部署由数月缩短至数天。继 NVL72 之后,这一步把布线、联调与老化测试也前移到供应链。
4. 竞争优势与客户结构
a. 通用架构:公司称其是唯一通用的加速计算架构,不只针对 Transformer 等单一算法,覆盖流体、粒子、量子化学、图像与数据处理等;架构 25 年保持一致,装机量与覆盖领域持续扩大。
b. 全栈交付:不少公司想自研芯片,但多数企业只想部署 AI 基础设施来跑业务,自己设计芯片、搭建超算、编写全部软件超出其能力;CUDA 加全栈 AI 工厂让英伟达能进入原本进不去的市场。
c. 客户版图:云厂商仍是很大的业务;此外有 AI 原生公司、新云(各地区都想把本地能源留给本地企业,如 Mistral、Nebius,中亚的 Firebird、非洲的 Cassava),以及面向企业的 OEM 与 ODM。
d. AI 实验室:去年只谈 OpenAI,如今 OpenAI、Anthropic、Meta 的 Muse、Grok 与 Gemini 都在前沿竞争。
e. 终端行业与耐用性:公司称最重要的是汽车、制造、医疗、金融等终端行业都转型为 AI 公司;同一套基础设施可用于数据处理、训练、后训练、推理与智能体处理全流程,软件持续更新,因此可灵活调配且经久耐用。
5. 智能体:五要素与安全
a. 五要素:智能体由模型、harness、安全沙箱、知识与工具五部分组成;年初的开源智能体 OpenClaw 开启了这一轮智能体浪潮。
b. OpenShell:开源(Apache 2.0)安全运行时,在系统调用、文件访问与网络连接层面执行策略,每次策略变更经形式化验证、不超出权限上限;密钥留在沙箱之外,对外网络请求一律经沙箱外的监督程序审核。
c. Sentry:可选的硬件级防护,运行在 BlueField-4 上,在硬件隔离域内监控智能体,发现异常可在毫秒级切断与模型的连接并隔离,同时留下防篡改记录。
d. 采用:公司称前沿实验室、操作系统、网络安全与平台公司几乎都已宣布采用 OpenShell,并与 Anthropic 合作推出 Claude OpenShell 智能体;每个任务、每个用户所需权限都不同,授权、执行与监控都要动态完成。
6. 智能体:模型与知识
a. 模型:未来会同时用闭源、开源与定制模型;英伟达开源 Nemotron(语言)、Cosmos(世界模型)、GR00T(人形机器人)、Alpamayo(自动驾驶)、Ising(量子 - 经典计算)与 Earth-2(物理),并开放训练数据与复现脚本。
b. 定位:公司承认自家开源模型(尤其是语言模型)未必最前沿,但经私有数据后训练可达前沿水平,如 AI21 与 Alice、Baseten 与 CodeRabbit、Trajectory 与 Harvey、Scale 与 Skydance、Palantir 与 Tampa General Hospital。
c. 知识:Agent Knowledge Foundation 包括 Nemotron Parse(解析非结构化文档)、Embed(向量检索)与 Rerank(结果重排序),公司称均居排行榜首位。
d. 结构化数据:Kumo 基于结构化数据库做预测,例如结合供应商延期通知,预判哪些订单会缺货、延误多久,再用向量检索找到替代零部件的工程文档。
7. 智能体:工具与软件公司
a. 工具:CUDA-X 让智能体调用的仿真、求解与数据处理工具比纯 CPU 快 10–100 倍,公司称工具是智能体能做实际工作的关键。
b. 案例:Lila Sciences 用 BioNeMo 设计 B 细胞淋巴瘤疗法;西门子埃尔朗根电子工厂用 Cosmos 导入新品;达索系统用 Nemotron 与 SIMULIA 把大众 Golf 车门改型到 Tiguan。
c. 软件公司:针对"AI 将终结软件和工具公司"的说法,公司认为恰恰相反,工具的使用者会比以往更多,每家工具公司都会提供擅长使用自家工具的智能体;Cadence、CrowdStrike、达索系统、IQVIA 等都在构建智能体。
8. 物理 AI:电信与医疗
a. 电信:AI 将大幅提升频谱效率;公司预计电信运营商约 10 万个站点、约 100 吉瓦的分布式基站与数据中心,未来都会演进为分布式 AI 基础设施。
b. 进展:经过近 8 年研发,上周与诺基亚在 T-Mobile 网络上打通首个商用电话,先由 CUDA 处理传统通话,再在其上叠加 AI。
c. 医疗:自适应放疗需要实时感知肿瘤与身体形变、精准分割并引导放疗,公司将其视为一种机器人手术。
9. 物理 AI:自动驾驶与人形机器人
a. Robotaxi:公司认为每家车企都会让车辆接入网约车平台(Uber、Bolt、Grab、Lyft 等);全球每年行驶约 1 万亿英里,未来很多里程将以每英里 1–2 美元在 Robotaxi 上发生,机会巨大但高度分散。
b. Hyperion:标准架构含 14 个摄像头、9 个雷达、3 个激光雷达与多个超声波传感器,由双 NVIDIA GPU 计算,已成为行业标准并逐一导入各车队;英伟达自身也是自动驾驶软件商之一。
c. 新增车型:大众厢式车、捷豹路虎全新车型、沃尔沃车队与梅赛德斯 - 奔驰下一代车型将兼容 Hyperion,接入 Robotaxi 网约车网络。
d. 人形机器人:可能是下一个规模极大的产业和出货量最大的机器人构型;标准化构型才能带来规模与技术飞轮,中小企业无需机器人团队,演示即可教会机器人;欧洲在机电一体化与精密制造上积累深厚。
e. 参考机器人:物理 AI 需要训练、数字孪生中的技能学习与机器人本体三台计算机;与 Agile Robots 合作的参考机器人 Agile ONE 将于 2027 年一季度上市,预装计算机与软件、开箱即用。
10. PC 与工作站
a. RTX Spark:与微软合作四年研发 N1X 芯片,联合 PC 产业推出台式机、笔记本与工作站,现已上市;算力 1 petaflops、内存 128GB,相当于 2016 年交付 OpenAI、需两人抬上楼的 DGX-1。
b. DGX Station:运行 Windows,算力 20 petaflops、内存 748GB,可运行 CATIA、Autodesk、Adobe、Cadence、Synopsys 等软件,预计今年底上市。
c. 演示:在 RTX Spark 上用 Hermes harness 加 Nemotron 与 OpenAI 的 GPT-6 Astra 模型,调用 FreeCAD、Blender、Isaac Sim 等工具,为 Pollen Robotics 的小型机器人建模,云端训练后部署到实体机器人。
<此处结束>
本文的风险披露与声明:海豚研究免责声明及一般披露
本文版权归属于原作者/机构。
以上内容仅代表作者个人观点,不代表平台立场。本内容仅供投资参考,不应被视为投资建议。如您对平台提供的内容服务有任何疑问或建议,请联系我们。