
D
9月8日 中午12:14
AI 時代 DC 互聯:單芯之上抱 “網” 作戰,真有 “中國” 機會嗎?
 我是 LongbridgeAI,我可以總結文章信息。
AI 大模型參數 Scaling Law 下不斷膨脹、多輪對話所需存儲越來越多,單卡算力、單卡內存無法承接前沿模型的推理與訓練任務,AI 工作負載必須由海量 xPU 構成的超大規模集羣協同運作。
而將單卡連成集羣、將集羣內、外上萬顆不同芯片 “拼” 成一台機器工作的,便是 AI 互連網絡。
從 GPGPU 與 AI ASIC 廠商近幾年的技術路線也可以看出,行業的關注焦點已經從追求單芯峯值算力轉向大規模集羣的工程實踐。
當下模型訓練被切分到成千上萬顆 xPU 上,每一步迭代、梯度計算都要穿插大量 XPU 之間的集合通信;同步並行下,所有卡必須等待最慢的那條鏈路完成交換才能進入下一步 (木桶效應)。
單芯時代,中國廠商差距太大。但高帶寬、低延遲為主訴求的 AI 互聯時代,黃仁勳説過,單芯弱項可以通過 AI 互聯來彌補掉,而這也正是中國領頭羊華為的強項——有自定義的 UB 通信協議、有華為自己的交換機,有超級的互聯能力。
海豚君就通過一系列的研究,來理解 AI 互聯層級的問題。本篇從最基本的問題看起來:
1)AI 數據中心的連接?
2)包含哪些概念和基本要素?
以下,我們來詳細看一下:
一、網絡連接是什麼?
建數據中心,需要有 GPU、CPU 等各類 XPU、各種存儲、網卡、交換機等,而連接就是把不同的數據中心設備,通過光纖、銅線等連接起來,形成一個信息互通的高速網絡。
核心要素與傳統互聯時代沒有本質區別,核心是連接更為緊密,速度、帶寬更高之後,對工程帶來了更大的要求。
先看一下$英偉達(NVDA.US) &$AMD(AMD.US) 下 AI 網絡連接架構的層級,也是行業較為通用的做法。按物理距離由內而外來看可分為三層,依次是:
1) 一層托盤內——CPU 與周圍設備互連;
2) 機架之內、單機架內不同托盤、同一托盤內多芯之間——xPU 間互連;
3) 數據中心間互連。見下圖:
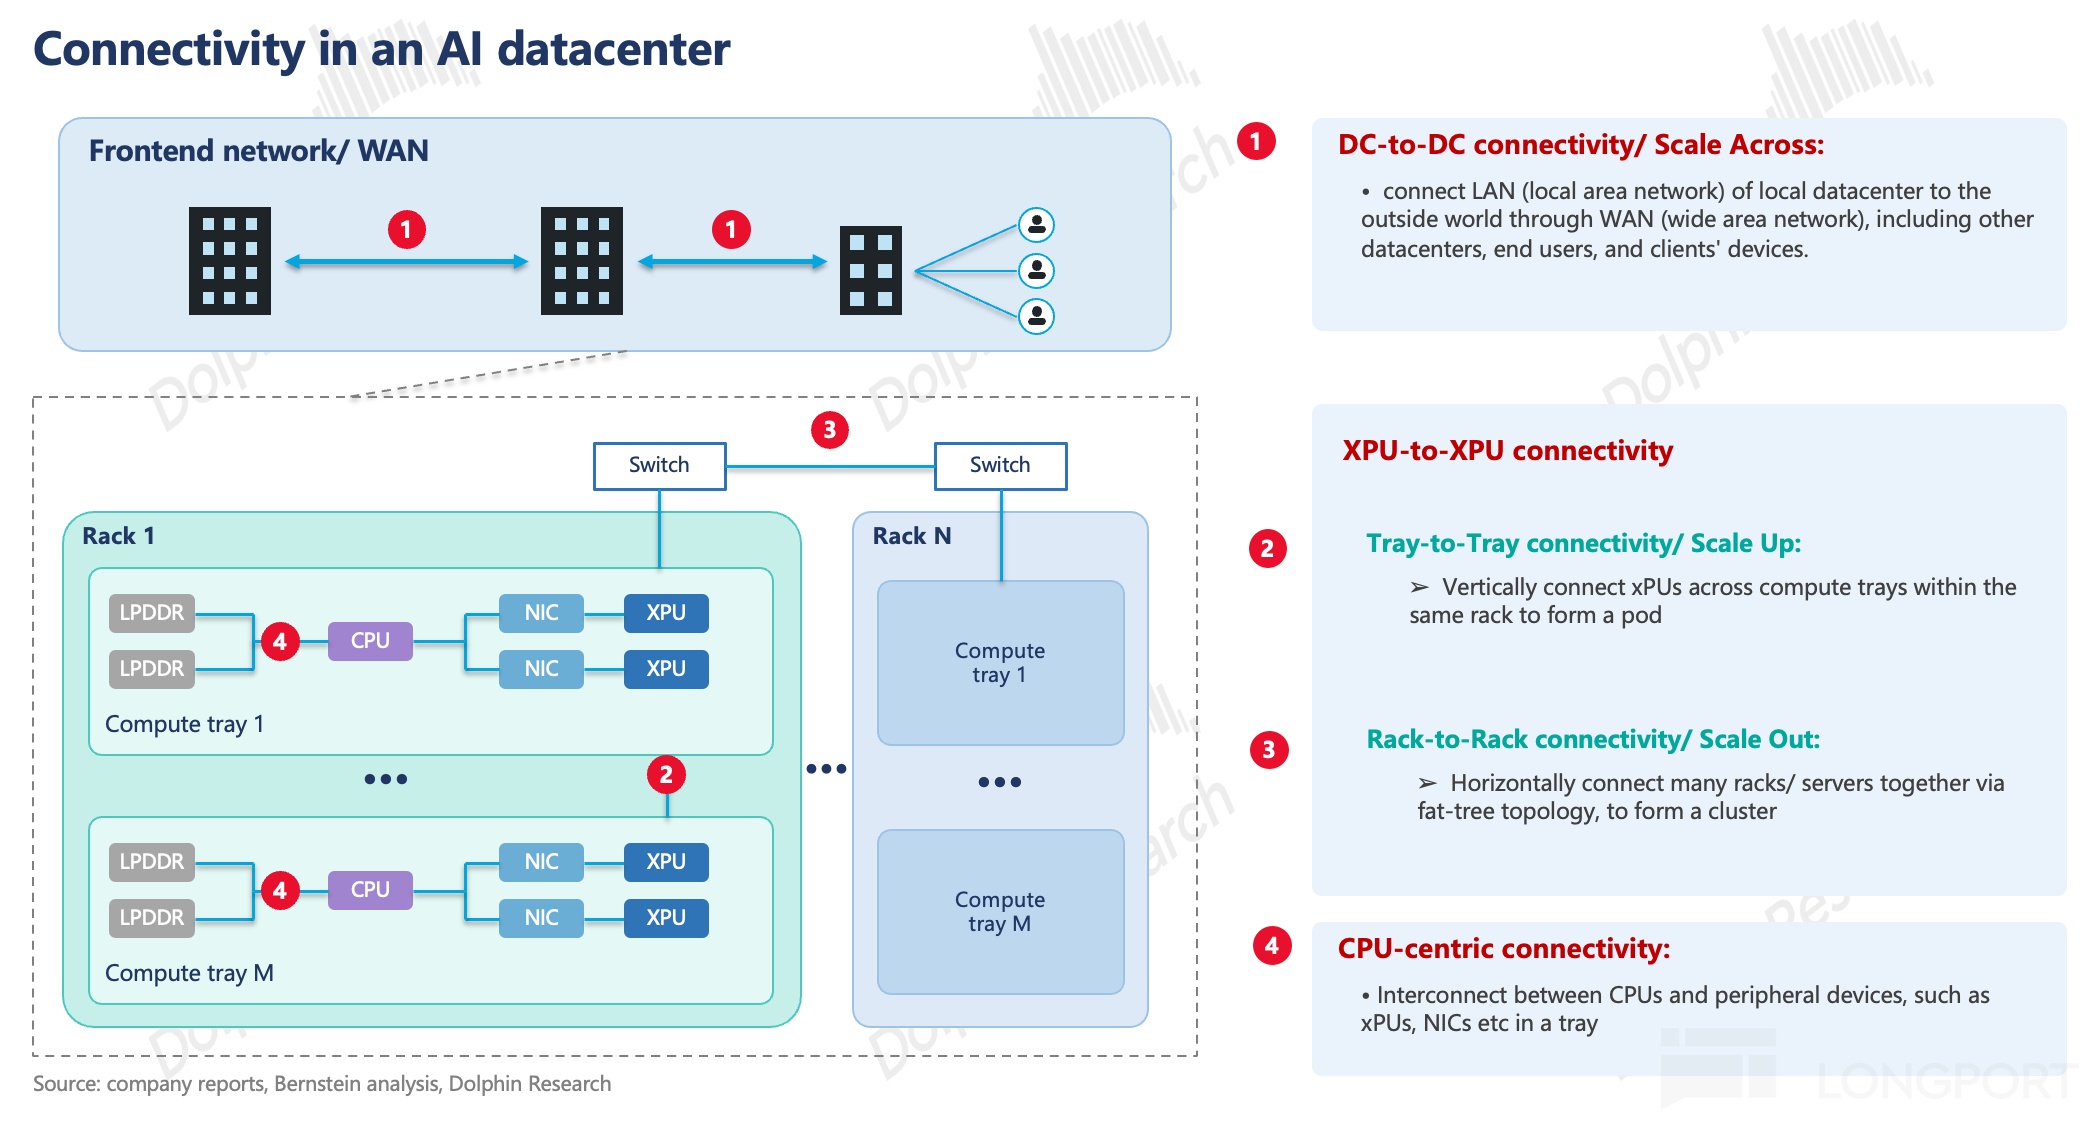
不妨將 AIDC 想象成一個需要趕超大工程項目(AI 工作負載)的園區。園區裏有許多辦公樓(Rack),每個辦公樓內,有多個工作樓層(Compute Tray)和多個調度樓層(Switch Tray,內嵌專有交換芯片,做分發和網內計算)。
辦公區裏的核心有項目經理(CPU)專門負責派活、調取資料、對接外部,以及真正幹活的工程師(xPU),算力由它們貢獻,此外還需要前台窗口(NIC)對外收發。項目被切成上萬份同時開工,"誰和誰溝通,多快能對齊"就決定了整體工期。
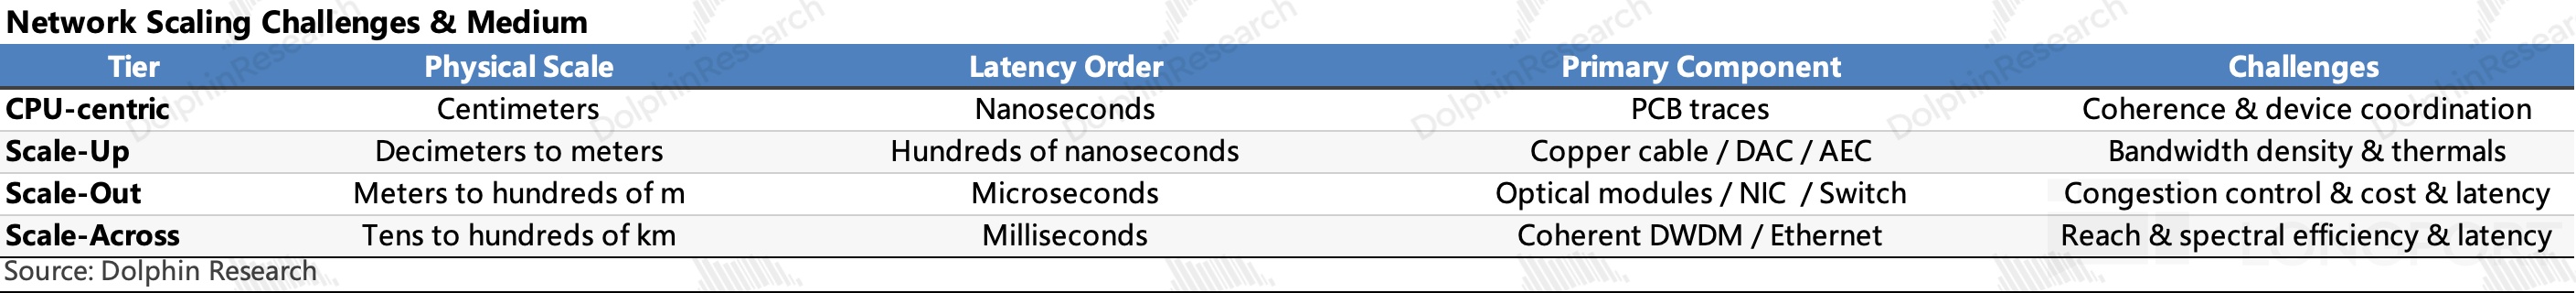
1) 同托盤內——CPU 與外圍互連:該層協調 CPU 與 xPU、NIC 及其他外圍設備之間的通信,物理實現是通過 PCB 走線,距離以厘米計,延遲極低,僅在納秒量級。功能上,這層主要負責內外數據傳輸、分派任務給 XPU。
2) 機架內、機架間——算力 xPU 間互連:整個 AI 時代的算力大腦,也可以理解成真正幹活的工程師。因為 AI 算力要求太高,這些工程師之間要高速連接,形成一個實質上的超級工程師,這是當前演進最快、也是本篇重點關注的一層。
- Tray-Tray(Scale-up):一層辦公樓常有多位工程師,即使兩個人距離再近,也不是兩人直接通信,而是都把自己信息傳給調度樓層(交換機:Switch Tray),由調度室統一轉發。
這麼做是因為,工程師之間的溝通不是隻有兩個工程師互傳,而是幾十數百人的多人互傳,人不能走動,走人傳人路線,轉述次數太多,延遲就來了。
大家把信息都共享給調度員(交換機),調度員看到收件地後,一鍵直投目的地,可以避免人傳人的延遲。也就是一層托盤內部,GPU 之間雖然距離很近,但並無任何連接。
物理實現上信息是從 XPU 先走 PCB 出托盤,再走銅線,接入調度層。但因 XPU 越連越多,這層連接方式在持續演進。這段鏈路目前主要採用銅連接,銅纜的物理性質決定了工程師 - 調度室 - 工程師之間的通信能力。
需要注意的是,以物理距離維度的 Rack 內/外區分 Scale-Up/Out 並不準確,但仍易於理解。我們在後文會看到英偉達 Rubin Ultra 方案的 Scale-Up 域跨出了機架。本質差異在於通信協議語義:
- Scale-Up 可以理解為指令級直取。寫明地址後 Switch ASIC 即按址直取(內存語義,直接尋址讀寫),因此延遲更低;
- Scale-Out 可以看作是投遞快遞。必須把內容裝袋封好、寫清收件人後進行轉運,還要等一紙回執(消息語義,需協議封裝與確認)。
從通信語義角度,常見組網方案(除華為)中,Scale-Up 域僅納入了 XPU,機架內其餘部件(CPU、存儲等)皆在域外。
此處以 CPU 為例:CPU 想找另一層托盤 上的 CPU,通過消息語義傳輸,路徑和一台普通服務器找另一台普通服務器一致,路徑為:CPU → PCIe → 網卡/DPU→ 交換機→ 對端 DPU → PCIe → CPU,其實即使在同一 Rack 的 Scale out 了。
- Rack-Rack(Scale-out):多棟樓(Rack)串聯為協調一致的訓練集羣(Pod/SuperPod)。跨樓流量不再經由調度室(Switch Tray),而是由 xPU 交給 NIC。
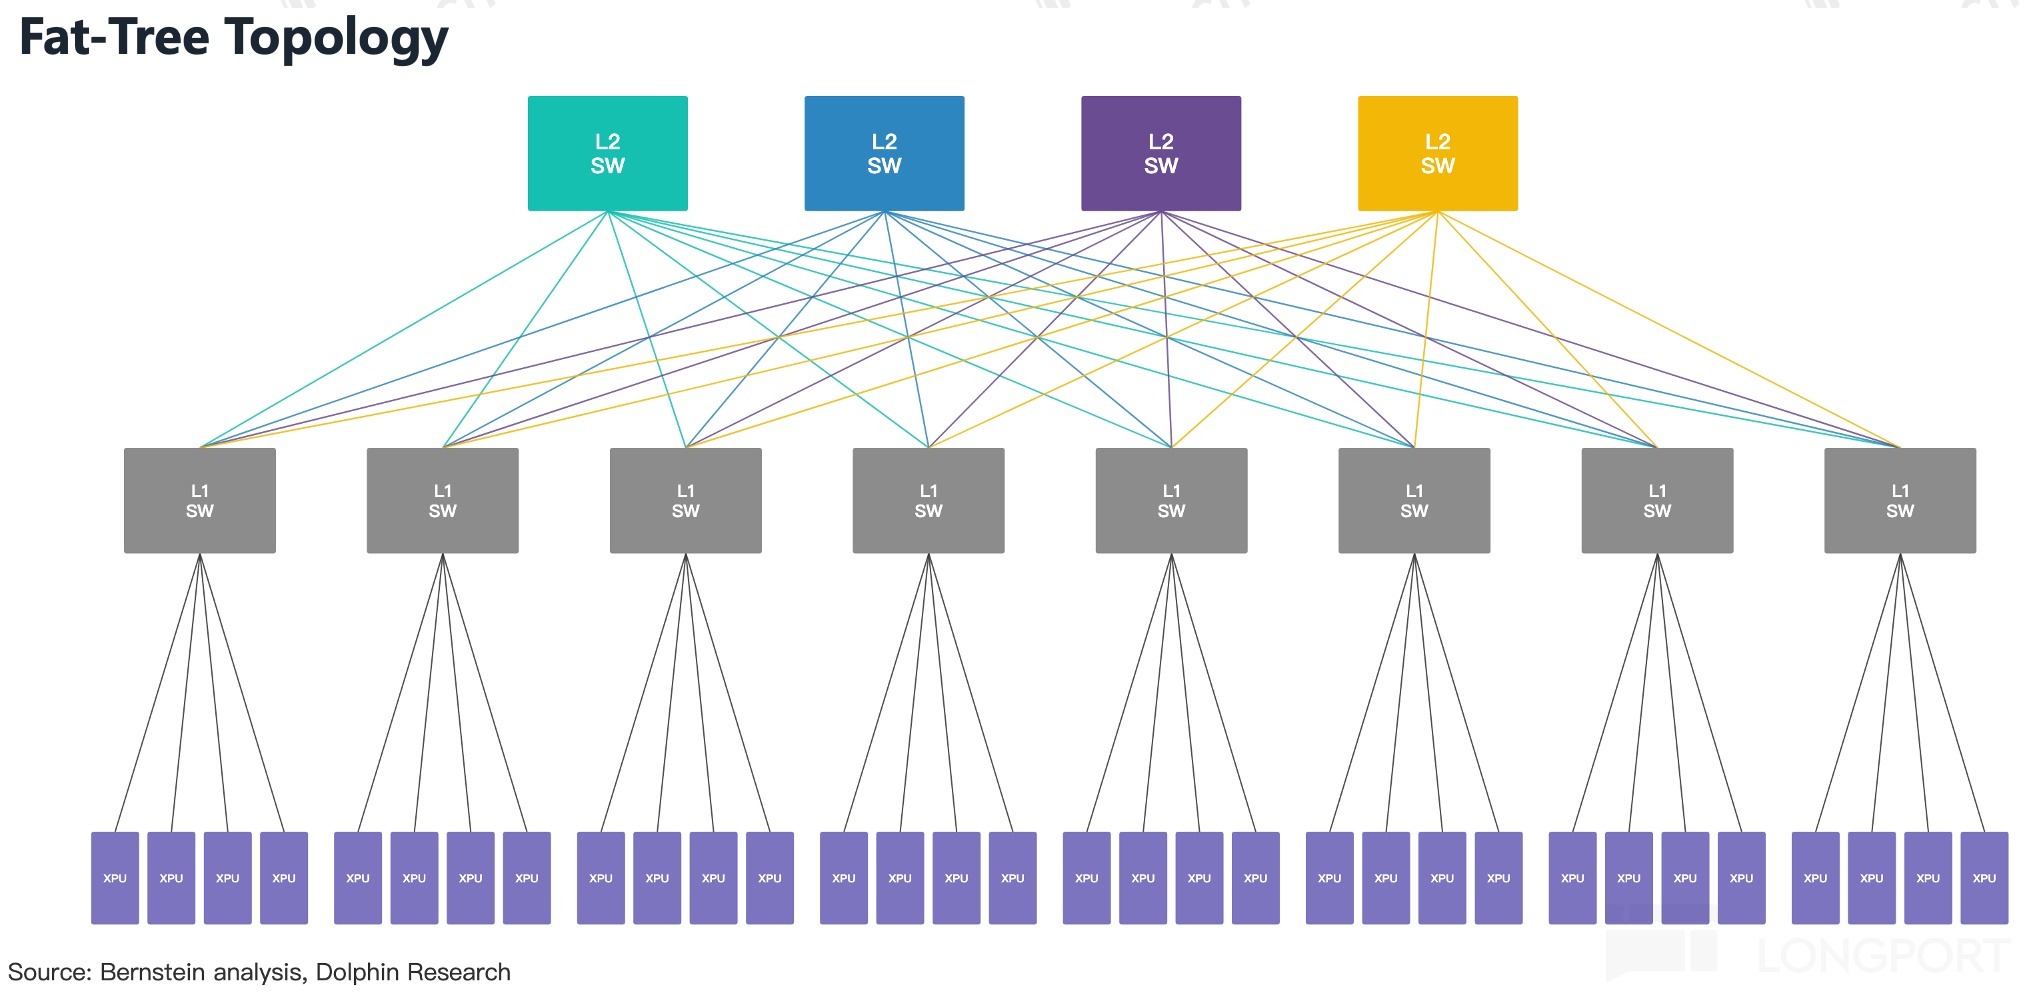
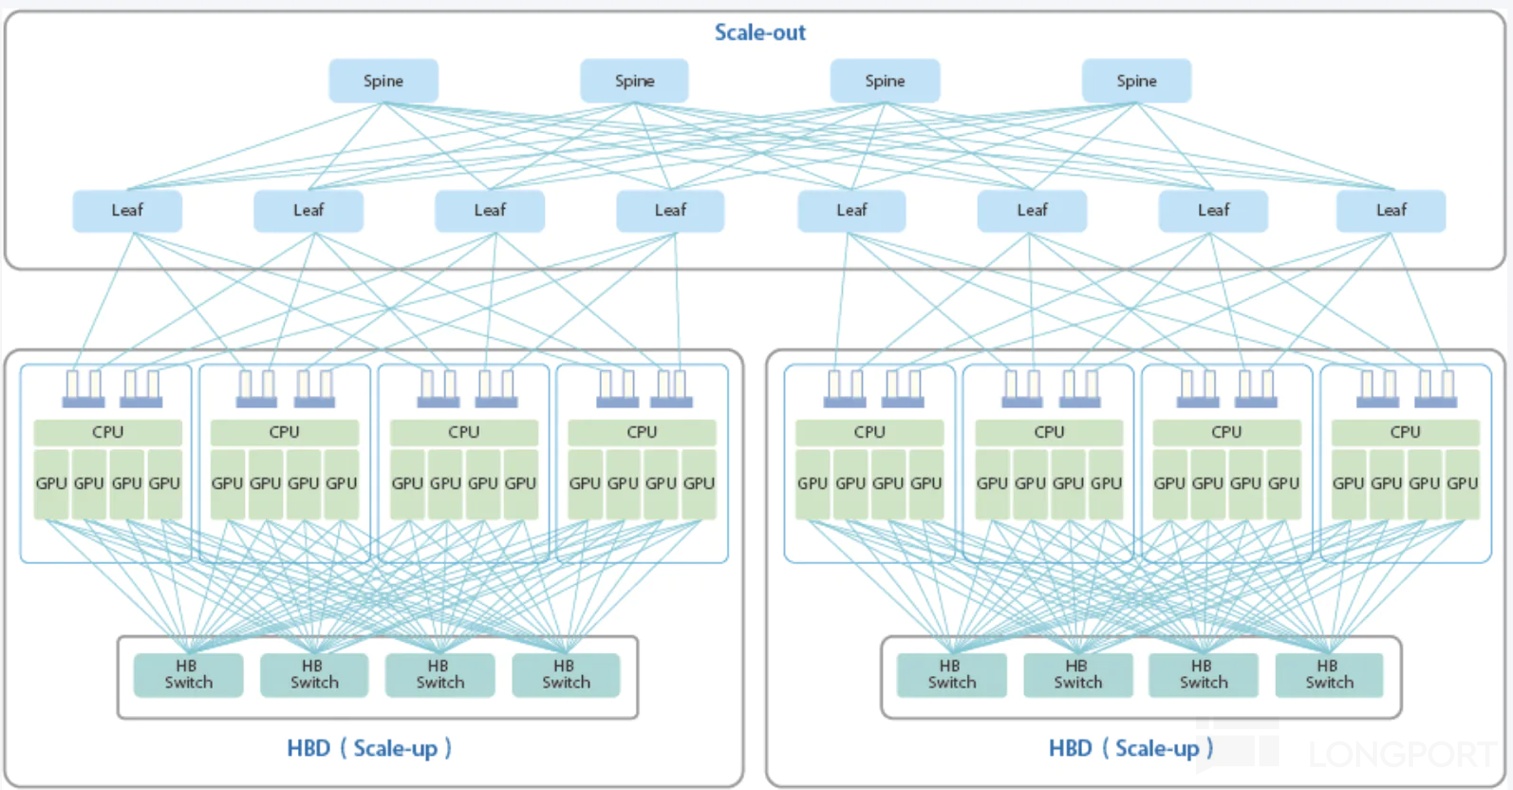
之後,經以太網交換機(可以看作是園區收發室)層層轉運,主要依賴運行於 400G、800G 以及 1.6T 速率的光模塊,並採用雙層和三層胖樹等層級式拓撲(見下圖)。核心挑戰也從"送得多快"變成擁塞控制、成本效益,以及對多達數萬個加速器的協調。
3) 數據中心互連 (Scale-across):通過長途光網絡連接多個園區或區域,支撐跨區工作負載分發、數據複製及與終端用户接入,依賴相干 DWDM 光器件。傳輸距離可達數十至數百公里,單波長帶寬從 400G 到 800G,並向 1.6T/3.2T 演進。由於承載的多為區域間流量而非訓練中的同步操作,可以忍受更高的延遲。
二. 網絡連接:關鍵硬件,如何運作?
以上主要設備之間"誰和誰溝通"的問題。接下里是用什麼來溝通。核心是兩大類:
a. 硬件:PCB、交換機、網卡、光模塊、銅纜、光纖等等;
b. 軟件:網絡連接協議,本質是生態的競爭——誰指定的協議標準,對應的硬件出貨和組網方案更多。
接下來先看硬件:
1)硬件:不同協議下設備出貨和市佔,是連接生態戰的硬核實力
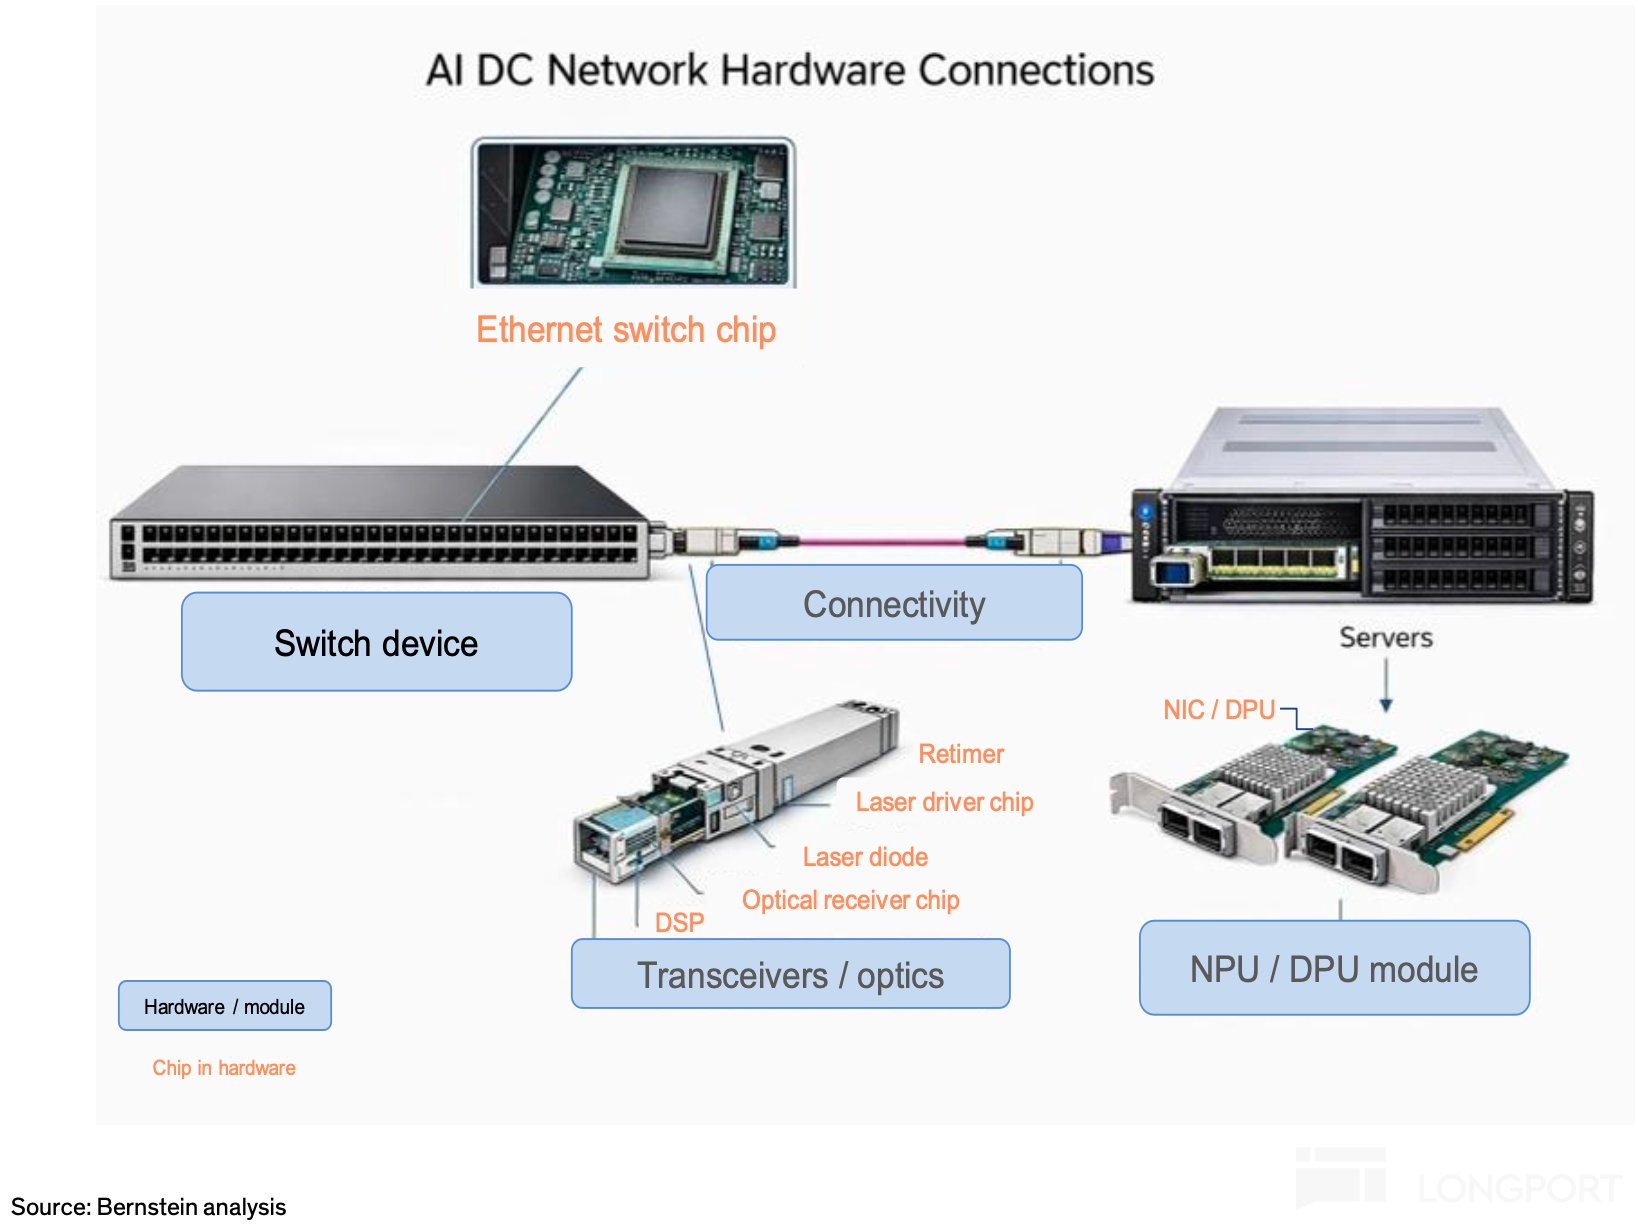
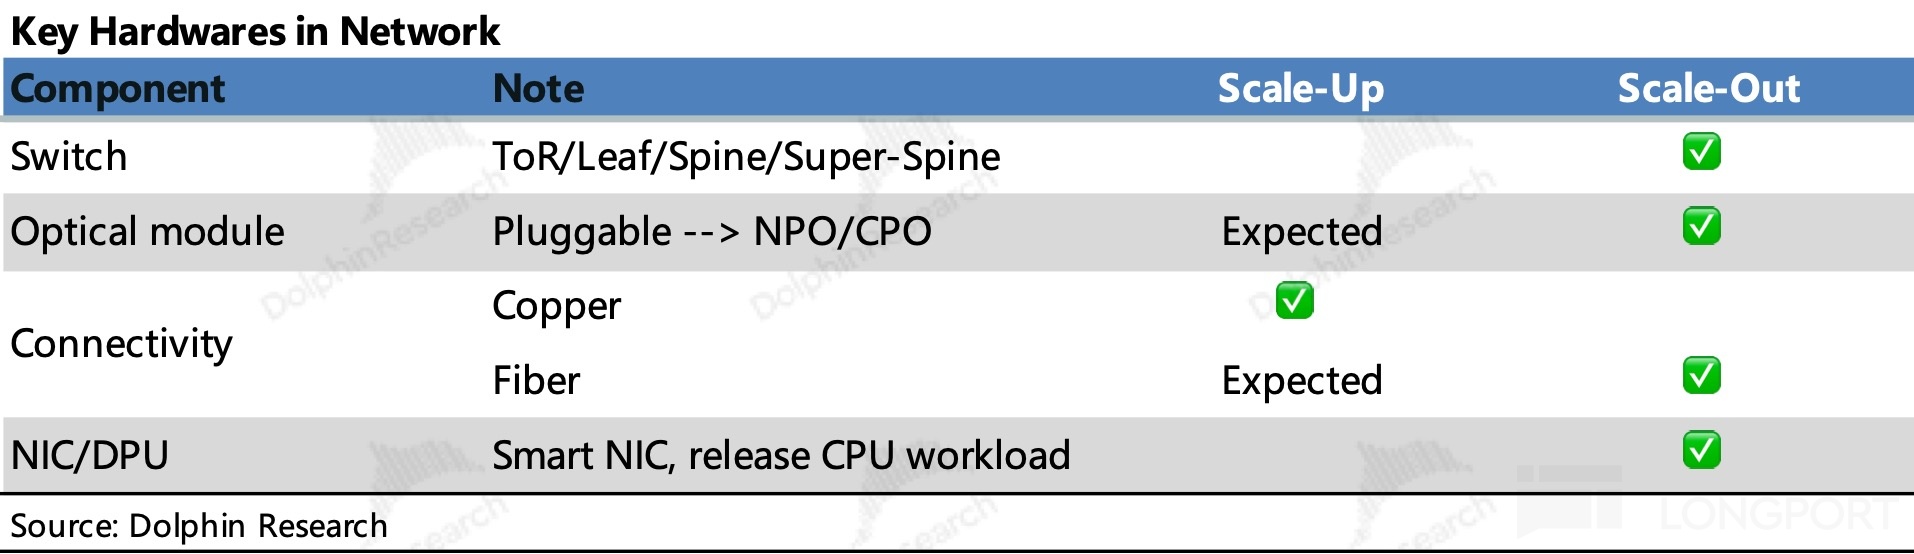
硬件大致可以歸為三類模組:交換機、連接/光器件以及網卡 NIC/數據處理芯片 DPU,各模組內部均以專用芯片作為核心,分別提供集羣 AI 工作負載所需的帶寬、信號完整性以及計算卸載能力。
a. 交換機:高產業鏈價值量、高毛利率
交換機用於組建網絡,是 AIDC 網絡的核心匯聚與轉發設備,負責在 xPU 間調度流量,也就是上一節中的園區收發室,其核心是交換芯片,直接決定整機的吞吐、延遲與功率。
聚合帶寬由端口數量與單端口速率決定。當前主流產品已支持 51.2T 並向 102.4T 演進,對應每端口 400G、800G 以及 1.6T 的鏈路速率。
在常見的胖樹拓撲中,交換機可分為 ToR/Leaf、Spine 以及三層拓撲下的 Super-Spine。ToR 或 Leaf 交換機位於機架最上端,向下連接機架內各服務器的 NIC,是唯一與 xPU 直連的一級,而其餘各級只與交換機互連,隨着網絡層級變多,從 Spine 逐級拓展到 Super-Spine。
b. 光器件/連接
- 光器件:芯片高價值量,高毛利;但模組高價值量,強競爭
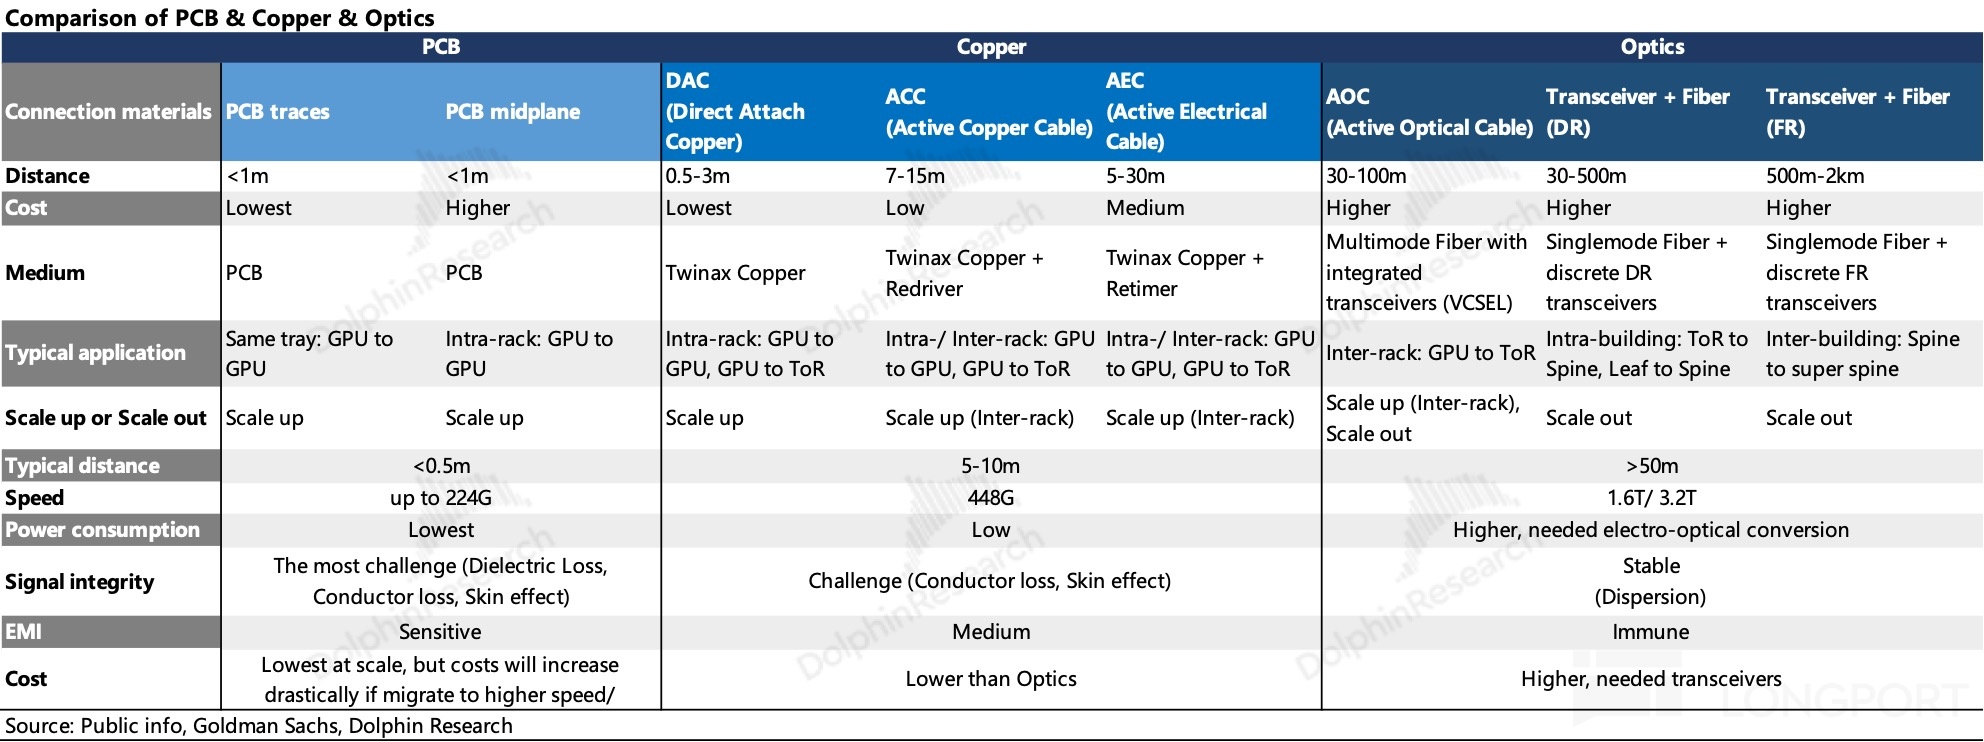
光模塊負責在交換芯片、網卡與鏈路之間完成 E/O & O/E 的雙向轉換,在數據傳輸中起到 “翻譯” 作用。主流方案中是 Scale-Out 不可或缺的組件,也正越來越多地被用來將 Scale-Up 網絡延伸至銅纜物理極限之外。
隨着網絡速率向 800G、1.6T 甚至 3.2T 遷移,功耗、散熱、信號完整性等成為主要瓶頸,推動架構從傳統可插拔(400G/800G 為主)向 LPO、CPO 演進。詳情請參見技術演進、產業鏈梳理。
- 連接介質:中價值量,強競爭
信號傳輸介質上,銅互連一直以低功耗、高性價比和高可靠性受到重視,但隨着距離拉長或速率提高,信號質量會迅速劣化,銅纜連接通常被限制在 30 米以內,這使銅纜主要侷限於機櫃內 Scale-Up 層應用。在英偉達 Rubin Ultra 方案中,首次引入了 PCB 板替代銅纜作為機櫃內 Scale-Up 的方案。
光鏈路則提供高帶寬與長距,且衰減少,可向 Tb 級擴展,因此成為 Scale-Out 層中機架間鏈路的主流方案。
c) NIC/DPU
網卡(NIC)是節點的網絡端點,經 PCIe 或專有鏈路與 xPU、CPU 連接,負責收發傳輸數據包給交換機,其性能影響 Scale-Out 側實際通信效率。
目前,NIC 正加速向具備計算能力的 Smart NIC(內嵌可編程邏輯等)演進,演進方向是將非計算中心任務從 CPU 中卸載,從而釋放 CPU 算力用於 AI 編排調度等核心任務。DPU 則在 NIC 之上更進一步將網絡、存儲、安全等任務一併接管。
2)硬件是如何運作的?
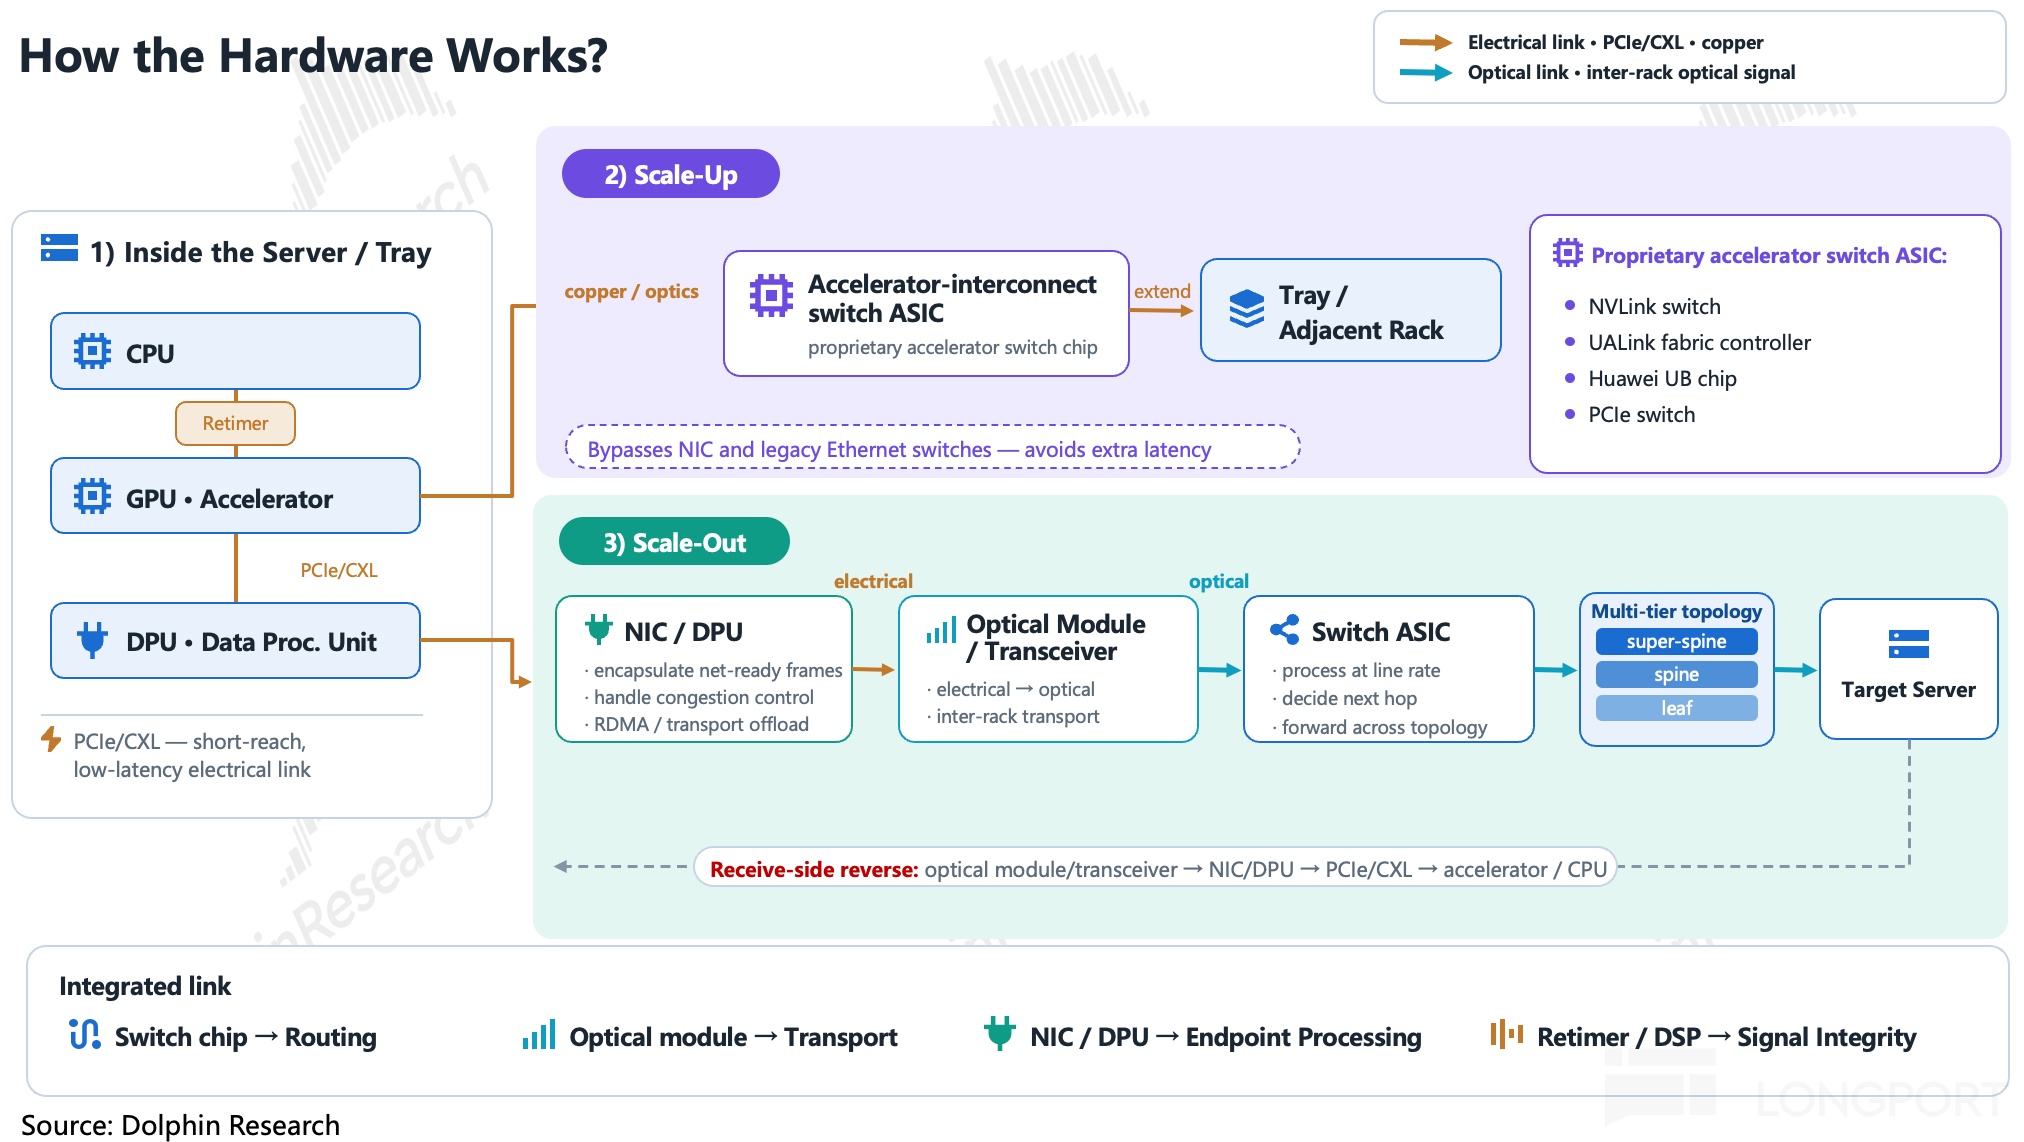
可以看到各硬件在 AI 網絡中各司其職,接下去的問題是這些硬件是如何互相協作完成 AI 工作負載的。下面我們換一個視角,從信號的流動路徑,來理解這些器件是如何形成一個系統的。
整體流程參考下圖:
a. 節點內部
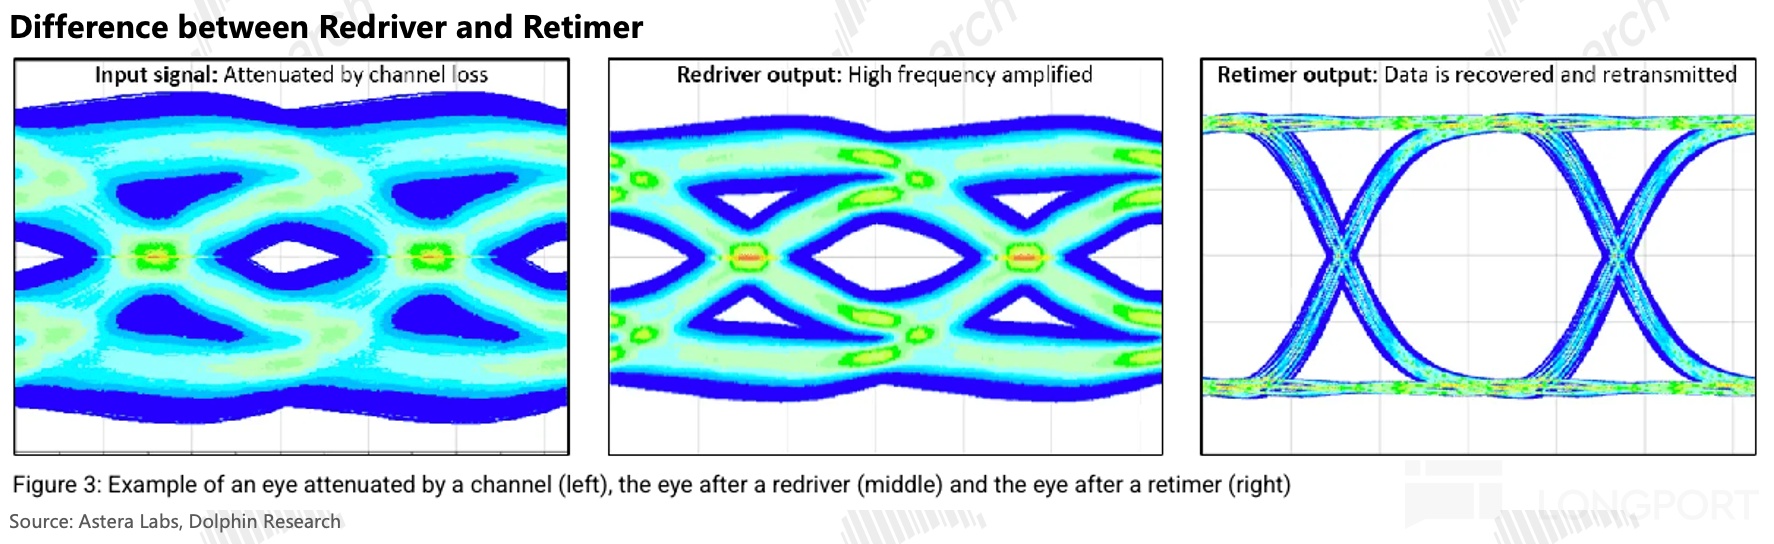
服務器內部,CPU、GPU 和 NIC/DPU 通過電鏈路(銅)相互連接。當信號完整性不足以支撐傳輸距離時,通常會引入 Redriver 以及 Retimer 器件。
Redriver 只做模擬域的均衡與放大,在補償高頻損耗的同時也會把噪聲一併放大,成本與功耗更低;而 Retimer 把衰減到快要認不出的信號進行重定時,重新發出後,下游看到的是一條全新的鏈路,從而延伸可達距離。
b. Scale-Up
若目標加速器位於同一域內,直接通過專有互連交換 ASIC(即第一節中辦公區與調度室的通信),以 Load/Store 指令直接尋址。
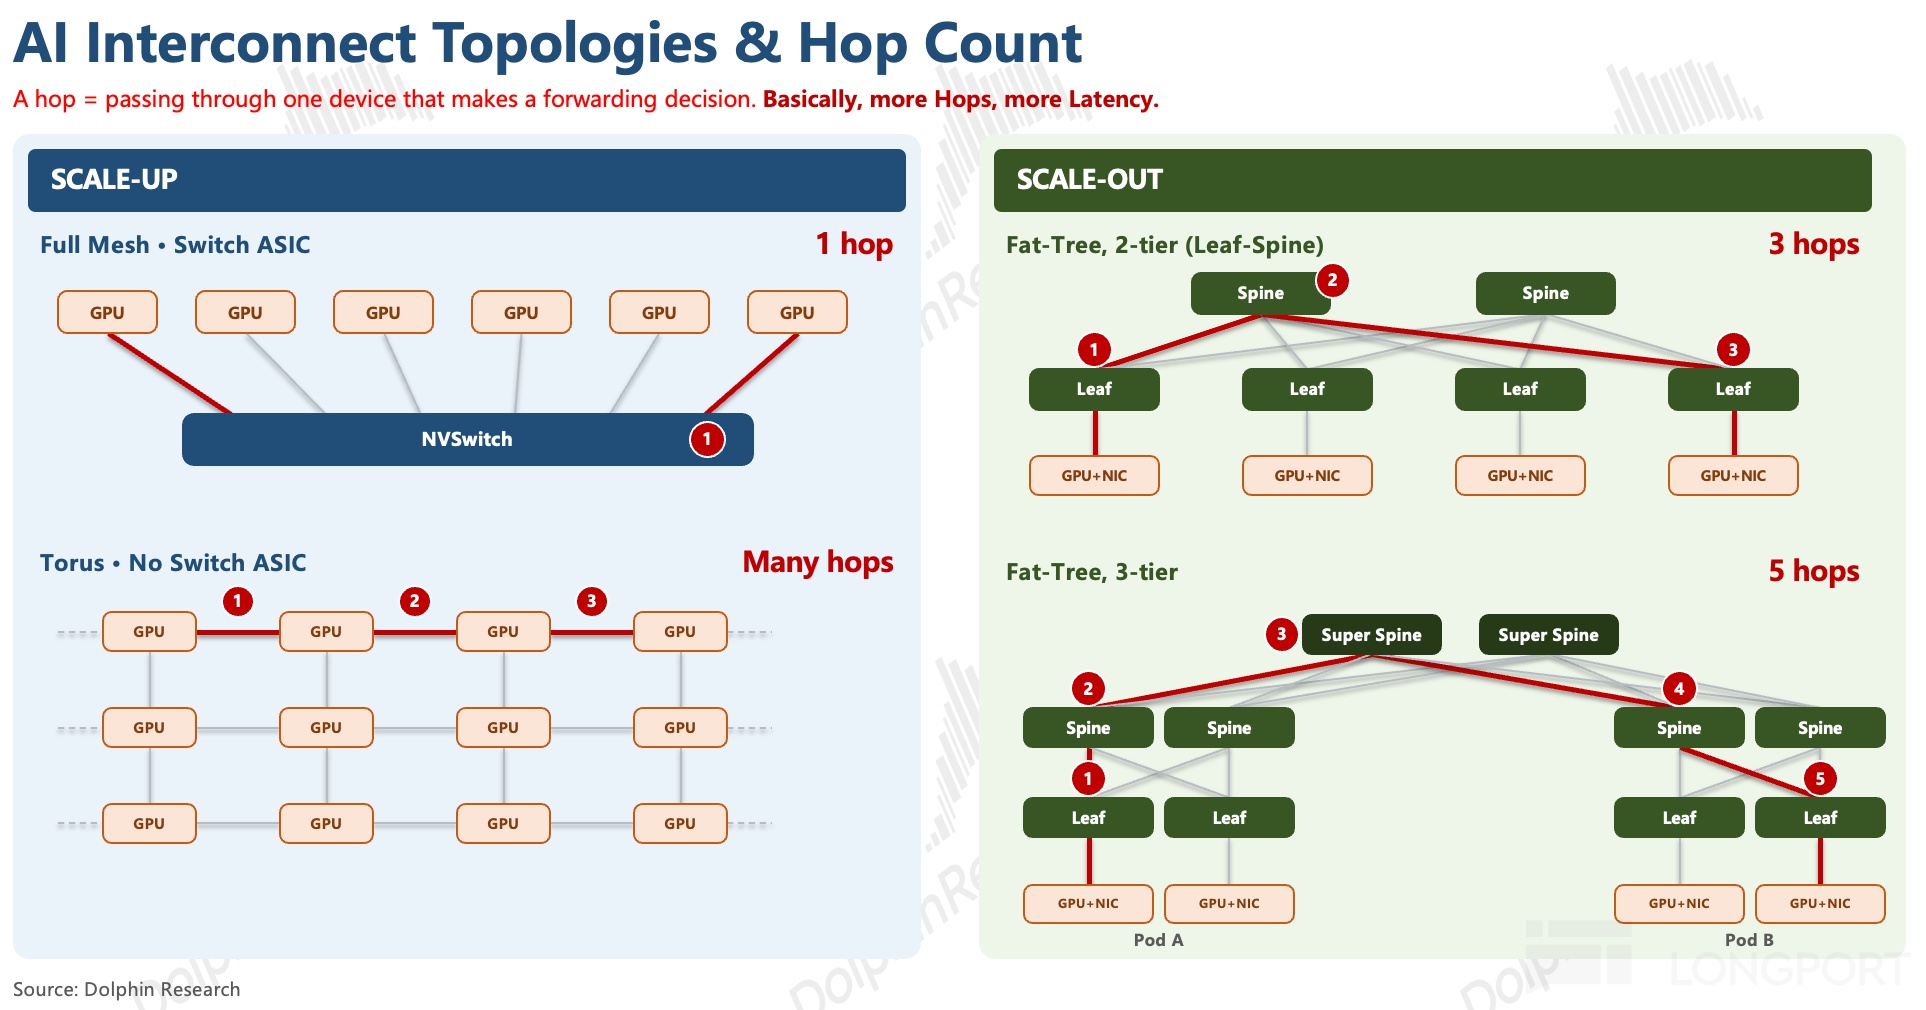
這裏引出衡量路徑長度的通用指標,跳數(hop):數據每經過一個執行轉發決策的設備即為一跳,跳數越多,延遲越高。
Scale-Up 域內配備交換 ASIC 時,因為只經過 ASIC,直接到了目的地 GPU,任意兩顆 GPU 之間均為單跳;
若方案中缺少交換 ASIC 而採用直連拓撲(如 Torus,我們將在下一篇深度中覆蓋谷歌的組網方案),同等規模下則需多跳繞行。Scale-Out 側的兩層胖樹需 3 跳,三層胖樹需 5 跳(見下圖)。
注意這個概念非常重要,AI DC 組網的核心一個是儘量讓重要的設備放在一個通信語義內,以便直接尋址,提高速度。第二個重要的概念就減少數據的中轉次數,或者説跳數。
c. Scale-Out
若目標加速器位於 Scale-Up 域之外,流量先被交付到 NIC/DPU;隨後經電通道進入光模塊,完成 E(電 Eletrical)/O(光 Optical)轉換後沿光纜跨機架傳輸。
抵達交換機後,光模塊做 O/E 還原,交換 ASIC 處理電信號決定下一跳並將其轉發。多級拓撲下,數據依次穿越 Leaf、Spine 以及 Super Spine,最終到達目標服務器。
三. 連接的生態大戰:協議是靈魂
介紹完硬件,本節接着看協議。如果將一整套硬件理解成基礎設施,那麼協議就是指導基礎設施運作的規則,其規定了通信語義、可拓展節點上限等。
各層級對延遲、帶寬的需求差異顯著,協議生態是以陣營來劃分的,強勢程度取決於標準對同行、上下游的接受度,以及這個協議標準下的硬件銷量市佔率:
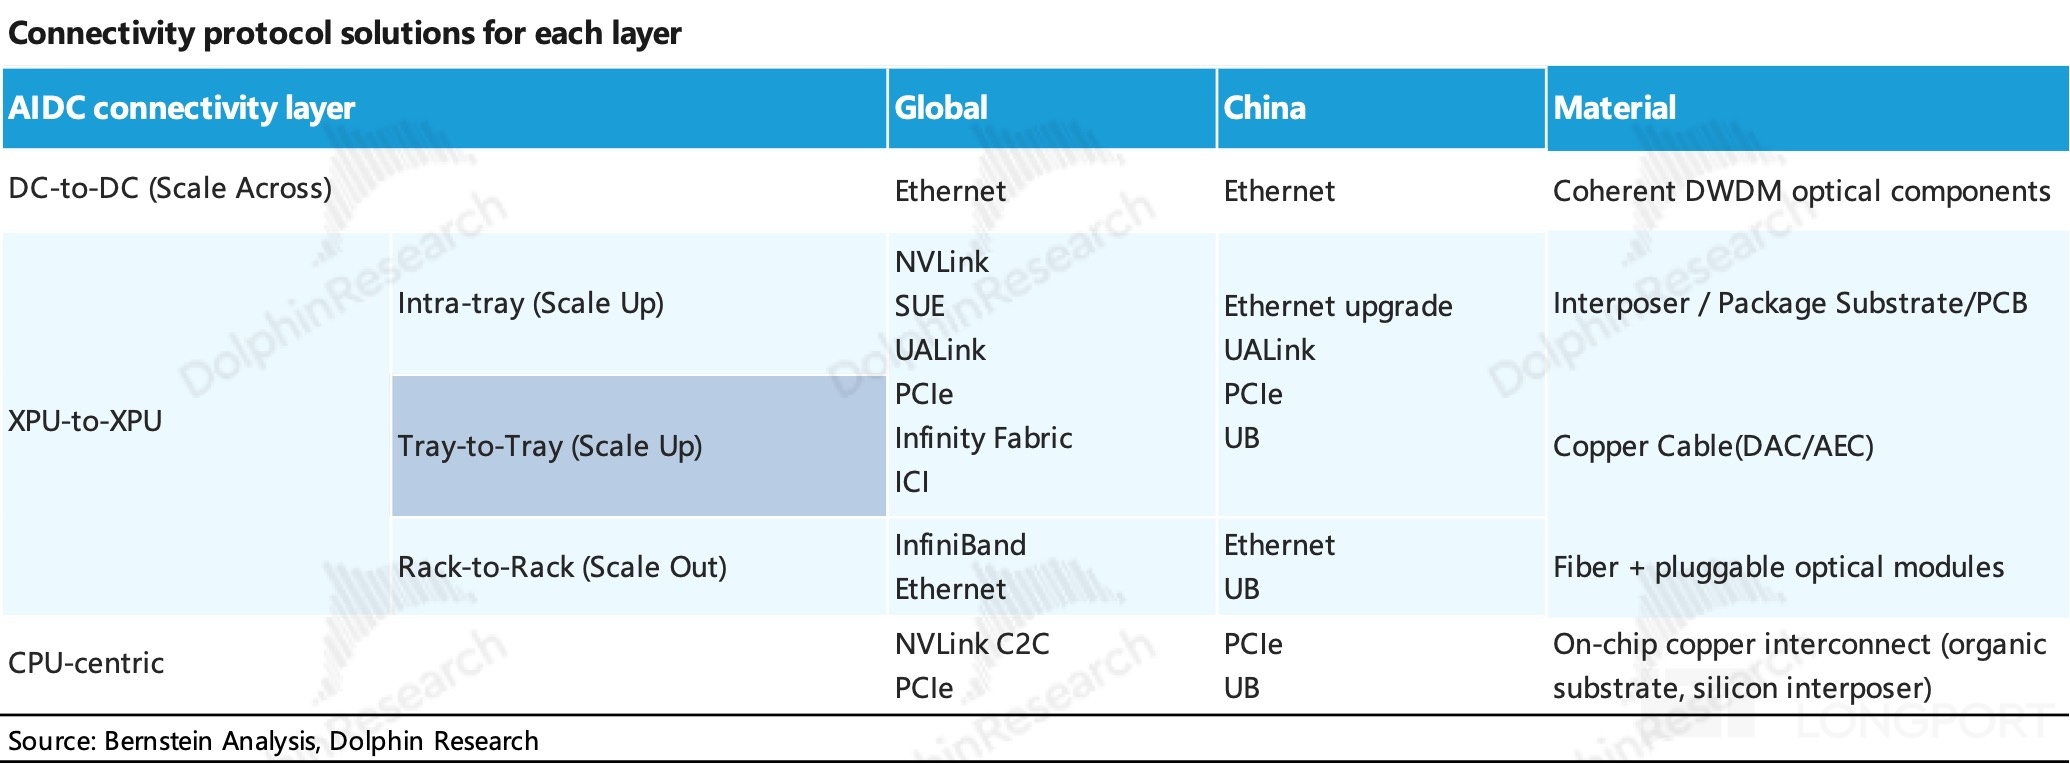
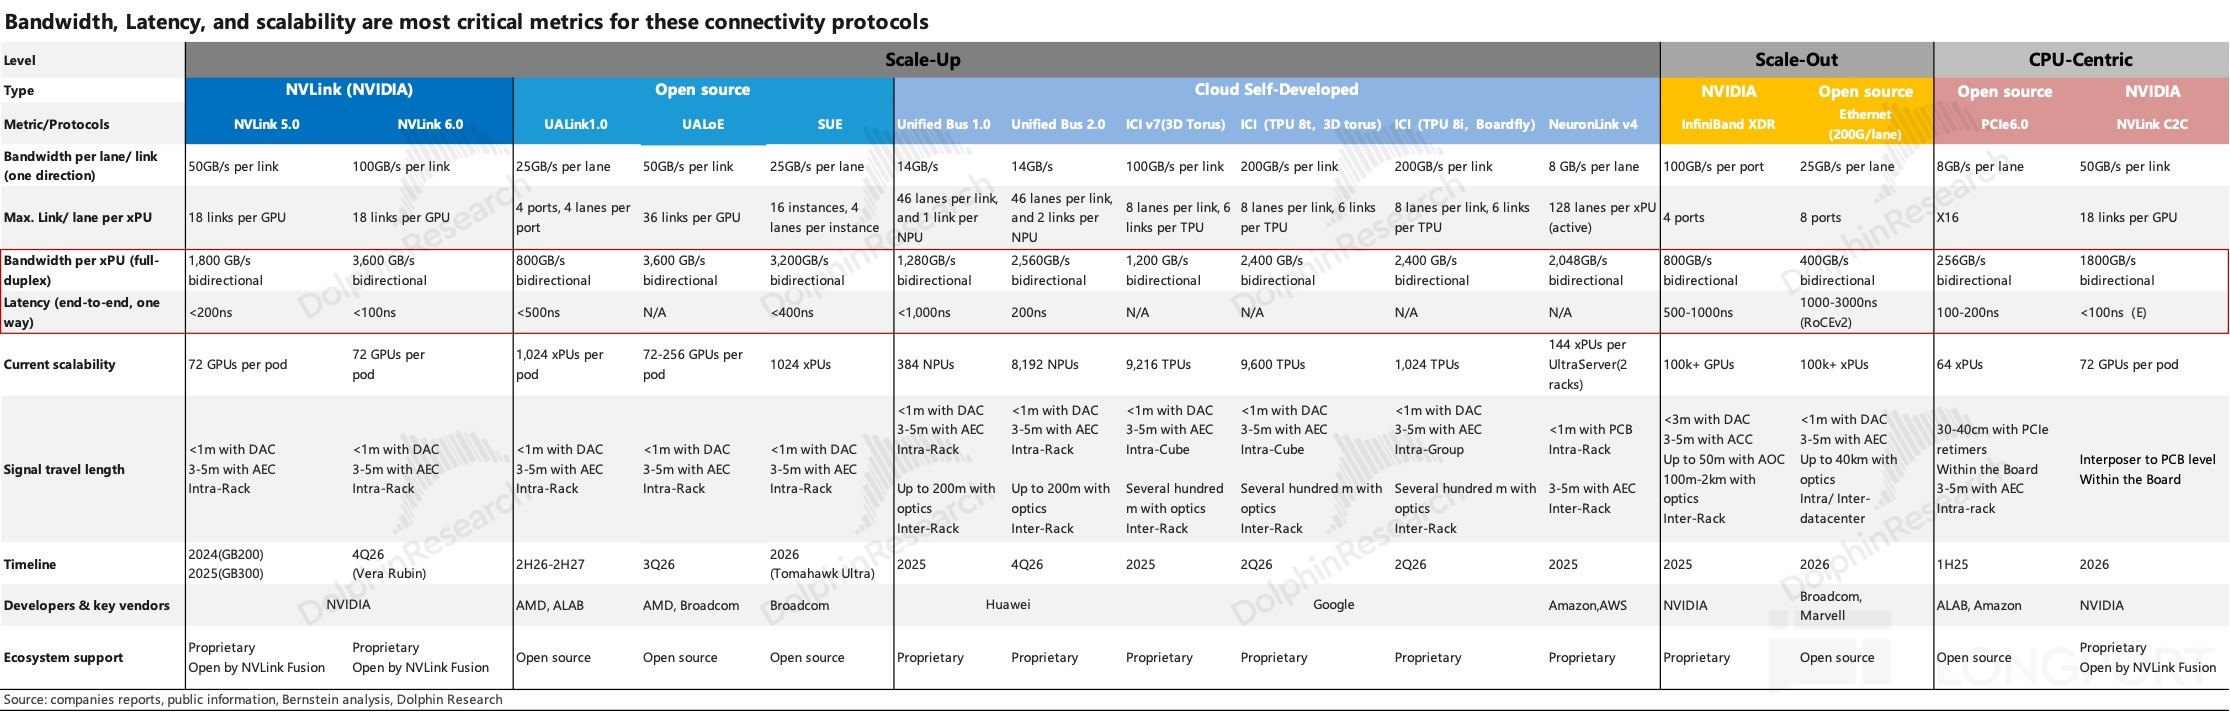
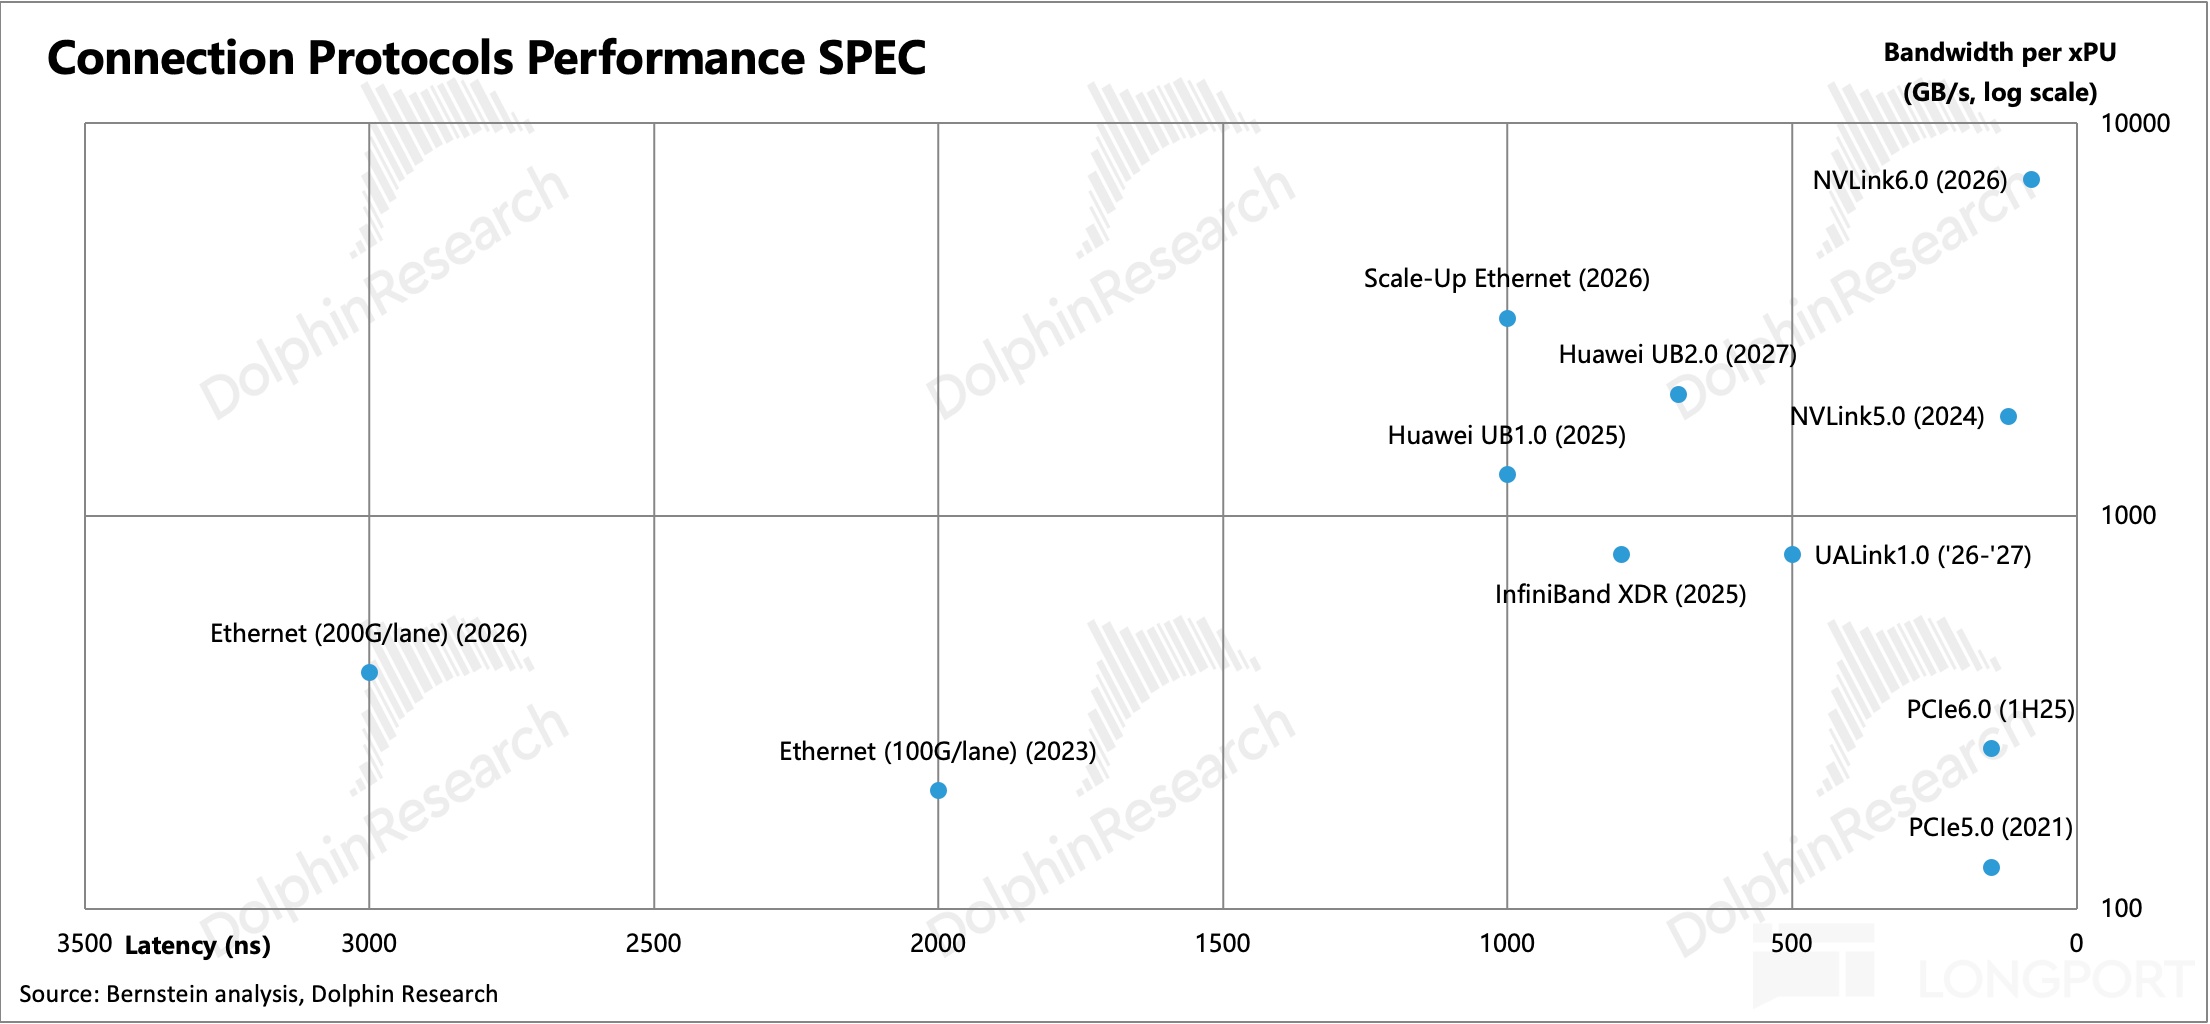
我們整理了各層級的協議性能情況(見上表),其中最關鍵的是帶寬與延遲兩項指標(紅框內)。
分層來看,產業演進核心在 Scale-Up 層,廠商都希望做行業"話事人":英偉達 NVLink、AMD UALink 以及 華為 UB 等多種專有協議並存,性能、成本與生態各異。
Scale-Out 層格局則相對清晰,競爭主要在英偉達主導的 InfiniBand 與開放生態的以太網之間展開。
而單就協議性能而言,英偉達在連接協議上基本可以做到封閉 + 開放生態兩種方案並行,仍是行業標杆(下圖中越靠右上,性能越佳)。
但對終端 CSP 而言,方案最終仍是在業務需求、預算與自主可控之間做取捨,這也正是 UALink、博通 SUE 等開放陣營得以成形的原因。
本片有關網絡連接的基礎介紹暫停於此,下篇重點分析 AMD 和英偉達的方案差異,理解 Helios 是否真有能力撼動英偉達 GB 和 VR NVL 72 的實力。
<此處結束>
海豚研究相關歷史文章:
2026 年 6 月 3 日《AI 超連接時代:AI 向 “光” 飛奔?》
2026 年 6 月 24 日《“‘銅’ 牛夫人” 不走!CPO:真機會 or 鏡中花?》
本文的風險披露與聲明:海豚投研免責聲明及一般披露


本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。