

Cerebras:不切晶圓的芯片 “怪獸”,有希望挑戰英偉達?
 我是 LongbridgeAI,我可以總結文章信息。
英偉達等絕對多數芯片設計公司都是把一塊大硅片做好線路後,切成小芯片,小芯片再互聯起來做AI加速器,避免因為製造瑕疵而報廢整塊硅片,而有一家公司卻“頭鐵”地偏偏不走這條路。
它直接把整塊硅片當成一個芯片,大小如同21.5cm x 21.5cm的正方形果盤(面積與12寸晶圓所能截取的最大矩形面積相近),塞進了4萬億個晶體管和90萬個核心,那就是“Cerebras”。
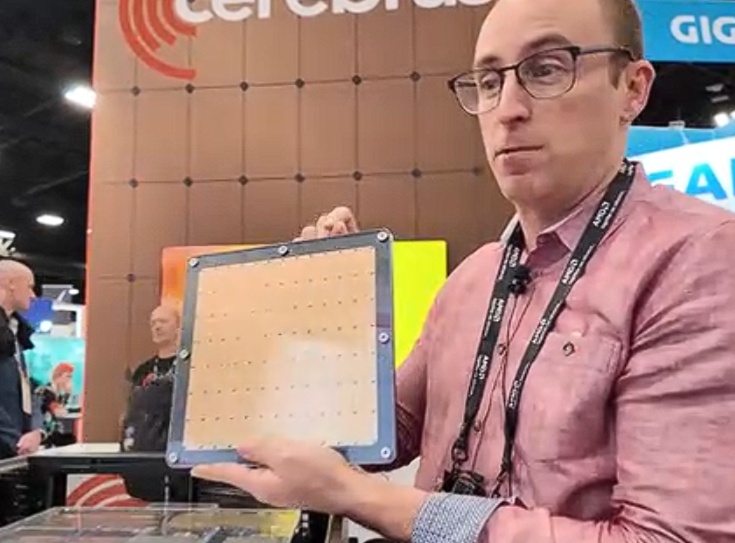
GPU 推理瓶頸是“內存牆”。英偉達絞盡腦汁繞着走,$Cerebras(CBRS.US) 則用晶圓級芯片把牆拆掉,而它的護城河主要在台積電之外的設計、容錯和封裝環節。
本文主要圍繞Cerebras的WSE(晶圓級引擎)產品是什麼、能解決GPU什麼問題、以及WSE是如何製造以及難點在哪。在下篇中將主要對Cerebras公司的經營表現以及未來展望展開。
一、Cerebras做什麼?
Cerebras的核心是WSE(晶圓級引擎,Wafer Scale Engine),這個命名是區別於常規芯片都是Die級別,而非晶圓Wafer。
同行常規是把一張晶圓切成幾十上百顆一張郵票大小(800mm²)裸片,再用高速互連拼回去、當成一個大加速器用。
Cerebras的邏輯是:既然最後還要拼回去,為什麼要先切?於是把全部、各類計算都刻在一整片晶圓上。
Cerebras將整片晶圓劃分成12列x7行的84個完全相同的網格(die),其中這84個不是獨立的芯片,在互為鄰居的片之間是互聯的,84塊構成了“一整個芯片”。
在每個die中有1.07萬個激活核心core,其中每個核心僅0.05平方毫米。那麼一個晶圓(芯片),就對應有90萬個激活核心(實際有97萬個左右物理核心,結合良率約有7%的設計冗餘)。
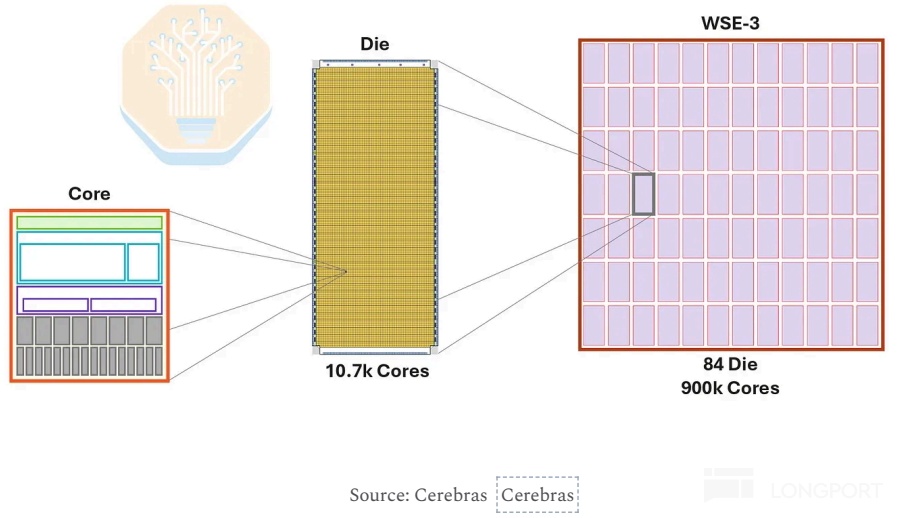
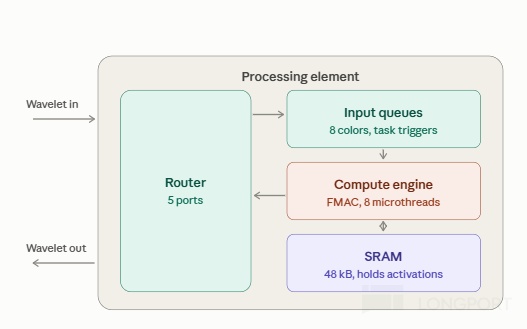
具體來看,在單個核心之中主要塞了三個東西:一個路由器、一個計算引擎和48KB的SRAM(單晶圓97萬個核心大致對應44GB的SRAM)。面積大約是對半分,一半給邏輯,一半給存儲。
這種走果盤大小芯片模式的WSE路線,目前只有Cerebras一家,並且因為WSE單核的面積僅為0.05平方毫米(英偉達、蘋果的單元面積在3平方毫米左右),尺寸標準只此一家。
WSE單核內的計算核心、路由器、SRAM組合架構都是由Cerebras自研的, 但SRAM上,不同於HBM芯片廠的外採,bit cell設計和代工是由台積電來完成,包含在晶圓報價中。
在實際的工作中,GPU和WSE(Cerebras)的區別主要在於:
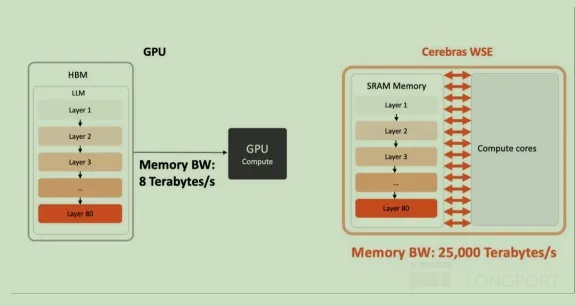
1)GPU是一座圖書館。全套百科全書(權重)放在書庫裏(HBM),上百個讀者(SM,核心計算單元)坐在閲覽室。每要寫一個字,所有讀者都得把整套書完整翻一遍。書庫到閲覽室只有一條走廊,每秒能過8TB的書;
2)WSE(Cerebras)沒有選擇建圖書館。它僱了90萬個人(核心),每人背下整套書裏的一小段。沒有書庫,沒有走廊,也沒人需要跑腿。要寫一個字的時候,只要把題目念一遍,每個人立刻從記憶裏報出自己那一段的答案,匯總一下就完了。
在WSE的情況中,單個核心中的三個部件作用分別是:
①SRAM:主要部分是用來存放權重(背下的一頁書),其中一小部分是用來放激活值、KV cache等(草稿紙);
②計算單元:主要在一個數(激活值)送過來的時候,它負責乘一次、加一次;沒有數傳過來,就坐着不動、不耗電;
③路由器:是用來傳題目和收答案的。主要工作是“把題目念給所有人”、“把大家的答案收回來匯總”、“把答案送去下一站”。
基於WSE構建方式不同,能克服GPU最主要面臨的問題就是縮短了運輸時間,解決“內存牆”。
這是因為GPU的權重在HBM,每個Token都要完整“搬一次”(B200/B300帶寬8TB/s)。而WSE直接將權重搬進了SRAM,就在計算單元旁邊。
二、GPU針對“內存牆”的努力
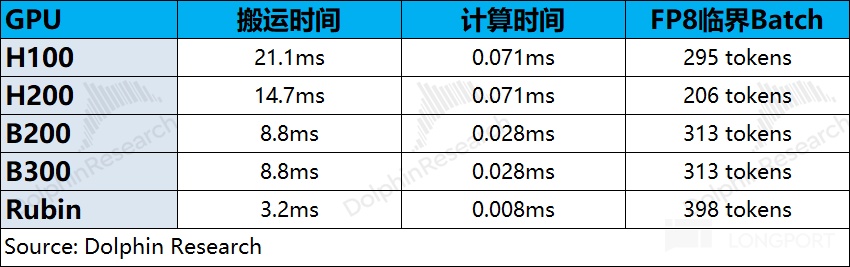
HBM的搬運時間遠遠大於GPU的計算時間。如果以Llama 70B 模型(FP8)為例,參考B300的情況,HBM的搬運時間約為8.8ms,而GPU計算所用的時間僅為0.028ms,相對搬運的時間不到0.5%。
這意味着99.5%的時間都在等權重從HBM搬過來,導致了GPU算力的閒置,這也是推理場景主要瓶頸。
注:HBM搬運時間=70B參數x單參數佔用1B空間/8TB/s帶寬=8.8ms;GPU計算時間=2次運算x70B參數/5PFLOPS GPU計算速度 =0.028ms。
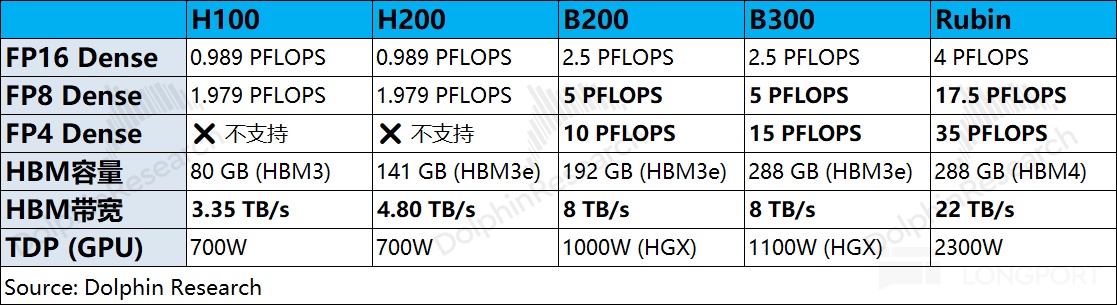
從英偉達各代GPU參數來看,即便下一代Rubin將HBM帶寬提升了2.75倍到了22TB/s,但Rubin GPU 17.5PFLOPS的計算速度,提升了3.5倍。GPU的閒置時間仍有99.5%。
對於這麼大的算力閒置,目前GPU想到的方案是拼團(Batching)。因為所有用户都要讀同一套權重,既然這一趟已經“花時間”去搬運了,順手把其他人的題目也一起算了(本身99.5%的時間都在發呆)。
拼團的目的在一次搬運任務完成後,讓上百個計算任務同時進行,抹平搬運數據所需的時間,這就可以測算出目前理論上的拼團上限值(313->398)。在這個臨界點之下,意味着還在“浪費”算力;而高於這個臨界點,表明在“浪費”帶寬。
“拼團”能提高GPU計算的使用效率(經濟性),但在客户端還是會帶來一些問題,從而影響用户體驗:
1)KV cache會限制拼團上限:雖然權重是共享的,但是每個用户的對話記憶(KV Cache)都是私有的。
在Llama 70B模型裏,每個token按照FP8精度,要佔用160 KB的空間。一個用户對話如有8K上下文,單用户KV Cache 就要佔用1.3GB(即8192x160KB=1.3GB)。
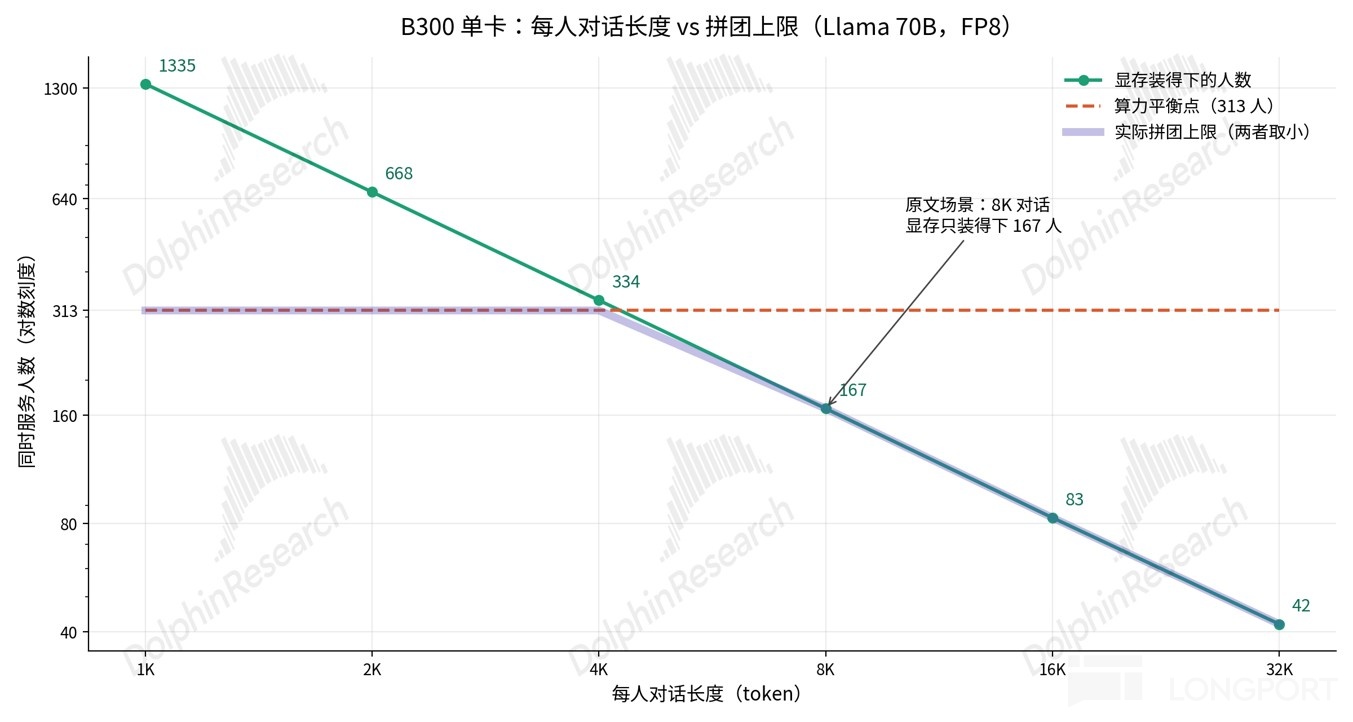
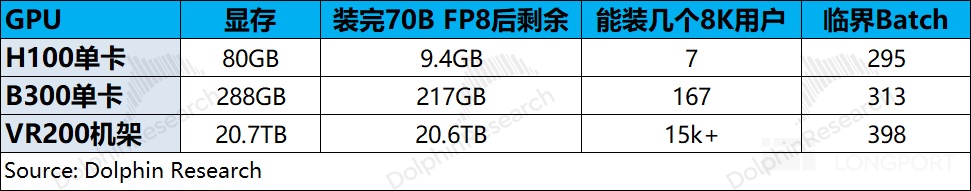
以B300單卡為例:顯存288GB,在裝完70B FP8模型參數後,HBM還剩217GB空間,一個用户佔1.3G的KV Cache,那麼一張卡也就同時服務167個8K上下文長度的用户。
此前我們測算的batch臨界值在313,這意味着實際拼團上限在167這個位置就到頂了,KV Cache已經把HBM塞滿了,限制了拼團的上限;
2)延遲與吞吐的死結:在吞吐(服務商的單位成本)改善的同時,拼團會帶來首字延遲(等團湊齊)、字間延遲(搶資源)的情況,這就導致所有GPU推理API都有“快但貴”和“慢但便宜”的兩檔。
基於“拼團”帶來的問題,GPU廠商(英偉達)也在尋求克服的方法:
方法一 從單卡邁向機架,擴大整個機架的顯存(打破KV Cache的天花板):從英偉達的H100->B300->VR200機架來看,機架級顯存方案能克服KV Cache上限的困擾,從而優化“拼團”的效果。
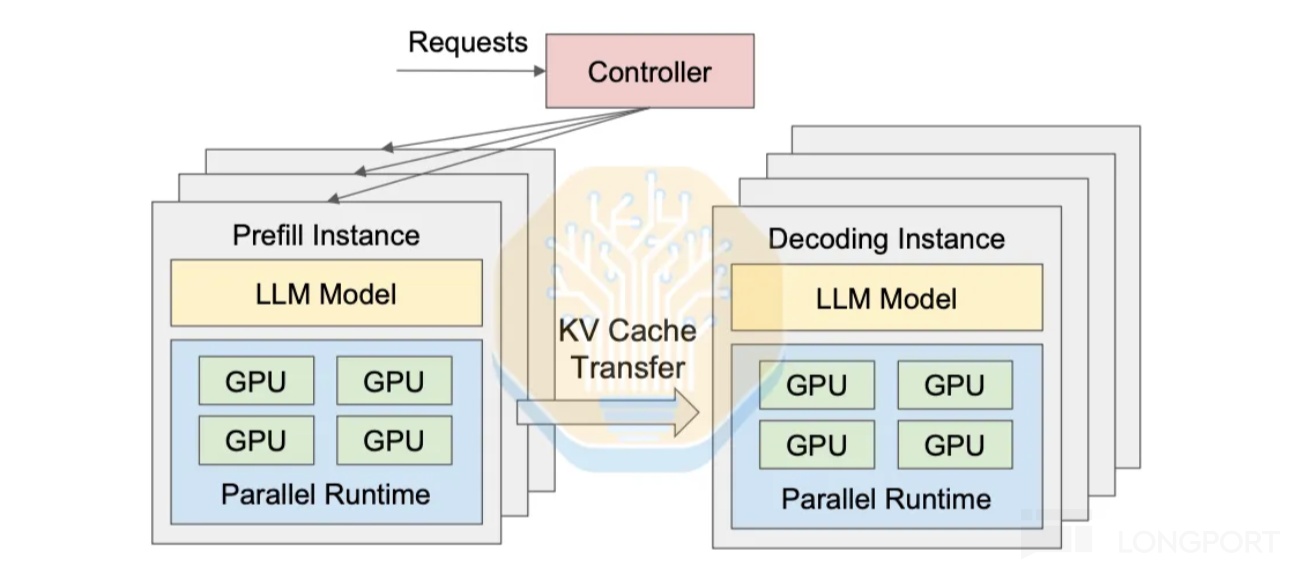
方法二 系統級分解——解耦推理(Disaggregated Inference):把Prefill(預填充,生成KV Cache)和Decode(解碼,消費KV Cache)拆成兩套獨立的GPU集羣,中間由KV Cache池連接。
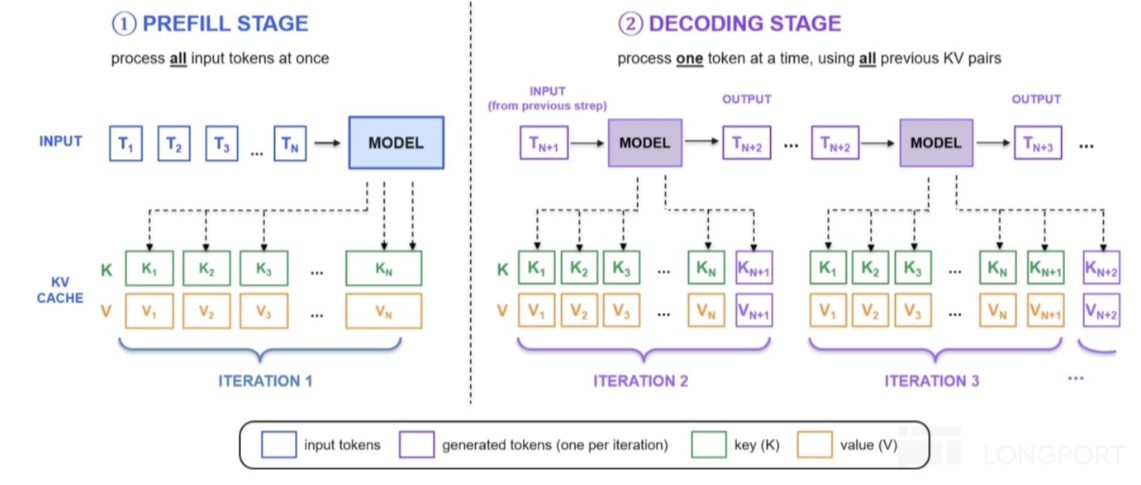
a)預填充階段Prefill:是處理完整的輸入上下文。它是計算密集型的,非常適合GPU 處理;
b)解碼階段Decode:負責預測新token,且受限於內存帶寬。解碼階段對延遲非常敏感,因為模型是逐個預測新token的。
在傳統GPU方案中Attention和FFN(前饋網絡)是搶着用HBM(爭帶寬);而英偉達購買Groq之後,新一代架構VR200引入了以Groq的LPU為核心的LPX機架,進一步將Decode拆分成Attention和FFN兩部分:
①Attention(回看前文):如果有前文,需讀歷史上所有token的K和V(=KV Cache)。VR200中的Attention能獨享全部HBM帶寬,不用和FFN搶帶寬;
②FFN(前饋網絡,使用自身知識來做計算):無或無需前文只看當前token來算,就使用LPX機架的LPU計算芯,這種芯片上的片上內存SRAM非常大,主要是存FFN權重。由於權重常駐SRAM,不需要從HBM搬運,可以實現極低的延遲計算。
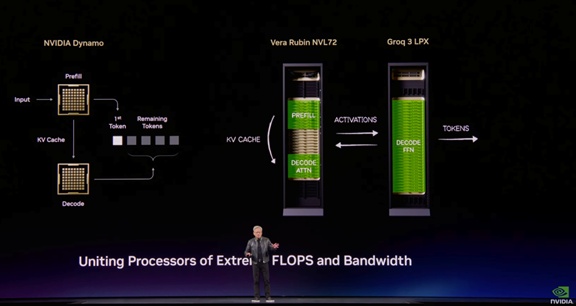
系統級分解將推理階段拆成了三段:Prefill(計算要求高)->Decode的Attention(KV Cache帶寬密集)->Decode的FFN/MoE(參數帶寬密集,但不依賴KV)。
針對於不同階段的關鍵要素,GPU廠商(英偉達)提供了不同的方案:
a)Prefill環節對算力要求高但對HBM帶寬要求低,可以選擇英偉達“讀題”專用芯片(如Rubin CPX)。
b)Decode 中的Attention需要在意KV Cache的讀取速度,仍需要通用GPU(如Rubin、B300);
c)Decode 中的FFN在意權重讀取速度,可以採用SRAM預存權重(如LPU、Groq機櫃),節省了從HBM輸送的時間。
在解耦推理後,相對理想的狀態是GPU僅執行Attention操作,其HBM容量可以完全分配給KV Cache,從而能增加其處理的Token總數,也提高了單個專家平均處理的數量/利用率。
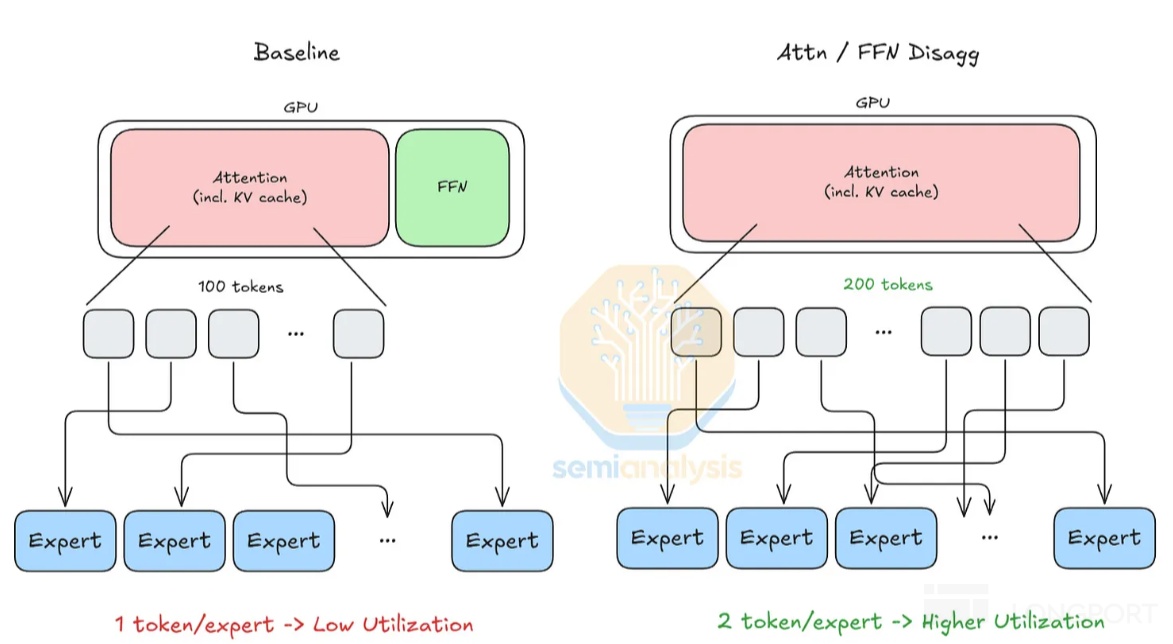
在英偉達從H100->B200/B300->VR200 NVL72的變化中:從H100到B200/B300,主要是在算力的提升,結構上沒有變動,這主要有助於Prefill階段;而從B200/300->VR200的改變更大,直接從結構上將推理拆成了三段。
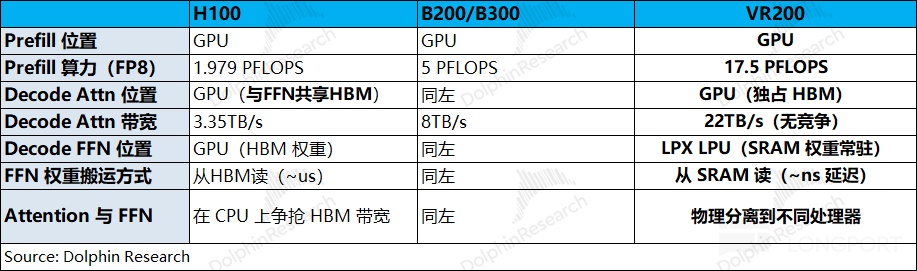
其中,LPU的片上SRAM放模型FFN權重參數。但KV Cache的讀取仍在HBM,“單次讀取的延遲時間”沒變,主要是減少搬運量。
綜合英偉達的VR200+LPU的方案,相對更適合於“長上下文+高交互+大MoE”的場景(DeepSeek-V4、Kimi K3等),而在“短上下文+低交互+Dense”的場景中(如此前的GPT-3 175B、Llama 70B等),解耦方案是並不適合的。
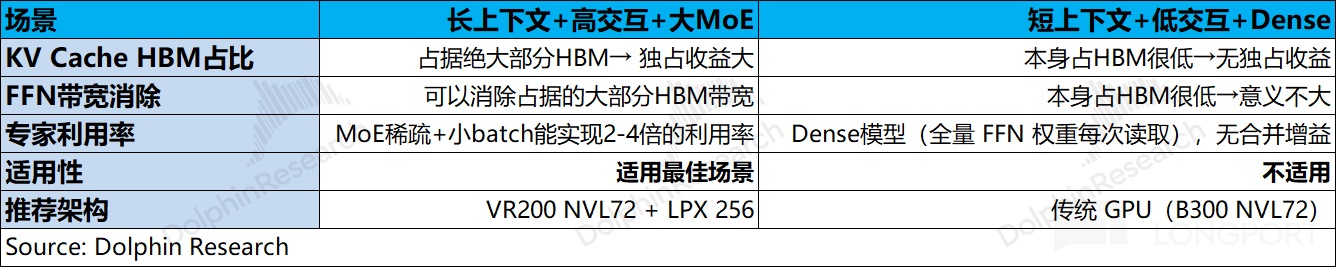
注:短上下文是指短對話(幾K token);超大Hidden Dim(超大隱藏維度)是指模型每一層的數據寬度很大,32k+的超大模型每層FFN達到11.3GB
三、Cerebras的WSE是怎麼造的呢?
GPU廠商(英偉達)選擇解耦推理並引入LPU,能一定程度緩解HBM擁擠的問題。由於LPU只承接了權重部分,KV Cache依然存在HBM,還是會受到HBM帶寬(22TB/s)的影響。
不同的是,在Cerebras WSE方案裏,KV Cache也直接存取在片上SRAM,片上帶寬(21PB/s),讀取延遲不到1ns(對比GPU方案0.1-1us),更適用於低延遲、願意為速度買單的客户。
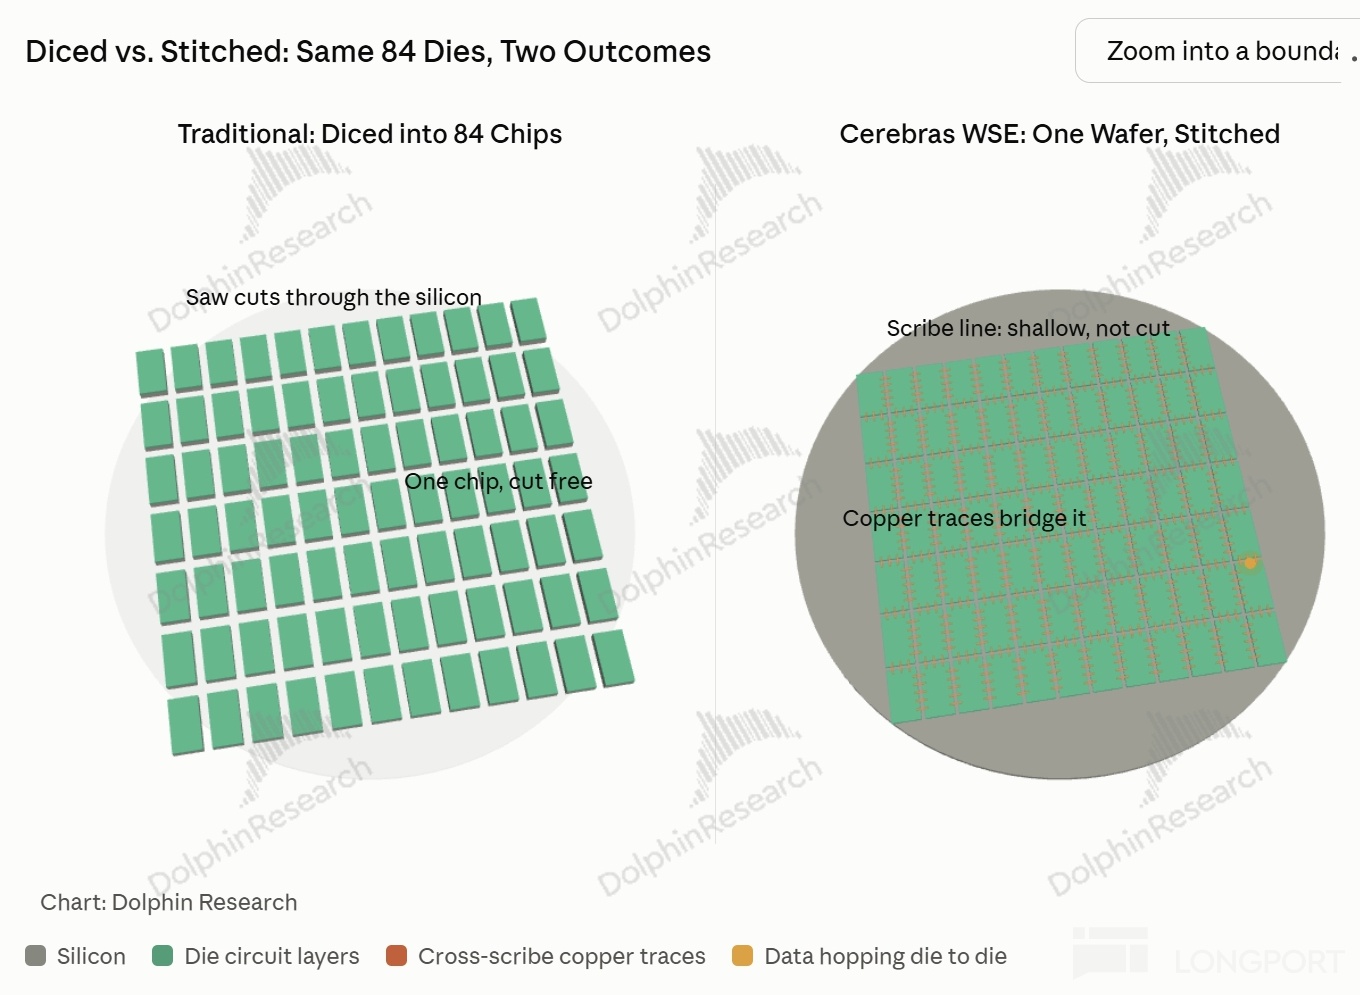
由於WSE與GPU方案不同,製造過程中也有着很大的不同。Cerebras的晶圓級芯片(WSE)是半導體工程史上最具顛覆性的設計之一。傳統GPU一般採用的是“晶圓切割成小芯片(Die)再封裝”,而WSE採用的是一整塊晶圓能切出來的最大正方形就是一個大硅片的方案。
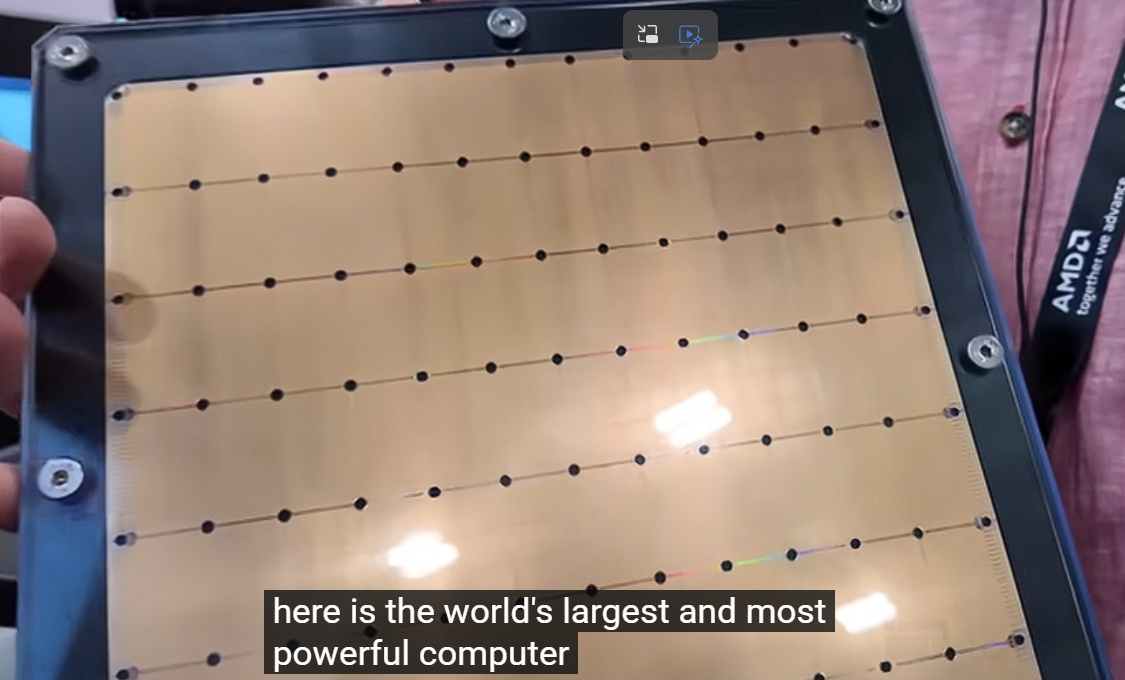
從上圖來看,WSE只是對單個直徑300mm的晶圓切割出21.5cmx21.5cm的最大正方形,而內部並未切割,採用“光刻視場縫合(Reticle Stitching)”技術。
這塊硅片是4.6萬mm²,但光刻機曝光有面積上限——單次最大曝光面積約26mm×33mm=858mm²,稱為一個視場/Reticle)。
一台光刻機要在晶圓上重複曝光84次,才能打滿這塊正方形區域,這也對應着WSE的84個Die。
傳統做法中,這84個曝光區域之間留有物理劃片槽,等待後續切割刀切開。而WSE的做法是:物理劃片槽依然存在,但在製造芯片頂層金屬線(Top Metal Layers)時,利用特殊的掩膜版,跨越劃片槽繪製出微米級的銅走線(作用只是起到純粹的物理連接),從而把這84個原本獨立的網格(Die)直接在硅片內部“縫合”連接成一條高帶寬的二維網格,這也就是上圖中看到的線。
WSE與傳統芯片明顯不同,那麼Cerebras具體是如何生產的呢?
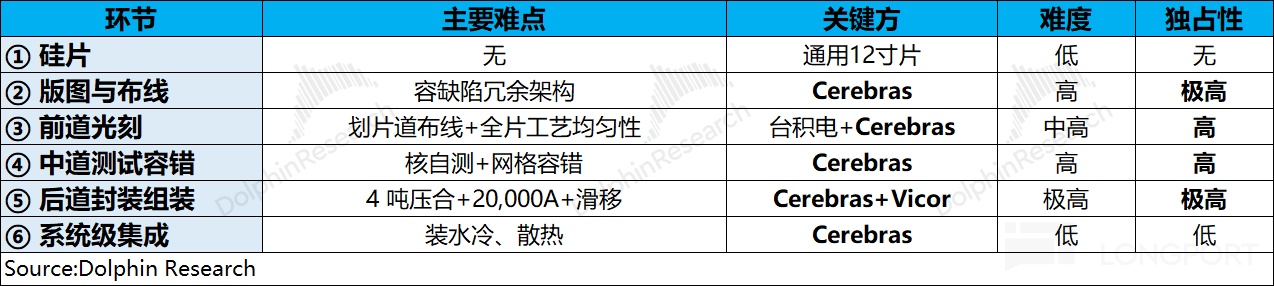
它需經歷“硅片->版圖設計及佈線->前道工藝(光刻)->中道測試與容錯->後道封裝/組裝->系統級集成”的過程,這與傳統晶圓/芯片的大體流程是基本一樣的,區別點在於部分環節的操作。
環節1:硅片製造(與常規完全相同)
WSE也是從標準的12英寸(300mm)高純度硅片起步,這一段的流程與所有芯片一致。從冶煉高純度石英砂(二氧化硅)開始,經過提純、拉單晶、切割、拋光和清洗,最終得到晶圓。
環節2:版圖設計與佈局走線(WSE特有)
常規芯片通常是芯片設計廠用EDA軟件設計版圖後,交給代工廠做掩膜版,而WSE的單核微架構太特殊,是Cerebras自己主導。
芯片上的“佈局走線”不只是物理版圖,還包含編譯器在運行時的邏輯佈局——芯片走計算任務時,84個計算區塊中,要繞過有缺陷的區塊,這是WSE容錯機制的關鍵支撐。
在這個環節中,主要涉及以下方面:
①單核微架構:設計一個38,000µm²的核。48KB SRAM(8個6KB bank,每bank 32-bit寬)+計算引擎(SIMD ALU、8個微線程上下文)+5端口路由器。自研ISA(指令集架構),不是ARM也不是RISC-V。
②核陣列版圖複製:把單核版圖在reticle(光刻視場)範圍內陣列複製。reticle(光刻視場)的物理上限858mm²(26mm×33mm單次曝光),Cerebras的一個計算區塊約550mm²,容納約11,548個核。
③冗餘與繞行邏輯設計:在版圖裏預埋冗餘計算核、冗餘路由、區塊時效時的繞行機制。這是設計階段就付掉的成本,不隨台積電的缺陷密度波動。
④劃片道走線設計:跨die的短線圖案。這需要台積電專門提供的劃片道設計規則,這不在設計廠給代工廠的施工説明書(PDK)裏。
⑤設計圖交付:用外購的傳統EDA工具做綜合、佈局佈線、DRC/LVS。唯一公開披露的外購IP是Synopsys DesignWare的片上傳感與監測模塊(SLM),主要是在4.6 萬mm²的這個大硅片上分佈温度、電壓、工藝偏差傳感器。
環節3:前道工藝(光刻——WSE的技術分叉點)
參考半導體前道標準流程(清洗→氧化/擴散→沉積→光刻→離子注入→CMP→金屬化),WSE同樣經歷了這些環節。這部分和跑一顆普通5nm芯片沒有任何區別,WSE是用步進重複曝光把同一張掩模版圖案重複曝光84次(550mm²的die)。
注:步進重複曝光是光刻機的一種工作方式。掩模版上的圖案,通過投影物鏡縮小後曝在晶圓的某個位置,然後晶圓台移動一步,再曝一次。
目前量產的WSE3是採用台積電5nm工藝,N5一般大約是15層金屬。
每一層都是同樣的四步循環:①沉積介質層(整片);②光刻打圖案(步進84次);③刻蝕出溝槽和通孔(整片);④填銅+CMP磨平(整片)。就這樣重複15次,打造15層樓。
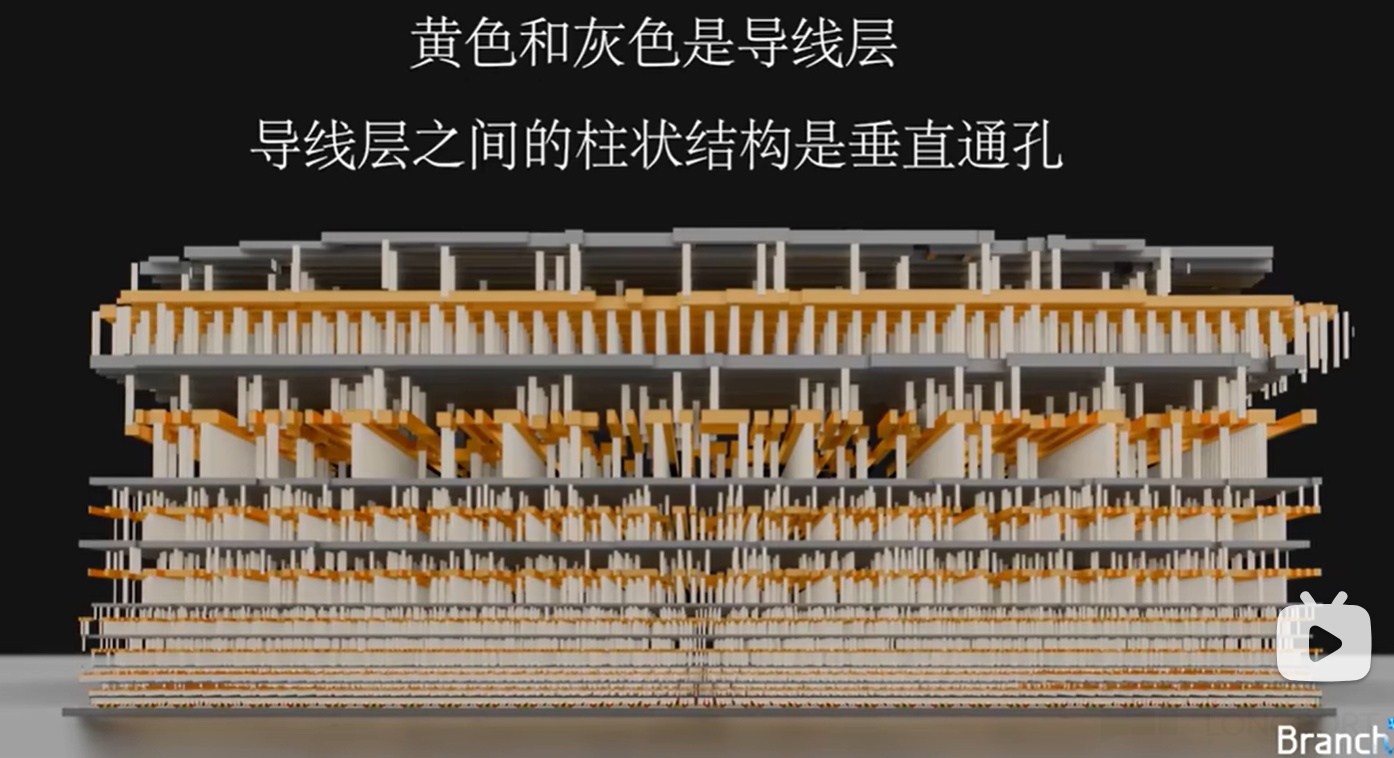
實際上在前面的12層基本是相似的,區別主要在13層及之上,WSE的掩模版變了。
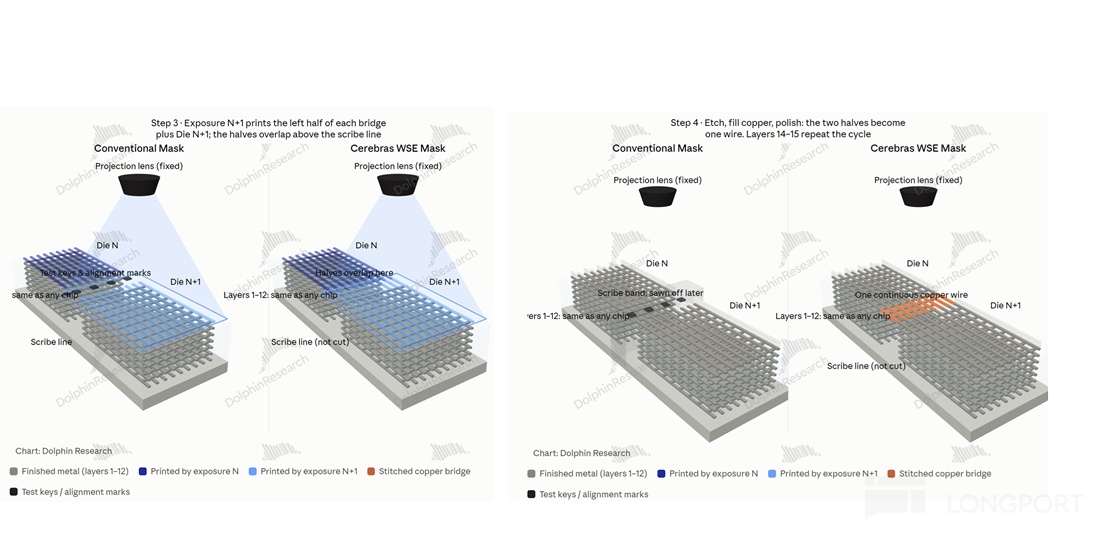
常規芯片的掩模版上,劃片道那條帶是留給工藝監控結構、套刻標記、測試鍵的。那是準備被鋸掉的地方,畫什麼都無所謂。
Cerebras的掩模版上,那條帶被改成了走線通道。跨越die邊界的短金屬線,長度不到1mm,這裏用到了跨劃片線晶圓級互連技術,類似於在高層架天橋。
這是最關鍵的地方,這裏的一根跨界的線:一半畫在曝光場的右邊緣、一半畫在左邊緣。即:第 N 次曝光(die本體+右側半截天橋)->晶圓台移動一步->第N+1次曝光(左側半截天橋+die本體) ->兩個半截在劃片道上空對接,連成一根完整的線。
由於要設計跨界的線,所以要替換掩模版。天橋不需要額外的曝光次數,兩次曝光的天橋對接是靠晶圓台的步進精度完成。具體的工藝流程與前12層基本相似,區別主要是在掩模版上增加了天橋。
劃片道上的銅,和die內部的銅,都是同一次沉積、同一次刻蝕、同一次CMP的產物。 用的也是同樣的設備、同樣的材料和同樣的參數。
高層做?是因低層的線太細了,納米級的對接誤差會直接斷線或短路,良率歸零。高層微米級的容差寬鬆兩三個數量級。
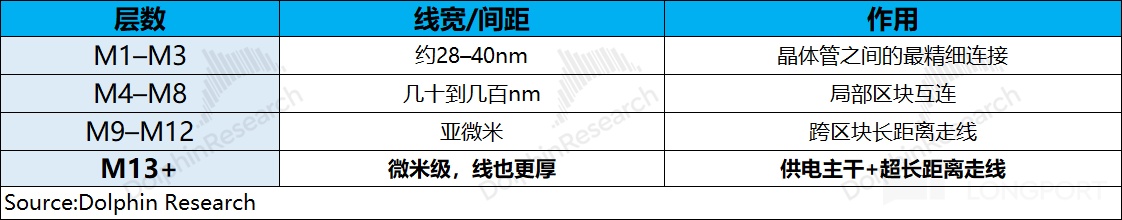
實際上“高層架1層天橋”是理論上夠用的,但考慮佈線靈活性和冗餘,推測大概率會架2–3層。普通晶圓的劃片線是切割芯片時的“禁區”;Cerebras在劃片線上進行佈線,從而將84個die全部連成一個整體。
環節4:中道測試與容錯
傳統晶圓過程中要在切割前,對晶圓上每顆die做電學測試,壞die需要打墨點或記入電子地圖。在沿劃片道全部鋸開後,把壞的die丟棄掉,好的die送去封裝。
WSE測試的目的不是挑出好die,而是摸清整片晶圓上哪些核心壞了、壞在哪。WSE中的84個die被金屬線縫成一體,對外的I/O只在整片的邊緣。沒有任何物理通道去單獨訪問中間某個核,因而WSE採用的是全片測試。
網格中每個core都自帶SRAM(48KB)和路由器,即每個core具備“自己運行測試程序+通過路由器網絡把結果傳出去”的物理條件——這正是“自測(核自己測自己)”的最小硬件基礎。測試下來:
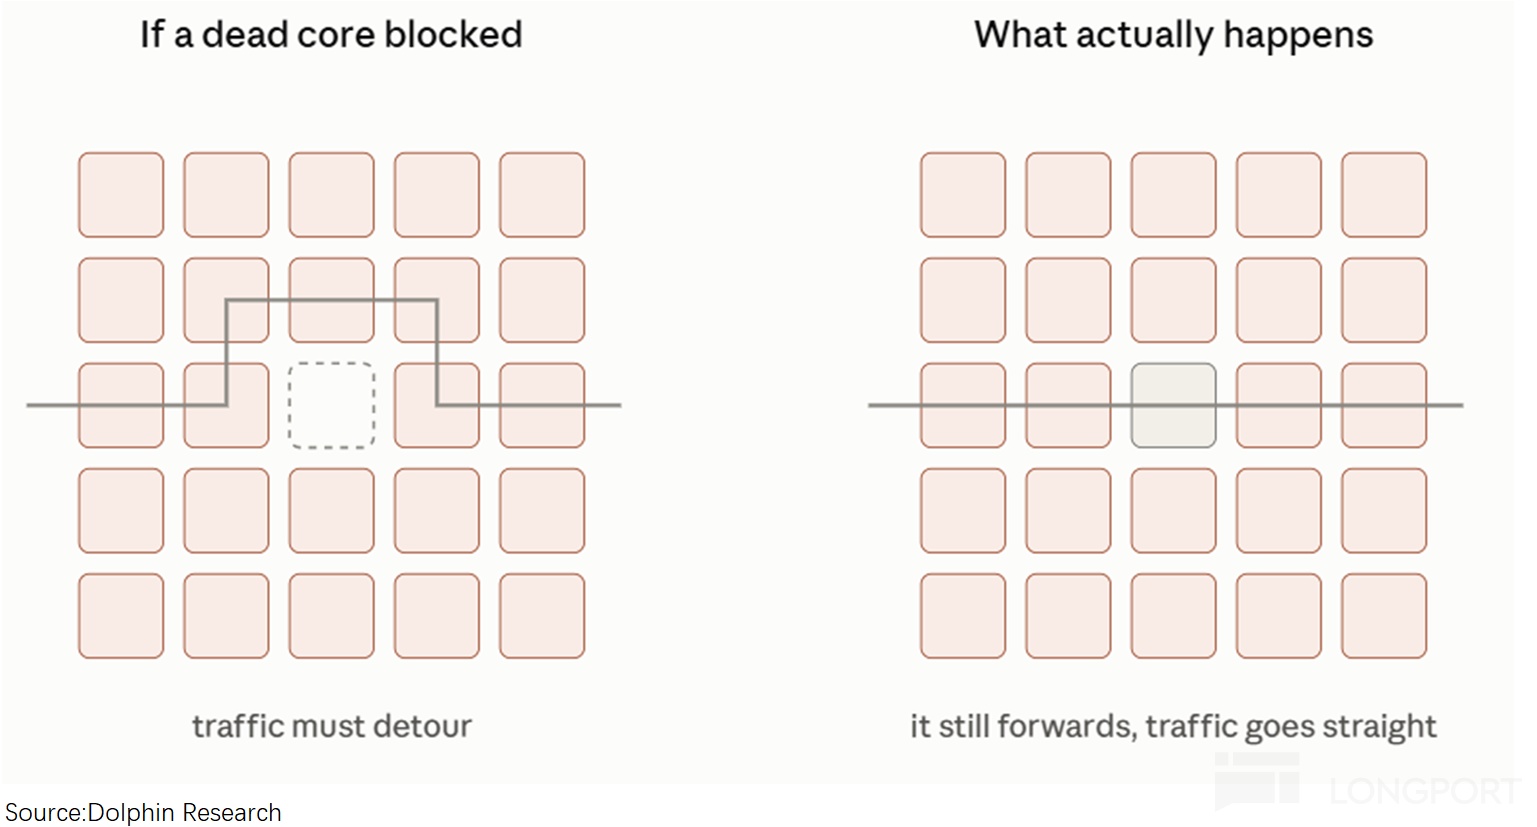
①一個core的路由器壞了:等於路壞了,自己區塊的數據報不了,其他區塊數據無法經過,等於區域性失聯了。這種需識別是單一區塊壞了,還是這個區塊的數據路徑斷了。
這需通過冗餘路徑探測(如從多個方向、多個邊緣端口交叉驗證)才能判別,因此一開始就對core設計了從東南西北四個方向的冗餘路徑。
②“壞核”:WSE的Core=計算單元+本地SRAM+路由器,即計算和路由在物理上是分離的部件。路由器活着,計算和存儲壞了,這個區塊可以繼續當純轉發節點。但路由器廢掉,無論計算和存儲是否可用,這個Core就算壞死了。
環節5:後道封裝/組裝
在Cerebras的WSE製造中,台積電主要參與了“前道晶圓製造+晶圓級互聯(Fab內)”工作,之後封裝和整機系統集成(Fab外)基本都是由Cerebras完成。
在前道製造完成後,台積電在晶圓交付前完成了以下關鍵的中後道處理:跨劃片槽金屬互連(台積電和Cerebras聯合研發)和全晶圓級鈍化及凸塊(台積電在未切割的整塊300mm晶圓表面做全盤鈍化保護,並製作高密度的Micro-bumps/C4凸塊,用於引出電源和信號觸點)。
簡而言之,台積電交付的是一張打好了金屬凸塊、帶有跨掩模互連線的300mm硅晶圓。接下來的系統級物理封裝,台積電沒有參與,全部由Cerebras自研。
這是一塊300mm的硅晶圓,775微米厚,沒有一個電源接口,沒有一條數據通道,沒有任何散熱方式。Cerebras接下來要做的是,把這個硅晶圓變成一台機器。
首先對直徑300mm的硅晶圓沿着215mmx215mm的外框切一刀,把圓片四周的月牙形邊角料就是廢料,大約浪費35%的面積,得到一個正方形硅片(上文中成品樣式)。
接下來的問題,主要是對外數據連接與通電兩大難題:面積太大,功率23千瓦(相當於十幾台家用電磁爐同時全功率運轉)。傳統封裝下,一通電就把自己燒死了。
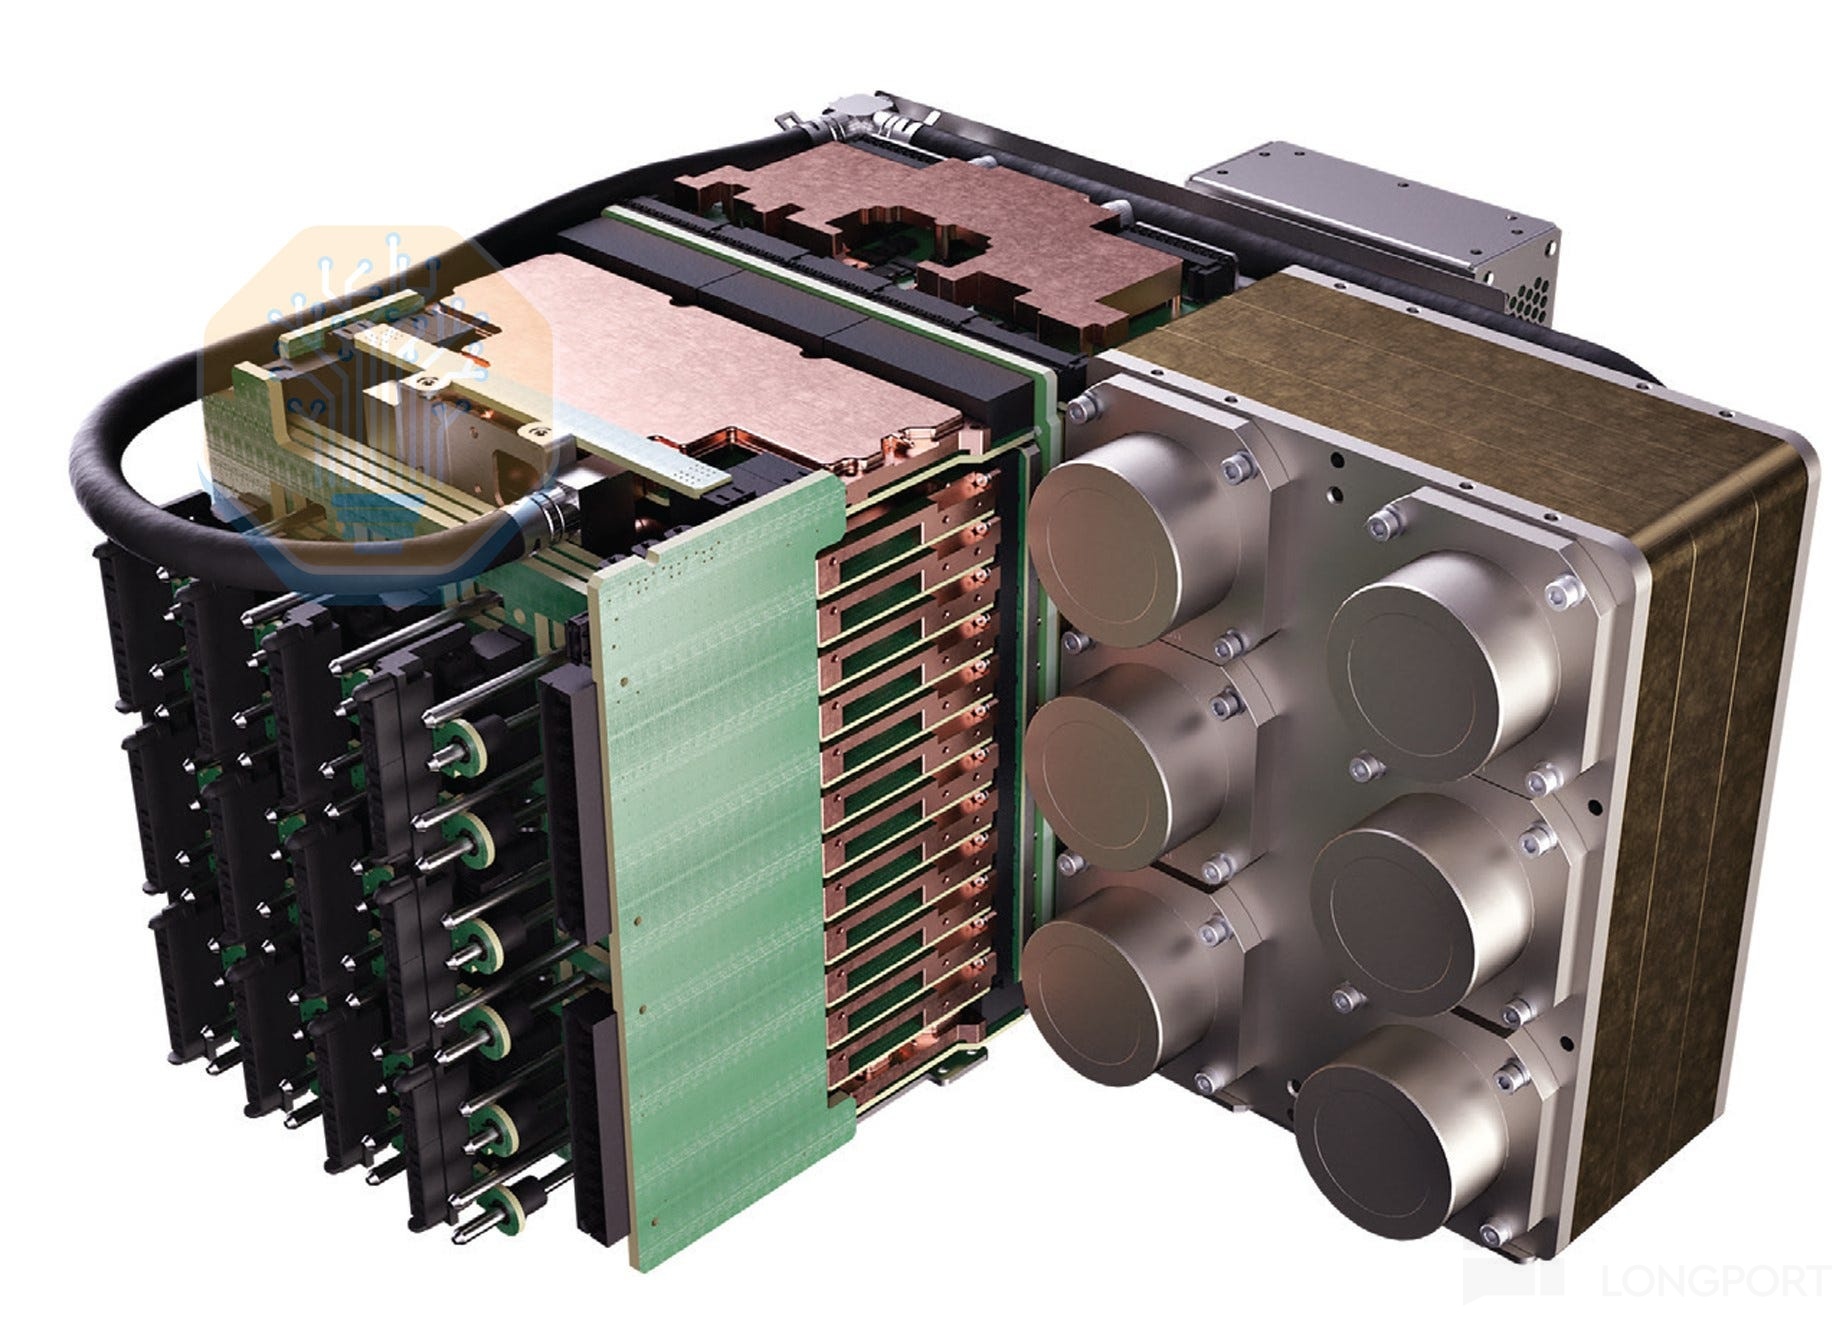
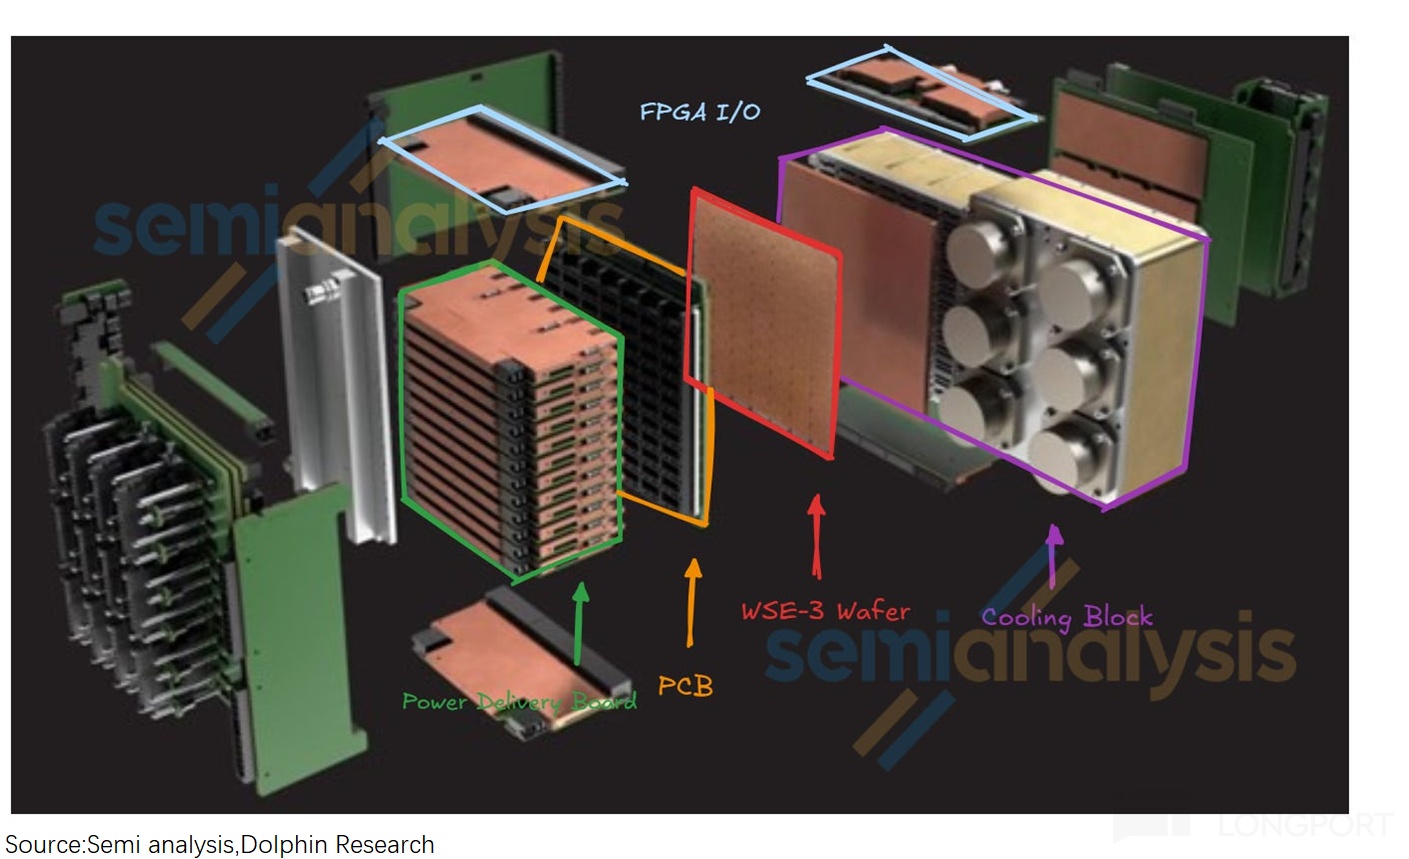
面對這個難題,Cerebras設計了四層三明治結構“冷板+晶圓+柔性連接器+PCB”,公司將其稱之為“engine block”(引擎缸體),這也是Cerebras的核心技術。
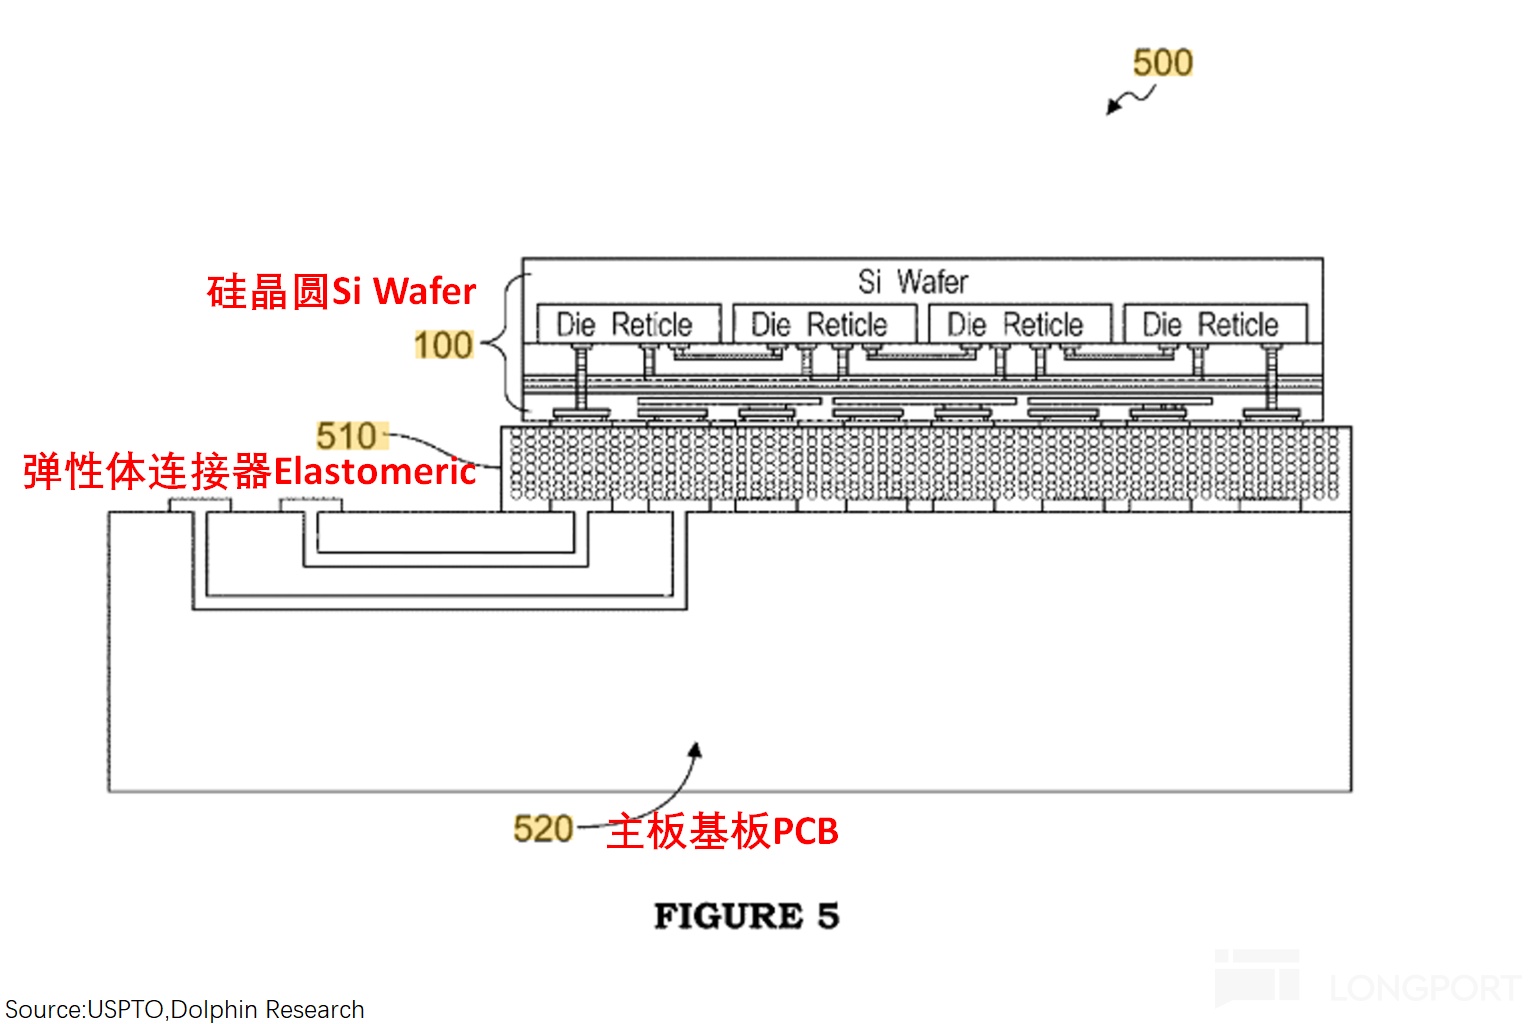
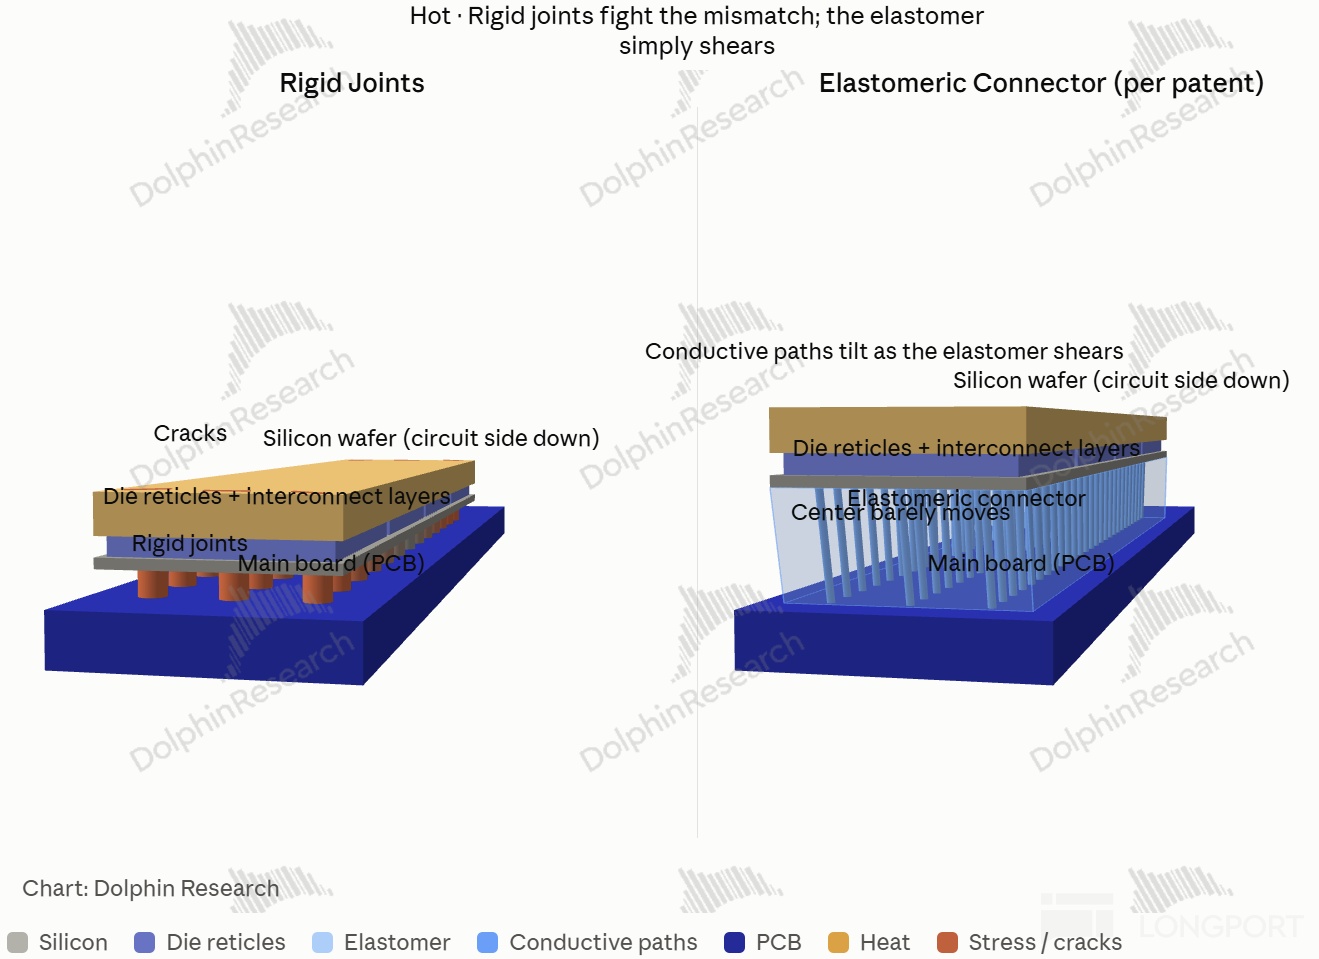
①首先需要將215mm見方的正方形硅片接到PCB電路板上,但傳統的焊接方法是無效的,開機後的高温使其撕裂。硅晶圓受熱膨脹的程度和下方標準電路板完全不同。如果直接用錫球焊死,只要芯片一發熱,膨脹差會像剪刀一樣直接把所有焊點全部剪斷。
Cerebras設計了一種定製的帶微型彈簧/柔性觸點的專用連接介質,放在PCB和大硅片之間——由數百萬根像“微型彈簧”構成的柔性墊圈,專門用來吸收兩側不同的熱膨脹。
當硅片發熱變大時,彈簧會向側向微微彎曲橫移;當硅片冷卻縮小時,彈簧又恢復原狀,用“以柔克剛”的方式化解了足以炸裂芯片的熱應力。
②在給硅片安上電路板後,還需要搭建“摩天大樓式”垂直供電系統(3D Vertical Power Delivery)。
WSE的峯值功耗高達23千瓦(23,000 W),而先進半導體核心工作電壓極低,僅為0.8V左右。這需給晶圓注入高達20,000+安培大電流,足以瞬間熔化普通鋼纜或焊接重型鋼軌。
用傳統的邊緣供電:a)距離太長,電流需要走過10cm的銅線才能到達晶圓中心,且到了中心電壓已衰減到沒有了,晶圓中間大部分區域根本分不到電。
為了解決上述難題,Cerebras垂直供電:把整個電源模塊(VRM)直接壓在了晶圓的正下方,讓電流垂直向上直達晶圓背面,輸入48V(甚至 54V)直流高壓,電流低了,就不會發熱過載。再把這48V的電壓,用降壓板,分成0.8V的小電壓,分給84個die。
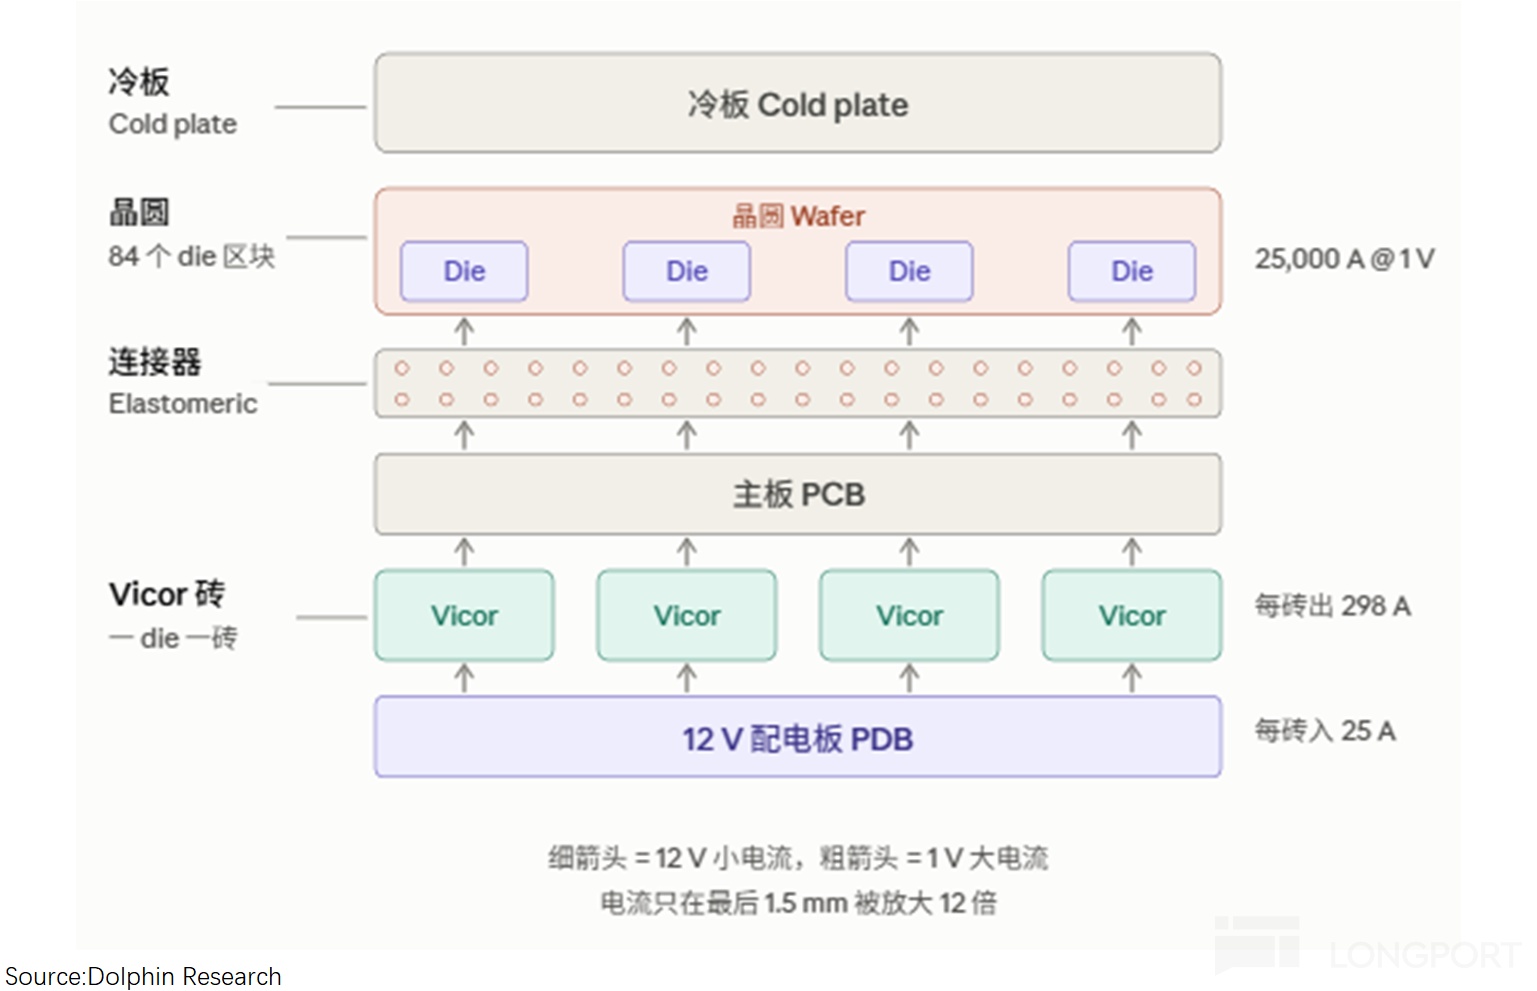
③在完成線路對接和供電搭建之後,還需要為這個23kW“火爐”(相當於十幾台全功率運行的電磁爐)安裝直貼微通道水冷冷板。
“直貼微通道水冷冷板”就是一片銅冷板——背面機加工出微鰭片通道、正面拋光後靠預載力直接壓在晶圓背面,冷卻液在通道里流過把20kW+熱量帶走。
Cerebras的冷板-晶圓接口採用了“拋光滑合+預載力+相對滑動”設計:其中拋光能減少熱阻和滑動阻力;預載力(壓力)越大,微凸點壓扁越多,接觸面積更大;相對滑動指的不是粘死,可以像熨斗那樣貼着滑動。
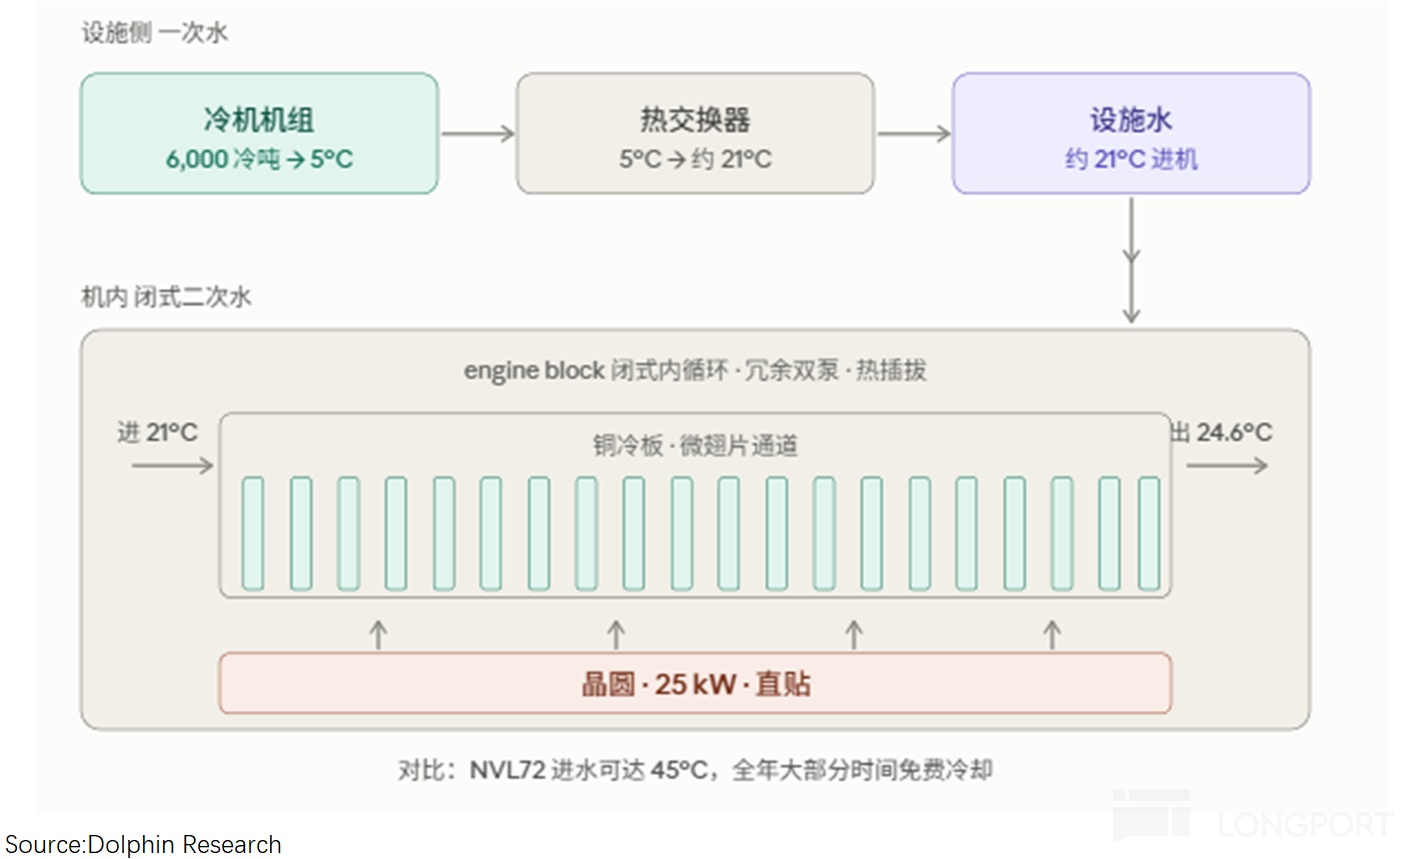
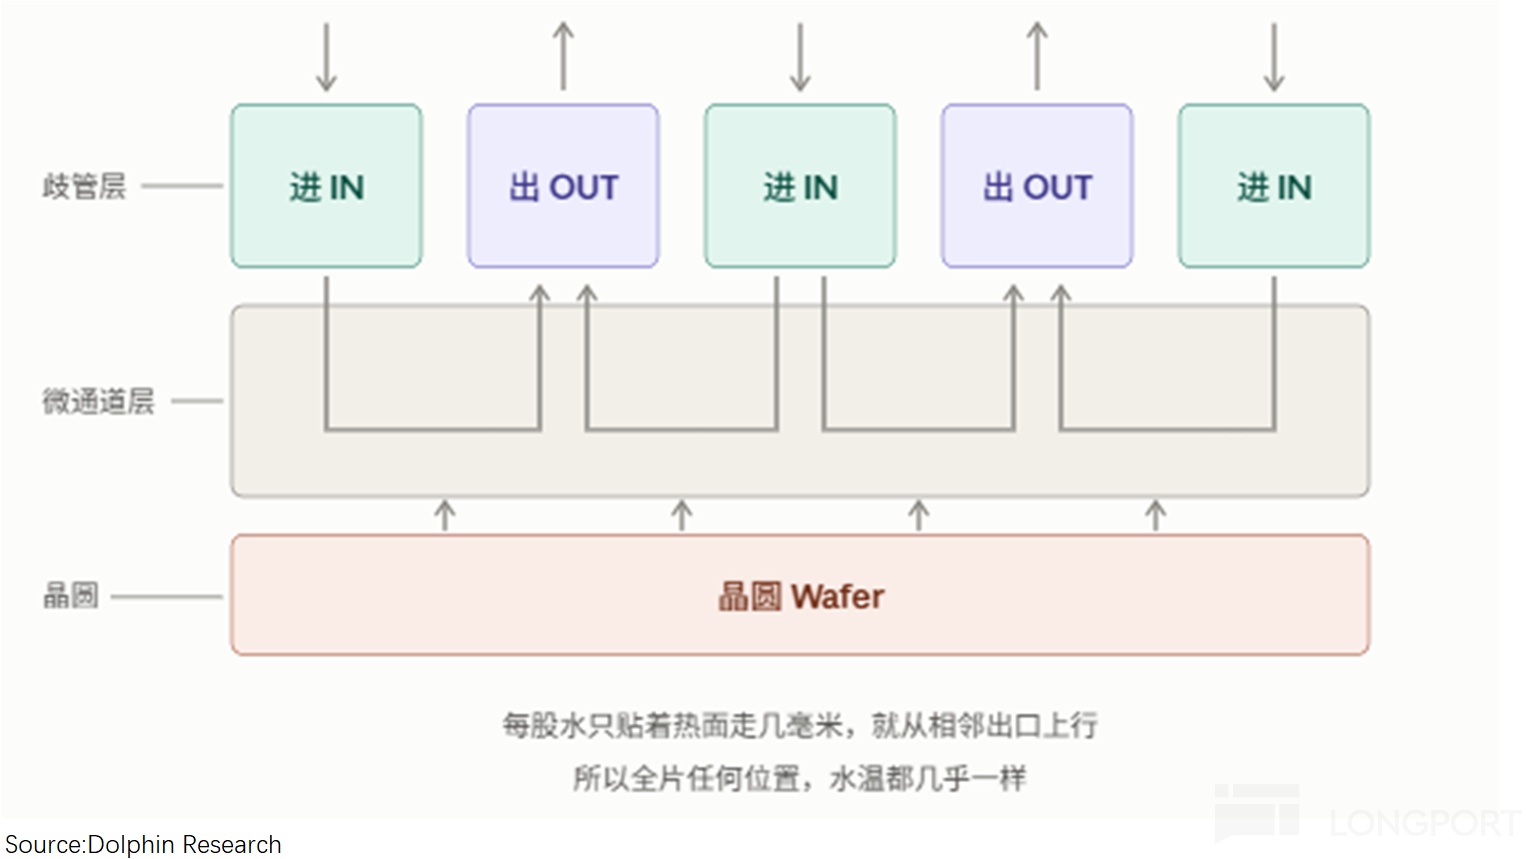
Cerebras徹底放棄了傳統單向平流水冷,發明了垂直三維分流歧管技術:就是在冷板內部不是一條長管道,而是被劃分成了成百上千個微型冷卻單元陣列。冷水通過頂部的歧管,像無數個微型花灑一樣,垂直直接噴射到各個局部區域。
在①+②+③基礎上,將四層零件(冷板+晶圓+柔性連接器+PCB)組裝成一個engine block(引擎缸體),全部的電連接(晶圓-PCB)和熱連接(晶圓-冷板)都由壓力維持。
因為晶圓、彈性連接器和PCB都很大,正確裝配並維持系統壓縮,可能需要高達4噸甚至更多的壓縮力。在壓完之後,再用緊固件把晶圓固定在PCB和熱交換器之間,實現長久維持。
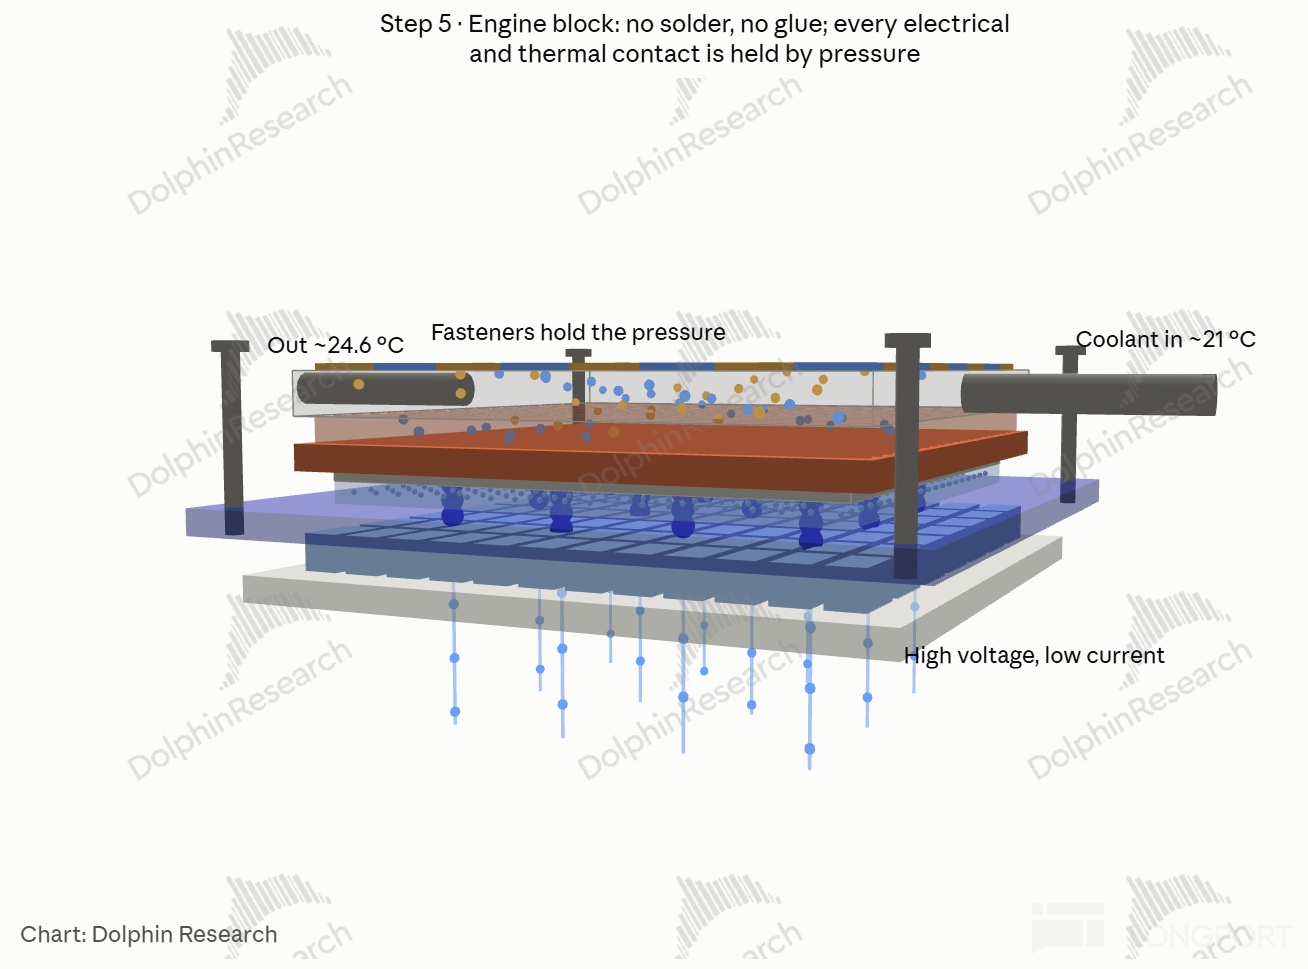
由於被壓的對象是215mm×215mm×775µm、重83克的裸硅,任何一處局部壓力集中都會把它壓裂。所以4噸不是“壓下去”那麼簡單,是要讓這4噸在半平方英尺上分佈得極其均勻,因而整套裝配機器是100%定製的。
從四層堆疊到WSE模組,靠的是“插+壓”兩步:晶圓先通過彈性體插槽插上 PCB,冷板拋光面再在預載力下壓緊晶圓背面——用Cerebras自研的組裝工具完成四層夾心壓合,接上冷卻歧管後模組成型,這是公司的核心技術。
環節6:系統級集成
從WSE模組(engine block引擎缸體)到計算整機,需要裝信號接收器、裝電、裝水冷、裝散熱出口。全程Cerebras都是內部組裝測試。
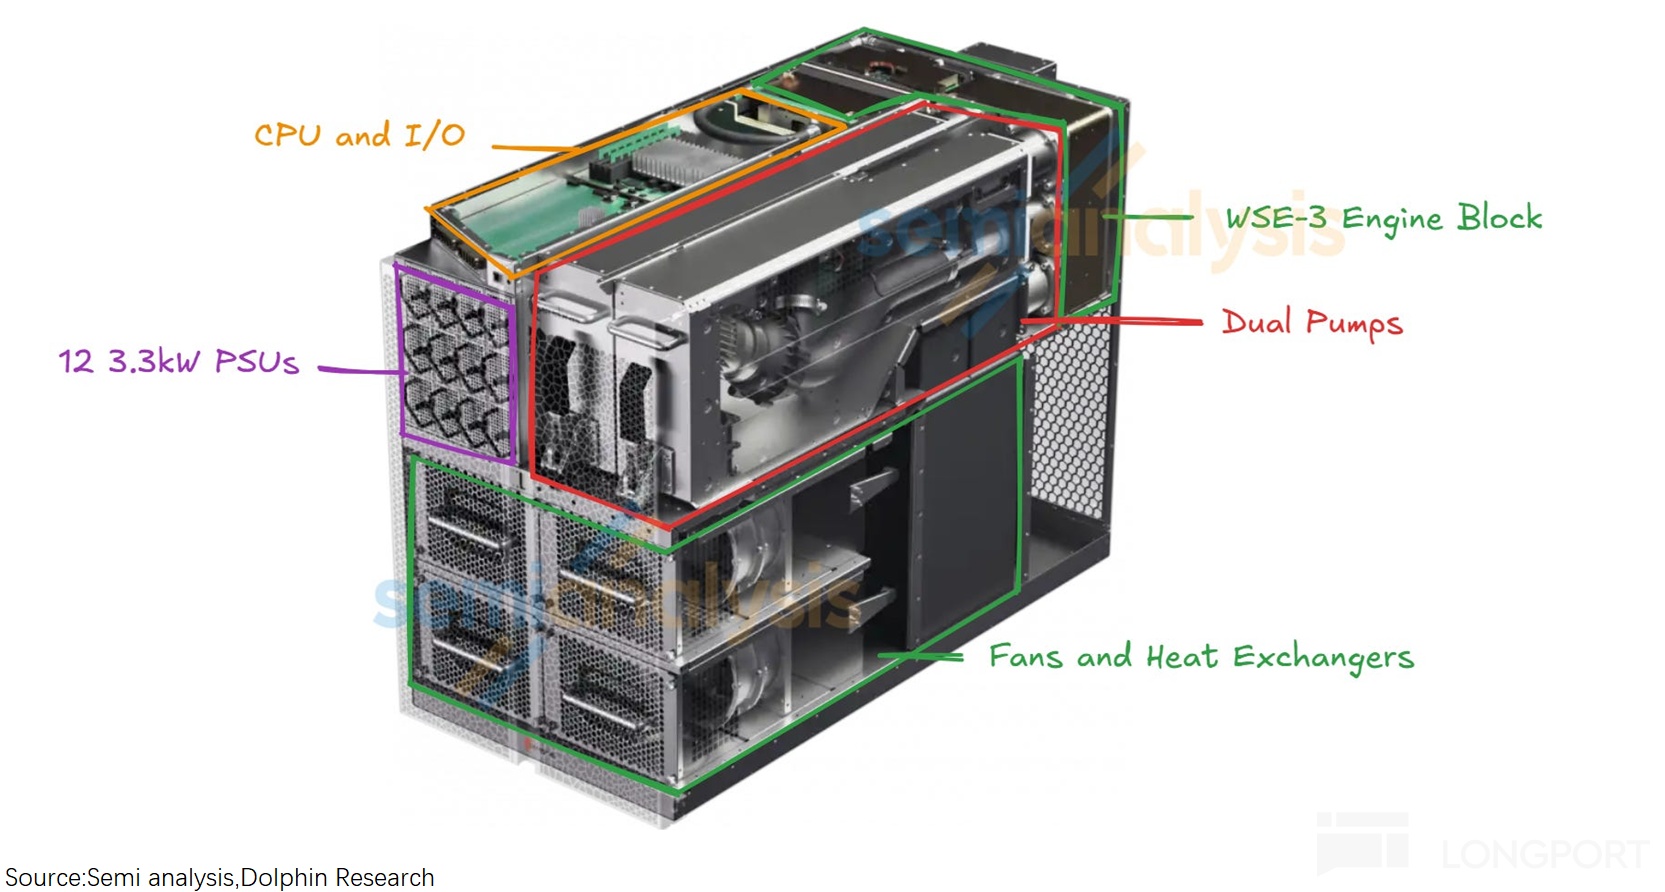
①裝信號接收器:在WSE引擎組件的頂部安置着I/O FPGA模塊(網卡功能),該模塊通過板對板連接器與WSE PCB相連。功能內是傳遞Cerebras專用I/O信號,並將其轉換為用於橫向擴展的以太網信號以及PCIe信號;
②裝供電和水冷:a)12個3.3kW電源單元+12塊PDB,通過盲插式電源連接器接進engine block;b)把engine block的冷板水路接到機箱的黃銅歧管上,並裝上了雙泵(其中一個備用),泵是冷卻系統的“心臟”。
③裝散熱出口:冷卻液在機櫃內轉圈,但熱量必須最終排到室外。冷板吸的熱不能永遠留在水裏,必須通過換熱器“交棒”給另一路(設施冷凍水或室外空氣),也就是圖中的熱交換器。
綜合上述6大環節就是CS整機的製造全過程。 環節2到環節6基本都有Cerebras參與,尤其是在難度相對較高的版圖與佈線、中道測試容錯和後道封裝組裝等核心環節基本都是由Cerebras獨立完成,台積電主要參與其中的前道光刻環節。
機架級整機的組裝測試是由Cerebras內部完成,交付物是一台台“成品機架”。值得注意的是,一台Celebras整機在出廠後,也不能直接使用,還需要做落地配套,需要:
設施評估->機房改造->上架與接管路(水、電、光纖)->接外圍系統(主機服務器、Memory X【存權重4TB-2.4PB】、SwarmX【多機廣播與規約】)->軟件棧部署與模型加載(CSL、Cerebras編譯器)->持續運維。
這樣看來,CS的設施改造代價是相當高的,但它的目標客户是能“把毫秒級延遲直接換算成收入”的玩家(OpenAI、AWS、高頻交易、實時交互)。在這些場景裏,CS的21PB/s片上帶寬帶來的速度優勢是GPU給不了的。
本篇文章主要是梳理Cerebras的WSE(晶圓級引擎)產品是什麼、能解決GPU什麼問題、以及WSE是如何製造以及難點在哪。在下篇中將主要對Cerebras公司的經營表現以及未來展望展開,歡迎關注。
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。