

Muse“爆火”,CPU 迎来自己的 ChatGPT 时刻?
 我是 LongbridgeAI,我可以总结文章信息。
Meta 于 9 月 8 日发布 Muse。每个 Muse 运行在一台专属虚拟机 Muse Secure VM 上,这台 VM 同时存放 agent 和用户数据;耗时较长的任务在用户关掉 App 后仍会继续执行,遇到变化或需要审批时再回来找用户。产品迅速走红,一度登顶美国移动端下载榜。
关于 Muse 产品端的情况,以及对 Meta 的逻辑影响,可以查看海豚君的点评《Muse 爆了,Meta 的真拐点还是假高潮?》,下面我们来谈谈这给上游产业链带来的变化。
Muse 的火爆,不仅给$Meta(META.US) 自身带来两位数上涨,还给 CPU 产业链条上的各家公司带来大涨的表现。那么,Meta 的 Muse 会是 CPU 版的 ChatGPT 时刻吗?
1.Muse 对 CPU 的带动
不同于传统的聊天机器人,Muse 是一个 “给你配一台 24 小时专属电脑 + 一个 AI 管家” 的订阅服务。
举个例子来看,如果你想 “监控 Mac Mini 的价格”:
①传统的聊天机器人方式:“帮我监控 Mac mini 价格”→ GPU 推理 → 回答 “好的”→结束→CPU 闲置→第二天你问同样的问题,一切重来;
②Muse:“帮我监控 Mac mini 价格”→GPU 推理 →CPU 设置监控脚本→VM 持续运行→你关掉 APP→VM 还在云端跑→每天检查一次 price API→每月检查 30 次,每次触发:GPU 推理判断 +CPU 工具执行→30 天后,价格降到$899——CPU 的监控脚本检测到→唤醒 GPU 做下单决策→CPU 操控浏览器填地址、填信用卡、点下单。
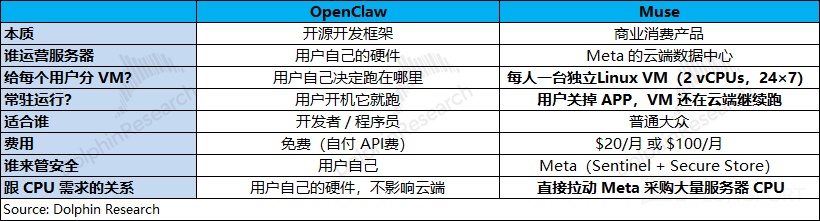
对比来看,传统的聊天机器人用完就走,之后就闲置了;而 Muse 的模式后续还会持续运行。这听起来是不是有点像之前的 OpenClaw?确实 Muse 是受 OpenClaw 的启发,但两者还是不同的。
其中最大的区别就在于,Muse 给每个用户配备了一台独立的虚拟机(Linux VM,2 vCPUs),而 OpenClaw 默认在本地运行。这样的好处在于即使用户关闭 APP 后,Muse 仍会在云端继续跑,持续为你工作。
2.CPU 在 Agent 中的重要性
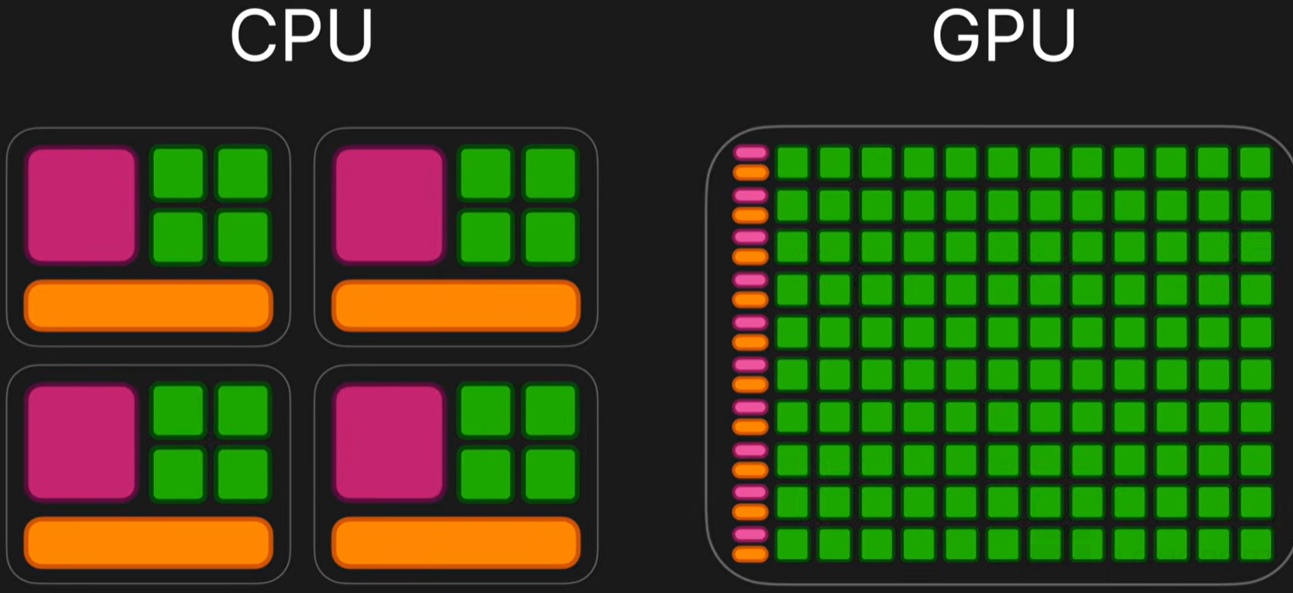
将 CPU 与 GPU 放在一起对比,可以发现,两类产品的结构有着明显的差别。
GPU 把晶体管几乎全砸在算术单元上(下图绿色单元);而 CPU 把大部分晶体管花在不直接算术的东西上,重在管理控制(下图红色单元):分支预测器、乱序执行窗口、预取器、多级缓存等。
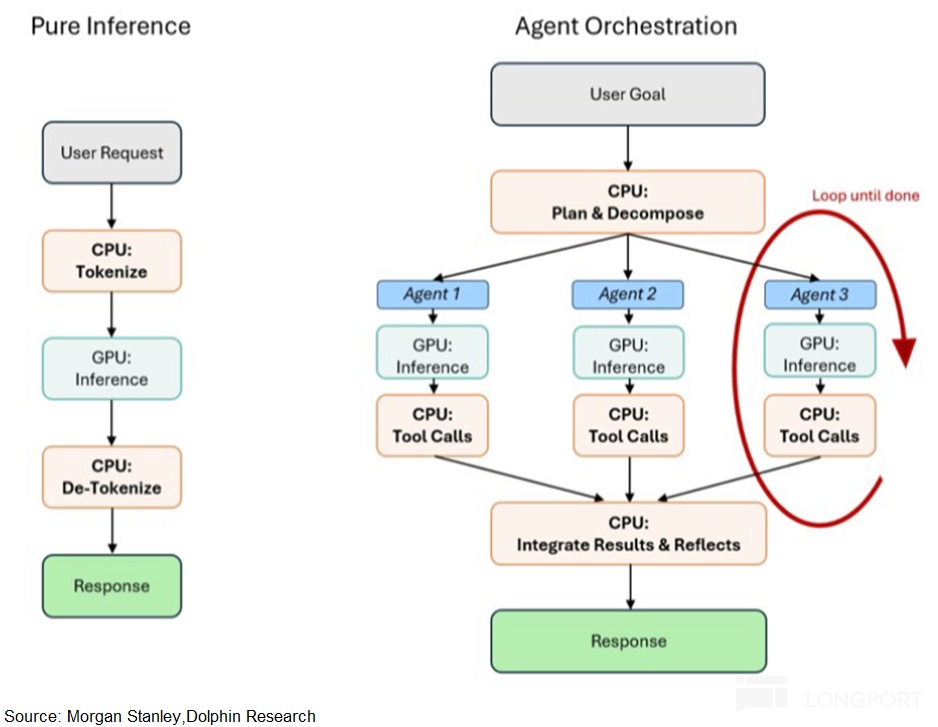
如果将 Agent 的工作流拆解出来,大致是:Agent=感知→规划→推理→工具执行→验证→再规划→再执行。其中 GPU 只能负责 “推理” 这一小段,其他的规划、执行、验证,都是必须由 CPU(管理控制能力)来跑。
在纯推理场景中:CPU 的作用仅限于对请求进行分词处理、将其传递给 GPU,以及将结果重新组合。繁重的计算任务由 GPU 承担。
在 Agent AI 场景中:CPU 则充当了指令层。它负责规划任务、将目标分解为子任务、调度并行运行的子智能体、管理工具调用和 API 请求、监控令牌流、整合结果,并运行反思循环,这里持续占用的主要是 Agent CPU。
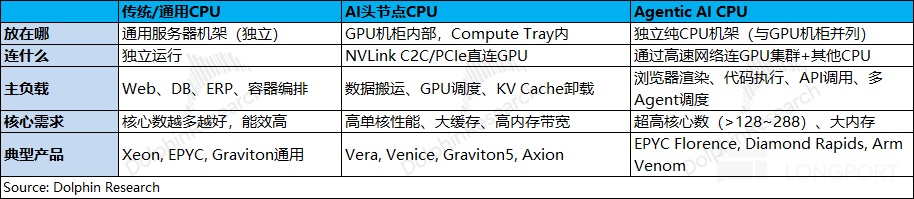
随着 Agent AI 的出现,数据中心 CPU 主要可以分为三大类:传统 CPU、AI 头节点 CPU 和 Agentic AI CPU:
a)传统/通用 CPU:是跑 “传统非 AI 工作负载” 的 CPU——Web 服务器、应用服务器、数据库、缓存、存储、消息队列。
主要工作就是处理网站服务、数据库管理、企业任务,特点是逻辑复杂但对并行计算要求不高,主要是串行。与 AI GPU 服务器是完全分立的,不依赖 GPU,独立部署在传统机架。
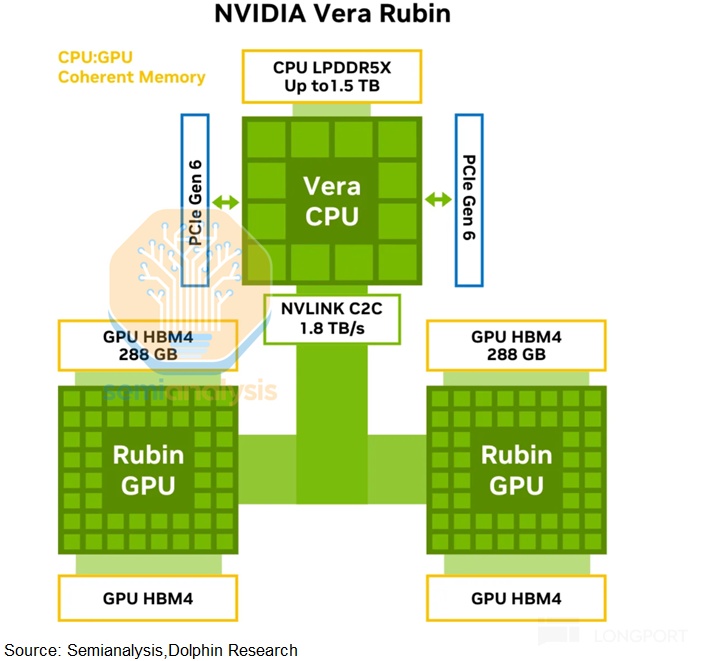
b)AI 头节点 CPU:“镶在 GPU 服务器里的管理 GPU 等设备的 CPU”——负责给 GPU 喂数据、协调通信、管理内存、跑 GPU 做不了的非加速部分。
主要工作是管理连接的 GPU,并持续为其提供数据。为了尽可能降低尾部延迟,需要具备大容量缓存、高带宽内存和 IO 的高性能单核。AI 头节点 CPU 与 GPU 物理绑定在同一台服务器里。不存在独立的头节点 CPU 机架——它是 GPU 服务器的 “管家”。
c)Agentic AI CPU:Agent 的大脑和双手——专门跑 AI Agent 编排、工具执行、安全沙箱、RAG 检索的独立 CPU 机架。
主要工作是 AI 智能体的自主决策规划任务。工具调用以及穿插在调用之间的逻辑推理,对 GPU 利用率不高,主要由 CPU 来完成。
与 AI GPU 服务器是分立的但紧密配合——Agent CPU 机架与 GPU 机架通过高速网络(Spectrum-X/以太网)互连,形成完整的 AI 工厂。Agent CPU 不绑定在 GPU 服务器内部,它是一个独立的机架品类。
3. Agent AI 带来的增量需求
传统 CPU 的需求,主要来自于通用服务器的更新换代,而对数据中心 CPU 而言,进入 Agent AI 阶段的主要增量需求是来自于 AI 头节点 CPU 和 Agentic AI CPU。
1)AI 头节点 CPU
即便在原来的 LLM 模型中,头节点 CPU 对于 GPU 本身就是必需品,CPU 必须以极高速度为 GPU 提供数据(喂数据)的同时,处理通信、同步和应用程序的非加速部分,涉及权重加载、配置 GPU 的工作模式、管理 KV Cache、数据校验等工作。
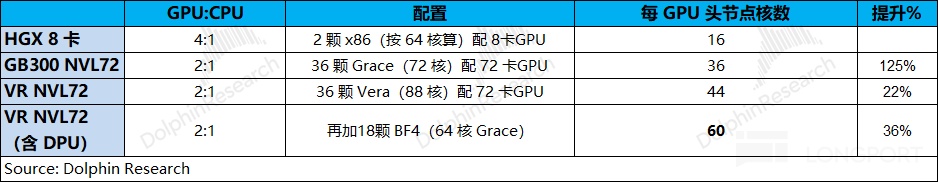
如果没有配置足够的 AI 头节点 CPU,会一定程度上影响 GPU 的效率,具体来看:头节点 CPU 带宽不够→GPU 卡在等待数据→利用率下降。正因如此,从传统 HGX 的 4:1 到 NVL72 的 2:1,因为加速器越来越复杂,就需要更多的 CPU 来管理和喂数据。
海豚君认为这部分的配比本身就在提升,主要是为了 “投入 CPU 来榨干 GPU 的每一分钱”,是纯粹的经济性驱动,并不是 Muse 的 Agentic AI 直接带来的拉动。
2)Agentic AI CPU
Agent 本质上是 CPU 工作负载,因为它们严重依赖顺序任务执行,而非纯并行处理,这是 GPU 做不了的事。在 Agentic AI 阶段,Agent CPU 是 “不得不用” 的,这也是 Muse 模式带来的纯增量。
ARM 曾给出一张 AI agent 的工作流线路图:
①用户→AI agent:提出一个目标,不是一个问题;
②AI agent→Cloud:agent 的本体跑在云端的 CPU 上。这一层没有加速器,纯 CPU。
③Cloud→Agents:一个 agent 把任务拆成多个子 agent,图上是 12 个。这一步是整张图的需求乘数。
④Agents ⇅ AI data center(循环):注意这里画的是双向箭头,而且每个 agent 各有一对。这是 “想 - 做-看” 循环的图示——不是一次调用,是反复往返。
⑤AI 数据中心内部:编排 CPU(Agentic CPU,新增需求)接收请求、管理状态、调度;把需要推理的部分喂给加速器;加速器吐出 token;再回到 CPU 判断下一步。
最后 Agents→Cloud→Answer→用户:结果汇总回云端,生成一个"Answer",返回给用户。
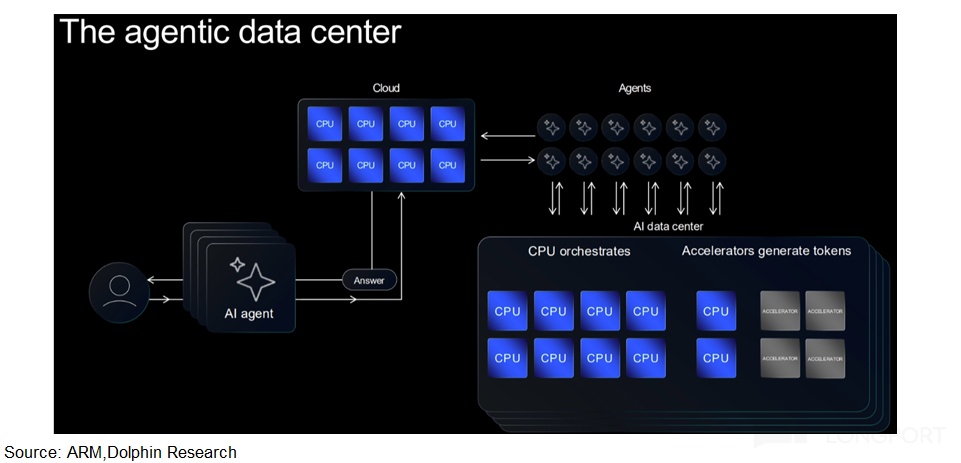
值得注意的是,这里提到的编排 CPU(orchestrates)是指 agent 主循环的编排,包括拆任务、生成子 agent、持有状态、决定何时反思、何时分支、何时重试、分发工具调用,而不是推理服务中对 GPU 计算任务等的编排(这是靠近 GPU 的头节点 CPU 的工作职能)。
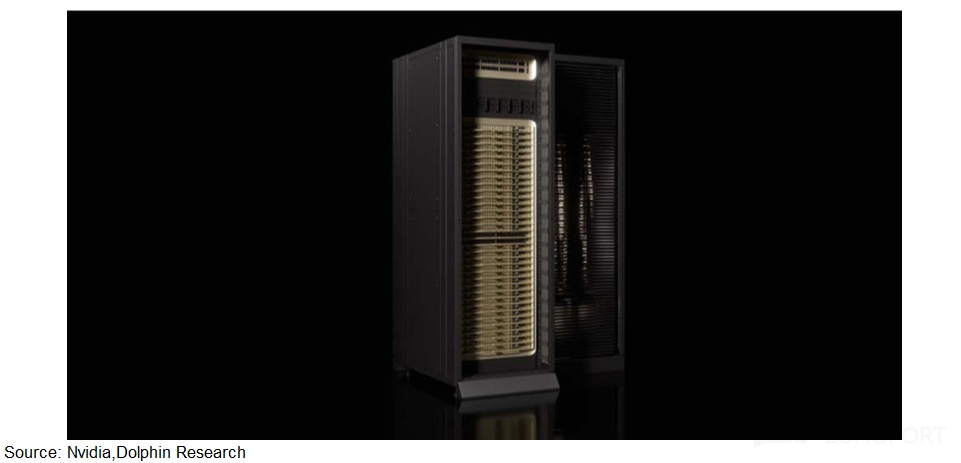
进入 Agent AI,数据中心内会新增大量独立 CPU 机架来专门做 Agentic 编排、调度和管理。为应对这部分需求,英伟达之前发布了独立的 Vera CPU 机架,其中有 256 颗 Vera CPU 芯片,每颗 88 核心,这才是 Agentic AI 的真正增量。
参考英伟达此前提出的 AI 工厂,Vera CPU 在 Vera Rubin NVL72(AI 头节点)、Vera CPU Rack(独立 CPU 机架)之外,还会在Vera BlueField 存储之中,负责存储管理、DPU、KV Cache 持久化。
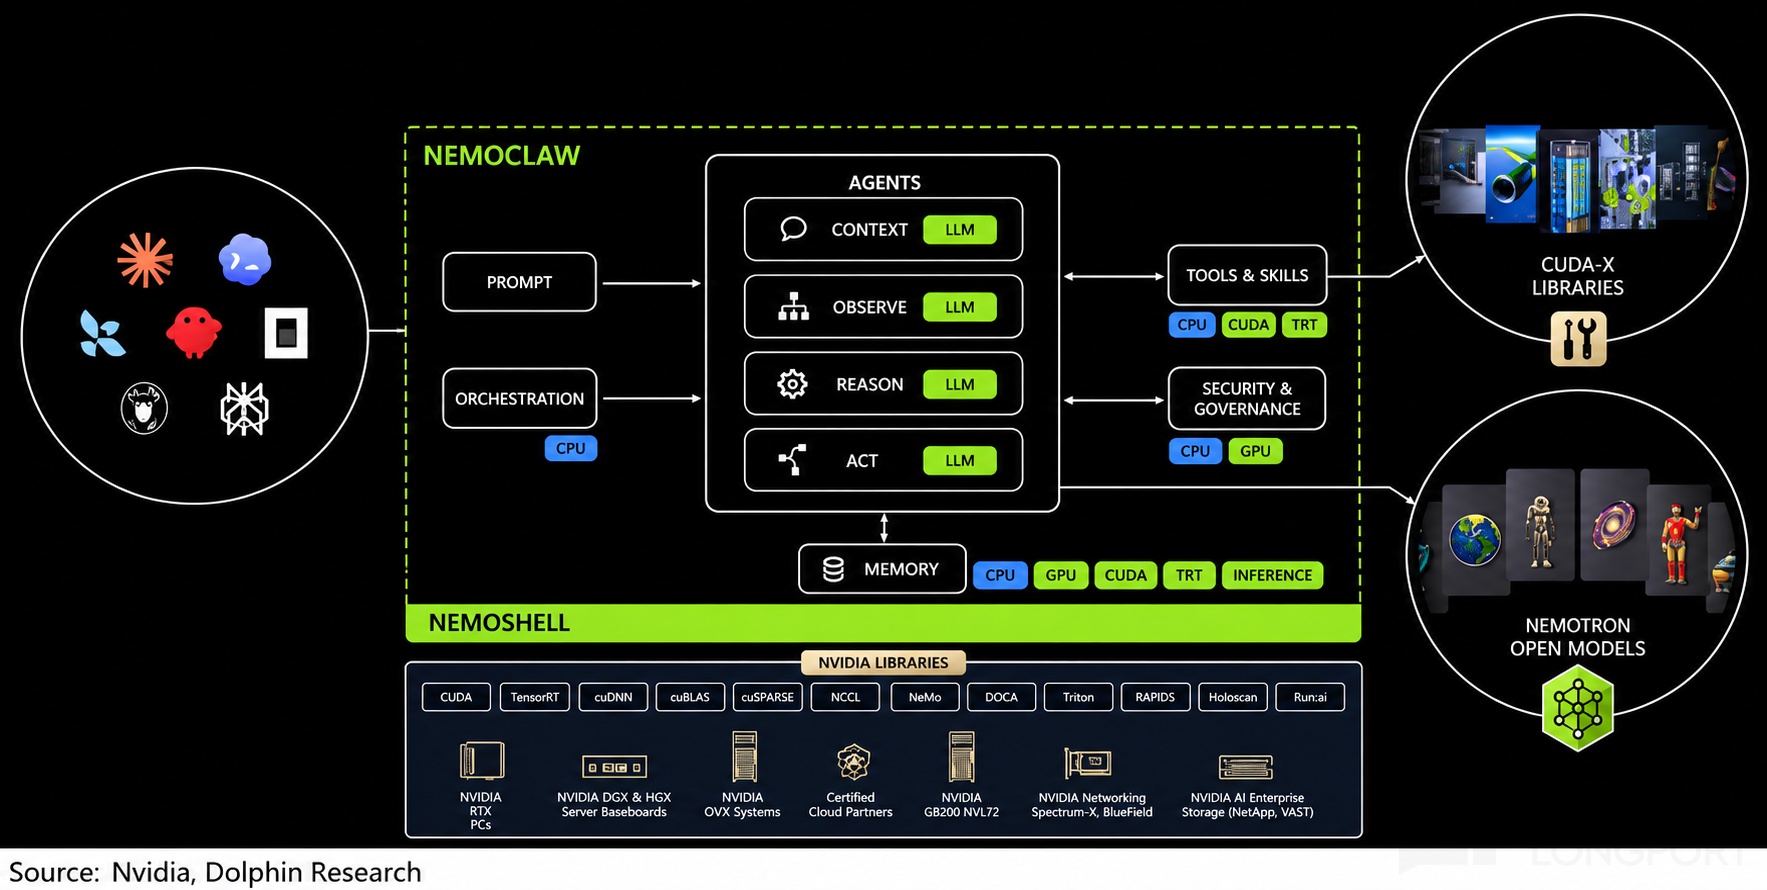
不同于 NVL72 内的 BF-4 DPU(Grace CPU),英伟达 STX 存储机架的 BF-4 DPU 采用了 Vera CPU。
在 STX 存储机架参考设计中,BF-4 包含⼀颗 Vera CPU、两个 CX-9 NIC 和两个 SOCAMM 模块。对于整个 STX 机架,它共有 16 个机箱(每个 STX 机箱包含两个 BF-4 单元),这意味着 1 个机架对应 32 颗 Vera CPU、64 个 CX-9NIC 和 64 个 SOCAMM。
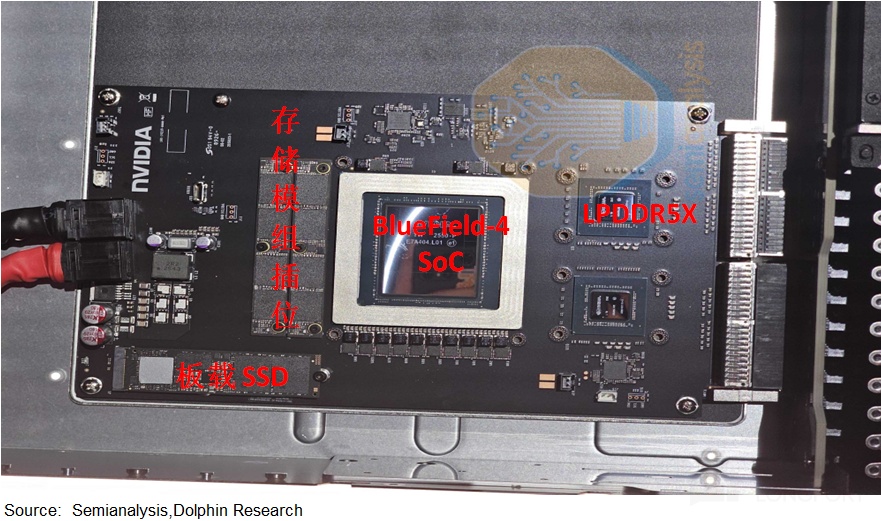
至于 BF-4(DPU) 实际上是有两类 CPU 芯片,一颗是在 NVL72 计算托盘内(Grace),还有一颗是在 STX 存储机架内(Vera)。
因而 BF-4 (DPU) 在 AI 头节点/Agentic CPU 的归属,要看这个芯片主要为 GPU 集群服务,还是为 Agent 工作负载服务(持久化 Agent 状态、KV Cache、长上下文存储),更倾向于 STX 是 Agentic 的一类。
4. CPU 的 “ChatGPT 时刻”?
经常会有人把CPU、核数和线程等概念搞混,我们先来理解这几个概念:
如果把 CPU 比作一个工厂,那么 1 个核心就是其中的 1 个工人,一个核心只能处理一项指令。1 个处理器如果有更多的核心数,那就相当于在同样的时间内可以处理更多的指令(事情),比如英伟达 Vera CPU(88 核)。
至于线程,就好比是工厂中的传输带。如果 A 工厂有 8 核 8 线程,相当于每个工人有一条对应的传输带; B 工厂有 8 核 16 线程,相当于每个工人有两条传输带;而 C 工厂是 16 核 16 线程。
在三家工厂中,C 工厂的处理速度是最快的(核数最多)。至于 A 和 B 相比,B 的处理速度会相对较快。在工人人数(核数)一样的情况下,线程的增多可以减少传输期间的时间空档,从而确保核心(工人)一直在工作状态。
这样来看,核数(工人)和线程(传输带)的增加,都是 CPU 性能提升的表现。
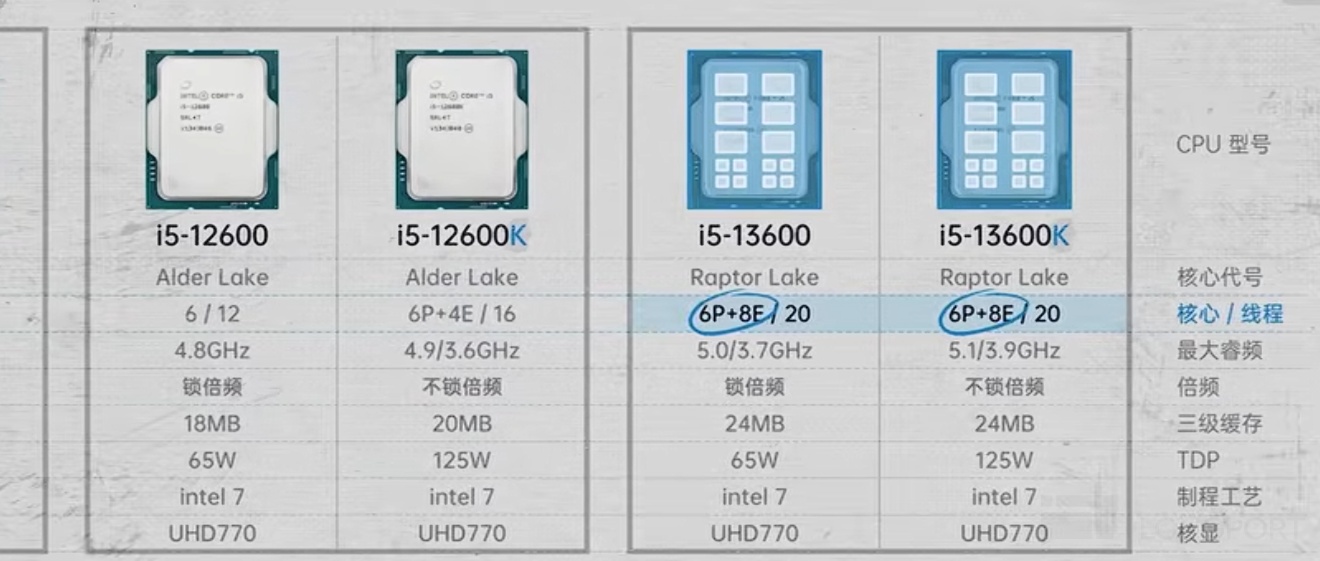
结合上文拆分的三类 CPU 来看,传统 CPU、AI 头节点和 Agentic CPU 的需求是完全不同的:
a)传统 CPU:跟着企业 IT 和云的请求量走,新增的部分主要来自于 agent 访问的第三方网站和服务。整体 CPU 颗数相对平稳,但是核数会受产品迭代的带动,Agent 影响不大;
b)AI 头节点:主要受 GPU 数量和机柜配比的影响,与 AI 加速器(GPU/ASIC)数量成正比。在近年内每 GPU 的 AI 头节点核数涨了约 3.75 倍。但拆开看,这个增量主要来自于 CPU:GPU 配比提升(翻倍)、单 CPU 的核数增加(22%)以及 NVL72 内的 DPU 新增(36%)。
对于 AI 头节点,单 GPU 的核数涨幅因素已经考虑进去了,还未看到下一代再度大幅提升的迹象。Agentic AI 对头节点 CPU 的带动影响不大。
c)Agentic CPU:这是 Agent 带来最大的增量机会点。这一类的颗数不是由 GPU 决定,受并发 agent 数的影响。
对于 Agent 需求,英伟达推出了单个 Vera CPU 机架,其中有 256 颗 Vera CPU(单颗 88 核,单核两线程),单机架总计 22,528 核,符合官方称可支撑超过 22,500 个沙箱(独立单间,防止污染)。
注: Muse 给每个用户发的虚拟机 2 vCPU。其中 2vCPU(虚拟 CPU)=1 个物理核的两个 SMT 线程。SMT 线程共享执行单元,2 vCPU 的实际吞吐不是 1vCPU 的两倍,大约是 1.2 到 1.3 倍。
具体来看,Agentic CPU 的需求可以分为固定层和弹性层两部分:①固定层主要是 1 个用户一个已经提前分好,就像是 Muse 发的 2vCPU,对应着固定沙箱;②弹性层是负责执行拆分出来的子 agent,持续复用的临时沙箱。不论是用户,还是子 agent 都是在独立隔离的环境中。
由此可见,Agent=模型(GPU 侧)+ 固定沙箱(用户侧拆解 Agent)+ 临时沙箱(处理子 Agent)。大致过程就是,用户发出指令,用户侧固定层的 CPU 拆解 Agent,接着交给临时沙箱处理子 Agent,推理运算由 GPU 侧来完成。
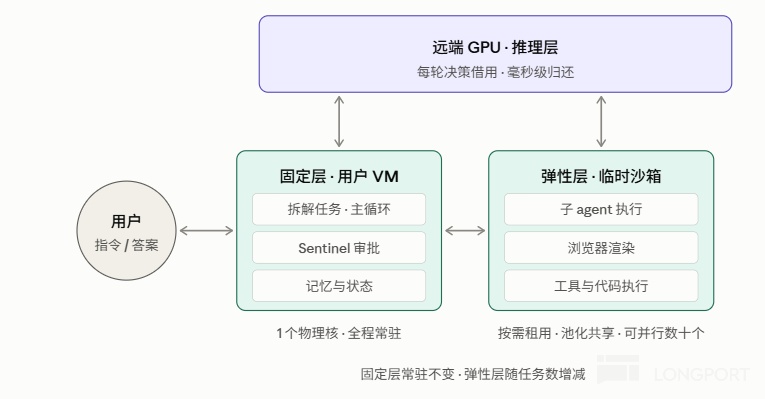
不论是固定层(用户侧)、还是弹性层(子 Agent)都需要安全隔离(沙箱)。CPU 的隔离能力来自于指令集和硬件结构本身。CPU 从诞生起就在解决一个问题:让多个互不信任的程序共用一台机器。几十年积累下来,CPU 硬件里有一整套专门的电路,来实现沙箱的功能。
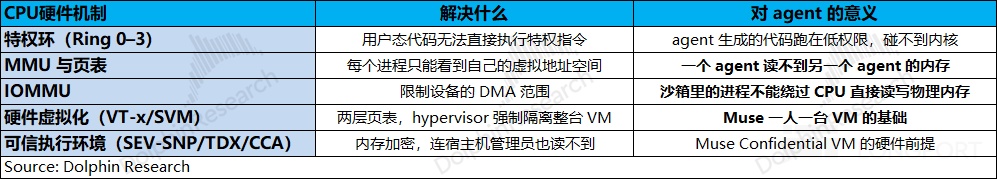
综合此前测算,单个 VR NVL72(含 DPU)的 CPU 核数有 4320 个(=72 个 GPUx 单 GPU 的核数 60),而这里的单个 CPU 机架的 CPU 核数将达到 22,528 个(256 个 Vera CPU×88 核),单个 CPU 机架的 CPU 核数是 VR NVL72 的 5 倍。
5.CPU 核数的增长机会在哪?
ARM 曾给出展望:传统 AI 数据中心每吉瓦(GW)算力大约需要 3000 万颗 CPU 核心,进入 Agentic AI 时代,这个数字将飙升至 1.2 亿颗。
对于 CPU 的需求,市场上有很多不同的说法。既有 GPU:CPU,还有单个 GPU 对应 CPU 核数,还有单 GW 的核数需求。其实海豚君认为 GPU:CPU 主要是头节点的环节,对 Agentic 阶段意义不大。单 GPU 对应的 CPU 核数在 CPU 机架引入后必然是大幅提升的,因而单 GW 的 CPU 核数需求相对更有意义。
①传统 AI 数据中心:以 GB300 NVL72 为例,整机架功耗 130kW 左右。如果 1GW 全部用于 GB300 NVL72,那么大约对应 7692 个 NVL72 机架。
单个 GB300 NVL72 约有 2592 个 CPU 核(72 个 GPUx 单个 GPU 对应 36 个 CPU 核),那么 1GW 大约需要 2000 万颗 CPU 核心(低于 ARM 的 3000 万颗口径);
②Agentic AI 数据中心:VR NVL72 的整机架和 CPU 机架的功耗都提升至 200kW 左右,那么 1GW 大约对应 5000 个 NVL72 机架,接下来就是 NVL72 与 CPU 机架之间分配的情况。
目前的现状是纯 GPU 机架的方式,下述表格中的保守、中性、乐观等情形实际上都意味着 CPU 机架带来的纯增量。
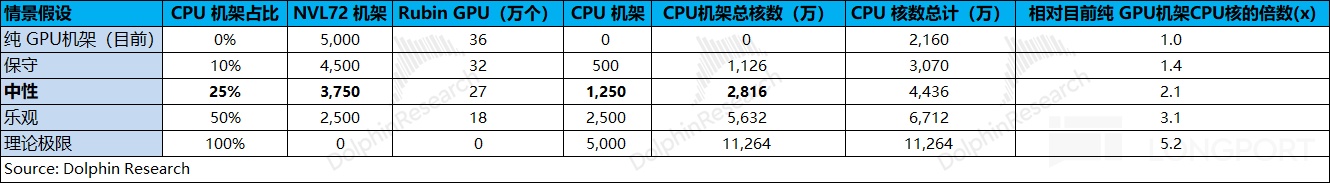
由此可见,在单一的 1GW 中,ARM 展望中给出的 1.2 亿颗 CPU 核数高于上图中测算的理论上限 1.13 亿颗 CPU 核数。
海豚君合理估算,随着 CPU 机架的引入,更为合理的情况是对于数据中心所需要的核数的提升在 2-3x 左右。
英伟达 CPU 机架中是纯粹的 CPU,并没有 GPU。因而在 Agentic AI 阶段对 CPU 机架的引入,自然会大幅提升整个 AI 数据中心的单 GPU 对应的 CPU 核数(受 CPU 机架占比的影响)。在中性情况下(CPU 机架占机架总数 25%),可以测算单 GPU 对应的 CPU 核数有望从 60 个大幅提升至约 160 个,这才是 CPU 增量的直接体现。
6.Agentic AI 能带来多少需求
从上文可以看出来,其实 AI 数据中心本身就持续在建,其中对应的头节点需求是增加的(非增量信息)。而Muse 的 Agentic AI 主要是在 agent 的需求下,要新增引入 CPU 机架,这也是 Agentic CPU 的主要需求来源。这和 GPU 无关,直接受 agent 用户情况的影响。
在这里引入一个公式:增量 CPU 需求= (A 头节点) GPU 出货量×每 GPU 头节点 CPU 核数 + (B 固定层) 总注册用户 x 日活率 x(活跃时间/24)×每用户 2vCPUx 峰均比÷超售比÷ 2(单核两线程)+(C 弹性层)活跃用户×任务并发率×每任务沙箱核数
在测算 Agentic AI 需求时候,主要关注于 B 固定层和 C 弹性层,需要理解的是:
①B 固定层:还是针对于用户侧的,但需要注意的是 Muse 分配的 2vCPU,并不会一直占用核心。a)当活跃时,用户被分配 1 个物理核心(2 线程);b)而在空闲时,记入存储单元→VM 暂停→物理核心释放给其他用户,等再次唤醒,会从存储中快速恢复。
Muse 分配的 2vCPU,实际上是保证你最多能用 2 个 vCPU,但不用时不消耗物理核心。例如 1 台物理服务器(256 核)可以分配几百甚至上千个 vCPU,正是因为大部分 VM 同时处于空闲状态,这就是超售比的概念。
以 1 亿 Muse 为例,假定日活率 30%,每天活跃 3 小时,峰均比 2,超售比 6,那么 B 固定层的 CPU 需求大约需要 125 万 CPU 核(=1 亿 x30%x3/24x2x2/6/2)。
②C 弹性层:不需要承担所有用户,只需要处理活跃用户给出的任务。任务并发率指的是平均每个活跃用户同时在跑多少个沙箱(子 agent),还要关注每个任务沙箱需要的核数。
依然在 1 亿 Muse 用户(日活 30%)、每天活跃 3 小时、峰均比 2 的情况下,假定每个任务沙箱需要的 CPU 核数为 4 个,以并发率来做情景假设:其中峰值活跃达到 750 万(=1 亿 x30%x3/24x2)
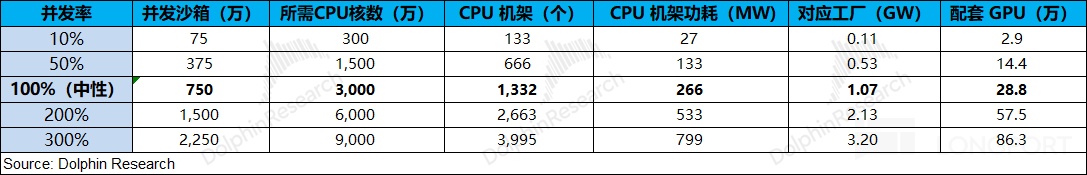
从中可以看出,在 1 亿 Muse 用户体量及以上假设的情况下,当并发率达到 100% 的情况下(即平均单个活跃用户同时在跑 1 个子 Agent),大约需要 1GW 的配套工厂。在配置 25% 的 CPU 架构的模式下,大约需要 1332 个 CPU 机架,C 弹性层对 CPU 核数的需求就将达到 3000 万个。
在上述情况(中性)下,A 部分 GPU 侧的 CPU 核数需求大致有 1728 万个(=28.8 万个 GPUx 单个 GPU 对应 60 个 CPU 核数);B 部分用户侧的 CPU 核数需求大致有 125 万个;C 部分子 Agent 侧的 CPU 核数需求大致有 3000 万个。
将 A+B+C 三部分合起来的 CPU 核数需求将达到 4853 万个,是原来纯 GPU 机架方案的 2.8 倍左右(相比于 1728 万个)。考虑到英伟达存储机架(DPU)等部分的额外需求,海豚君预估 Agentic CPU 有望带动 CPU 核数需求有望提升至此前的 3 倍左右。
7.Agentic AI 给 CPU 产业链带来的机会
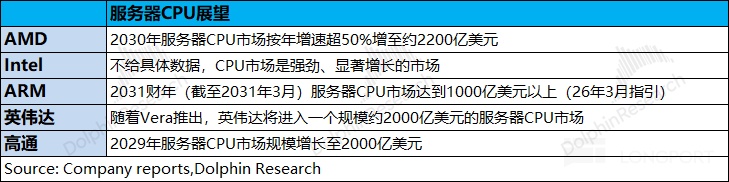
结合 AMD 此前给出的 CPU 展望,按年增超 50% 的增速至 2030 年服务器 CPU 市场规模有望增长至 2200 亿美元,可以倒推出 2025 年服务器 CPU 市场规模大约是 290 亿美元。
这里引入一个公式,“服务器 CPU 市场规模=CPU 总核数 x 单个 CPU 核均价”。从上述测算中可以看出 Agentic CPU 有望将 CPU 核数需求提升至原来的 3 倍,另假设单个 CPU 核均价年增 18%。
由于大部分 CPU 厂商的展望都给到了 2030 年,假定 Agentic CPU 模式将在 2030 年实现大规模落地(即 2030 年的 CPU 核数需求提升至 3 倍),以及在单个 CPU 核均价年增 18% 的情况下,至 2030 年 CPU 市场规模有望提升至 2000 亿美元(=290x3x1.18^5),复合增速接近 50%。
上述对 CPU 市场规模的测算与各家厂商的展望基本相近,其中 ARM 管理层也承认此前给出的 1000 亿市场展望是偏于保守的,CPU 市场规模至 2030 年将达到 2000 亿美元附近,已经基本上是 CPU 产业链的共识。
当前服务器 CPU 市场的主要厂商是英特尔和 AMD,结合两家公司 2025 年的相关收入情况来看,英特尔和 AMD 的市场份额分别为 58% 和 35%,其他的厂商合计不足 1 成。
由于 CPU 市场规模的增长主要来自于 Agent CPU 需求的推动,传统服务器 CPU 的增速相对较慢(主要来自于更新),海豚君预估英特尔的市场份额将继续回落,AMD、英伟达等厂商的份额有望实现回升,尤其是英伟达、ARM 和高通三家都是直接的纯增量。
假定 2030 年服务器 CPU 市场中,英特尔和 AMD 的市场份额都在 36%。英伟达、ARM 和高通作为 “新进入者”,有望获得 15%、5%、2% 的市场份额。
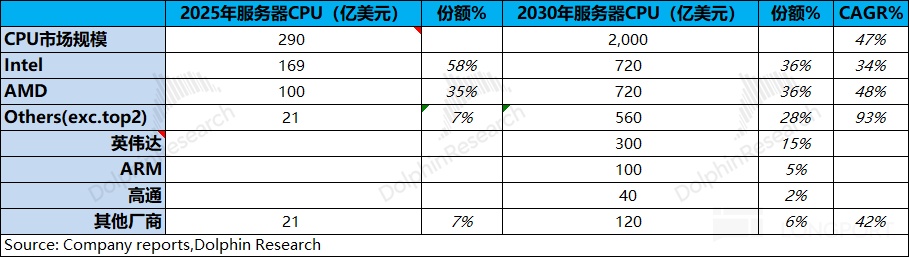
综合来看,Agentic AI 有望为$英特尔(INTC.US) 和$AMD(AMD.US) 的服务器 CPU 带来 550 亿和 620 亿美元年收入增量。英伟达、ARM 和高通能在 Agent CPU 中享受到 300 亿、100 亿和 40 亿美元的年收入纯增量。
基于上述情况,大致可以将英特尔和 AMD 服务器 CPU 在 2030 年的原有预期收入上调 100-200 亿美元,对应英特尔和 AMD 的 2030 年业绩预期大致提升 10% 左右。
虽然 Agent CPU 有望为$英伟达(NVDA.US) 带来的 300 亿美元收入,对于公司总收入占比不到 3%,对英伟达的整体影响不大。
在纯增量之中,Agent CPU 对 ARM 和高通的影响相对较大。如果两家公司在 2030 年分别获得 5% 和 2% 的市场份额,那么有望给两家公司分别带来 100 亿和 40 亿美元收入。假定 Agent CPU 业务的 OPM 为 25%,大约能给 ARM 和高通分别带来 25 亿和 10 亿美元的 2030 年经营利润增厚。
对于$Arm(ARM.US) 而言,除了卖芯片以外,还能卖核心,有望获得更大的业绩弹性,给予 ARM 这部分 25xPE 参考 (11% 的折现率),折现回来有望获得 410 亿美元及以上的估值增厚,对 ARM 股价的弹性在 15% 左右。给予$高通(QCOM.US) 这部分 20xPE 参考 (11% 的折现率),折现回来有望获得 130 亿美元的估值增厚,对高通的股价弹性在 6% 左右。
整体来看,Agentic AI 需要引入 CPU 机架,会直接带来 CPU 核心需求的增加,有利于推动整个 CPU 产业链的持续景气。从结构化的角度来看,增量需求主要来自于 Agent CPU 和头节点 CPU,传统服务器 CPU 需求平稳。
Agent 对于 CPU 产业链各公司的带动,ARM(15%)>英特尔/AMD(10%)>高通(6%)>英伟达(3%)。从上周的涨幅来看,同样体现了这样的排序情况。Muse 带动 Agent CPU 的需求基本上都已经在股价中反应,后续关注于 Agent 需求能否继续做大蛋糕(服务器 CPU 市场)以及哪家公司能抢占更大的额外份额。
<此处结束>
本文的风险披露与声明:海豚研究免责声明及一般披露
本文版权归属于原作者/机构。
以上内容仅代表作者个人观点,不代表平台立场。本内容仅供投资参考,不应被视为投资建议。如您对平台提供的内容服务有任何疑问或建议,请联系我们。