

NAND 天性 “多產”,閃迪憑什麼守 80% 毛利率?
 我是 LongbridgeAI,我可以總結文章信息。
上篇《AI 推理大爆發,“悲催” 閃迪真有鳳凰涅槃?》中,海豚君提到,$閃迪(SNDK.US) 甩掉傳統機械硬盤包袱後,已全盤聚焦 NAND 閃存市場,精準吃到本輪行業回暖的紅利。
技術上,閃迪不盲目 “死磕” 層數,而是主攻橫向微縮實現行業最高位密度、率先量產 CBA 鍵合架構提升能效,並聯合首推專為 AI 推理定製的 HBF(高帶寬閃存),綜合技術實力穩居 NAND 第一梯隊。
疊加 NAND 行業起飛的風口,閃迪業績爆發水到渠成。本篇繼續深度拆解三個核心議題:
1)在 AI 浪潮席捲之前,NAND 究竟是一個怎樣的行業?
2)為什麼 NAND 行業的供給總是陷入 “減不掉” 的怪圈?
3)同為存儲基石,DRAM 與 NAND 為何 “同源不同命”?
以下是正文:
一. 在 AI 浪潮席捲之前,NAND 究竟是一個怎樣的行業?
把閃迪 2019—2025 年閃存業務拆成 “量” 與 “價” 兩條線,會呈現製造業中極罕見的形態:
bit 出貨量從 38 EB 暴增至 101 EB、六年大增 166%;但每 GB 均價(ASP)從 0.206 美元跌至 0.073 美元、慘跌 65%。最終閃存收入不升反降,從 78.2 億美元微降至 73.6 億美元、倒退 6%。
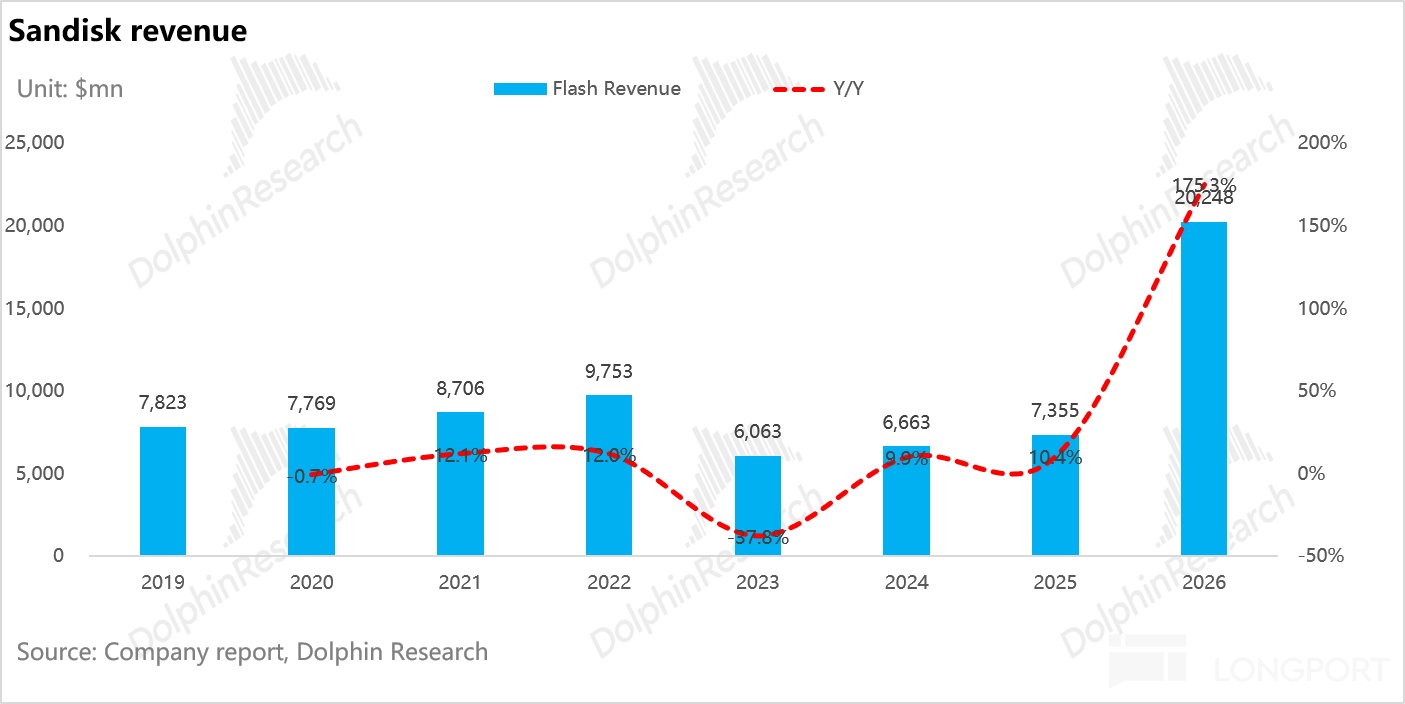
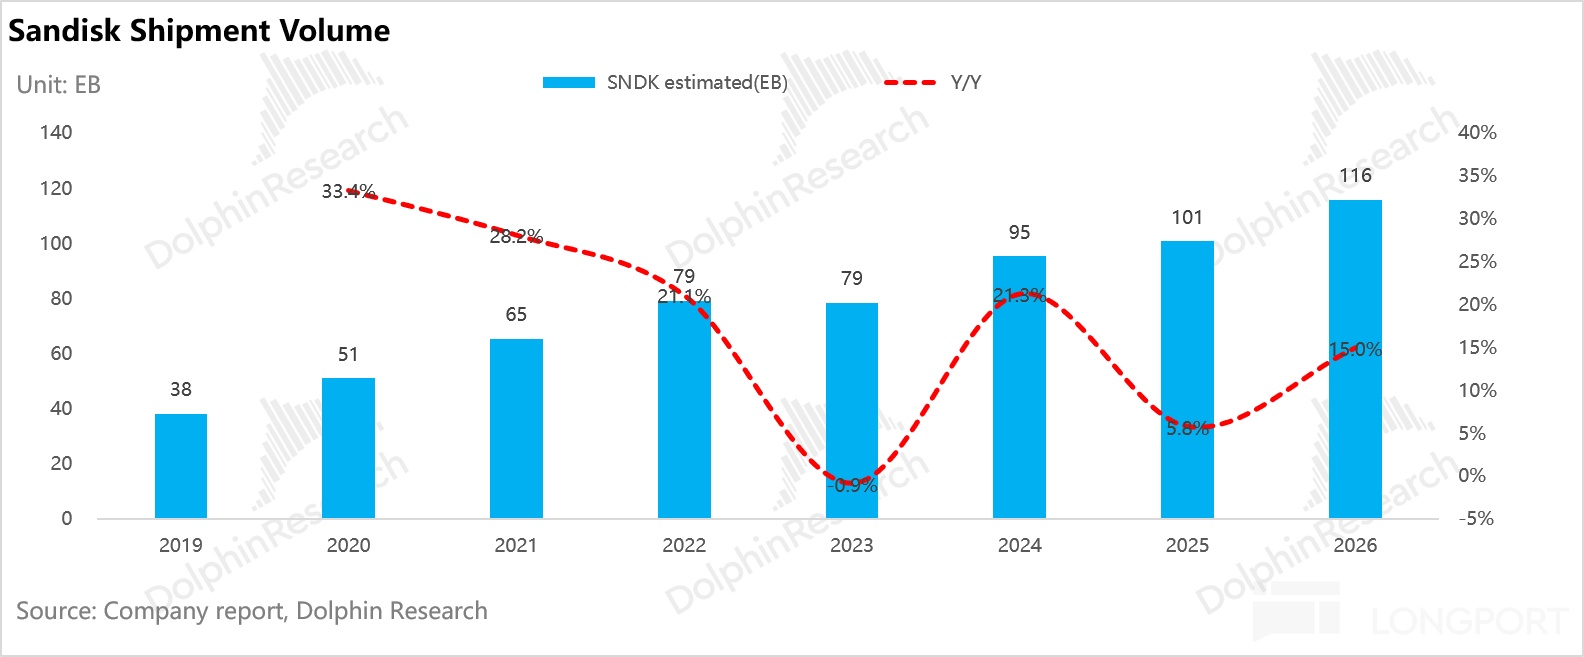
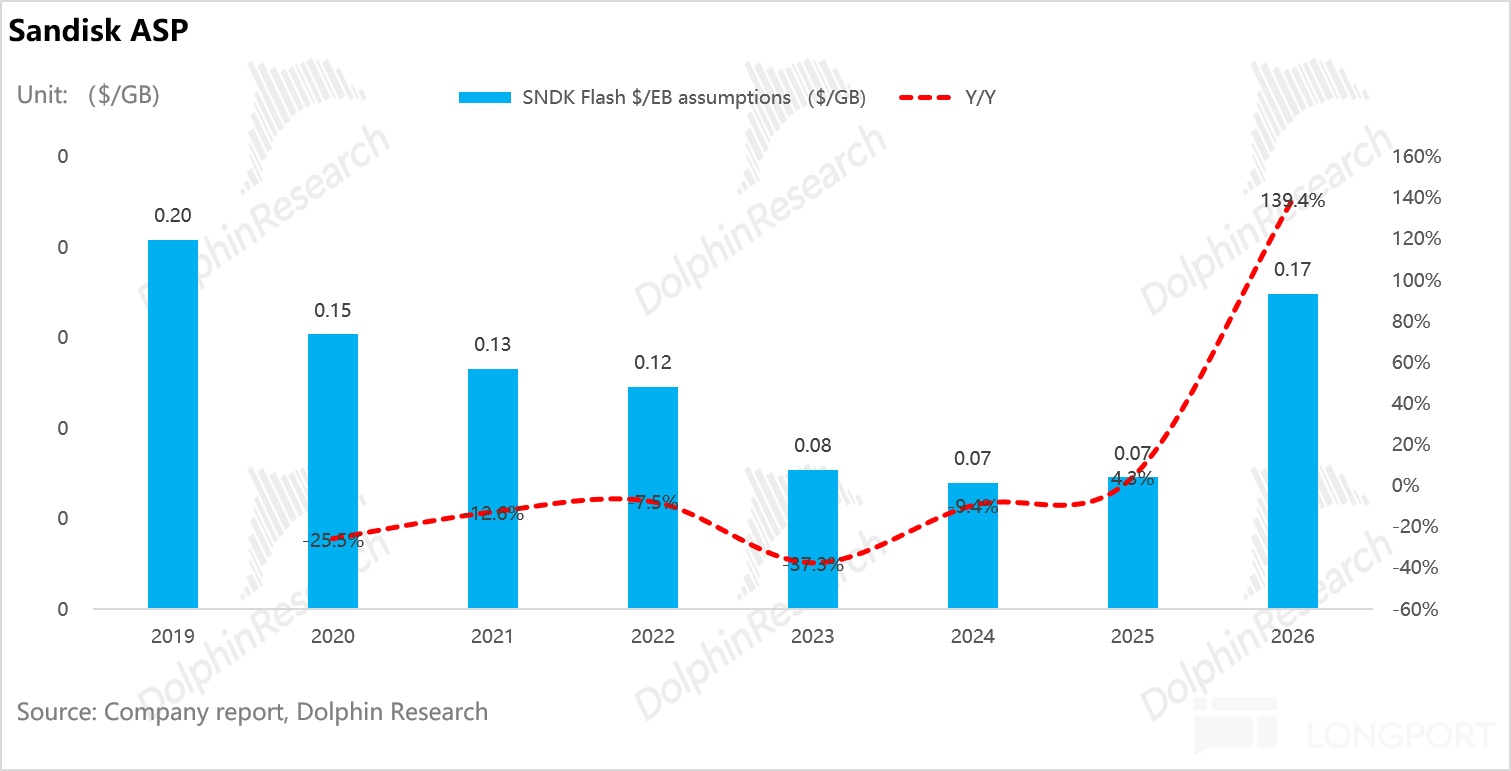
這揭示了 NAND 生意的殘酷本質:“做大量” 與 “做大收入” 之間一直沒有穩定的正向關係——技術進步帶來的成本下降幾乎超額 “贈送” 給下游,製造端留不住降本溢價。
① 下行週期:收入崩塌完全由價格驅動,銷量仍在增長
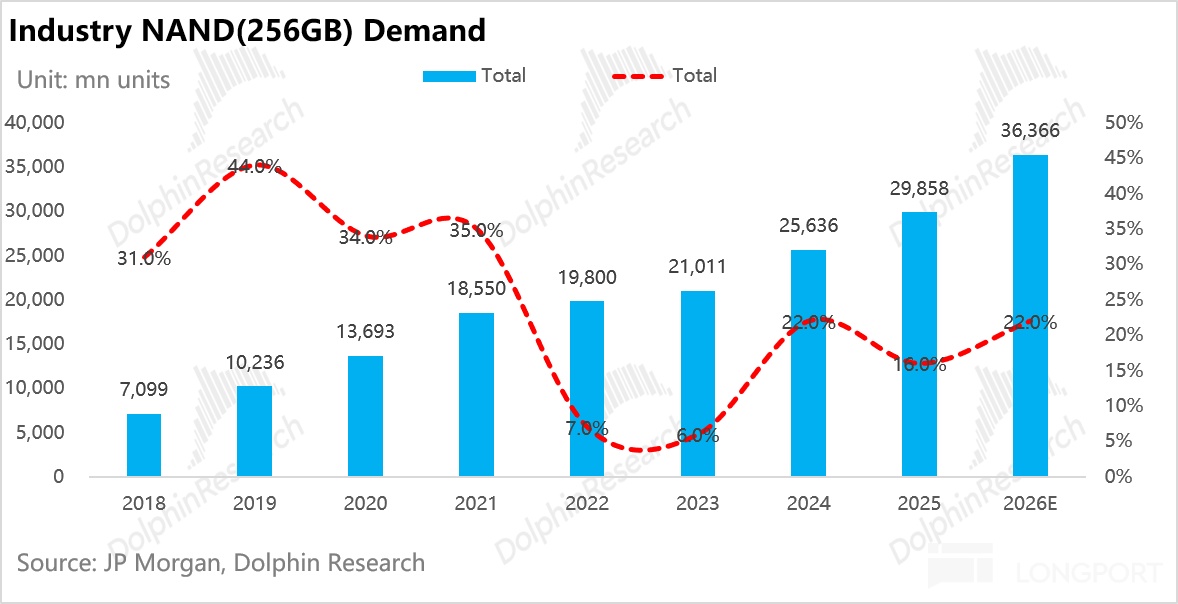
NAND 下游需求在 2018—2021 年持續保持 30% 以上高增速(每年 34%~46%),源於三重共振:
a. 智能手機普及與容量升級——每代旗艦機存儲容量翻倍,推動手機端 NAND bit 需求在 2018—2021 年間年均增長 34%;
b. PC 由 HDD(Hard-disk drive,機械硬盤)全面轉向 SSD(solid-state drive,,固態硬盤(SSD)——SSD 滲透率從約 50% 升至 90% 以上,2019—2021 年客户端 SSD bit 需求連續三年增速超 34%;
c. 企業級 SSD 擴張——雲廠商服務器 SSD 部署加速(標準服務器)。
但 2022—2023 年需求增速斷檔,驟降至僅 6%~8%:
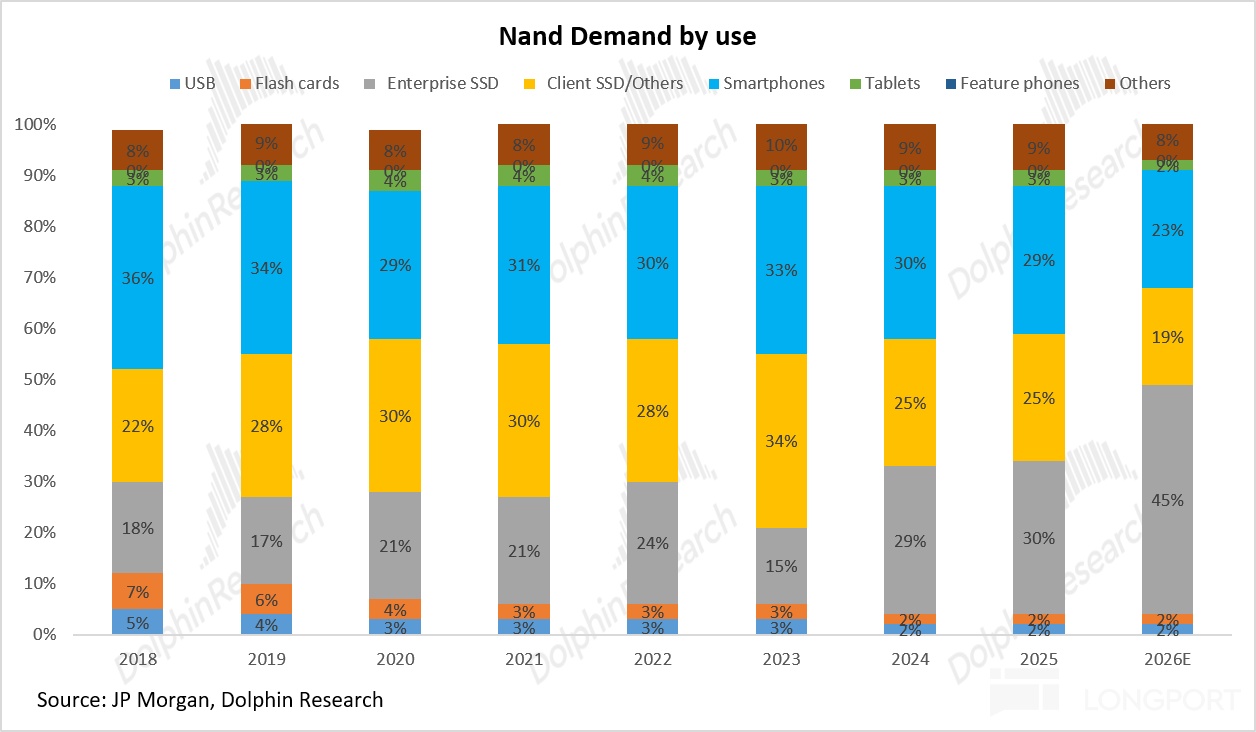
a. 手機全面萎縮:作為最大單一終端(2023 年約佔 bit 需求 33%),通脹與利率上行壓制換機、疊加 2021 年疫情透支,手機端 bit 增速從 2021 年的 46% 驟降至 2022 年的 2%,是最大拖累;
b. PC 斷崖回落:2020—2021 年疫情居家辦公需求透支了 PC 市場,2022 年全球 PC 出貨同比−12%,2023 年繼續−10%;
c. 企業級 SSD 降温:標準服務器在 2021 年投資高峰後進入消化期,企業級 SSD bit 需求 2022 年增速從 34% 降至 20%,2023 年轉為 −33%,而當年 AI 服務器尚未形成足以對沖的增量。
d. 庫存牛鞭效應放大收縮:三大終端同時去庫存,原廠庫存從 6 周升至 16 周。更關鍵的是跌價預期自我強化——客户預期續跌而推遲採購、轉為按需下單,訂單萎縮又加速價格下跌、反過來驗證預期,終端需求增長放緩至 6%~8%,被放大為存儲訂單的劇烈波動。
以閃迪為例,2023 年出貨量基本持平,每 GB 均價與收入同比均降 37.8%;同年行業收入約 −37%、ASP −42%——收入跌幅完全由價格驅動,銷量對下滑的 “貢獻” 為零。
這與傳統週期行業截然不同:鋼鐵、化工、航運下行期是需求萎縮→銷量下滑、量價同向承壓,靠減產匹配需求,使價格企穩;而 NAND 在最慘年份有減產動作,但出貨量並未縮水、價格獨塌近四成。
此階段 NAND 呈現典型大宗商品屬性:價格是市場博弈的結果,技術與成本優勢無法轉化為溢價、只體現為虧損幅度差異,價格跌幅完整吞噬了銷量增長的成果。
2. 為什麼 NAND 行業的供給總是陷入 “減不掉” 的怪圈?
供給端當年確實執行了史無前例的深度減產:
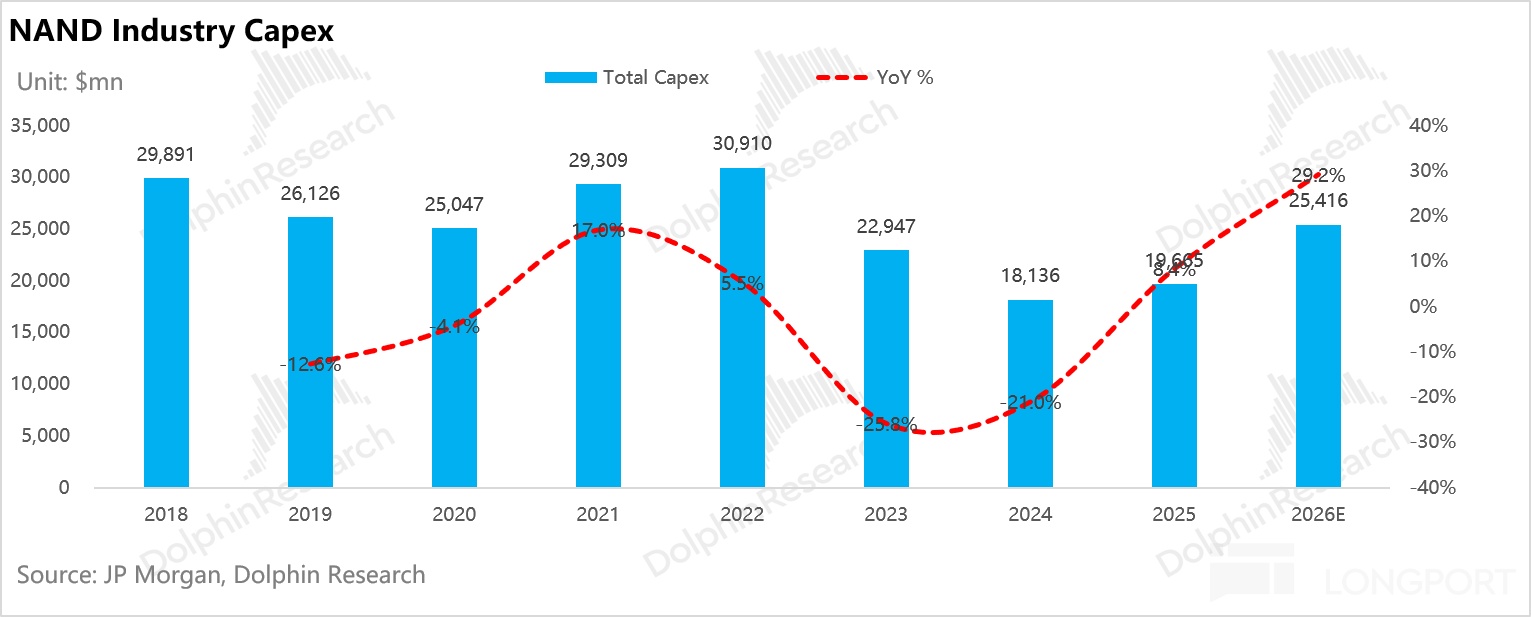
資本開支上,行業 CapEx 自 2022 年 309 億美元峯值連降兩年,2024 年降至 181 億美元谷底、累計收縮 41%。
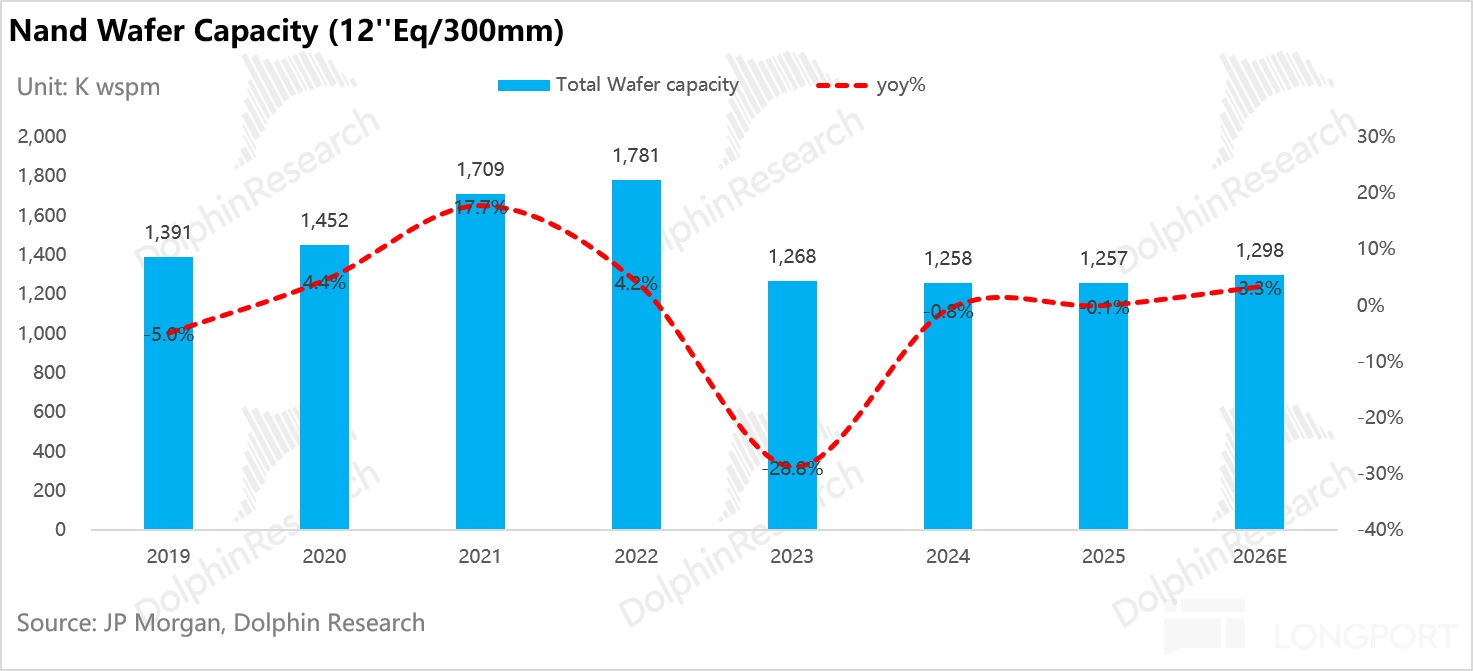
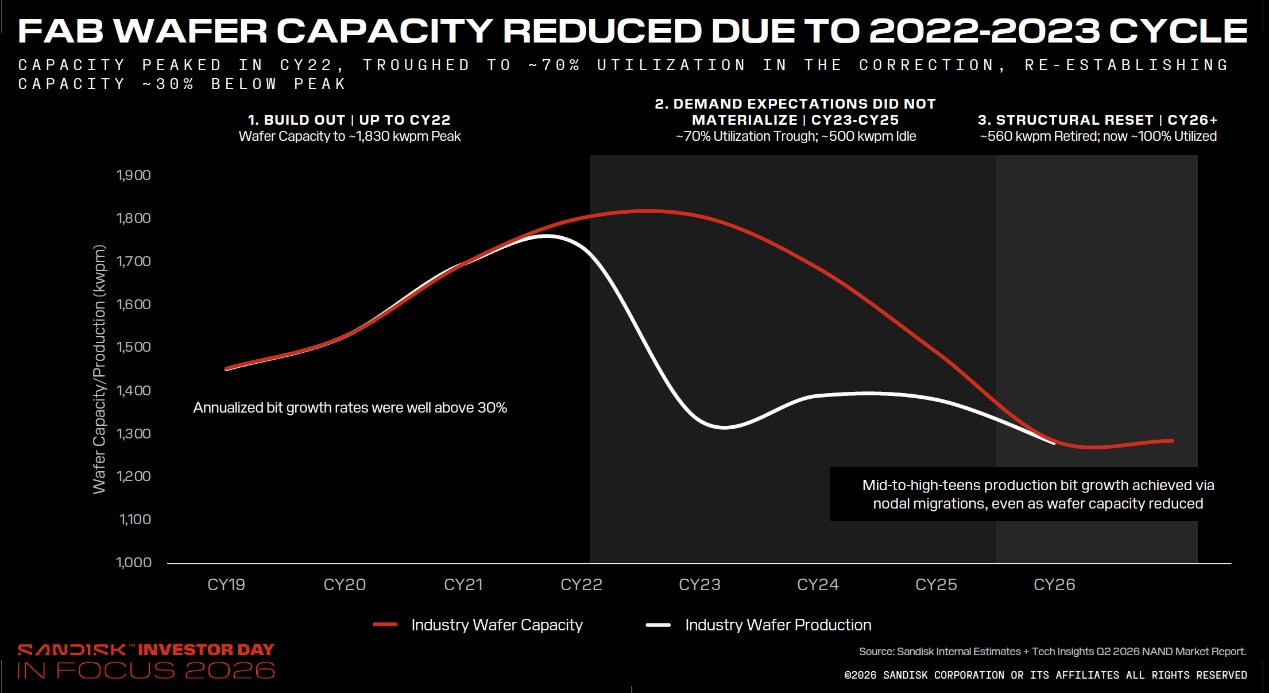
NAND 晶圓的投片量上,自 2022 年 178 萬片/月峯值,2023 年單年回落至 127 萬片/月、同比降 28.8%;根據閃迪説法,回調期間,行業產能利用率一度跌至約 70%、約 50 萬片/月閒置。
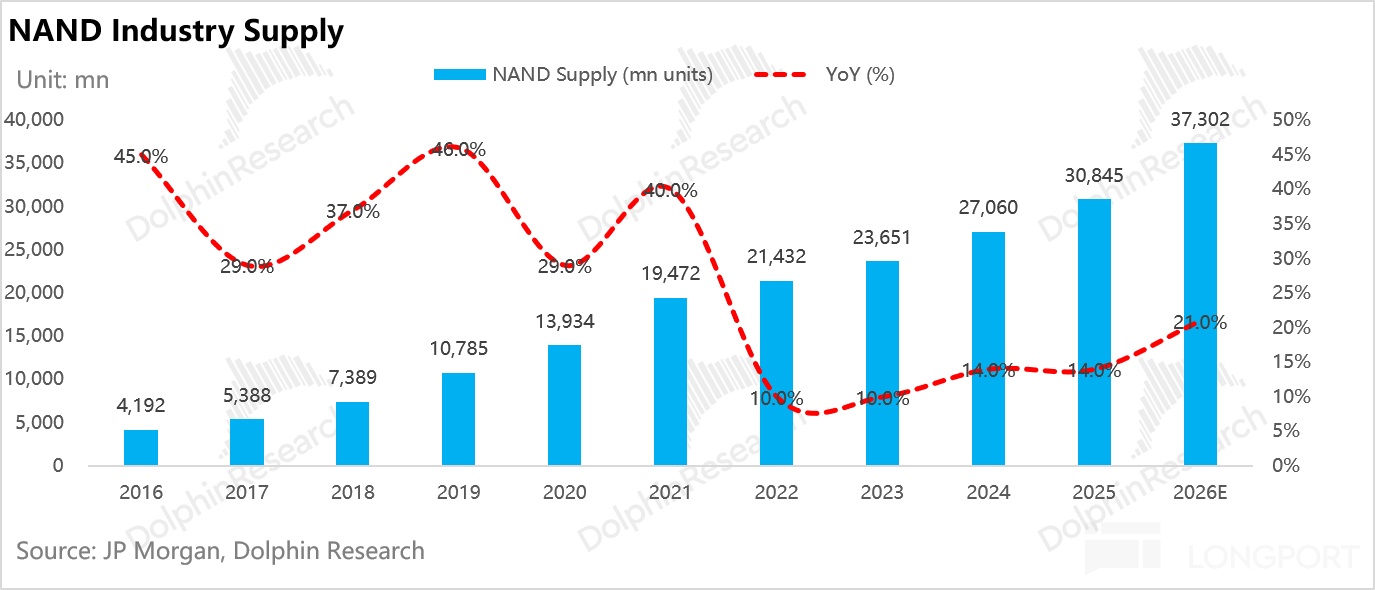
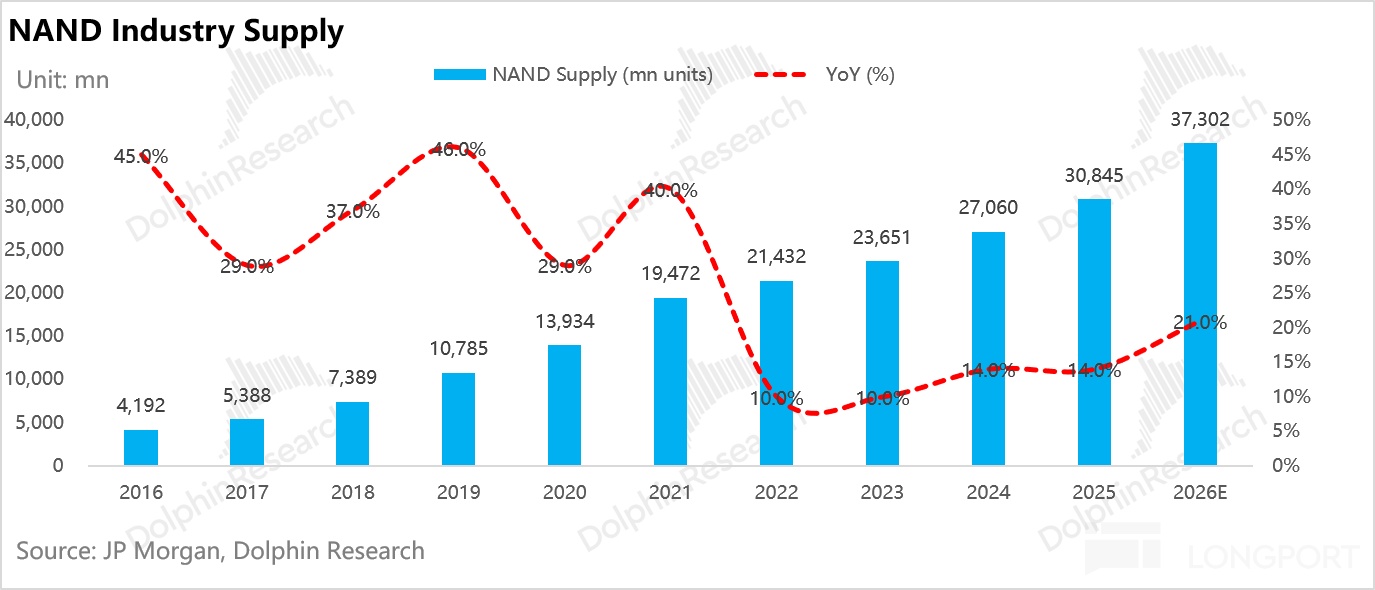
然而如此力度的減產並未換來供給收縮:2023 年投片量(wafer)收縮約 29%,bit 供給卻仍增長約 10%。2016—2026 年間 NAND bit 供給從未出現過任何一年負增長,即便 2023 年行業收入 −37%、全行業虧損亦然。
NAND 晶圓投片量縮減、 bit 產量增加,方向相逆背後,近 40 個百分點的落差,全部來自節點遷移的單位晶圓效率提升。而
其根源是供給側的一個固有屬性:NAND 的技術迭代本身就在持續製造產能過剩。
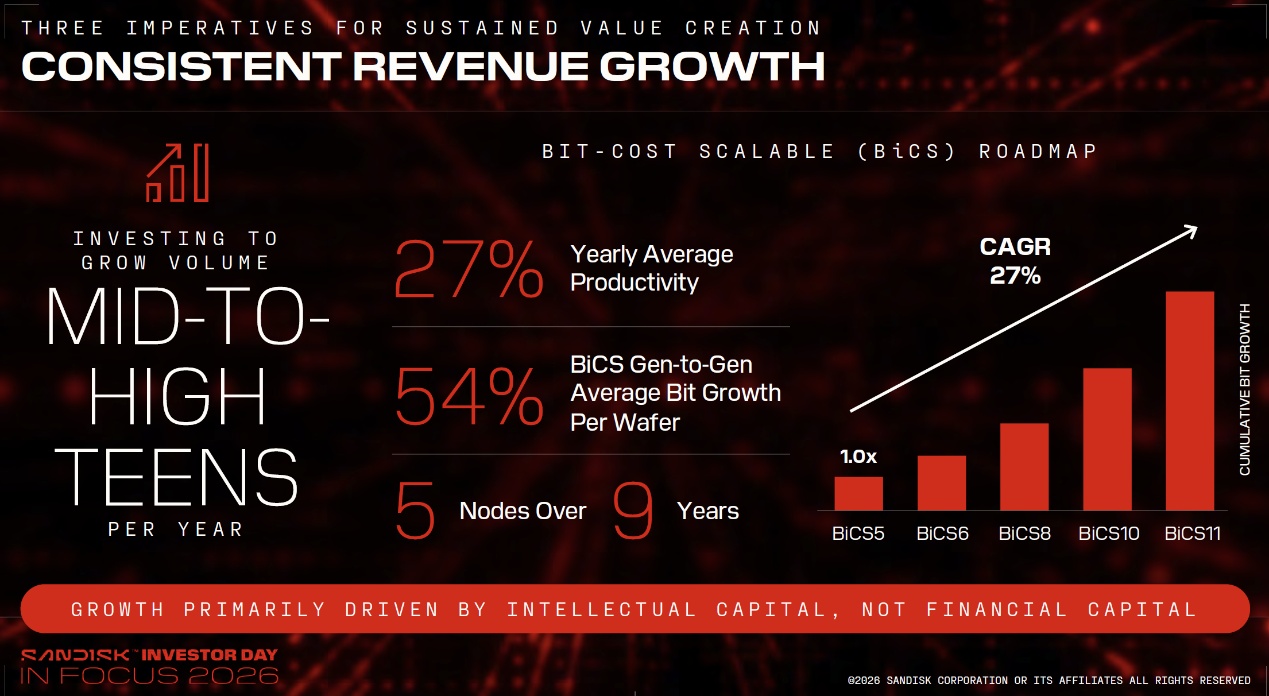
按閃迪披露,從 BiCS5 到 BiCS11 的五個節點,單位晶圓 bit 產出代際平均增幅 54%、年化複合約 27%,顯著高於行業 mid-to-high teens 的長期需求增速。
換言之,廠商能削減的只是投片量,卻無法削減每片晶圓自帶的效率提升——這部分供給增長是 “自動” 的、與減產意願無關。這正是 NAND 區別於鋼鐵、化工、航運的根本:後者可靠停產實現供給絕對收縮,NAND 即便在最深低谷供給仍雙位數增長。
那麼,NAND 為何能僅憑節點進步、在不加大資本開支與投片的情況下持續擴張供給?
關鍵在於釐清 “單位晶圓 bit 產出” 由什麼驅動,該指標可分解為:
每片晶圓 bit 產出 = 存儲孔密度 × 層數 × 存儲陣列面積佔比 × 每單元比特數
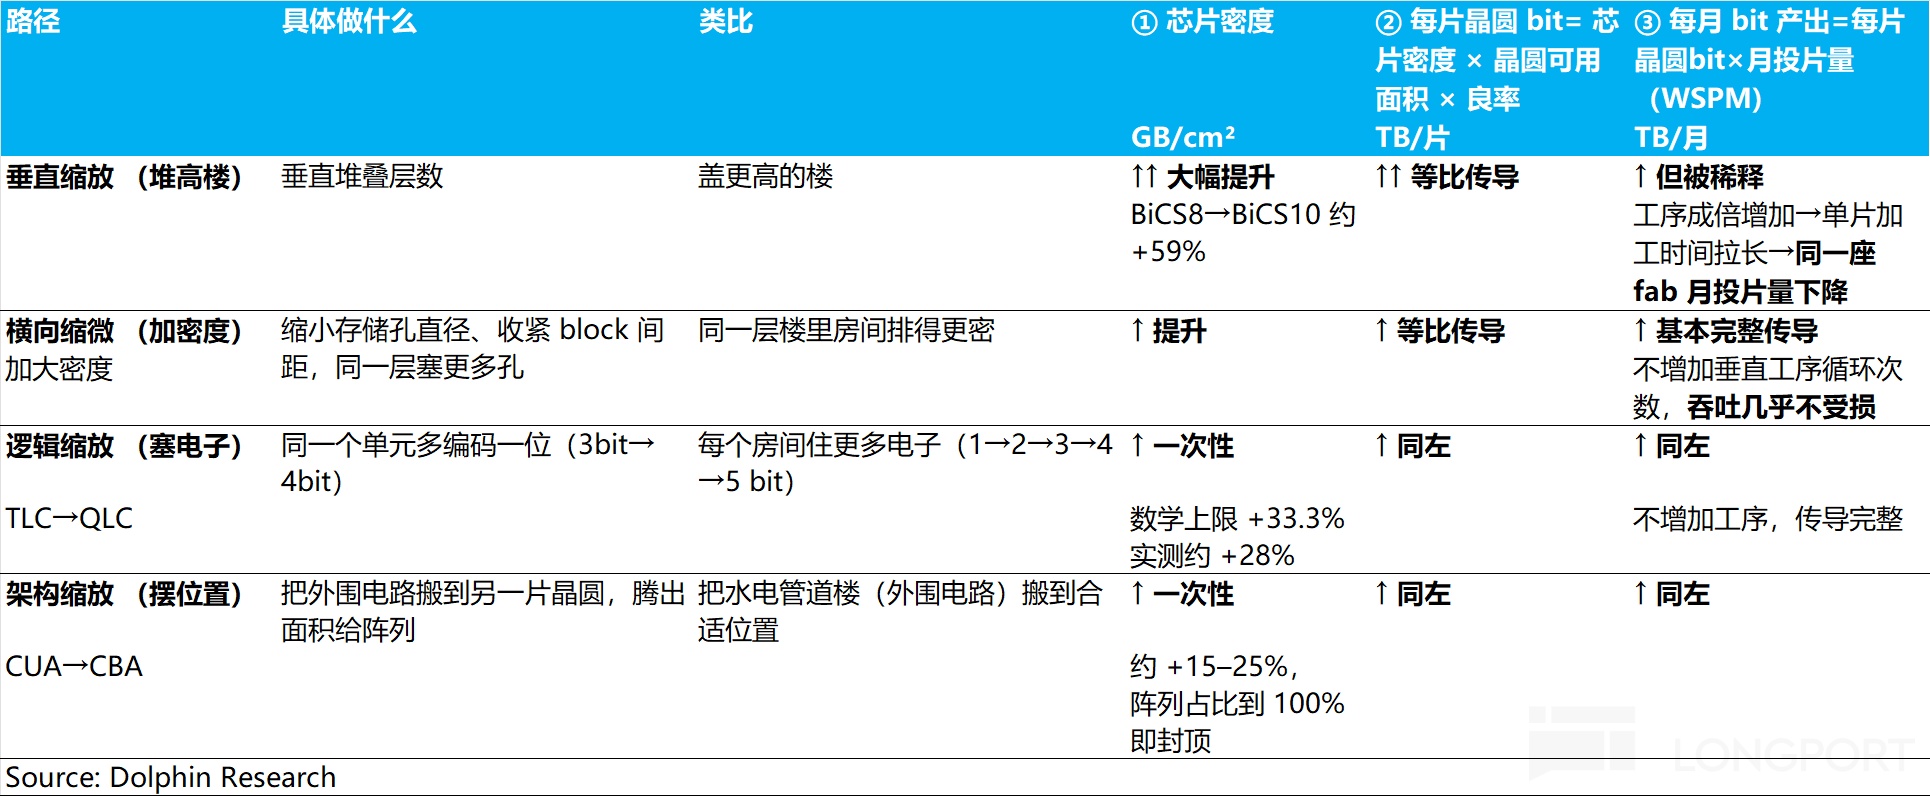
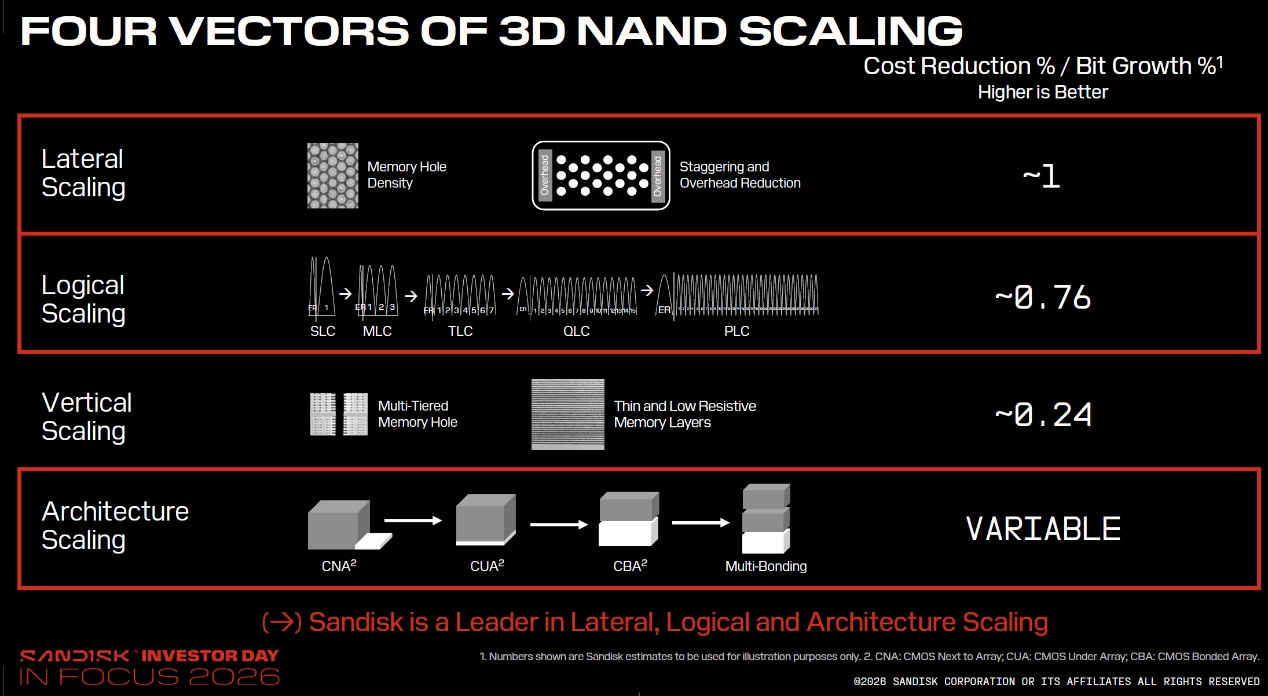
“邏輯縮放” 和 “架構縮放” 基本走過一次就到頭了;而 “堆層數” 和 “橫向縮小孔密度” 才是 NAND 大廠每年老老實實拼技術、能持續帶來單位晶圓 bit 產出增長的真正動力。
① 邏輯縮放(TLC→QLC):一次性台階,不構成持續增長來源
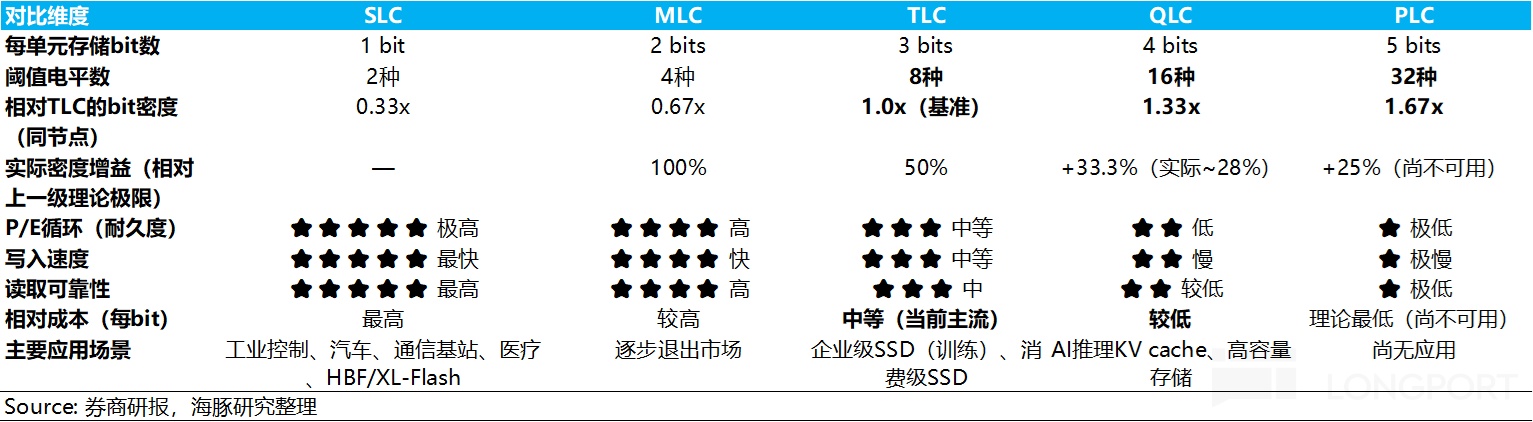
每個存儲單元用閾值電壓編碼信息,從 SLC(1 bit)到 MLC、TLC(3 bit)、QLC(4 bit)——單元數與面積不變,僅靠多編碼一位提升容量。每增加 bit 會提高存儲容量。
代價同樣明確:QLC 需分辨 16 個閾值電平(TLC 僅 8 個),噪聲容限減半、寫入變慢、耐久度約為 TLC 的三分之一;下一級 PLC 性能更差,閃迪也未給出時間表。
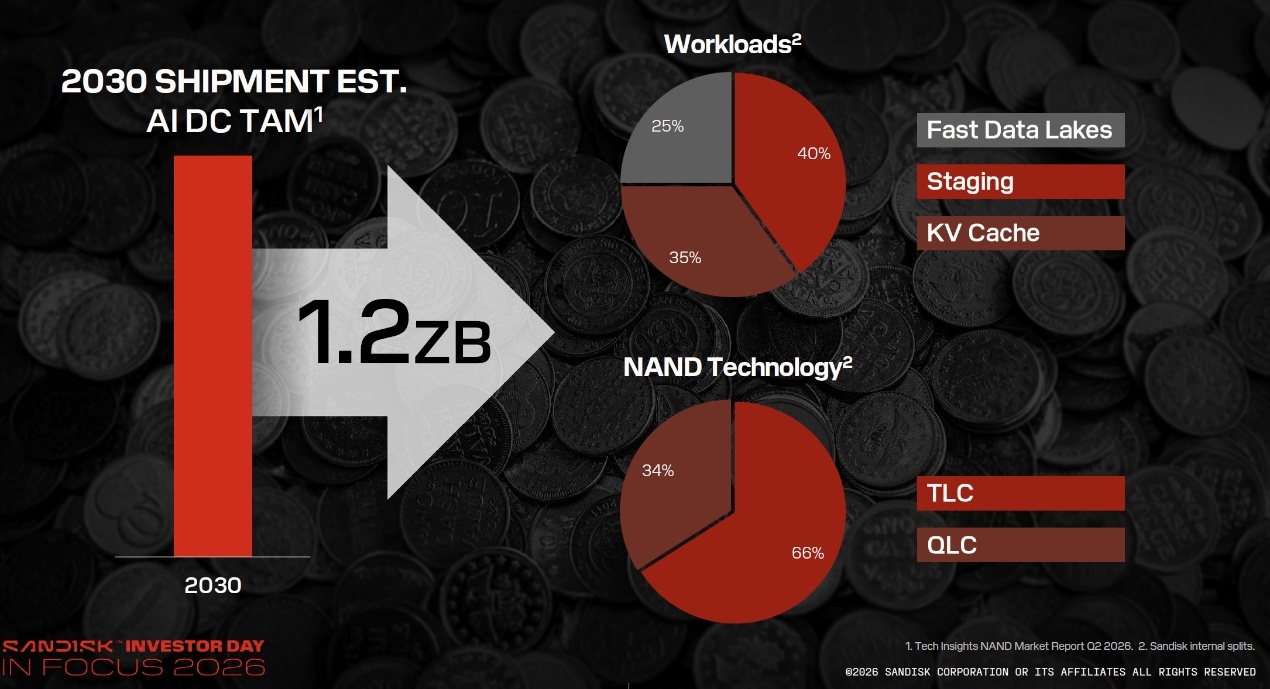
更關鍵的是這一槓杆結構上無法完整兑現——閃迪將 TLC 定位於高性能計算型 eSSD(承載 KV cache 中調用頻率不是那麼高的數據),QLC 用於大容量存儲型 eSSD(KV cache 中很少用到的數據)。
閃迪預計 2030 年 AI 數據中心閃存 TAM 達 1.2 ZB(相當於 2026 年全球出貨總量),其中 TLC 佔 66%、QLC 佔 34%。
換言之,即便最樂觀情景下,五年後仍有 2/3 的 bit 需求屬於 TLC;若想在單元層面繼續提密度只能等 PLC,而 PLC 目前實用性都有問題。
② 存儲單元 vs 邏輯單元的擺放位置優化:同樣是一次性收益,但價值不在密度
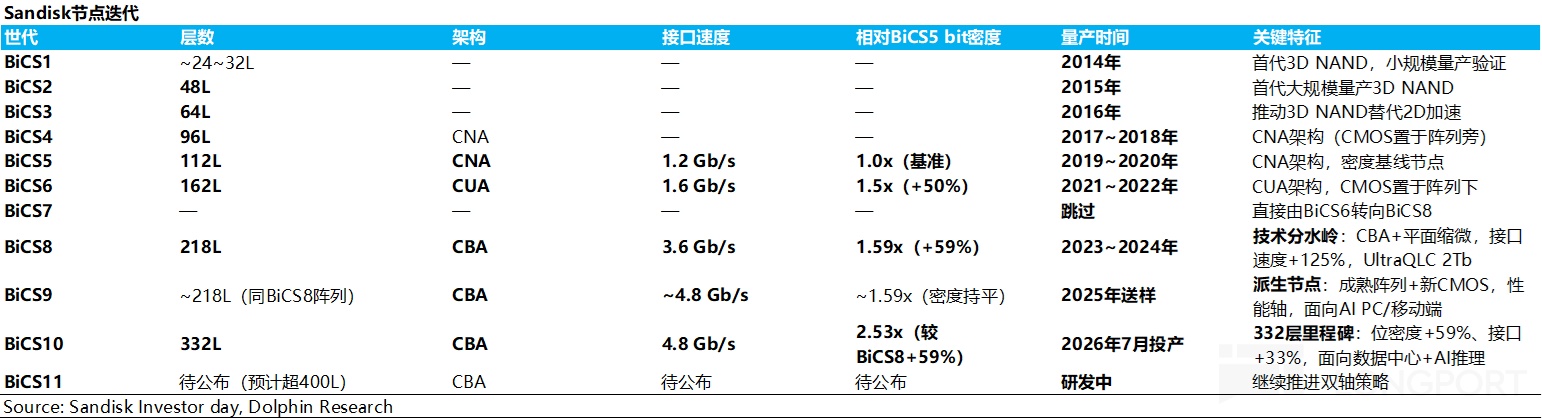
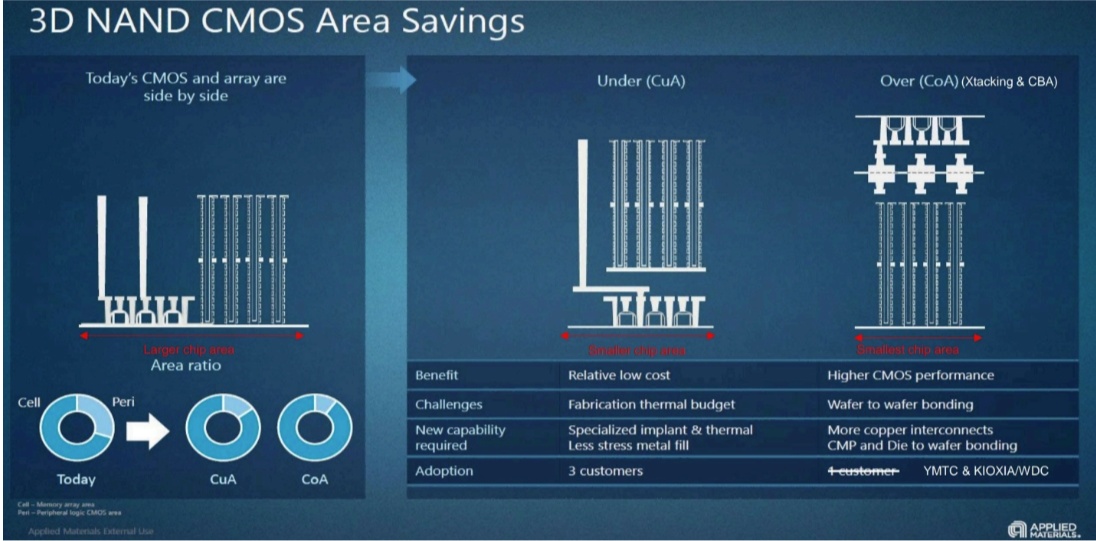
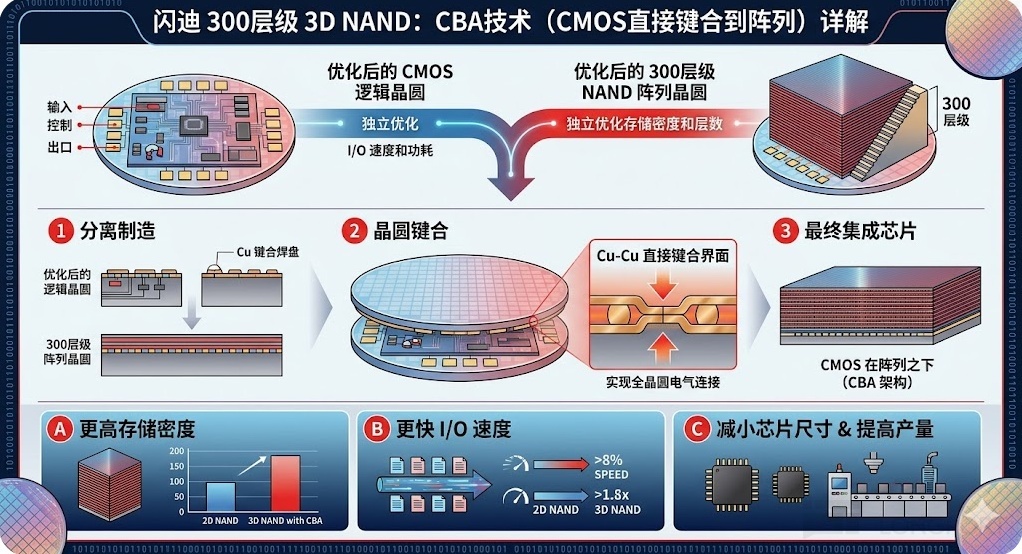
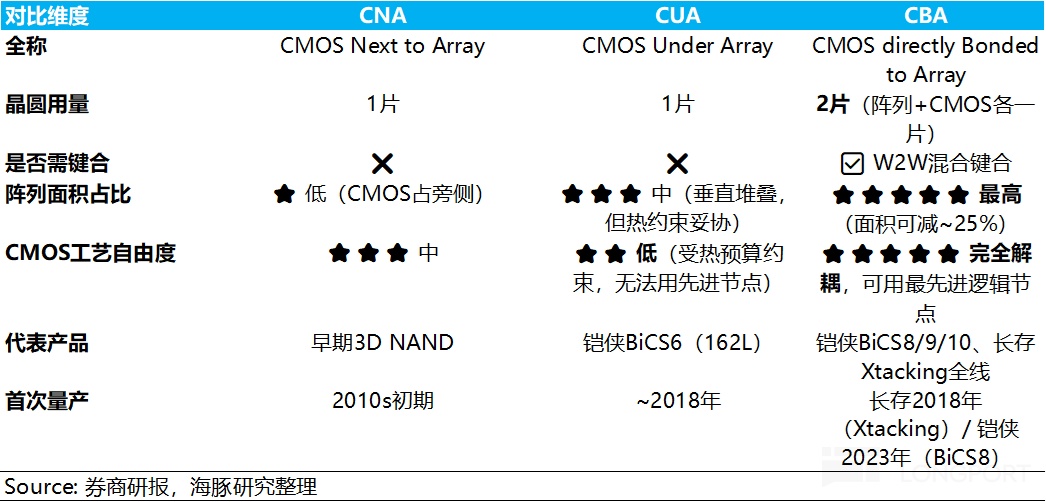
從密度看,CBA(CMOS bonded on Array, 邏輯單元與存儲單元直接銅銅鍵合)的本質是 “一次性回收閒置空間”:NAND 芯片由存儲陣列與不存數據的外圍 邏輯單元(CMOS)組成,架構演進主線就是剝離這塊 “無效率面積”——從邏輯平行於陣列旁(CNA)、置於下方(CUA),到陣列與邏輯分置於兩片晶圓、再經過銅 - 銅混合鍵合貼合(CBA)。
但空間回收有絕對上限:若邏輯原佔面積 20%、陣列佔 80%,完全移出後陣列佔滿 100%、密度提升 25%,此後再無面積可回收。長江存儲類似架構曾實現約 25% 的面積縮減(等效密度 +33%)。
但 CBA 對閃迪的真實價值不在密度,而在於提升性能:
銅銅鍵合後,邏輯單元和存儲單元分別生產,獨立處理後, 邏輯單元 CMOS 可用更先進製程(由邏輯芯片代工廠生產),實現更高 I/O 速度與更低功耗。
產品上,相較 BiCS8 同規格 2Tb QLC,只是把邏輯單元改為更先進製程後,BiCS9 寫/讀帶寬提升 150%/75%、寫/讀能效提升 85%/40%,且增量資本開支極小。
此外,CBA 依託的混合鍵合與多晶圓堆疊同樣是 HBF 的工藝基礎——首代 HBF 陣列即基於閃迪首個 CBA 節點 BiCS8。
③ 垂直縮放:沒有單一硬性物理上限,但 “經濟上限” 正快速逼近
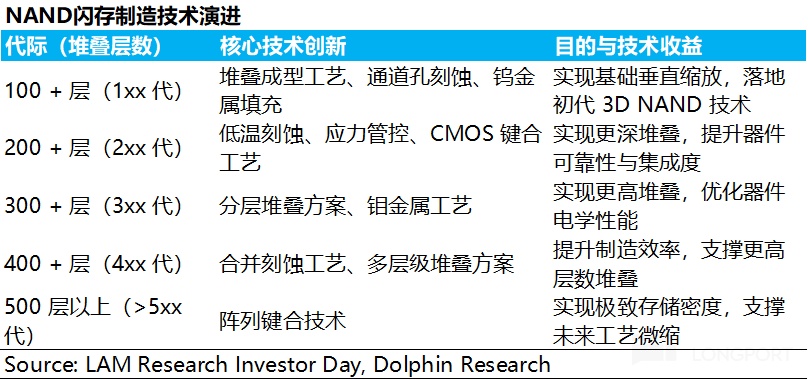
3D 垂直堆疊是當前擴容最主流、最直接的路徑,廠商已將最大化層數作為核心策略。雖無單一物理上限,但隱性代價與資本支出急劇攀升,受四重剛性制約:
a. 產能稀釋 “陷阱”:層數激增使刻蝕、沉積工序成倍增加,設備固定下單片加工時間拉長、月投片能力下滑。從 176 層升至 300 層以上,單片容量雖增 50%–60%,但因工序拉長,實際 bits 產量並沒有 50-60% 這麼高的增長;
b. 多 Deck 的 “工藝懲罰”:受溝道刻蝕深寬比限制,一次成型最高堆疊 120–150 層,超過就要做出新的一層(類似雙層巴士的 Deck),重新走一下刻蝕、接觸、填充全套工序;
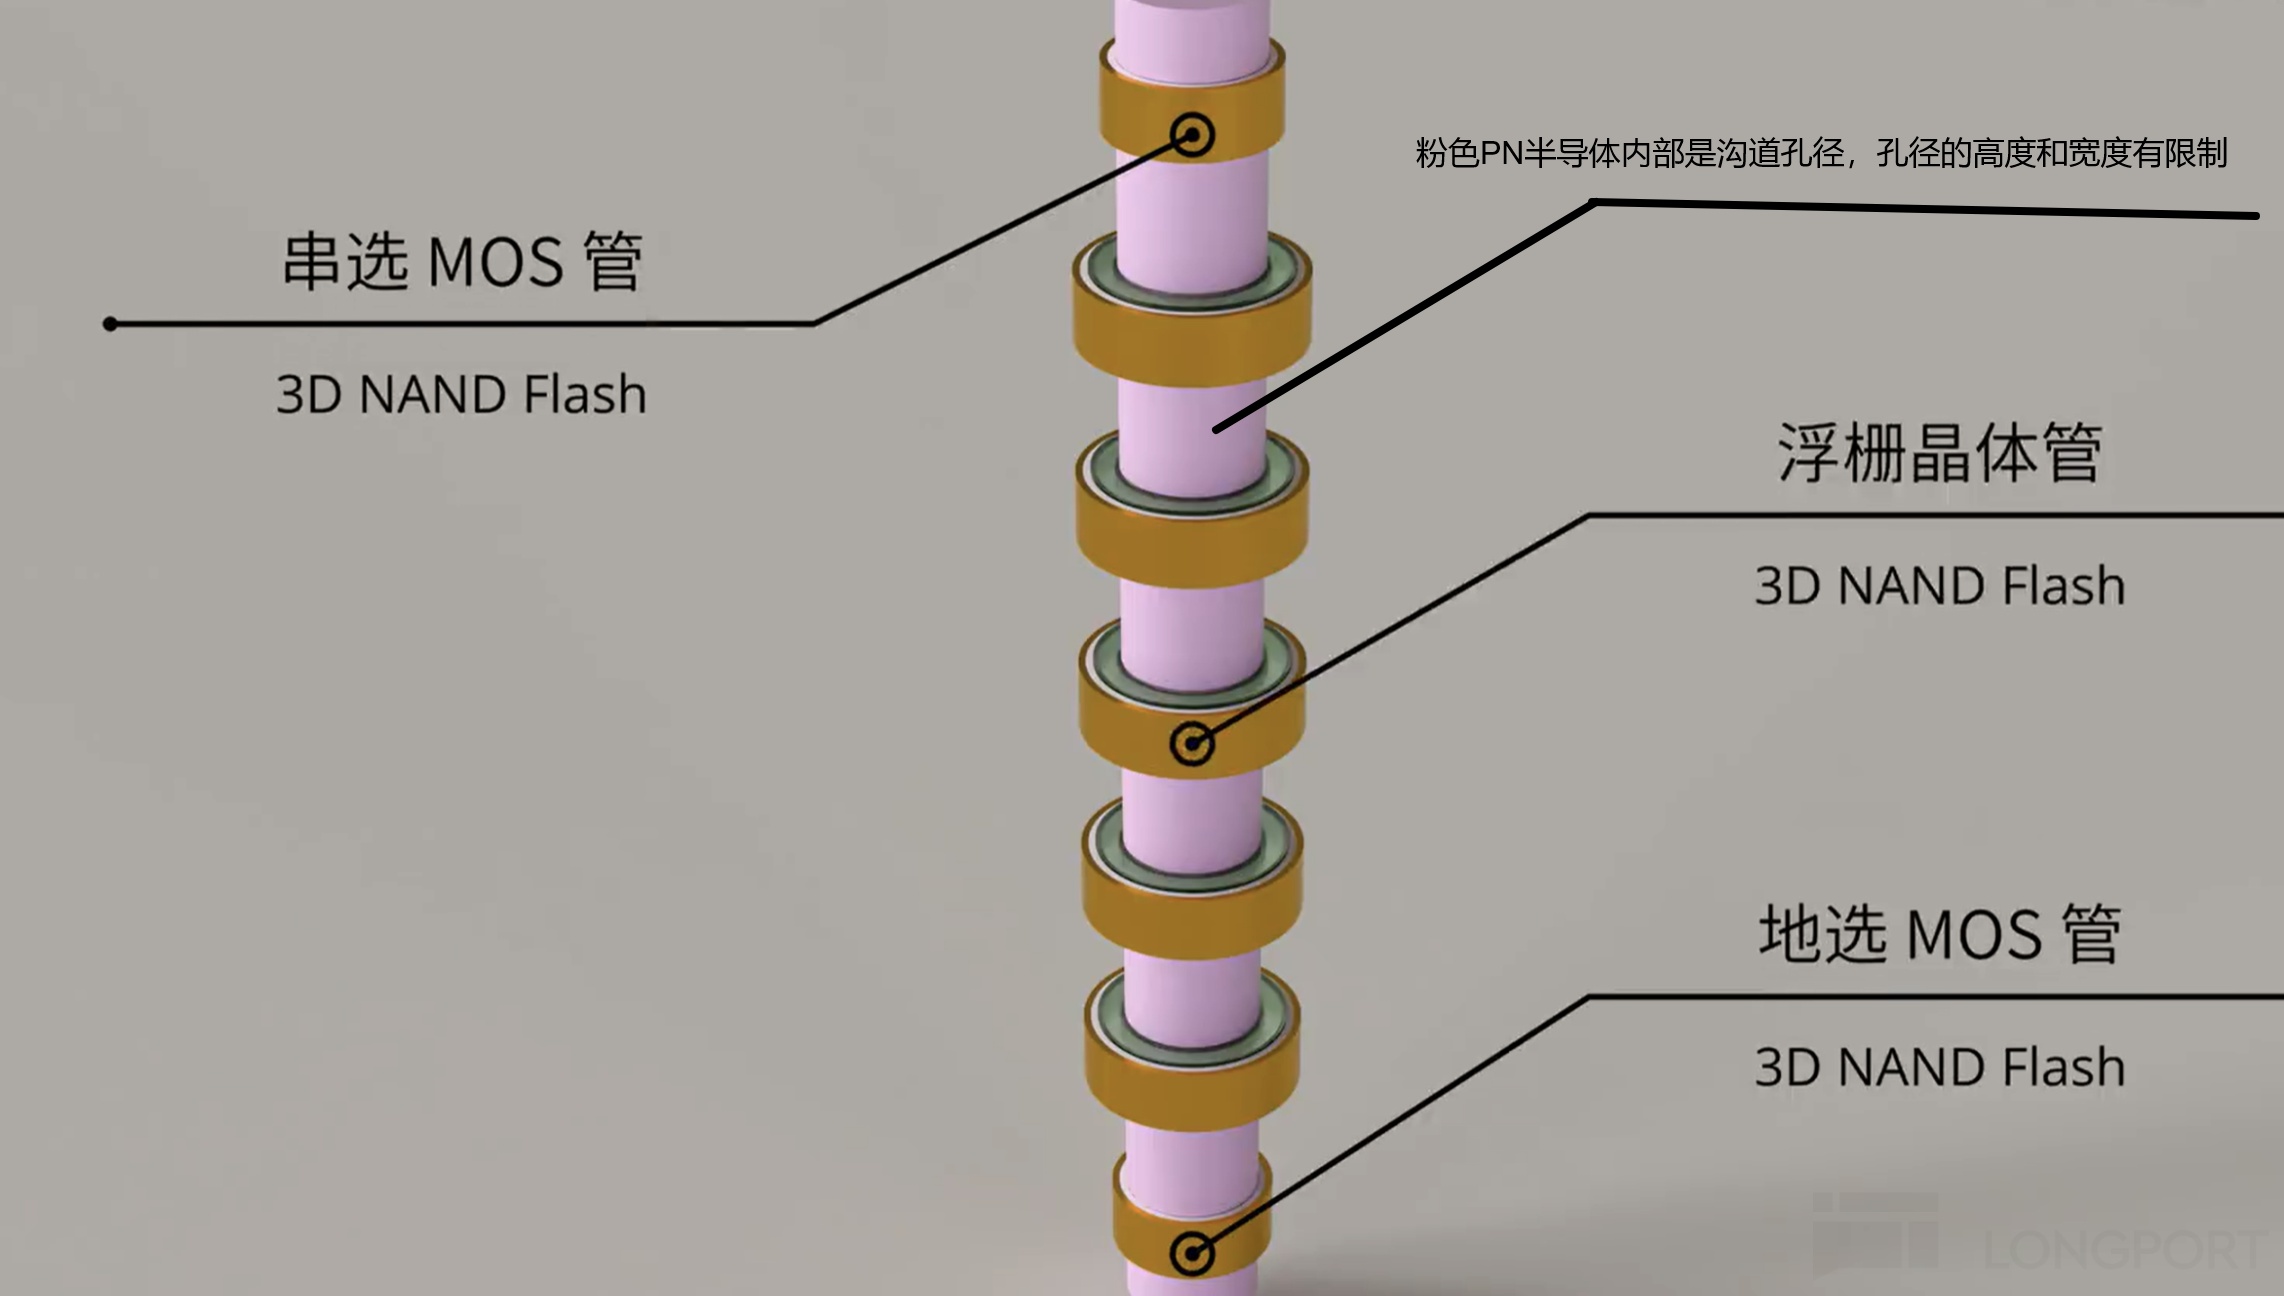
c. 材料強制換代:做成兩層 “巴士”,也就是 300 層,傳統鎢絲電線電阻飆升、漏電失效,要轉為鉬金屬, 沉積與刻蝕設備投資(每萬片月產能)就近乎翻倍;
d. 500 層以上的 “陣列鍵合” 與應力牆: 到這個層數後氧化物材料容易變形,在往上走,就要走類似 HBM 那種硅片與硅片之間的堆疊,複雜驟然拉昇。
換言之,500 層以上 “繼續堆層” 需要的是需鍵合能力作前提,而這恰是鎧俠/閃迪自 BiCS8 起率先量產、已積累經驗的領域。
④ 橫向縮放:縮小存儲孔徑、收緊 block 間距:差異化價值最高的引擎
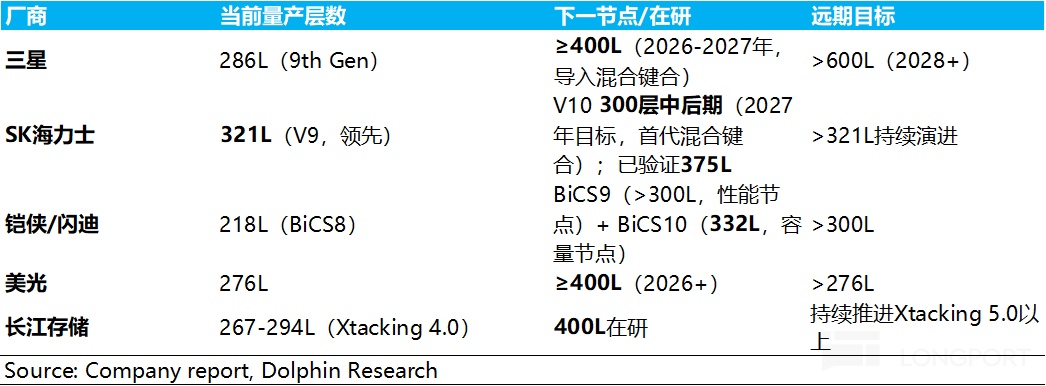
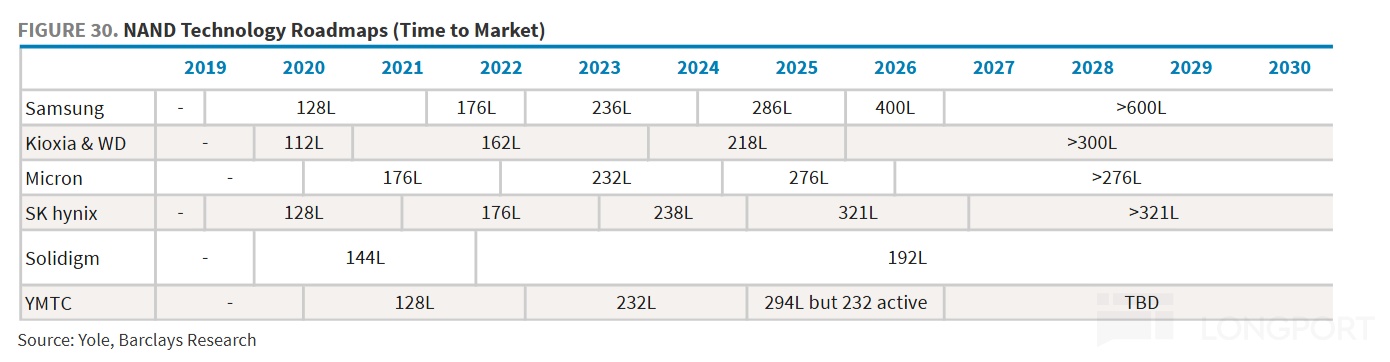
疊層數(如下圖,層數加高)是三星和海力士的選擇,因為它們在 DRAM 上積累了不少的經驗,而在平面維度上加密存儲單元 + 不同功能單元優化組合結構是鎧俠/閃迪的方案。
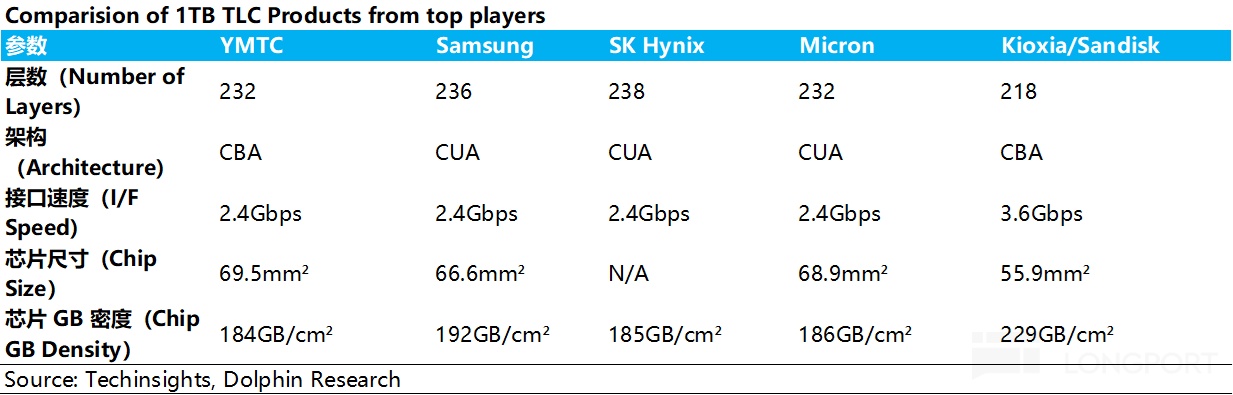
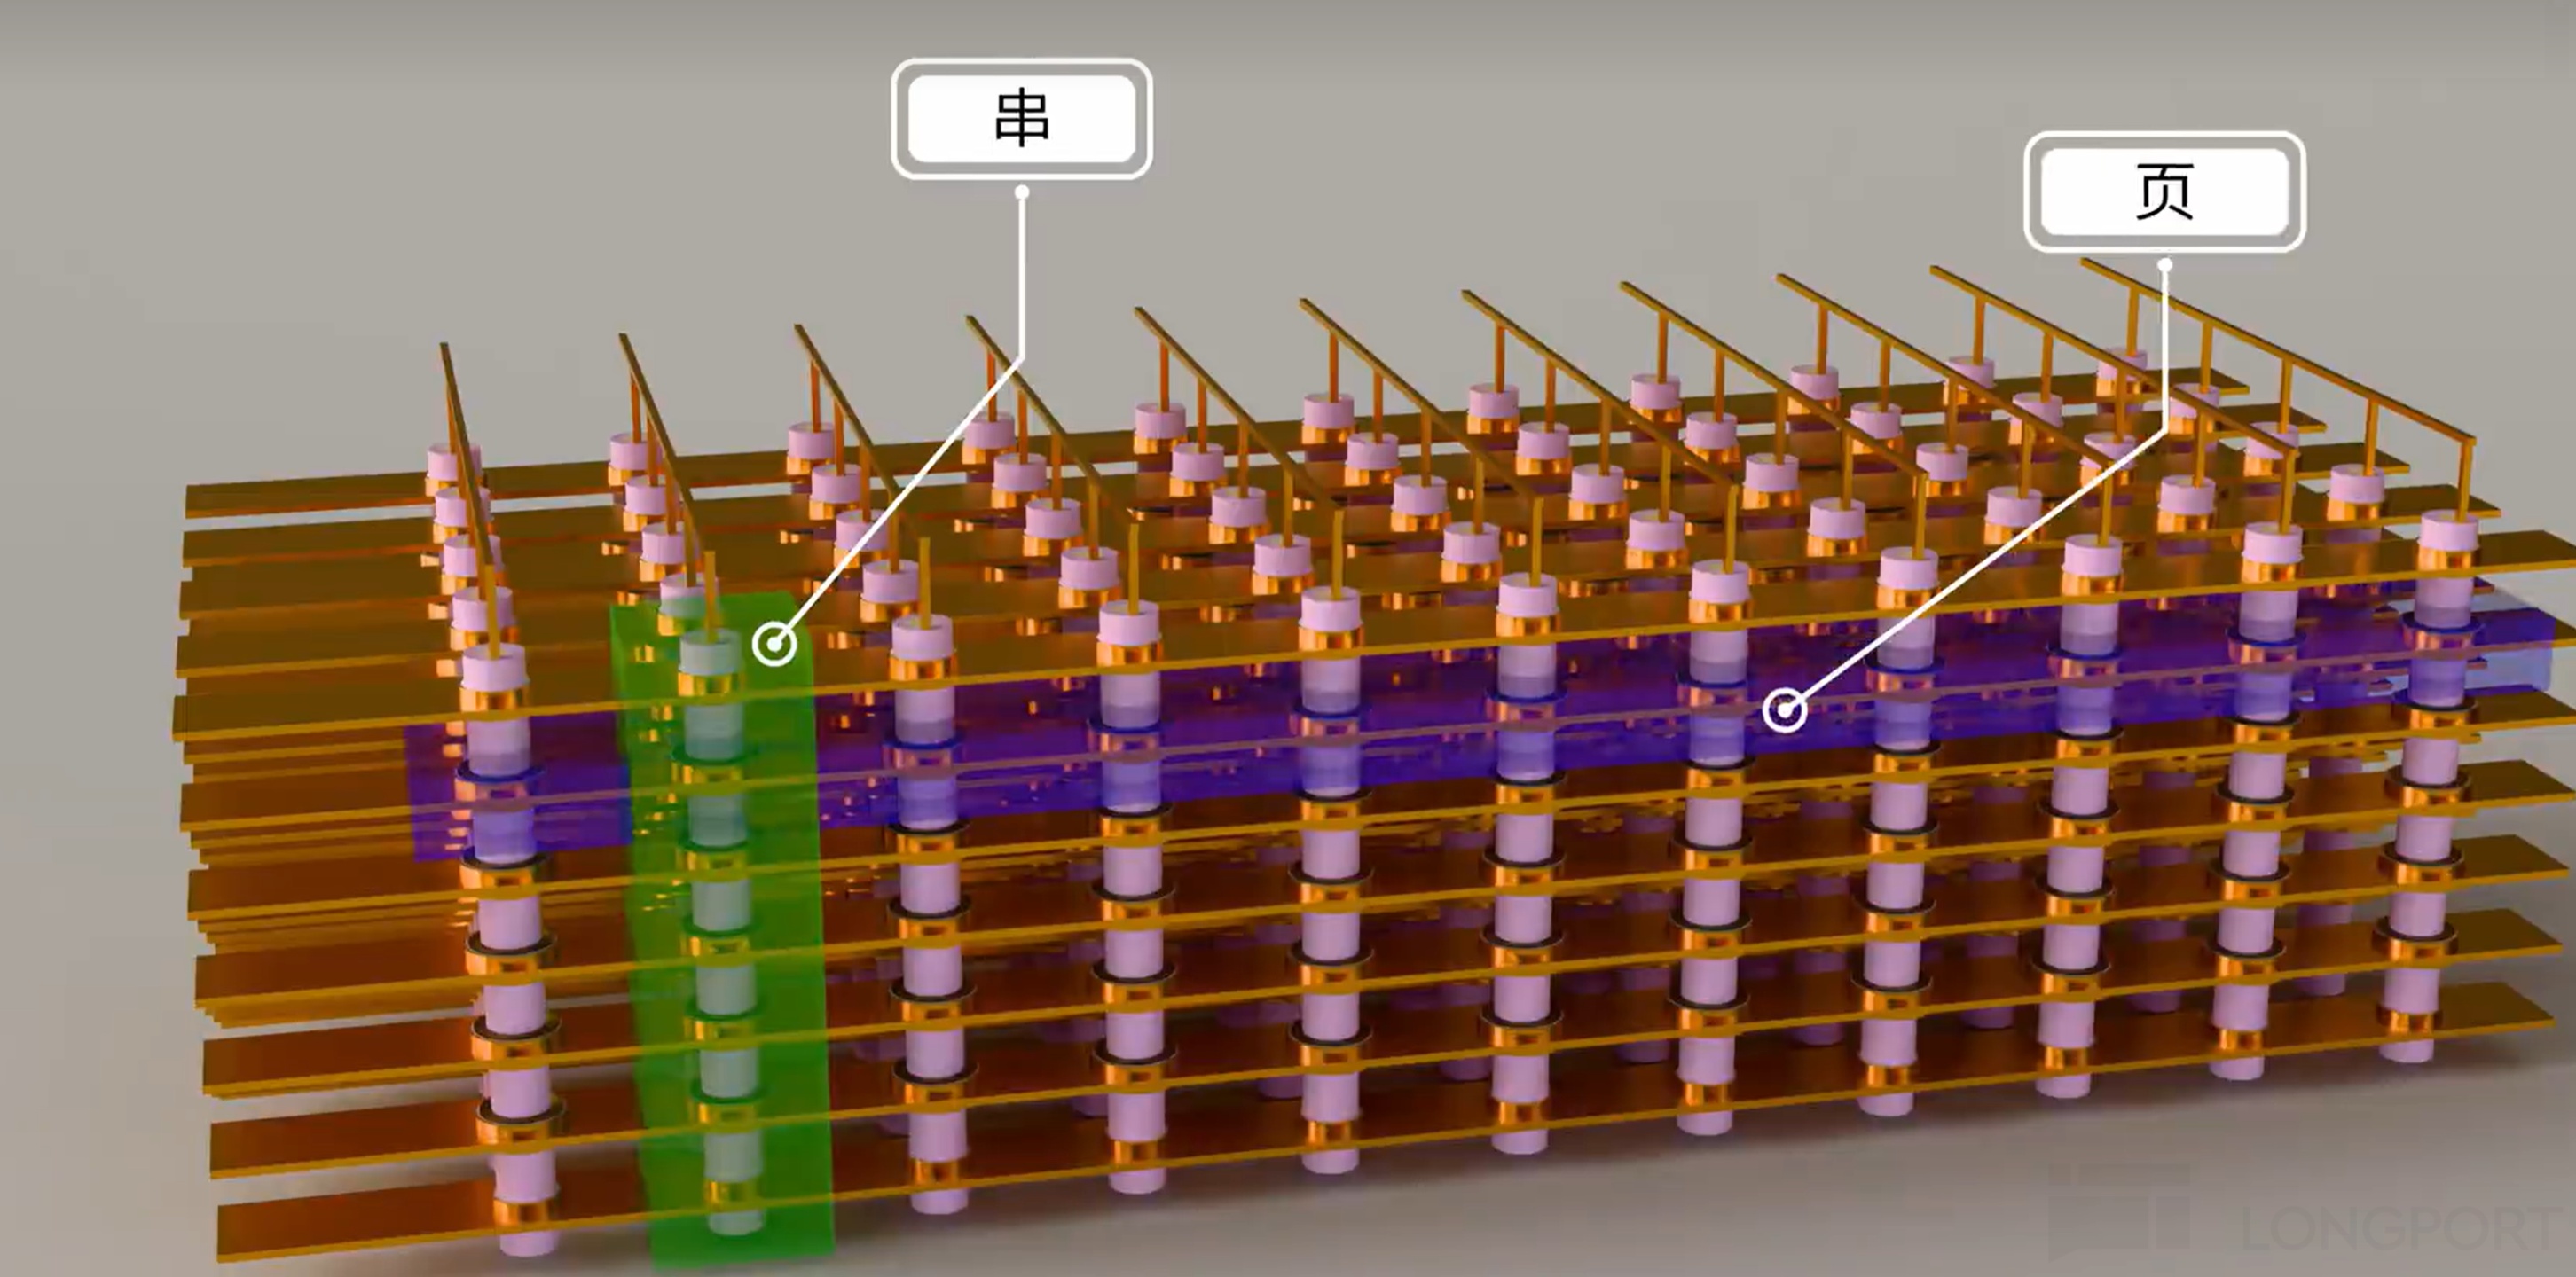
橫向加密的核心是刻蝕上搞事情(如下圖,在一個平面上加更多的柱子),結果是鎧俠/閃迪以全場最少的 218 層實現最高的 229 GB/cm² 密度,每層貢獻密度較次優者高 29%;芯片面積 55.9 mm² 也最小、較三星小 16%,同片晶圓可多切約 19%——層數雖低,密度與性能均未落後。
兩種策略的本質差異在資本強度:三星、SK 海力士以更多工序與設備換層數領先;鎧俠/閃迪以更少層數實現更高密度、消耗更少工序與設備。
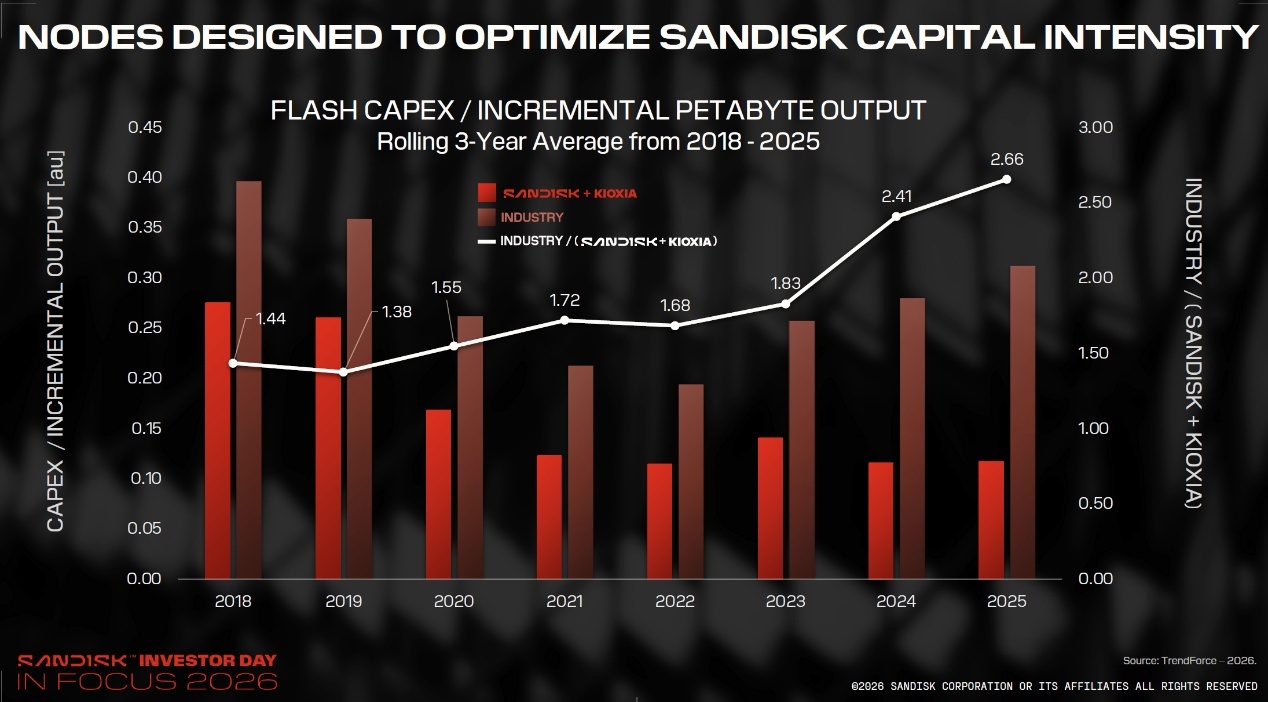
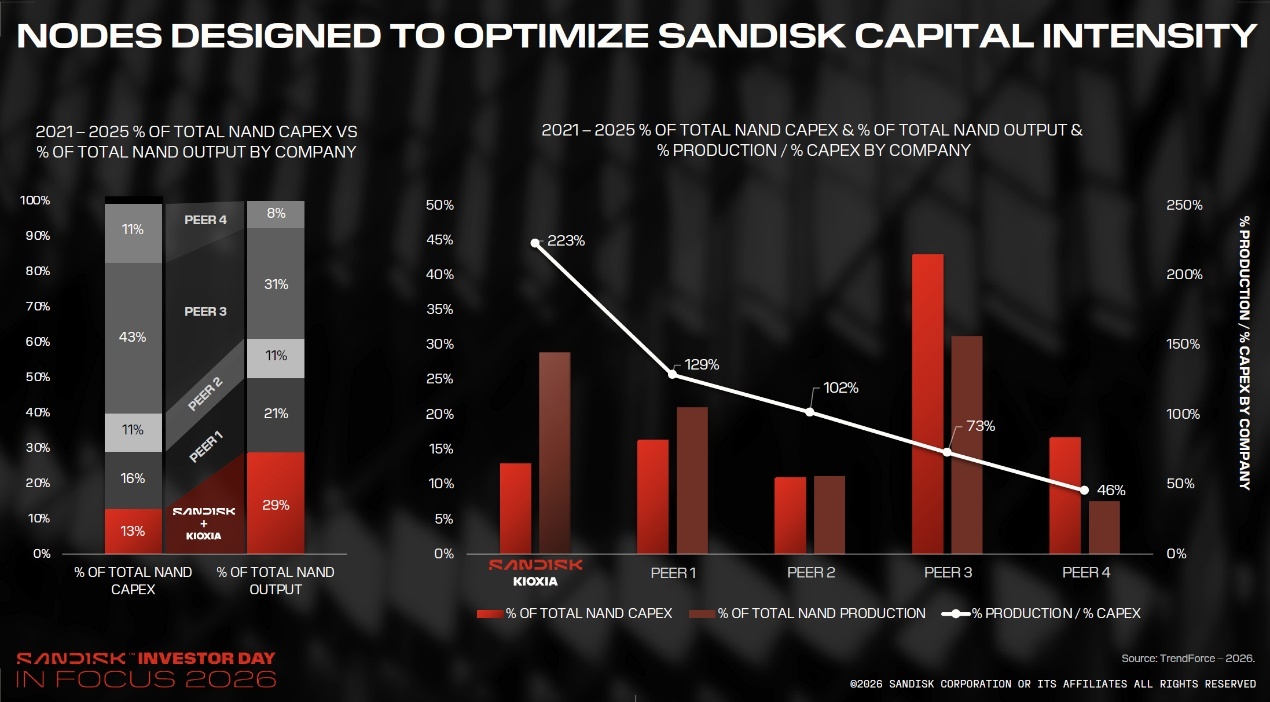
這直接體現在資本效率上:2025 年行業平均每增量 PB 產出所需資本開支為閃迪與鎧俠合資體系的 2.66 倍;2021—2025 年雙方以 13% 的行業資本投入產出了 29% 的行業 bit。
3. 同為存儲基石,NAND 與 DRAM 在供給端到底有何根本不同?
NAND 與 DRAM 的供給擴張遵循兩套完全不同的底層邏輯。這一差異並非源於策略,而由物理結構決定,並直接轉化為資本強度與週期性的區別。
擴張供給僅兩條路徑:技術工藝迭代(提升單片 bit 容量,屬存量升級)與增加晶圓投片量(新建潔淨室、擴設備,屬增量投入);前者資本消耗遠低於後者。
而節點遷移的成效取決於存儲密度還能多快提升,方向只有兩個:
a. 縱向——往上堆層,每層都裝單元;
b. 橫向——讓每個存儲單元佔地更小,同層塞進更多。
NAND 兩個方向都能走——既可堆層倍增密度,又可橫向縮微;而 DDR 內存在同一晶圓底座上只剩橫向一條路——其一個存儲單元內除了一個晶體管,還有一個垂直深孔電容,無法像 NAND 那樣 “一次刻穿多層” 低成本堆疊。
這決定了遷移的產出上限:DDR 內存 單代密度僅提升約 10%(1b→1c 已不足 10%),NAND 單代仍達 50%–60%。故 DDR 內存僅靠遷移每年單位晶圓 bit 產出僅增約 5%–10%、遠不足以覆蓋需求,缺口只能靠新建潔淨室填補;NAND 則相反,遷移本身的產出增量已能滿足甚至超過需求。
為什麼 DRAM 無法像 NAND 一樣做垂直堆疊?
3.1. NAND 3D 堆疊:靠 “批量成型” 與 “串聯共享” 實現內生擴容
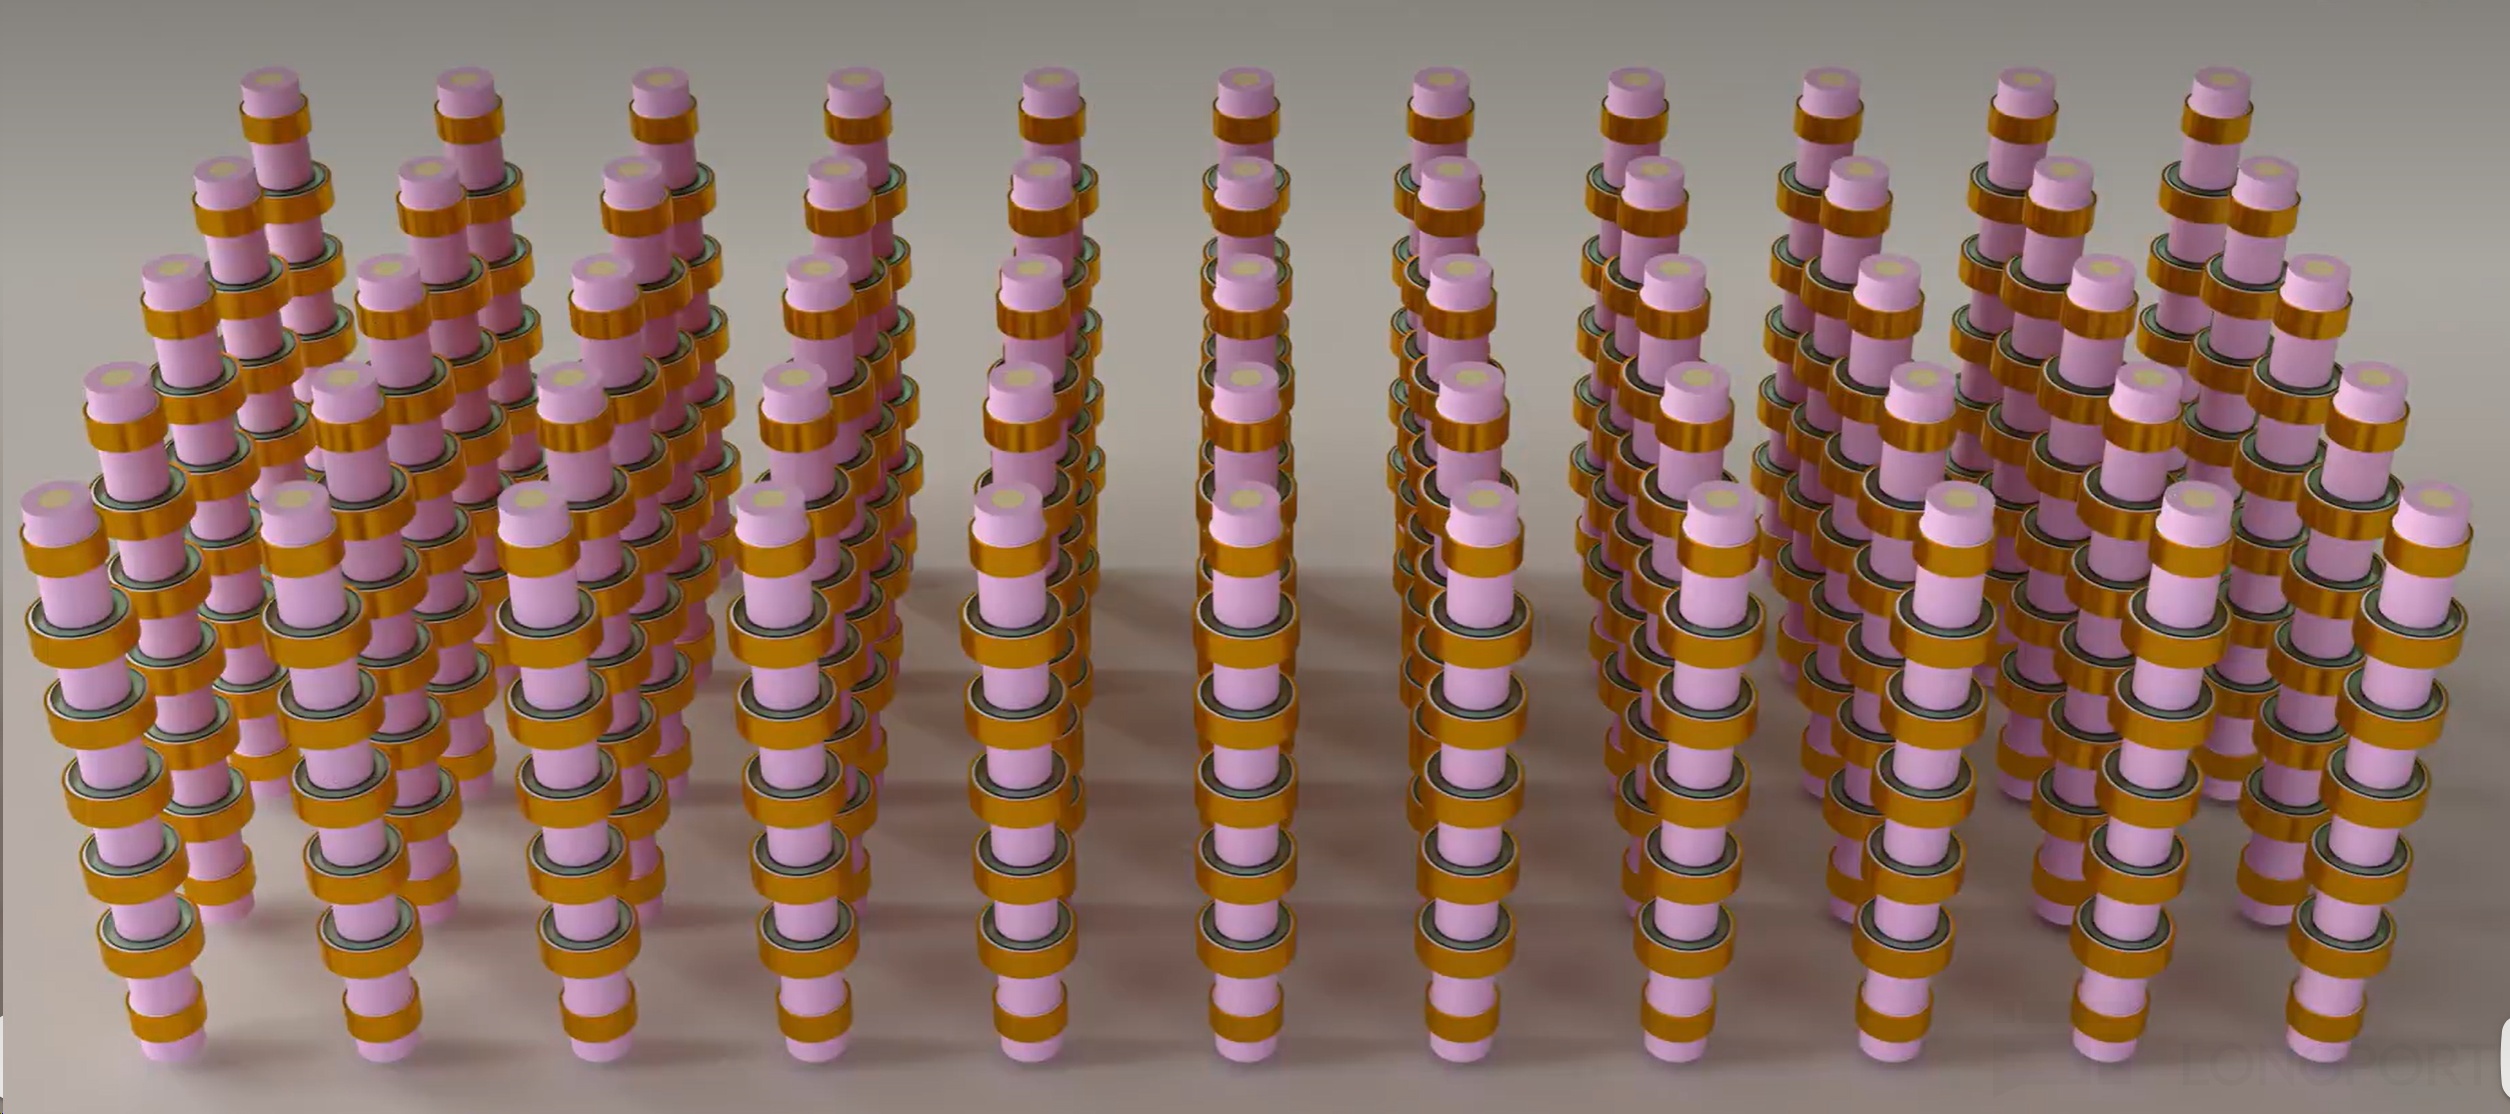
a. 串聯共享:NAND 單元本質是可導通的晶體管,數百個串聯在同一根垂直溝道、共享一條位線;讀取某層時只需向非目標層施加導通電壓(Pass Voltage)使其等效為導線,電流即可穿透讀取目標。
b. 批量成型:3D NAND 製造類似 “一次性澆築”——先交替沉積數百層氧化物與氮化物,再以極高深寬比干法刻蝕(HAR Etch)一次打通全部疊層、填入溝道材料,數百個單元同步成型。
NAND 單元不是 “造” 出來的、而是 “交叉” 出來的:每層沉積材料本身即一條字線、像刷牆一樣均勻鋪開、無需逐層定位器件;真正 “創造” 單元的動作只有把溝道柱刻穿——刻一次孔、300 層同時得到 300 個單元。
其成本關鍵在工序結構不對稱:層數提升增加的主要是沉積(重複、低成本),而定義溝道孔的光刻與刻蝕(高成本)次數並不隨層數增長。
DRAM:受制於二維極限的重資產擴張宿命
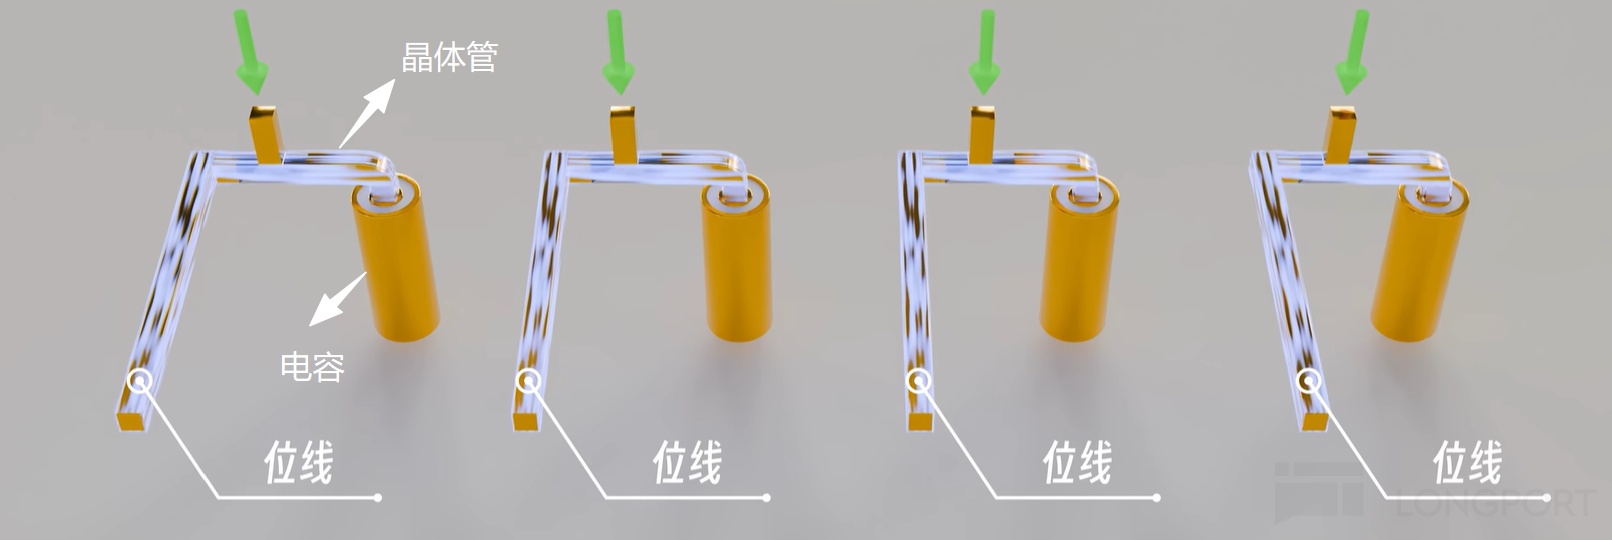
a.物理根因:電容不導通、單元無法串聯
DRAM 每單元由一個晶體管加一個深孔電容組成(1T1C),無法複製 NAND 的串聯結構,因電容隔斷直流電——相當於一道永遠打不開的 “牆”,串起來時電流連第一道牆都過不去。
NAND 承擔得起 “逐個打開前序單元” 的開銷,還因它一次搬一大片(整頁數 KB、整塊數 MB)、開銷被攤薄;而 DRAM 作為 CPU 工作內存必須精確取任意地址、延遲數十納秒,沒有攤薄的選項。
因此 DRAM 縱向無法共享位線——每增一層就需自底部多引一條。
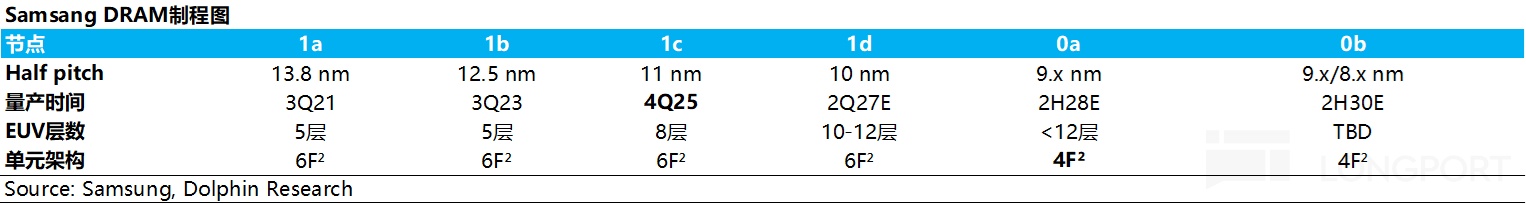
b. HBM 進一步放大了產能缺口
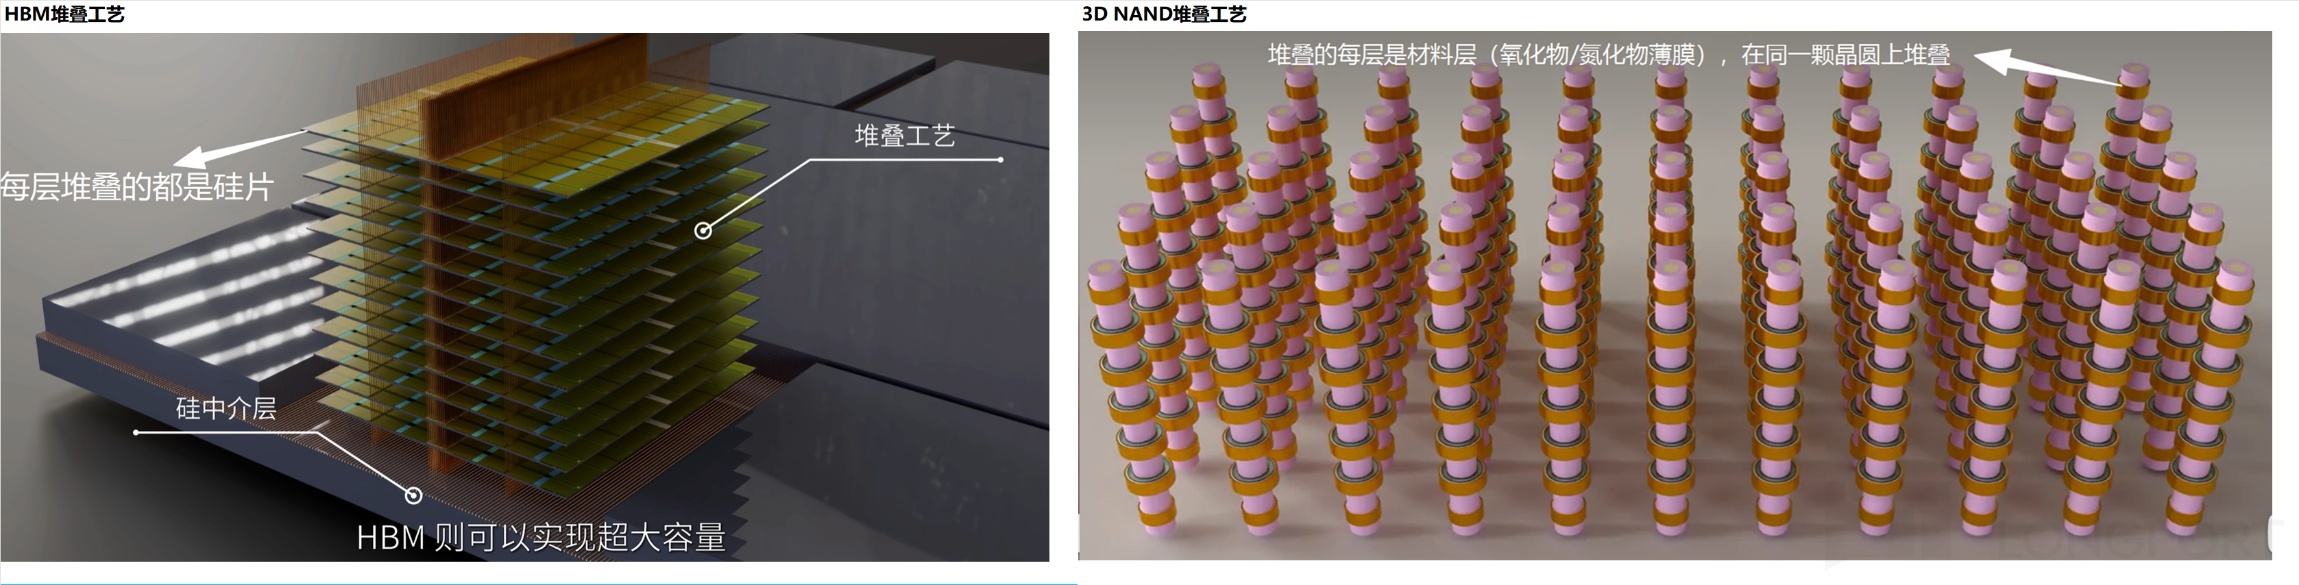
當橫向微縮帶來的單 die 容量進步放緩,為同時解決帶寬與容量瓶頸,HBM 應運而生,其本質是在有限封裝面積內塞進更多容量與帶寬(存儲容量=單 die 容量×層數)。
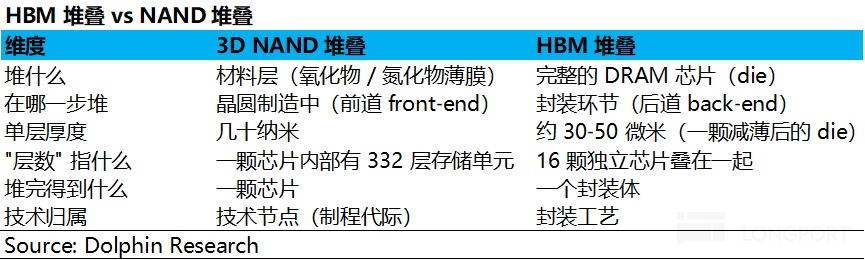
但 NAND 與 HBM 的堆疊截然不同:
NAND 是 “在一顆芯片共用地基上,蓋 300-400 層樓”——一次工序數百層同時成型,越堆越便宜、不額外佔晶圓面積;
HBM 是 “把蓋平房,再把每個平房帶地基,一層層摞起來”——每棟單獨蓋、打孔、對準,越堆越貴,還成倍消耗晶圓產能。
在 DRAM 技術遷移每年僅提供 5%–10% 增量的背景下,HBM 的興起使缺口急劇擴大,其對晶圓產能的消耗有三重放大:
a. die 更大——TSV 硅通孔與複雜 I/O 電路需設置內存禁放區,減少可用存儲面積,同容量下 die 面積較標準 DDR 顯著增大;
b. 多層堆疊消耗多顆 die——單顆 HBM 由 8~16 層 die 堆成,需要消耗的 die 更多(類似蓋樓層高需耗更多磚塊)
c. 綜合良率結構性偏低——即便單顆 die 良率很高,堆疊後因切割和鍵合損耗和良率等問題,複合良率不對稱下降
三者疊加,生產同等 bit 的 HBM 所耗晶圓產能約為標準 DDR 的 2–3 倍。
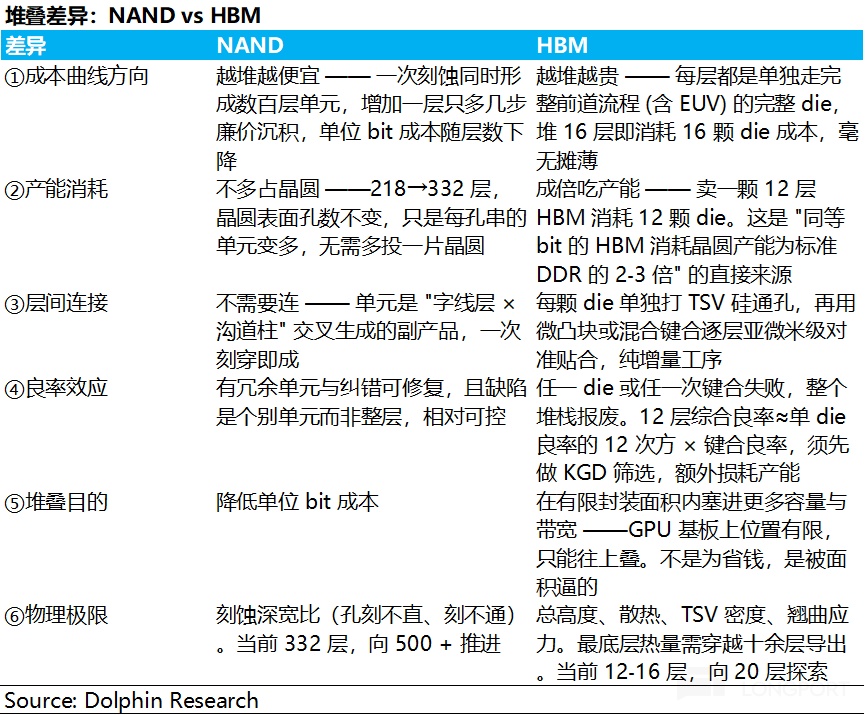
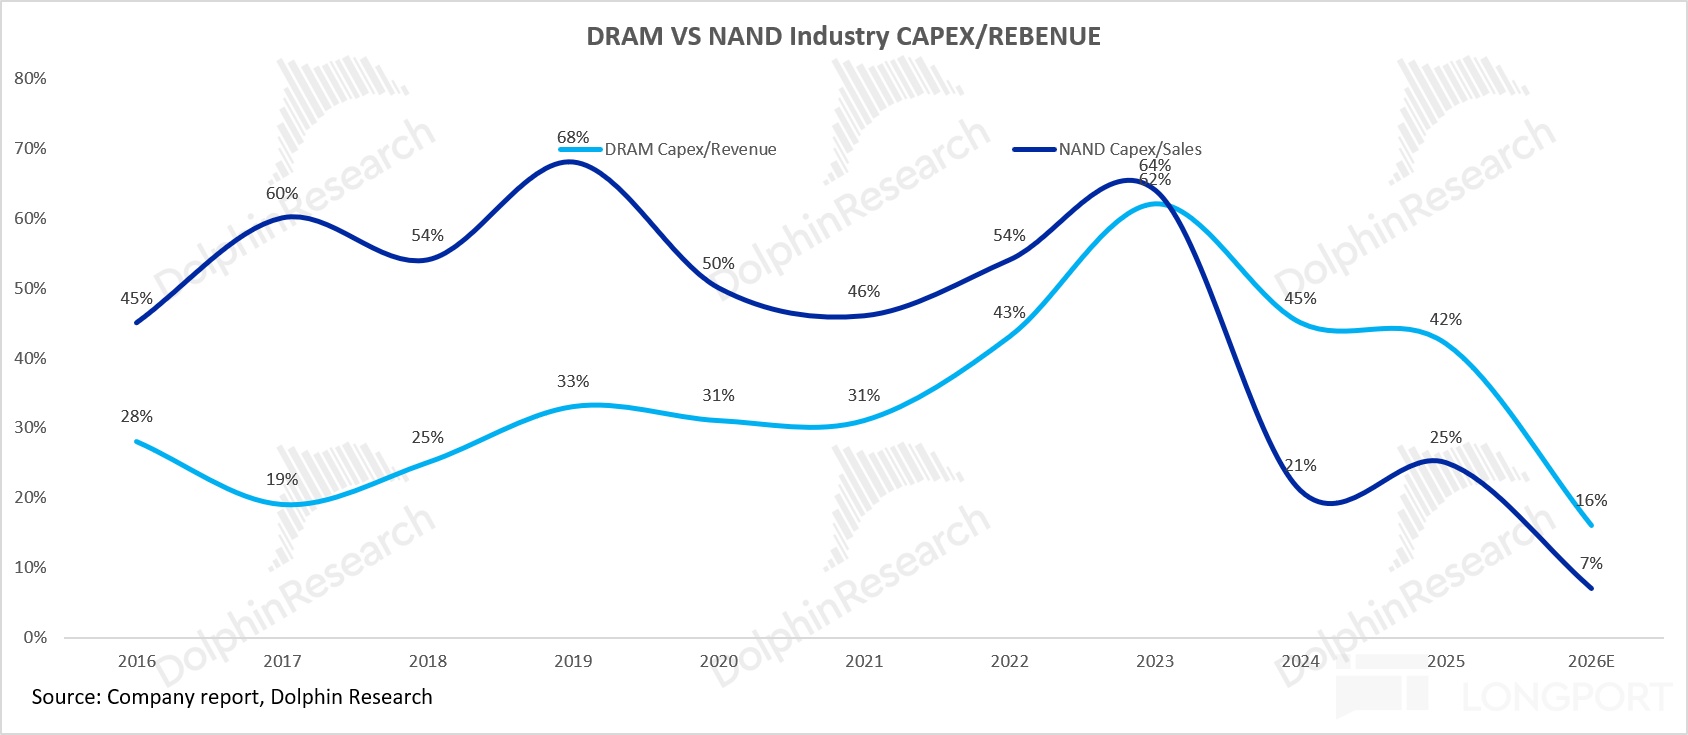
而缺口只能靠新建潔淨室填補,這直接解釋了 2024—2026 年 DRAM 與 NAND 在產能投資上近乎相反的局面:
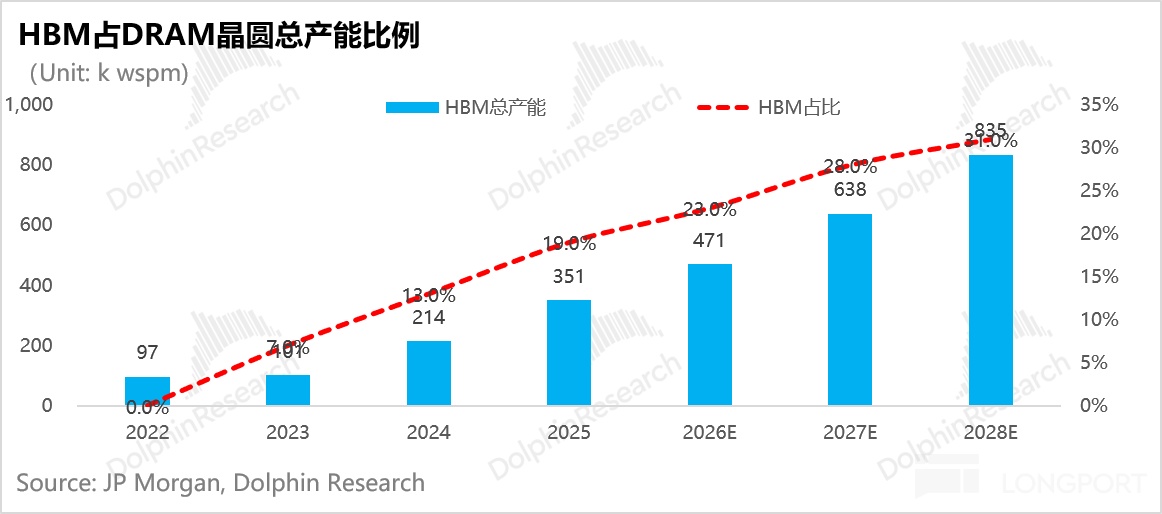
HBM 擠佔是本輪投資浪潮的核心:HBM 佔全球 DRAM 晶圓產能比重從 2023 年的 7% 升至 2026 年的 23%,絕對產能由 10 萬片/月擴至 47 萬片/月、三年增逾三倍。
而 HBM 的產能效率遠低於標準 DRAM:其 die 面積約為三倍——一片晶圓可產 1,500–1,800 顆 DDR,卻僅產 500–600 顆 HBM die,加之單顆需 8~16 層 die 堆疊、逐層消耗產能併疊加良率折損,有效 bit 產出效率顯著更低。HBM 每提升一點滲透率,都實質擠壓標準 DRAM 產能。
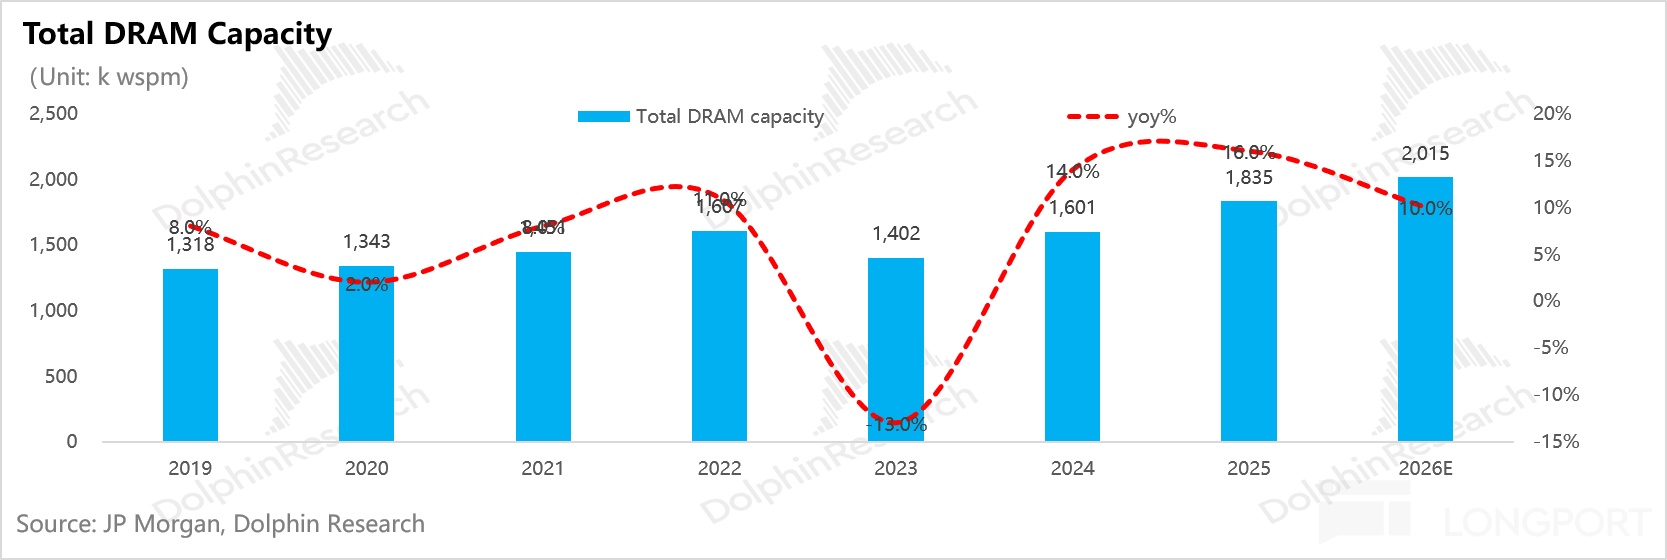
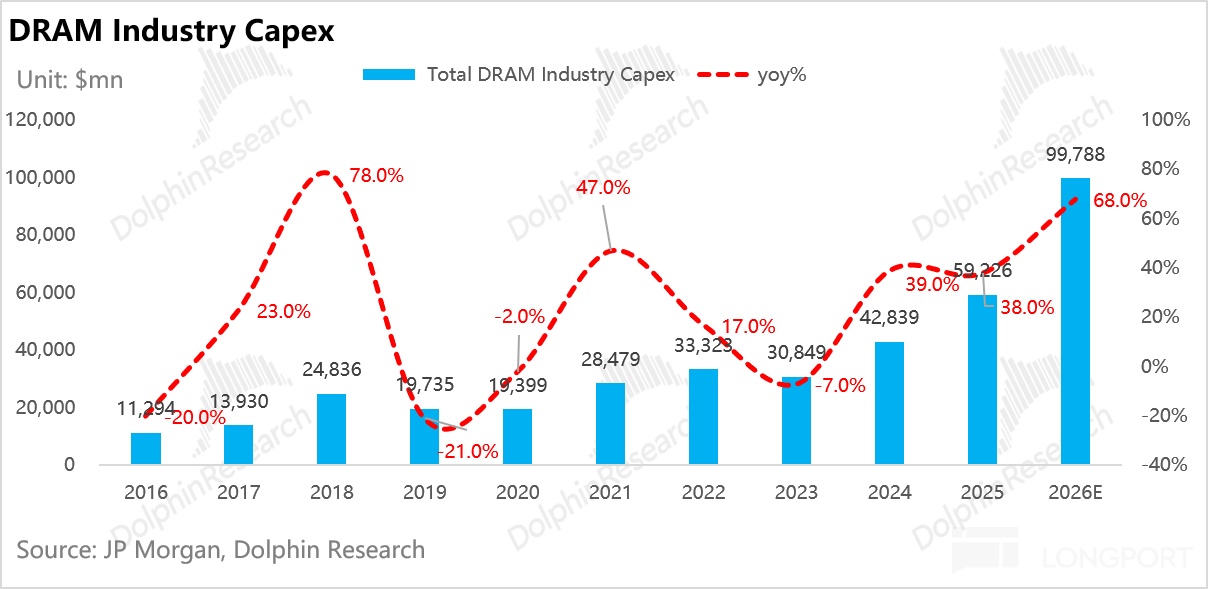
也因此 DRAM 資本開支持續攀升:由 2023 年 308 億美元升至 2026E 998 億美元(單年增速 68%);全球 DRAM 產能在 2023 年 −13% 後轉入擴張,由 140 萬片/月增至 2026E 的 202 萬片/月、較 2022 峯值高 25%。
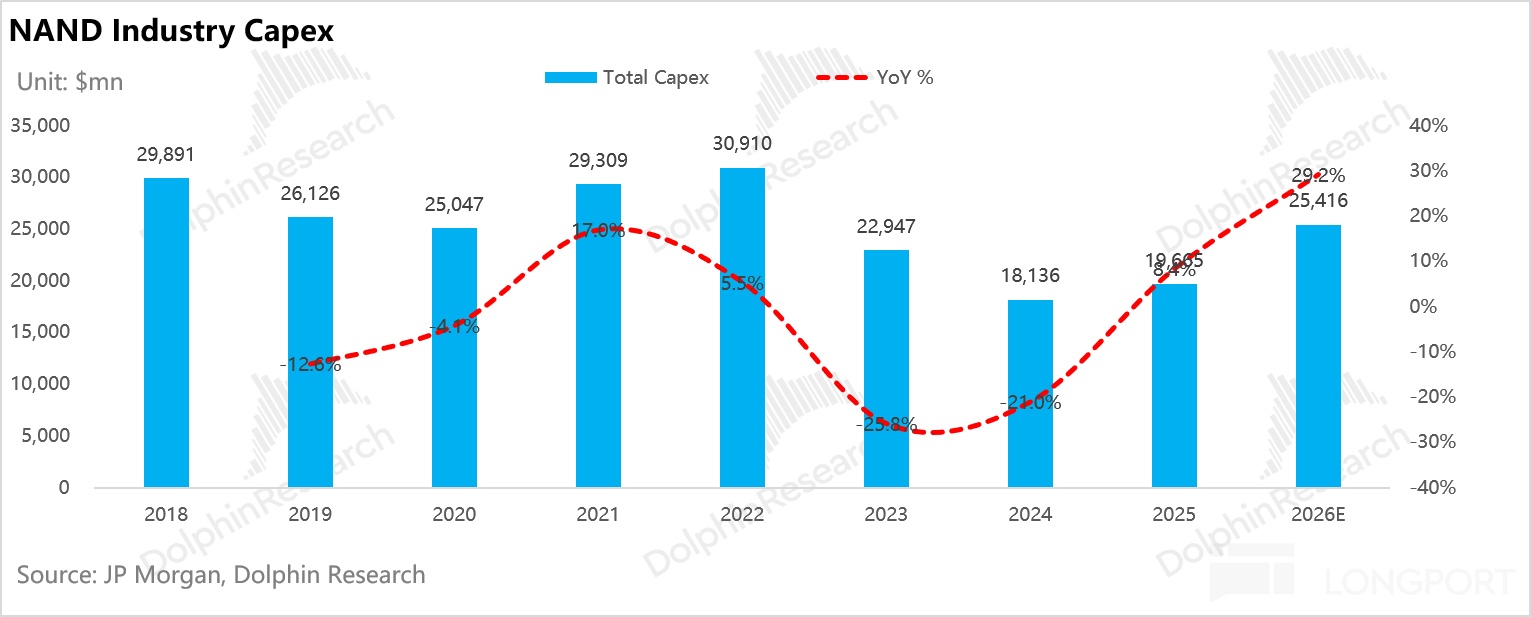
而 NAND 資本開支雖自 2024 年 197 億谷底回升(2025 +21%、2026 +29%),2026 年的 254 億仍較 2022 年峯值低約 18%。
2026 年 DRAM 行業資本開支約 998 億美元(三大原廠約 877 億),同期 NAND 僅約 254 億——DRAM 近乎 NAND 的 4 倍。
更具可比性的是資本強度:2026 年 DRAM 資本開支/收入為 16%、NAND 僅 7%,持續維持在 DRAM 一半以下,與閃迪 “中低個位數” 的長期指引吻合。
這本質是兩種供給邏輯在同一週期的鏡像:DRAM 必須新建工廠才能多產 HBM,NAND 靠技術遷移即可滿足需求增長。
4. DRAM 與 NAND 為何 “同源不同命”?
雖同屬強週期行業,但底層物理結構的差異,最終在商業模式上造就兩者截然不同的宿命:
a. 週期方向的不對稱:NAND 下行更慘烈,DRAM 調節更從容
NAND 下行更慘烈——遷移 “自帶” 供給增長,哪怕大幅削減 CapEx,單片 bit 產出仍隨層數堆疊慣性增加;尤其 3D 過渡期曾帶來一次性躍升,使產能增速一度遠超需求。
DRAM 下行則相對温和:其遷移增速持續放緩且遠低於需求,擴張高度依賴新增潔淨室——只要削減 CapEx 就能在物理層面真實、迅速收緊供給。這使 DRAM 上行擴產更難,但下行更有抗跌底氣。
b. 定價權底座的差異:DRAM 靠 “物理護城河”,NAND 靠 “行業紀律”
DRAM(尤其 HBM)的緊缺源於真實的物理產能限制與極高製造複雜度,廠商定價權極強;HBM 依賴的 TSV、先進鍵合形成顯著差異化,迫使三大原廠將產能向 HBM 傾斜、進一步加劇標準 DDR 緊缺。
反觀 NAND,當前緊平衡高度依賴寡頭之間的 “默契”:閃迪主動將行業 bit 增速目標壓制在約 15%、而非歷史上激進的 30% 以上。
這意味着行業內部仍蟄伏大量未釋放的技術產能,無需鉅額新增 CapEx 即可隨時投放,構成上行週期極大的潛在彈性與不確定性。
一旦供應默契鬆動、或中國廠商加速擴產,NAND 供過於求的達摩克利斯之劍隨時可能落下。
c. 現金流與資本回報的背離:NAND 蜕變為 “現金牛”
DRAM 必須將經營現金流持續重資本再投資(新建一座先進廠投資已超 200 億美元),而 NAND 資本開支主要用於存量產線的節點升級、而非擴產。
以閃迪為例,其長期指引極優:資本開支僅佔營收中低個位數、調整後 FCF(自由現金流)利潤率約 50%,且 100% 超額現金將通過回購返還股東。
儘管 SK 海力士 2026 年 8 月宣佈 40 萬億韓元回購、標誌 DRAM 巨頭也在跟進股東回報,但其天然更高的資本強度,註定上超級行週期內現金流比不了輕資產的 NAND。
綜上,當 NAND 供給端能 “自動” 實現 bit 增長、而三大原廠又將真金白銀優先砸向 DRAM/HBM 使 NAND 時,NAND 供需變化要看:一是供給端其他原廠是否打破默契,轉而在 NAND 上擴產;需求端 AI 持續拉高 NAND 的持續性如何?
那麼,AI 浪潮下,其他廠在 NAND 上是否真默契不擴產?下游需求帶來怎樣的結構性重塑?這波漲價超級行情還能飛多久?站在當前估值節點,涅槃後的閃迪是否仍有向上空間?
這些問題,海豚君將在下篇報告中一一拆解,敬請期待。
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。