

拿 DSec 來套?Muse 如何真正撬動 CPU 需求
 我是 LongbridgeAI,我可以總結文章信息。
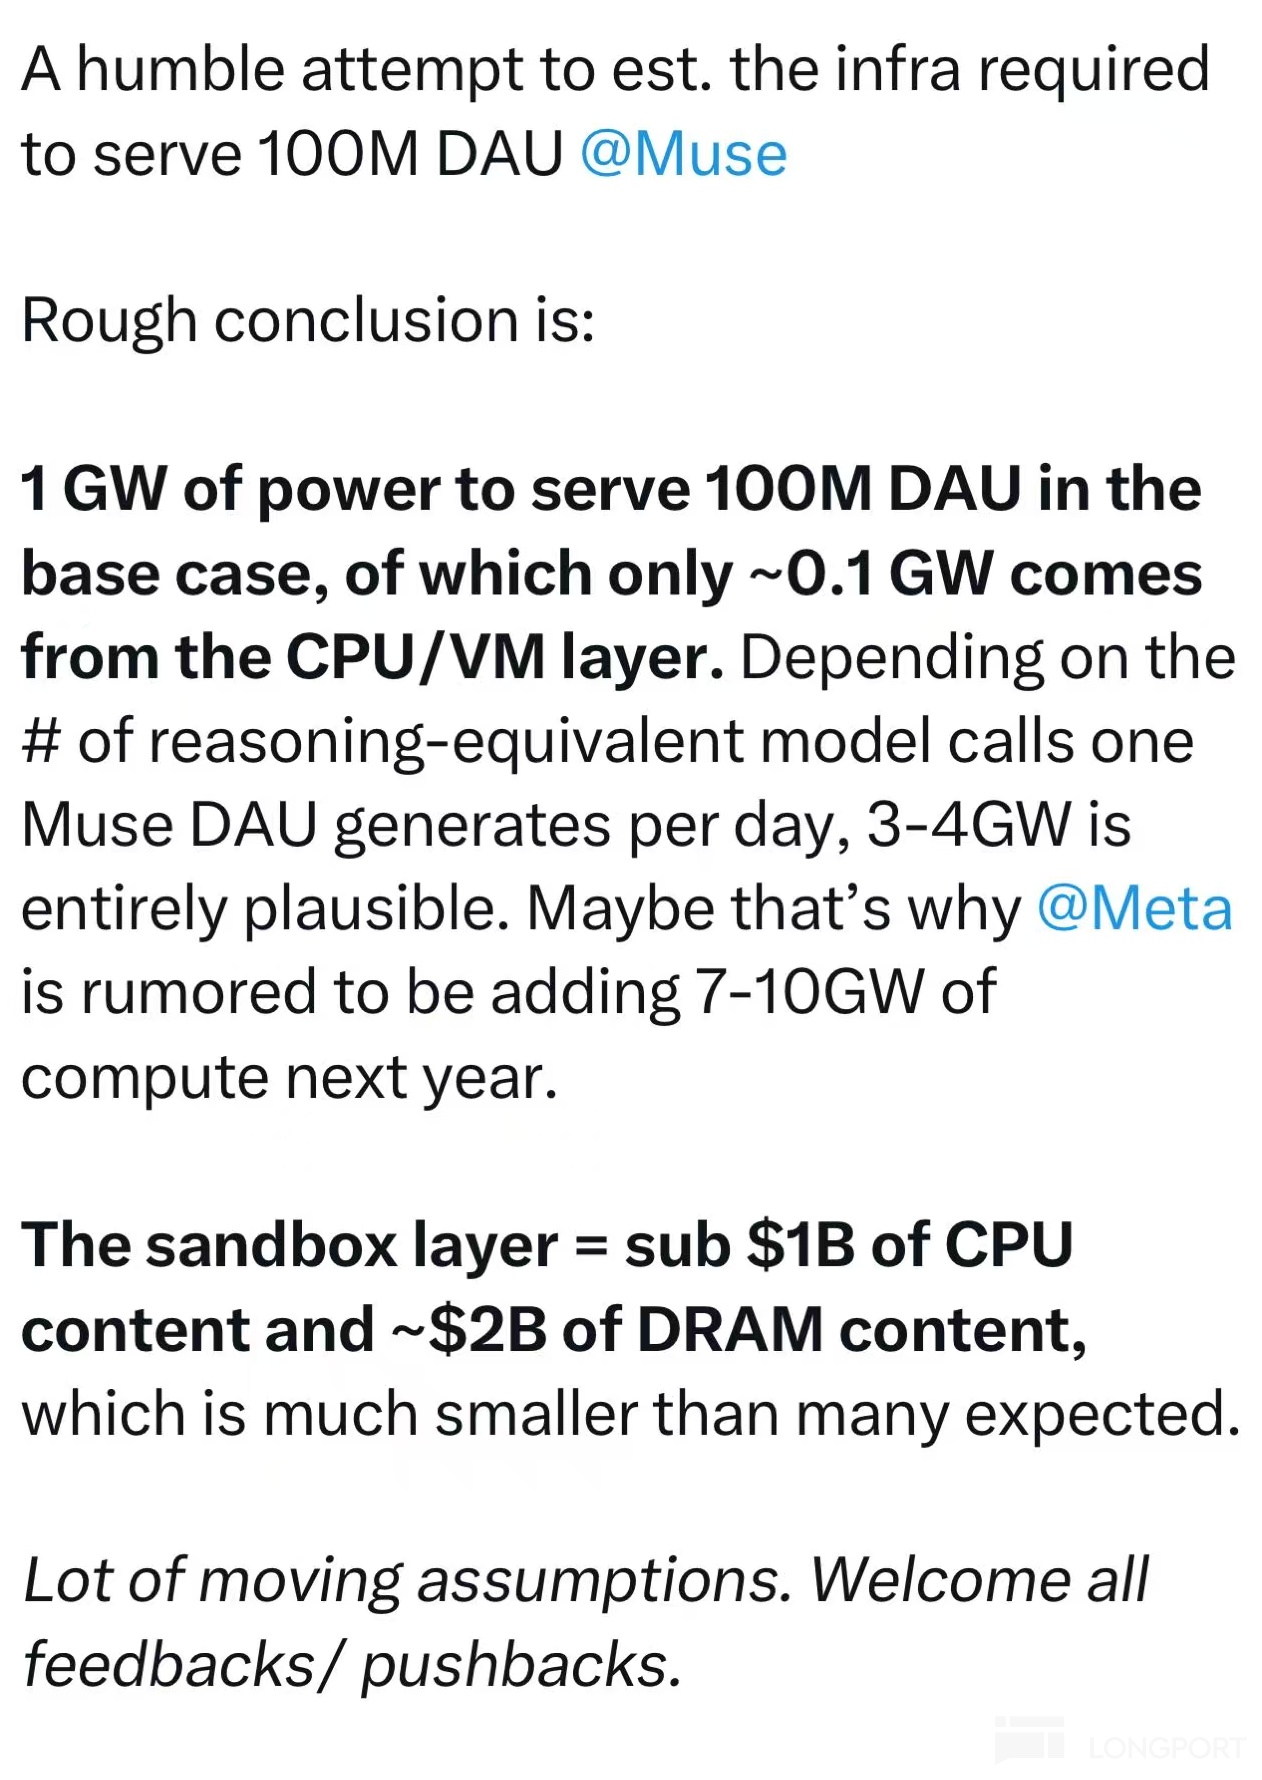
對於 Muse 對 CPU 的帶動,X 上有人提到了不一樣的觀點,先來看看不一樣的聲音:
“基準情形下服務 1 億 DAU 需要 1GW 電力,其中只有約 0.1GW 來自 CPU/VM 層。 取決於每個 Muse DAU 每天產生多少次推理等效模型調用,3 到 4GW 完全説得通。”
1.計算方式對比
首先我們來對比下計算方式:
Freda:“CPU 核數=DAU× (活躍時長/24)×峯均比×冗餘係數×每 live VM 物理核數”;
海豚君:“CPU 核數=(A 頭節點) GPU 出貨量×每 GPU 頭節點核數 + (B 固定層) 總註冊用户 x 日活率 x(活躍時間/24)×每用户 2vCPUx 峯均比÷超售比÷ 2(單核兩線程)+(C 彈性層)活躍用户×任務併發率×每任務沙箱核數”。
可以看出對方的測算中,並沒有測算 A 頭節點(GPU 側)的 CPU 核數。當然這也能理解,這個也不能算 Agent CPU 帶來的增量部分。
關鍵在於 Agent CPU 主要帶來的部分,就是用户側和 Agent 側兩部分,海豚君將其拆分成 B 固定層和 C 彈性層兩塊,而 Freda 的測算並沒有進行拆分,而是直接用一個 live VM 物理核數來給設定。
2.概念的混淆性
Freda 的測算中,關鍵在於 live VM 物理核數的選定,她直接參照了 DSec。
原本提到 “DSec also demonstrates stable operation at around:800 microVMs per node.” 她測算的是,188 物理核/節點÷800microVMs/節點=0.23 物理核心 per live VM。
值得注意的是,DSec當時的設計目標是:當 Agent 需要執行代碼、操作 shell、讀寫文件等工具時,按需創建microVM沙箱來隔離執行。因而這裏的 microVM,實際上並不是用户數,而是沙箱數。之後再把這個數去乘以用户數,來測算整個規模明顯是不對的。
另一方面,Freda 選用的 800 個 microVM 只是演示上限,按生產實測峯值表現為 524 個 micro VM,拿 188 物理核/節點÷524microVMs/節點=0.36 物理核心 per live VM,而不是給出的 0.23。
這兩者只有在 “一個用户在峯值時恰好只持有一個沙箱” 時才相等。而 Muse 顯然不是這樣的,用户 VM 本機沒有瀏覽器,broker 要去租另一台跑瀏覽器鏡像的 VM。光這一條,一個正在瀏覽的 Muse 用户就至少佔兩個沙箱。
這麼看來,Freda 只是測算了 C(彈性層)的部分,並未測算 A 頭節點(GPU 側)和 B 固定層(用户側)的 CPU 核需求。
3. 不合適的參照對象
當然,C(彈性層)本身也是 Agentic AI 需求的主要增長來源,姑且來看這部分:
DSec 和 Muse 本身就是不同的,拿着 DSec 來參照也不太合適。DSec 是 DeepSeek 用來跑代碼執行的沙箱:跑一段代碼、返回結果、銷燬;而 Muse 的沙箱是常駐的個人計算機:帶瀏覽器、帶持久記憶、帶 Chromium 多進程調度、關掉 App 還在跑。
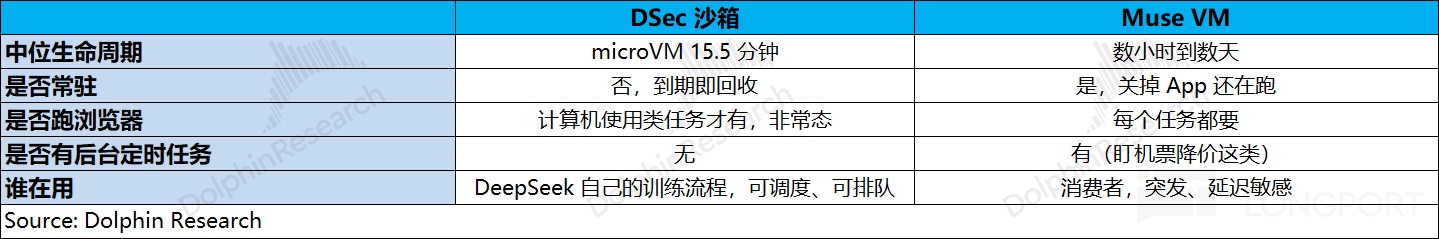
Freda 的整條邏輯建立在 “90% 的沙箱平均只用不超過申請 CPU 的 5%"這個實測上。但這個 5% 是在 DSec 的負載構成下測的,是被大量 “跑腳本、編譯、跑測試” 稀釋出來的均值,不是瀏覽器負載的佔空比。
Muse 是完全不一樣的。一次跨平台比價可能觸發多達 146 次頁面加載,而每次頁面加載都是完整的 HTML 解析 +JavaScript 執行 +DOM 構建 + 渲染。Chromium 的 JS 主線程是單線程且 CPU-bound 的,一個現代商旅頁面的渲染要佔滿一個核好幾秒。
本身單個客户不一定只有 1 個任務,因而海豚君在 C(彈性層)中引入了併發率的概念(情景假設),即對應單個活躍客户的平均任務數(1 個任務對應 1 個併發沙箱),這部分要關注後續 Muse 等 Agent 的使用情況。
對於 C(彈性層)的測算,在 1 億 Muse 用户(日活 30%)、每天活躍 3 小時、峯均比 2 的情況下,假定每個任務沙箱需要的 CPU 核數為 1.5 個(此前的 4 個是參照 NemoClaw 的配額上限),以併發率來做情景假設:其中峯值活躍達到 750 萬(=1 億 x30%x3/24x2)
中性情況對應着併發率=150%(從此前的 100% 上調),即單個活躍客户平均有 1.5 個任務。如果單個 CPU 機架和 GPU 機架均為 200kW ,CPU 機架的佔比下調至在 15% 的情況下(此前假定佔比 25%),對應着 1GW 的配套工廠。
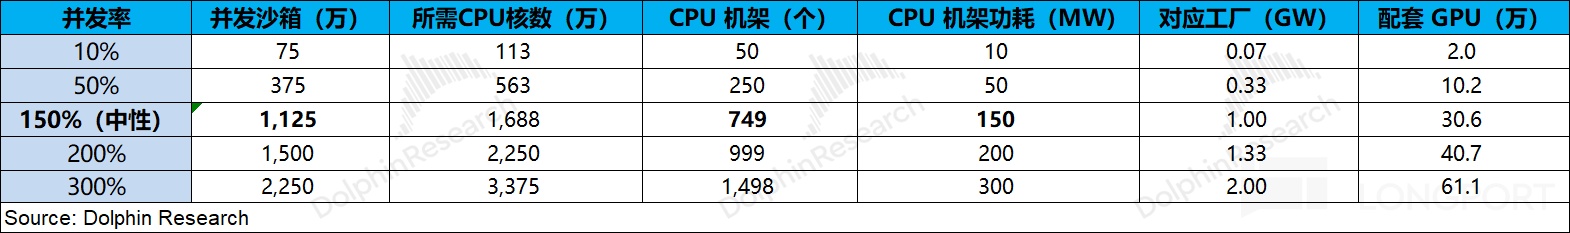
在這情況下,單 GW 對應的 CPU 核需求量=A(GPU 側)1836 萬個(=30.6*60)+B(固定層)188 萬個(=1 億 x30%x3/24x2x2/4/2)+C(彈性層)1688 萬個=3712 萬個,大約是原來純 GPU 機架方案的 2 倍左右(相比於 1836 萬個)。
在調低單個任務沙箱需要的 CPU 核數的情況下,也相應的調低了 CPU 配比情況,對應着 CPU 需求倍數從 3 倍調整至 2 倍,仍遠高於 Freda 的預測。考慮到英偉達存儲機架(DPU)等部分的額外需求,海豚君預估 Agentic CPU 有望帶動 CPU 核數需求仍會達到 2 倍以上。
整體來看,這份 Freda 的測算中混淆了 microVM(任務沙箱)和用户的概念,她的計算中僅僅計算了 C 彈性層的一部分,並且在計算過程中參照的 DSec 和 Muse 的方式本身就有很大的不同,這樣的參考是明顯不合適的。
<此處結束>
2026/09/29 CPU 熱評《Muse“爆火”,CPU 迎來自己的 ChatGPT 時刻?》
本文的風險披露與聲明:海豚研究免責聲明及一般披露
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。