

從綠葉到鮮花,AI 推理如何為 NAND“逆天改命”?
 我是 LongbridgeAI,我可以總結文章信息。
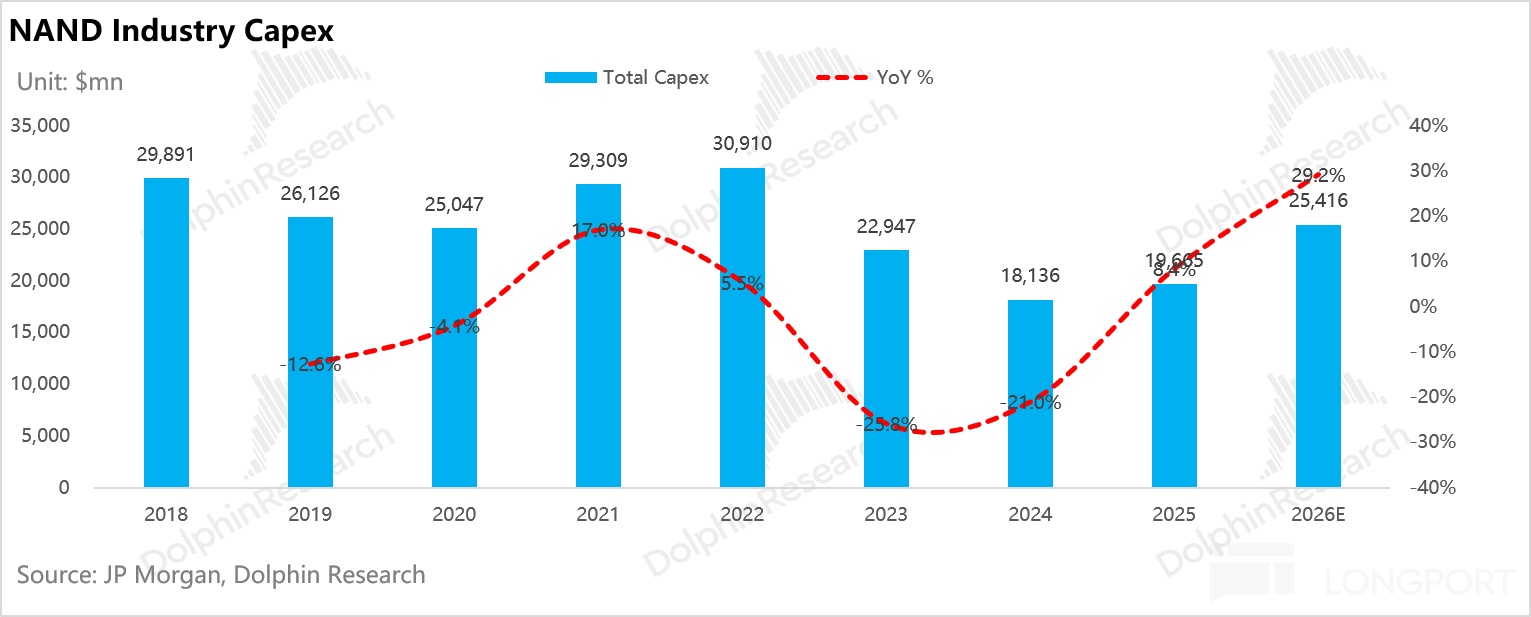
NAND 是一個被“技術詛咒”的行業:正如海豚君在前篇《NAND天性 “多產”,閃迪憑什麼守 80% 毛利率?》中所説,AI 爆發前的 NAND 就是典型的大宗生意——產能由市場無情出清,技術領先換不來溢價,只能“虧得比別人少”,銷量增長的紅利被降價全部吞噬。
根源在供給端太多產:靠單一晶圓上向上堆疊、橫向縮孔,從 BiCS5 到 BiCS11 五代,閃迪每片晶圓的 bit 產出每代增加 54%,年化複合約 27%。
也就是説,哪怕一分錢擴產(CapEx)不花,bit 產能每年也會自動膨脹近三成。3D 轉型期更是一次性猛增,供給一度遠超需求,這讓“輕資產”NAND 生意在下行週期比“重資產”DRAM 更慘烈。
而 AI 的爆發,正在重寫 NAND 的劇本。本篇報告中,海豚君重點關注AI 浪潮究竟給 NAND 下游需求帶來了怎樣的結構性重塑?
正文如下:
1. AI 浪潮究竟給 NAND 下游需求帶來了怎樣的結構性重塑?
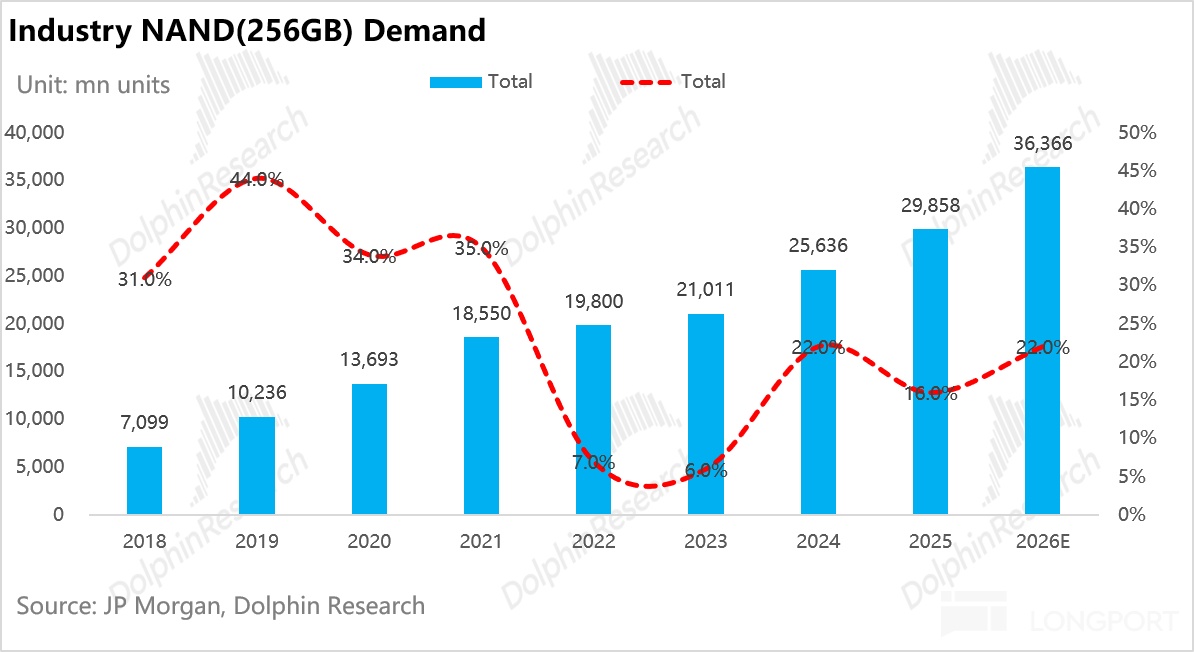
AI之前的消費電子週期中,“話事”需求場景——手機、PC、傳統服務器等核心下游增長平穩可預期,缺乏爆發變量,所以週期的大起大落,實質由供給端的無序擴產與急劇收縮主導。
需求增長來自三大動能:單機容量升級、新興市場滲透,以及固態硬盤(SSD)對機械硬盤(HDD)的存量替代,緩步而穩定。
穩定的需求,配上剛性提升供給,導致NAND 屬性被困在經典的“硅週期”中:供過於求、價格暴跌 → 原廠減產,低價同時刺激單機容量升級 → 供需再平衡、價格回升 → 原廠在高利潤下追高擴產 → 再次陷入產能過剩。
只要 NAND 擺脱不了“外圍零件”的定位,這個死循環就打不破。唯一出路,是出現一個不太看價格、且與 GPU 算力部署直接綁定的新場景——這正是後來 AI 浪潮所扮演的破局者角色。
第二階段(2025 年之後):AI 推理驅動的結構性爆發
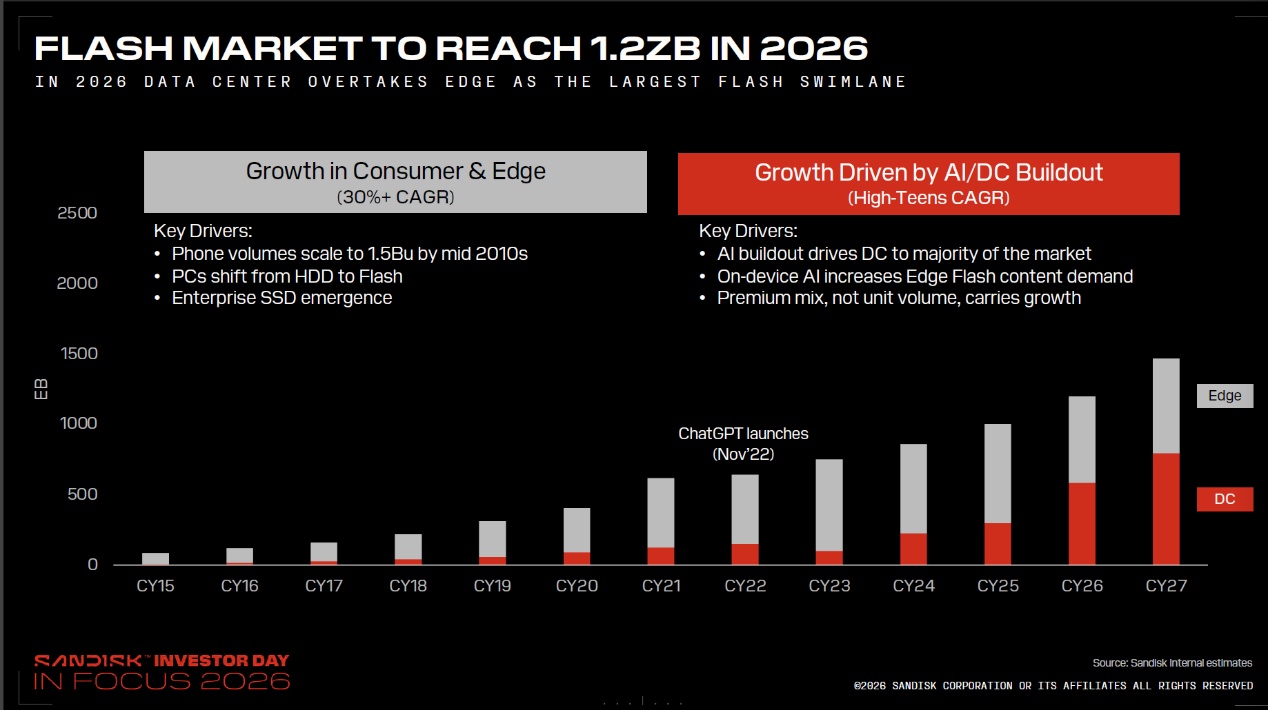
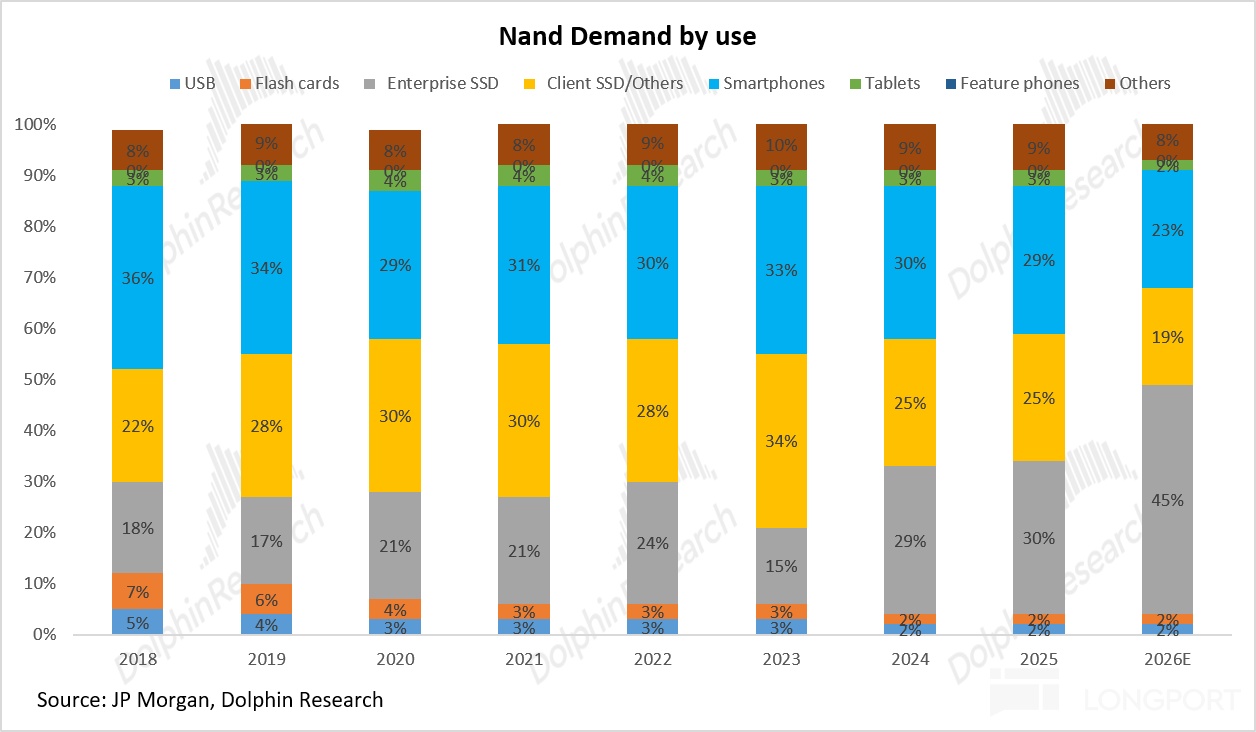
2026 年是 NAND 歷史上最具標誌性的分水嶺:數據中心佔 NAND 總需求的比重,從 2025 年約 30% 躍升至 2026 年約 45%,歷史性反超智能手機(同期收縮至約 23%),成為最大終端基本盤。
驅動 NAND 需求的主角,從對價格高度敏感、庫存大起大落的消費電子,換成了以 TCO(總擁有成本)和算力回報(ROI)做決策、對價格脱敏的雲服務商。
雲廠商關心的不再是“這季度顆粒夠不夠便宜”,而是“能否按時拿到足額的高性能 eSSD,保證未來三年 GPU 基建不掉鏈子”。從“短期壓價”轉向“長期保供”,正是原廠推行 NBM(新型長協模式)的需求側基石。
伴隨基本盤切換,AI 重心“由訓轉推”,更讓 NAND 的角色質變:
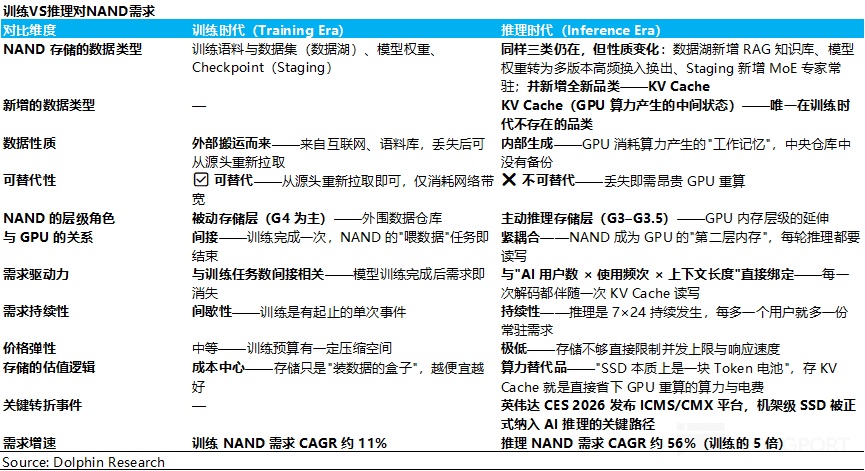
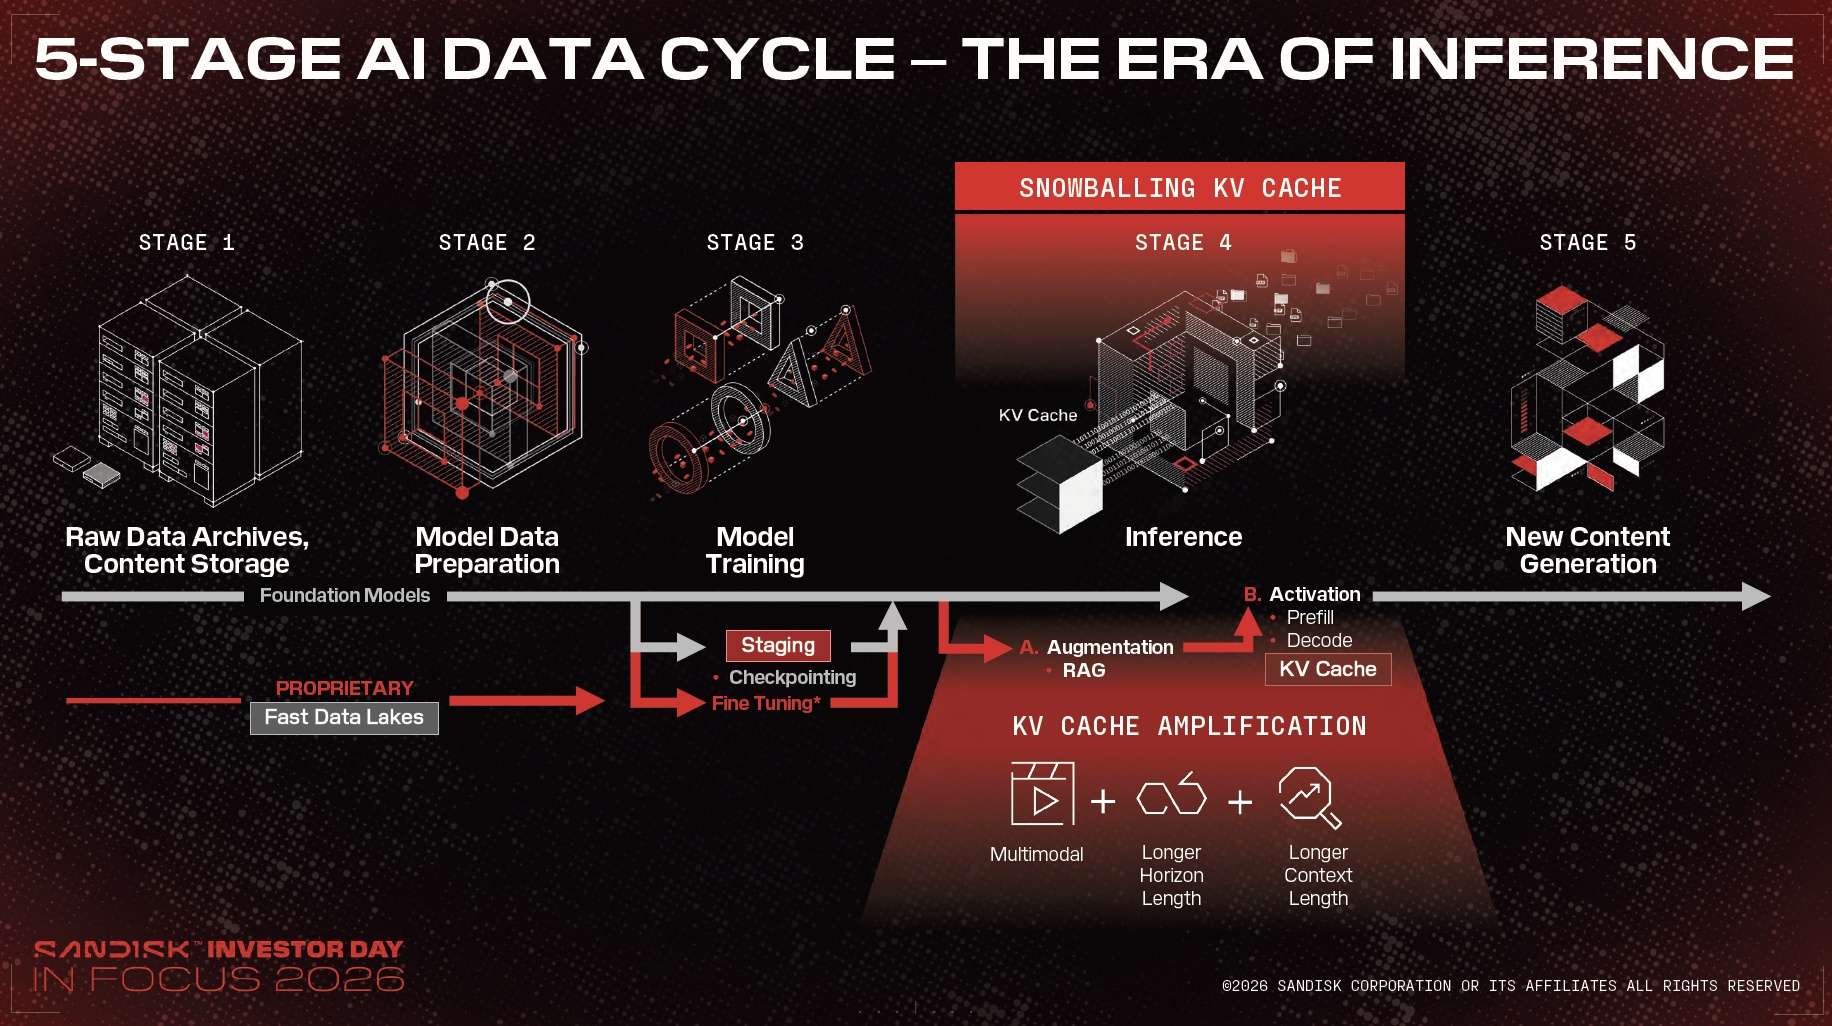
AI早期,NAND 只是外圍的“數據倉庫”:把訓練語料、模型權重、防宕機的 Checkpoint(存檔)等靜態數據,放在 GPU 能快速調取的近端。這些數據可替代性極強——丟了從數據湖重新下載即可,只花帶寬和極少電費,不必動用昂貴 GPU 重算。
但推理時代,計算變成高併發、持續性的“動態消耗”——存儲需求與“AI 用户數 × 使用頻次 × 上下文長度”強綁定。更關鍵的是,NAND 首次存儲“計算的中間產物”。
長文本推理產生的龐大 KV Cache 不是外部搬來的靜態數據,是 GPU 大量消耗算力後生成的“工作記憶”。它一旦丟失,中央倉庫沒有備份,只能再花昂貴的 GPU 算力和電費重算。
存儲的價值第一次可以直接折算成“算力與電費”。正如閃迪所説——SSD 本質上已經進化為一塊“Token 電池”:Token 是已經做過的功,與其丟棄重算,不如“充”入硬盤;存 KV Cache 就是幫雲廠商省電、省算力。
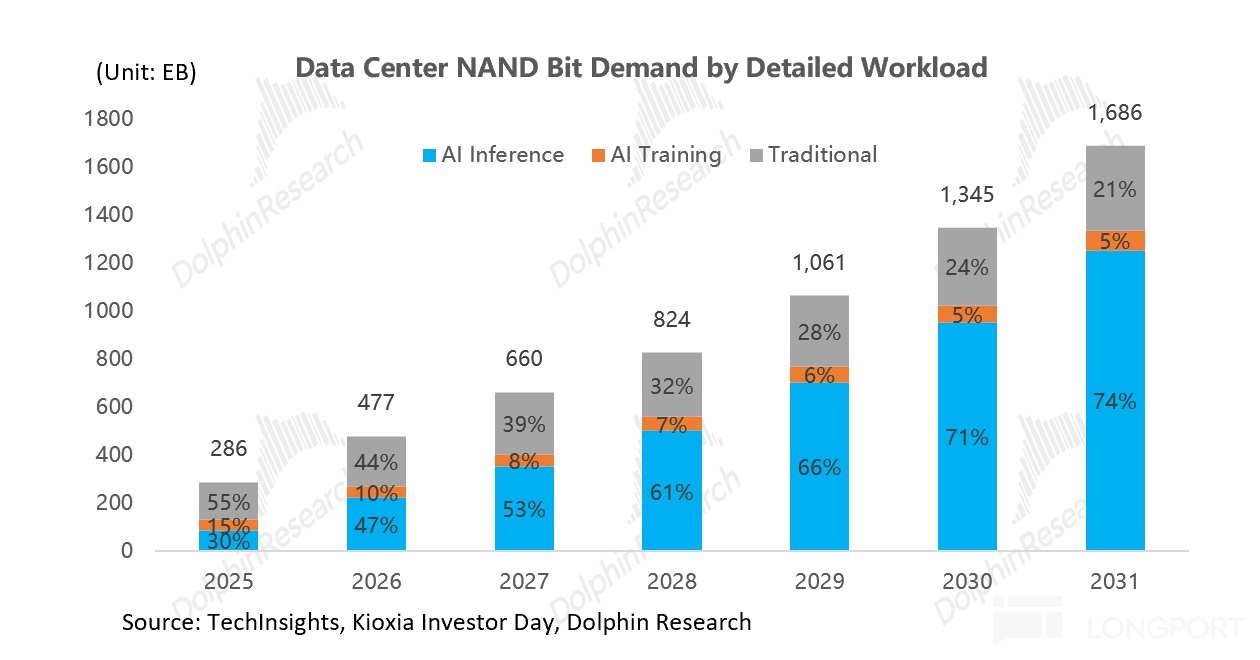
鎧俠的預測也印證了這一趨勢:數據中心 NAND 總需求將從 2025 年的 286 EB 增至 2031 年的 1,686 EB(CAGR 34%),且內部結構極度分化:
AI 推理: 從 2025 年的 86 EB 激增至 2031 年的 1,251 EB,CAGR 高達 56%;佔數據中心 NAND 需求的比例也從 30% 攀升至 74%。
AI 訓練與傳統負載: 同期 AI 訓練的 CAGR 僅 11%,傳統雲工作負載(以 CPU 為主)僅 14%。
推理需求的增速是訓練的 5 倍——本輪 NAND 超級行情,將主要由推理需求的爆發主導。
先看 NAND 在 AI 數據中心的主要應用:
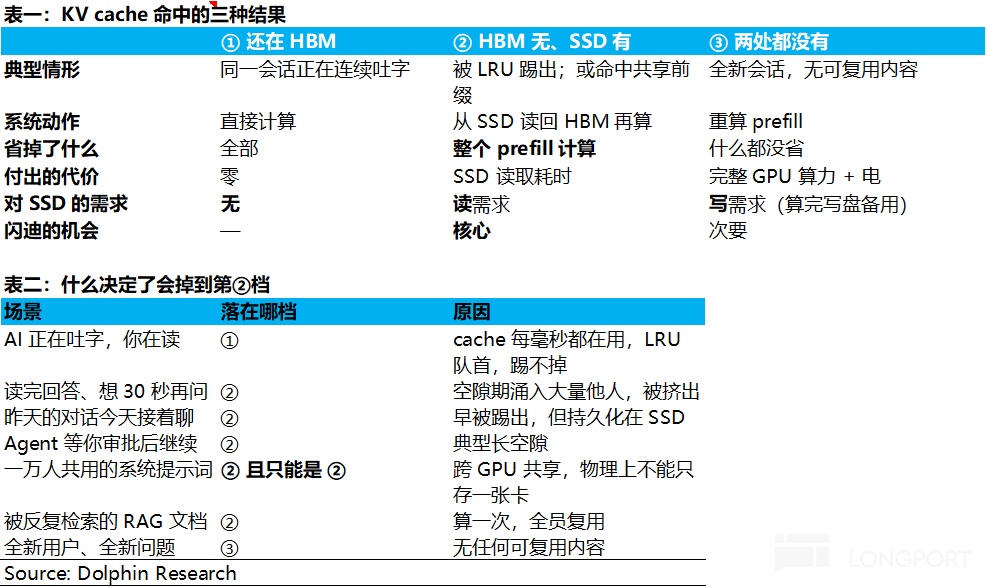
① KV Cache 卸載——NAND成GPU 的上下文存儲層
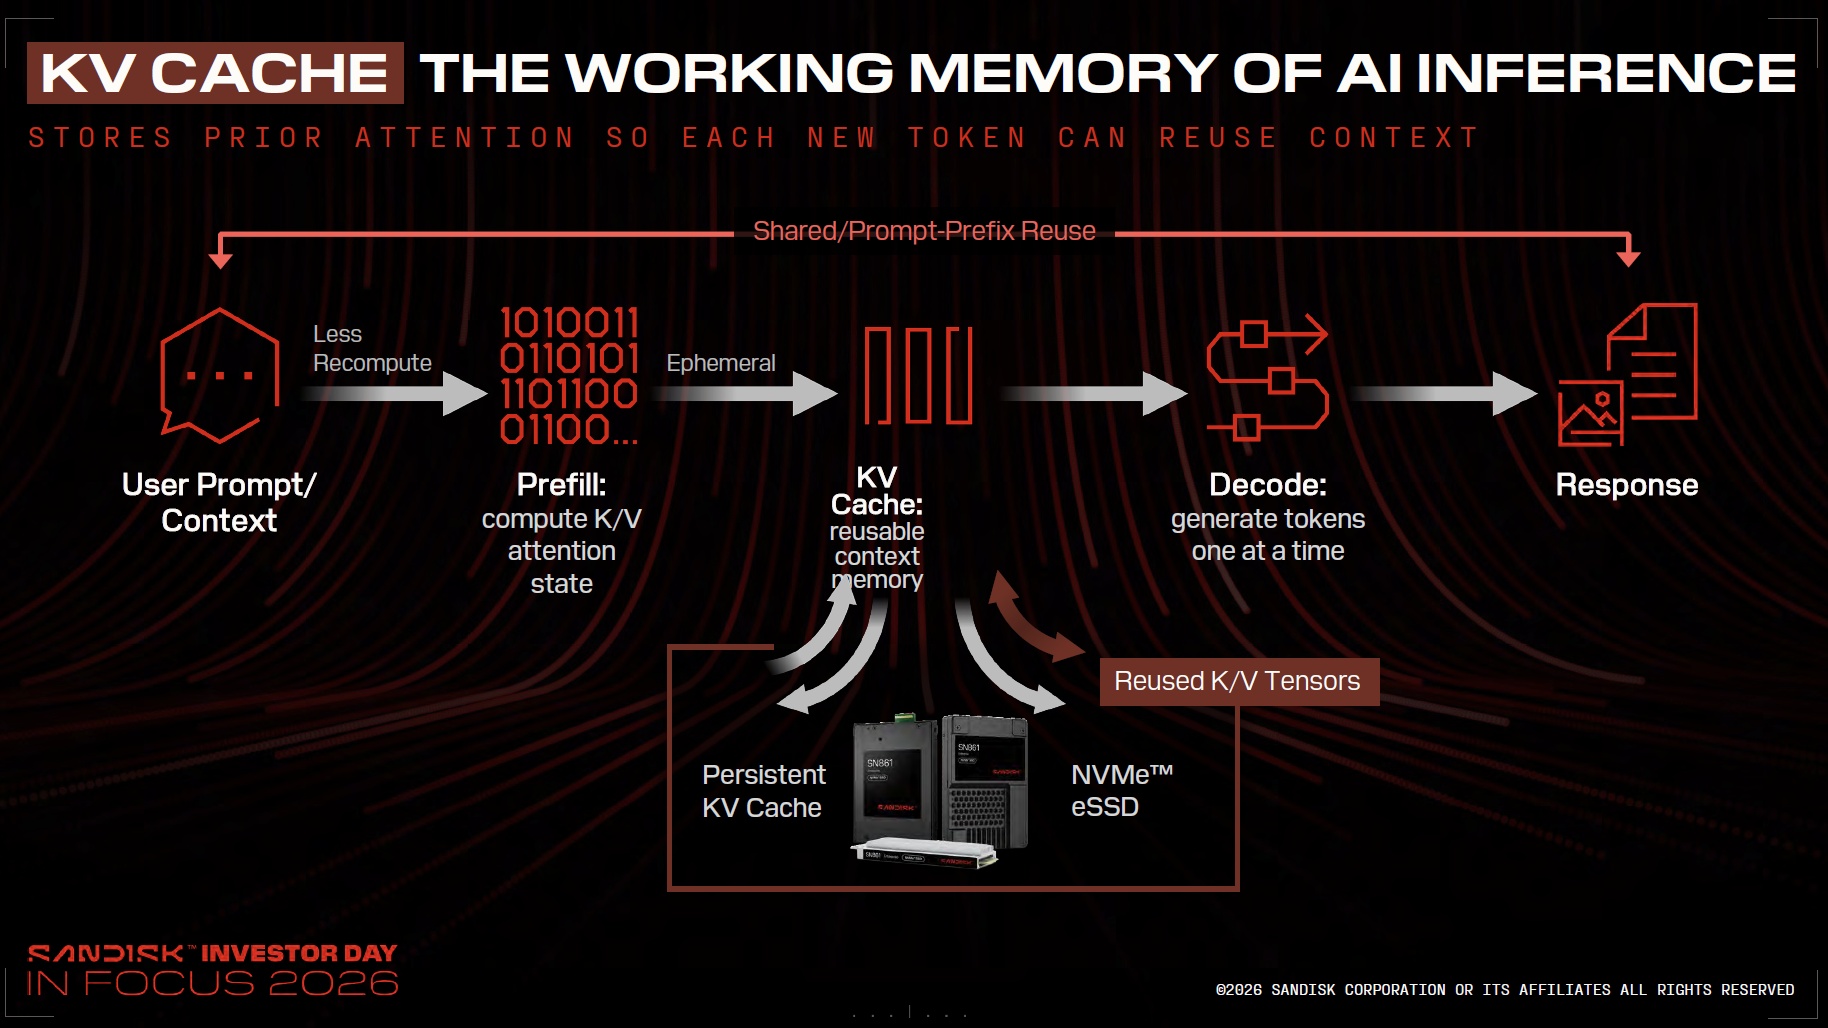
AI 推理時,GPU 必須為每個 Token 實時計算並維護 KV Cache(模型的“工作記憶”)。但早期架構中它是“算完即棄”的消耗品:一輪對話結束,或 GPU 要騰顯存服務下一個用户,HBM 裏的 KV Cache 就被清空。
於是用户一旦追問,或多人併發調用同一份超長文檔,系統只能把上下文重新餵給 GPU,從頭做一次昂貴的 Prefill(預填充)。
Prefill 是推理第一步:GPU 一口氣通讀全部輸入、算清 Token 間的關聯(Attention 機制),再生成一遍 KV Cache——這是整個推理中最吃算力、最費電的環節。
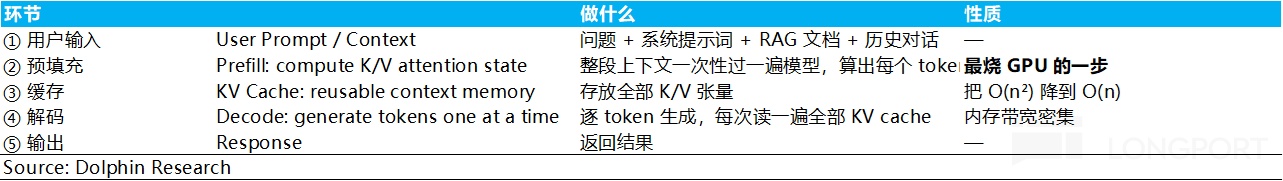
過去“用了就丟”,是因為兩筆賬算不過來:
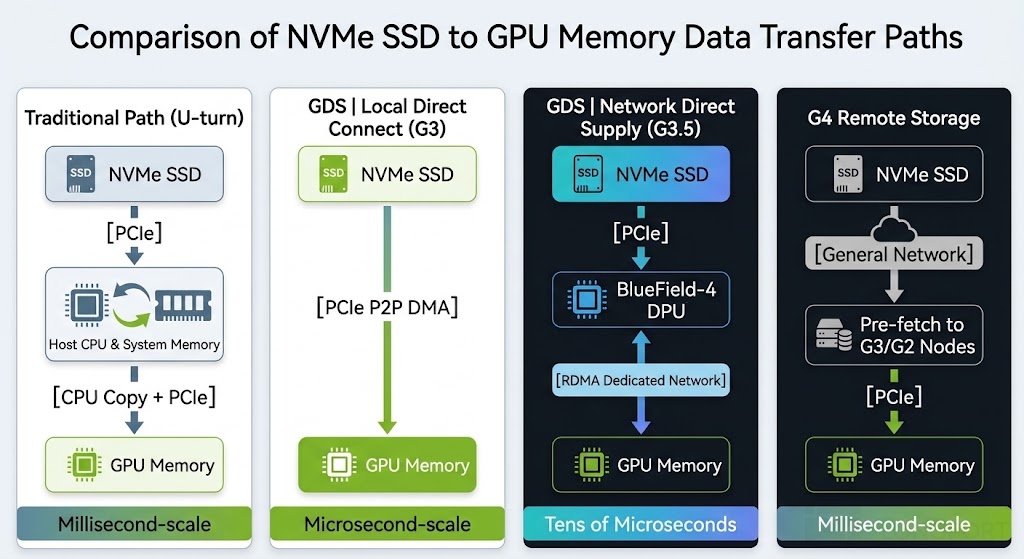
a. 重算比存起來更便宜: 早期(如 GPT-3 時代)上下文只有 2K Tokens,KV Cache 很小,GPU 零點幾秒就能重算完;而存進硬盤要經 CPU 和內存中轉、在 PCIe 上“折返跑”,來回耗時甚至超過重算。
b. HBM 又小又貴:GPU 自帶顯存“寸土寸金”,必須留給當前活躍的計算任務,不可能長期保管已下線用户歷史記憶。
但長文本時代推翻了這筆賬:從 2020 年 GPT-3 的 2K Token 到 2026 年主流模型的百萬級上下文,六年暴漲 500 倍。重算一次百萬 Token 的 KV Cache,要讓昂貴的 GPU 滿載跑好幾秒,有算力與電費代價。
這直接促成 KV Cache 的“再定性”:英偉達 ICMS(推理上下文內存存儲)架構,正式把它從“算完即棄的臨時緩存”改定義為“AI 原生持久數據”。
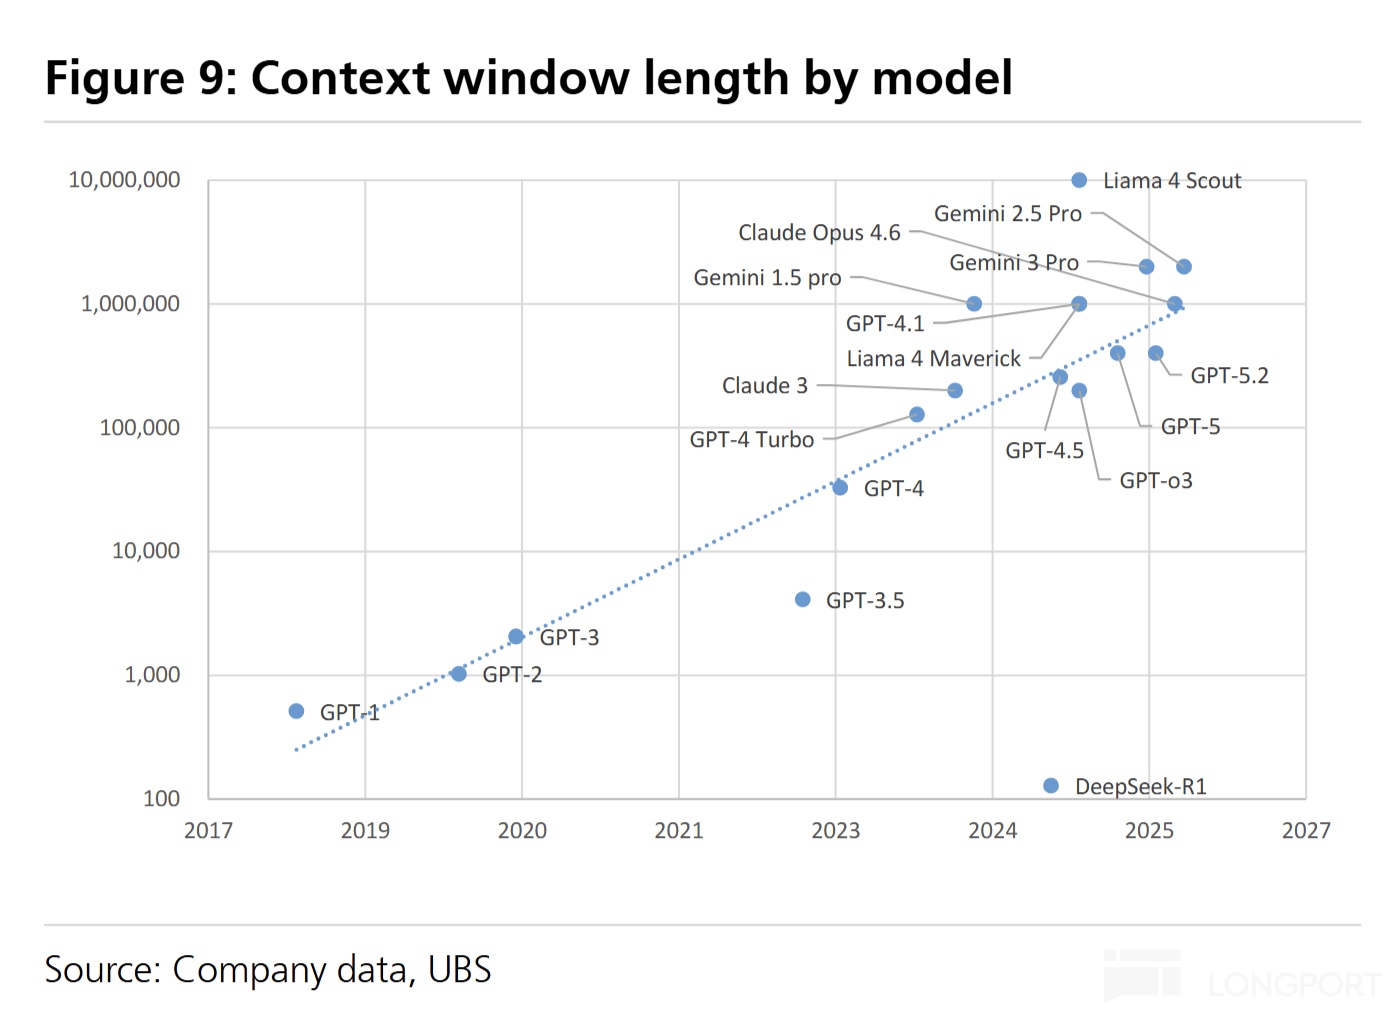
現在,臨時緩存變長久緩存,這個賬是否算得過來?
a. 容量約束: 算法壓縮也趕不上KV Cache膨脹速度
第一個條件,是 HBM 的擴容速度遠追不上 KV Cache 的膨脹。
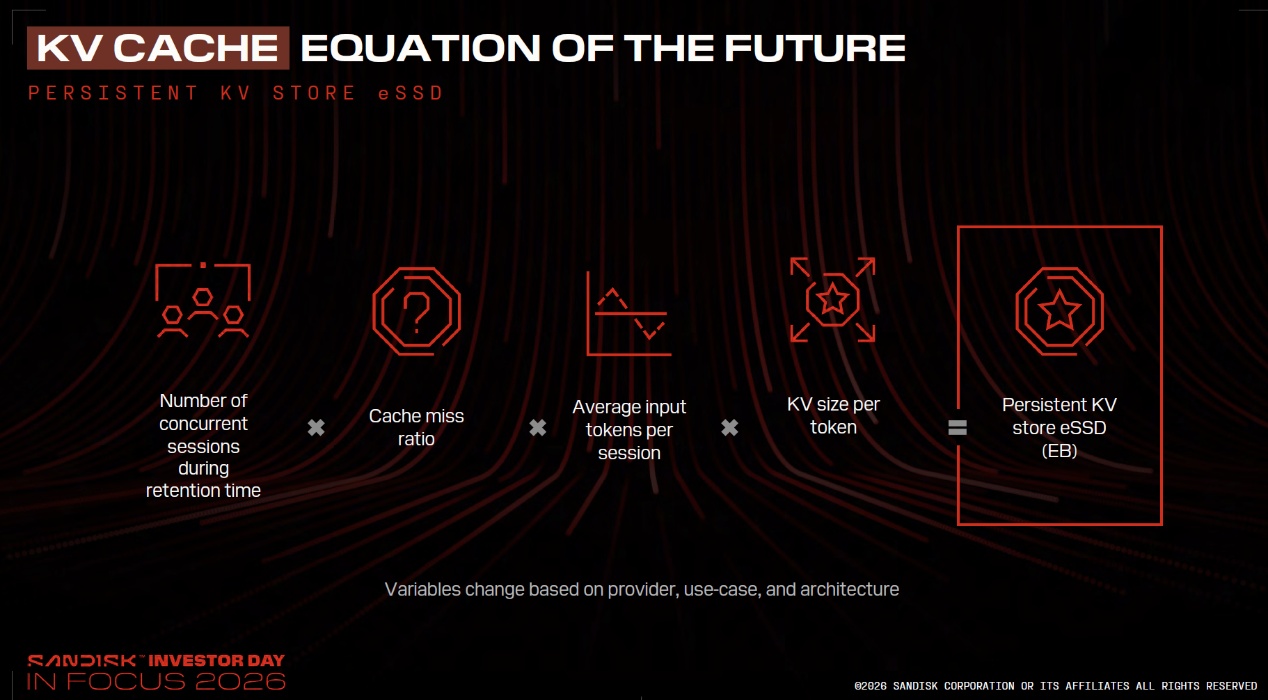
KV Cache 總量 = 上下文長度 × 併發會話數 × 單 Token 存儲量。目前,前兩個變量都在被急劇放大:
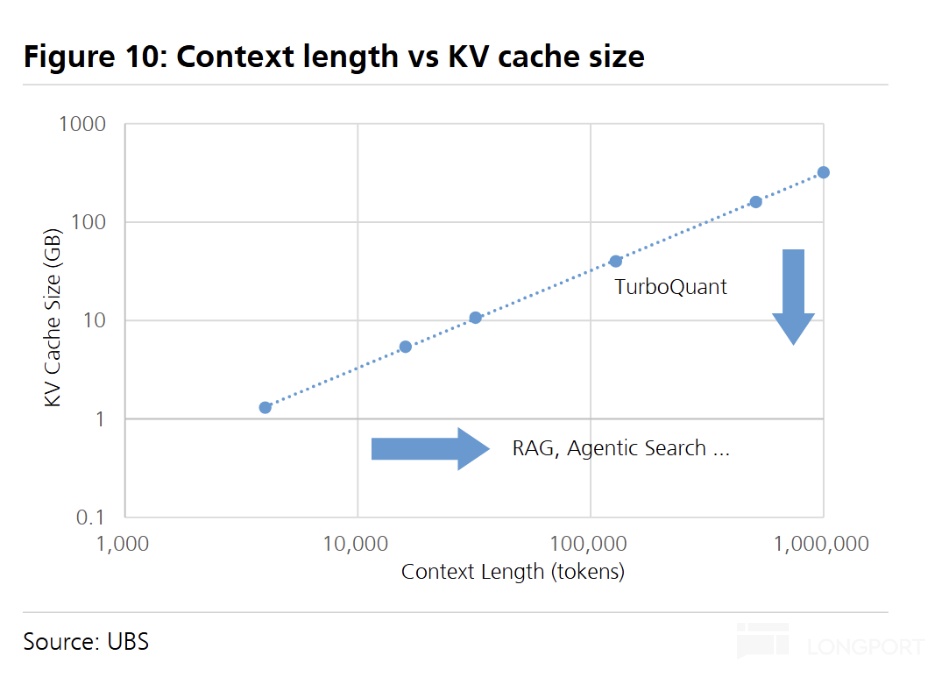
上下文長度每年翻倍以上:主流模型從 4K、128K 快速演進到 1M+,KV Cache 隨之線性放大。
併發與推理輪次爆發——正被三種應用架構急劇放大:
a. RAG(檢索增強生成): 問一句話,後台塞進兩本書。系統把檢索到的大量文檔拼接到輸入端,送進 GPU 的 Token 遠超原始提問,單次任務的 KV Cache 直接拉爆。
b. Agentic Search: AI 從“一問一答”變成自主循環的“規劃—調用—評估—再檢索”。多步任務把單次 Token 消耗從數百個拉到上百萬個。
c. Multi-Agent: 多個 Agent 併發協作,每個獨立生成 KV Cache,存儲需求隨數量成倍疊加。
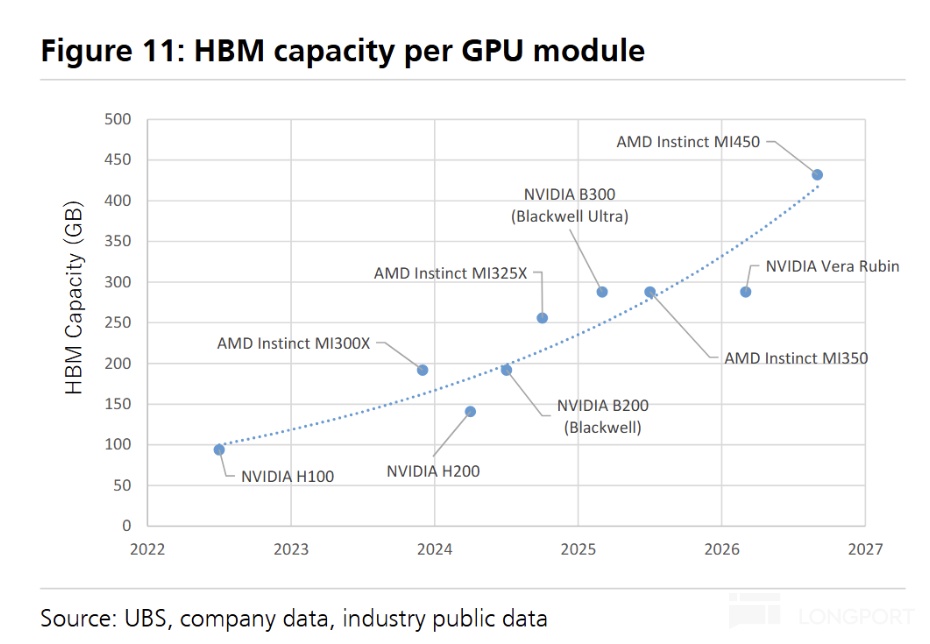
模型廠商每年至少把上下文擴大一倍,HBM 的物理擴容卻接近極限:單卡容量約 2-3 年才翻一倍,紅利還在放緩。
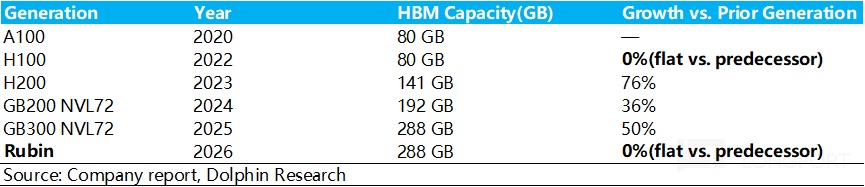
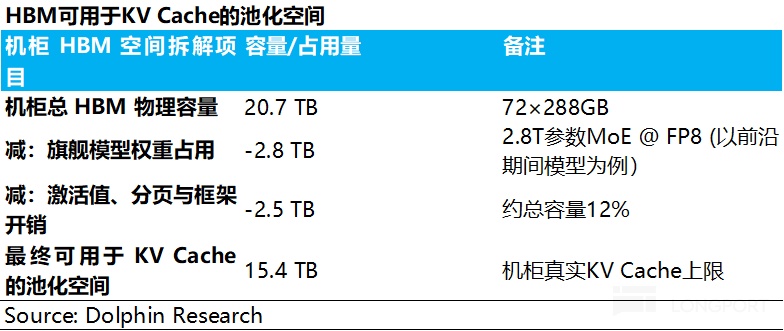
判斷 KV Cache 會不會溢出,要以單個推理機櫃的可用 HBM 池為單位。以 Rubin NVL72 的21T的HBM容量為例:
部署 2.8T 參數的旗艦 MoE 模型,FP8 下權重佔約 2.8 TB;再扣掉激活值、分頁與框架開銷(約佔 12%,約 2.5 TB),真正能給 KV Cache 的池化空間上限約 15.4 TB。
不壓縮時,10 萬 Token 約佔 40 GB。即便用最前沿的壓縮算法(如谷歌 TurboQuant,16 位壓到 3 位、約 5–6 倍無損壓縮),100 萬 Token 仍要佔 67–80 GB。
也就是説,一台造價約 500 萬美元的機櫃,極限只能同時服務 193–230 個百萬 Token 級長度得會話。對企業級雲服務而言,這意味着極低的算力變現效率(ROI)。
一旦上下文擴到 500 萬 Token,或併發突破這一閾值,機櫃級 HBM 池會迅速觸頂。因此把 KV Cache 從 HBM 逐級卸載到 DRAM 再到 NAND,往後看是一場必然之路。
b. 便宜,也是致命吸引力
哪怕 HBM 容量勉強夠用,用它長期留存 KV Cache 在經濟上也不成立:HBM4 約 16 美元/GB,eSSD 約 0.3-0.4 美元/GB,前者是後者的 40-50 倍。用它去放幾小時都不調一次的“温/冷 KV Cache”,是極度的資源錯配。
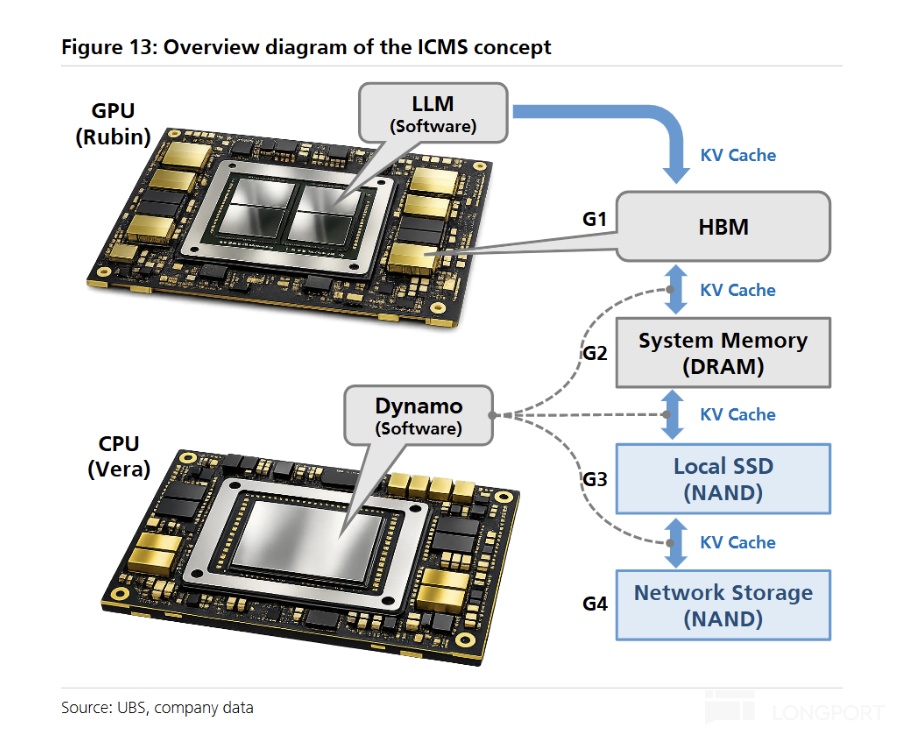
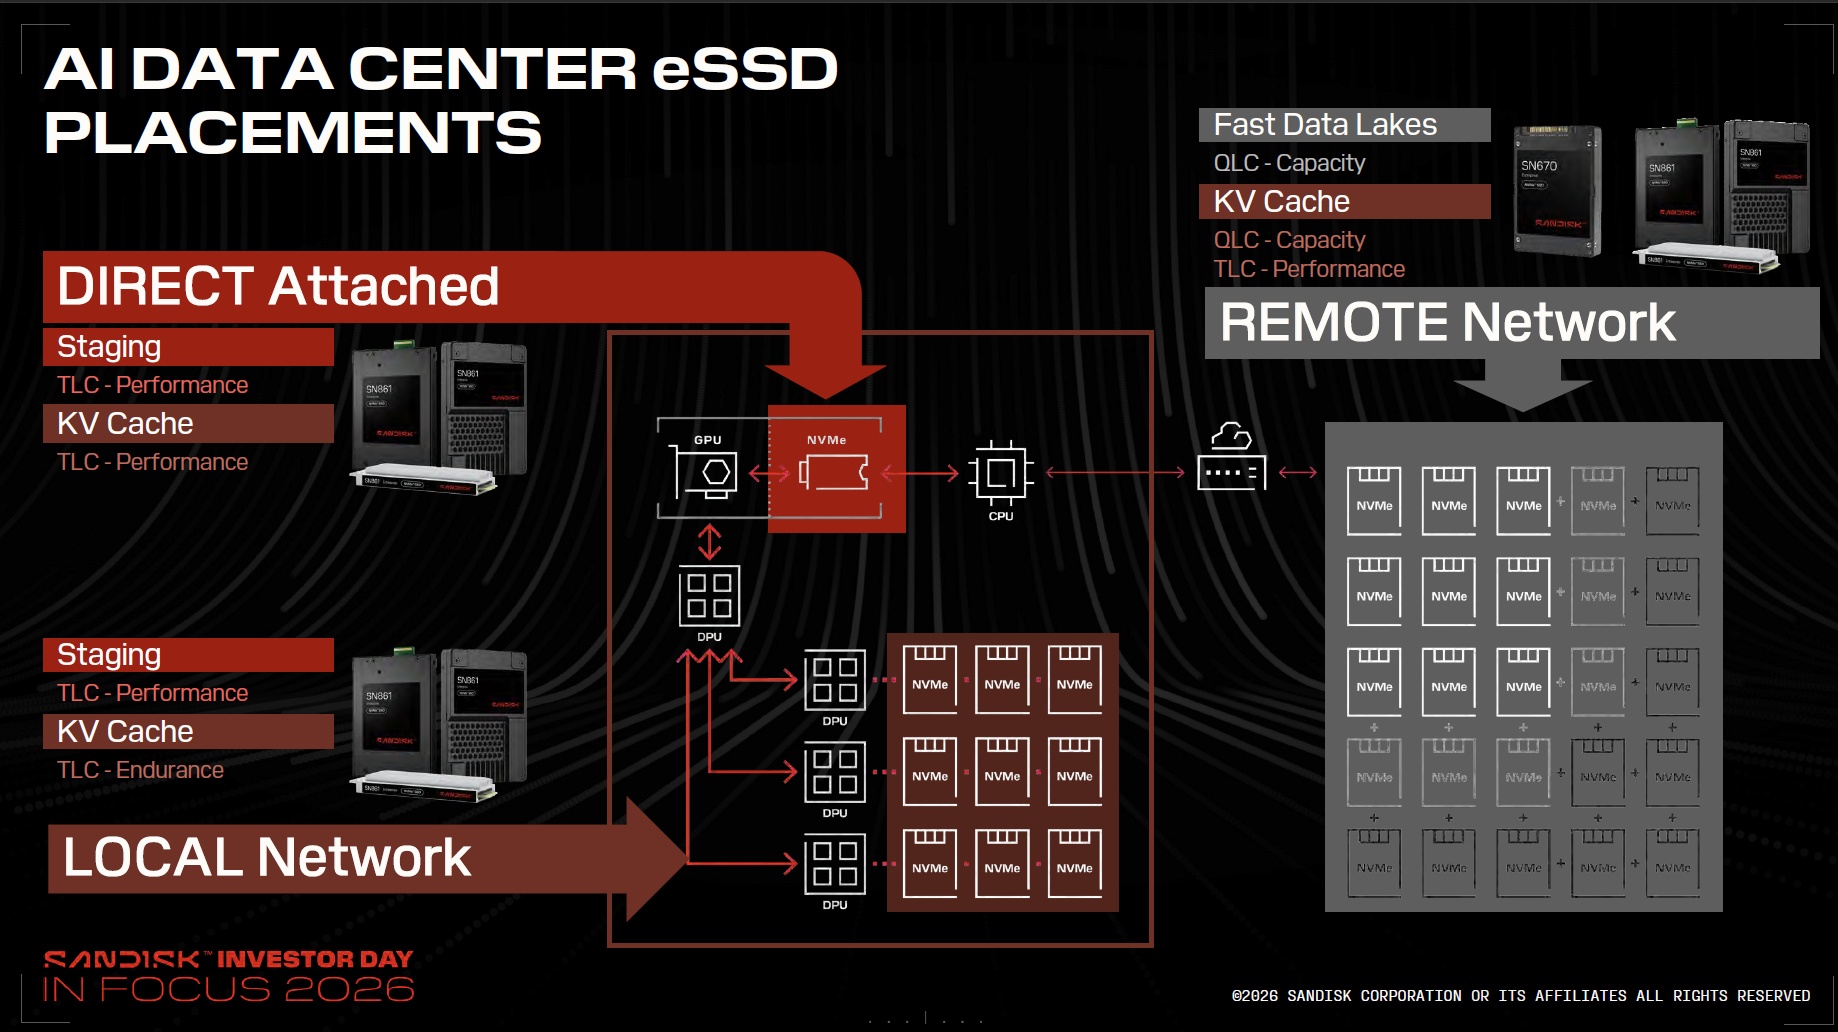
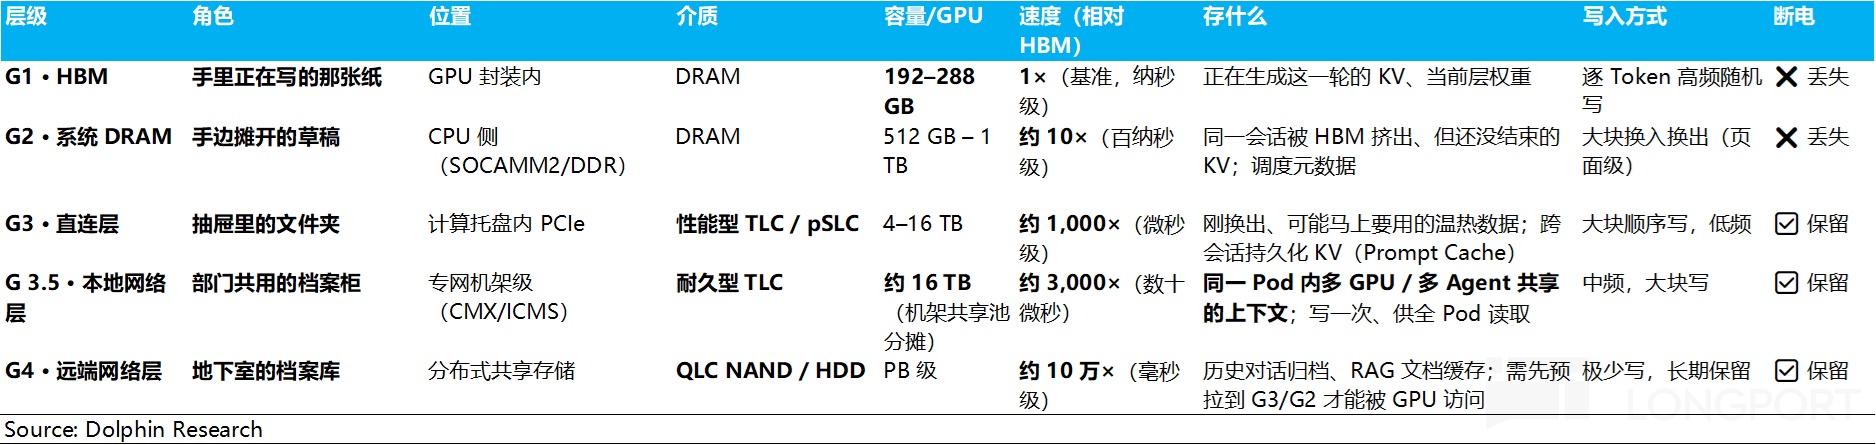
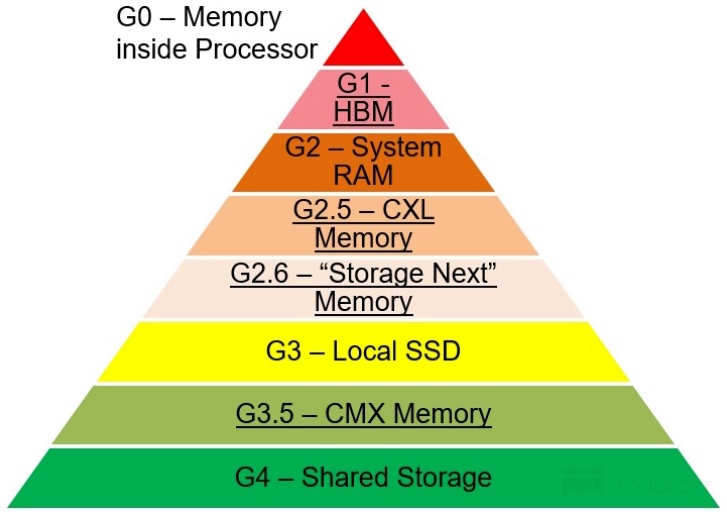
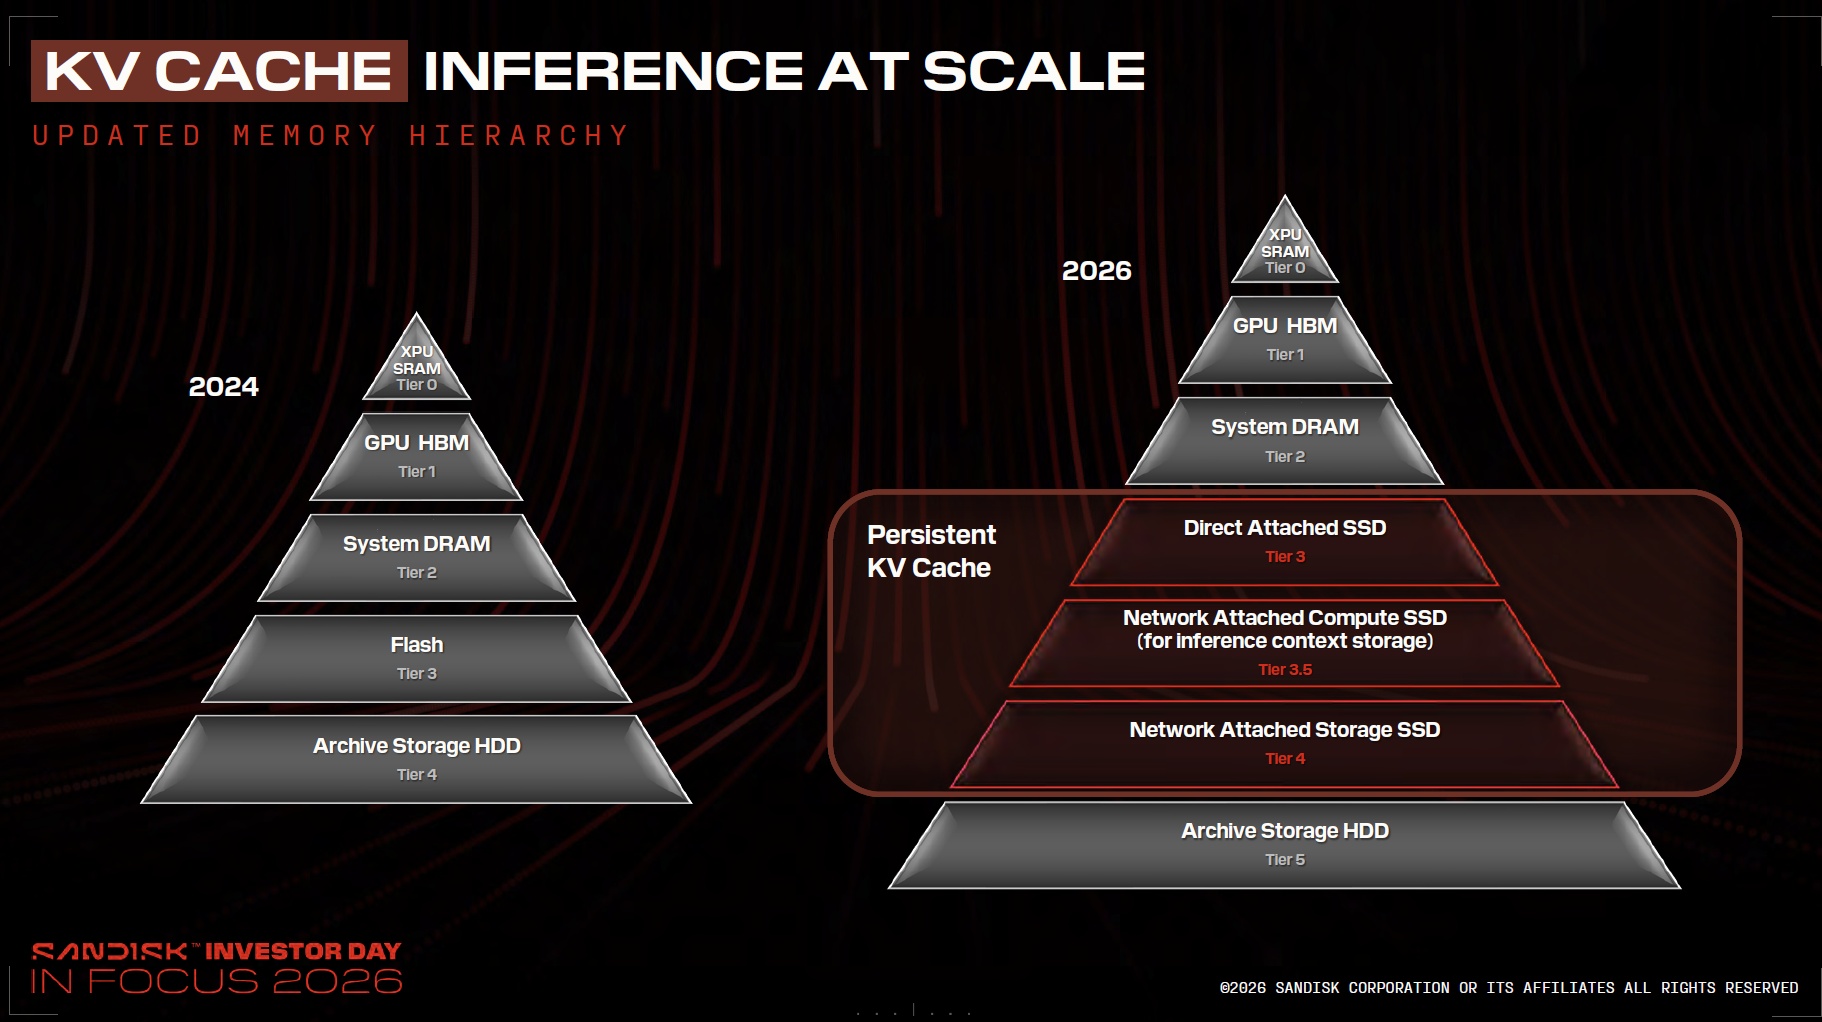
為此英偉達確立了新的分層內存架構:G1 HBM → G2 系統 DRAM → G3 本地 SSD(NAND)→ G4 共享網絡存儲(NAND/HDD),由 NVIDIA Dynamo 在軟件層統籌,讓 KV Cache 在各層間透明遷移。
英偉達估計,大規模多智能體推理下每個 GPU 模組最高需要 16 TB 的 KV Cache,因此在 Rubin 平台構建了 ICMS/CMX 上下文存儲層,位於 G3 本地 SSD 與 G4 共享存儲之間,定義為 G3.5 層——因為 G3 容量有限、不能跨節點共享,撐不住多智能體的大規模複用。
CMX 單層容量約 16TB,是單卡 288GB HBM 的近 60 倍——NAND夠便宜,才能做到量大不貴。
c. 改用NAND,時延上來得及嗎?
卸載值不值得,最終看 TTFT(首 Token 時延)——只有“從 SSD 讀回來”的時間和成本低於“用 GPU 重新算一遍”,卸載在商業上才成立。
GPU Direct Storage(GDS)是跨越門檻的關鍵:它繞過 CPU 和 DRAM,通過 PCIe/RDMA 在 eSSD 與 GPU 的顯存之間修一條直連高速路。
據公開驗證,GDS 結合壓縮技術可把 KV Cache 的恢復時延改善 10 倍,讓超低時延的上下文交付在工程上成為現實。
NAND存儲KV Cache的數據類型:“共享型記憶”和高頻複用
即使跨過容量與成本的門檻,KV Cache 要卸載到 NAND裏,還需滿足兩個條件:
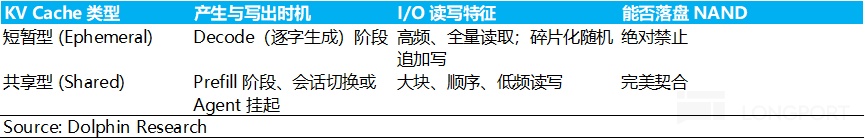
條件一:必須是共享型緩存
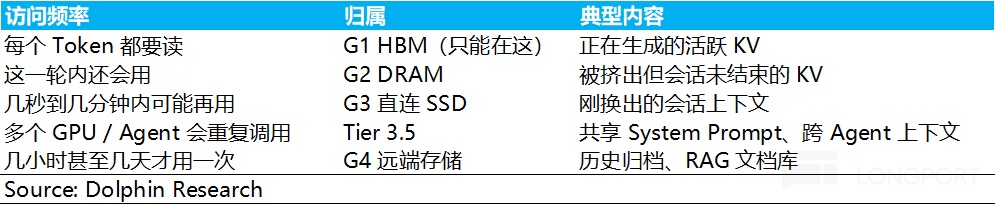
a. 短暫型緩存(逐字生成的草稿):HBM承載
AI 逐字回答(Decode 階段)時,每吐一個字都要全量重讀歷史上下文。此時強行寫 SSD,一是帶寬不夠、會卡死 AI“説話”的節奏(速度牆),二是高頻碎片化追加寫幾周就能耗盡企業級硬盤的壽命(壽命牆)。所以這類草稿禁止落盤,必須留在 HBM 顯存中。
b. 共享型緩存(靜態打包案卷):NAND來存
只有當 AI 剛讀完超長提示詞(Prefill 階段)、用户切出對話或 Agent 掛起任務時,產生的才是算完、可整段打包寫出的完整上下文。它“塊大、順序、低頻”,像整箱搬運定稿檔案,與 NAND 大塊連續讀寫完美契合,這類數據才可以NAND層。
條件二:高頻複用才能“值回票價”
除了可用,經濟也要可行:卸載淨收益 = 複用次數 × (重算算力成本 − 讀回成本) − (寫入成本 + 佔位存儲成本)
GPU 重算既費電又費算力,已算好的緩存從 SSD 讀回,只要被複用 1 到 2 次就能盈虧平衡。挑戰在於硬盤空間同樣稀缺,只有高頻複用的上下文,才值這個存儲佔位。
這最終濃縮為一個核心指標——緩存命中率:命中率越高,邊際服務成本越趨近於零。新請求進來時,系統通過“前綴比對”去硬盤取回備份,跳過最燒錢的 Prefill 重算。
正如 Manus 團隊指出的:命中緩存的 Token 比未命中的便宜約 10 倍。普通大模型命中率在 40%–70%(MiniMax 71%、Z.ai GLM5 約 40%),多步執行的 Agent 場景則長期企穩在 95% 以上(DeepSeek 實測 98.7%),實現“寫一次、讀上千次”的紅利。
實際使用中,對話變長或 GPU 換用户都會產生中斷,當前 KV Cache 就可讓出HBM空間。如果這些會話還會被再次調用就可存到 NAND中,服務恢復時再載入。
典型卸載場景包括:用户閲讀停頓、跨週期歷史回溯、Agent 掛起的長空隙、超大規模併發共享,以及企業級知識庫調用。
KV Cache 分層: AI 推理對存儲拉動不是單點,而是從高性能閃存(pSLC/TLC)到海量温冷存儲(QLC),連同 DRAM 與 HBM,把整條企業級存儲產品線一起拉起來。
這條通路上,各類存儲分工明確:
DRAM(G2)承接活躍任務的“熱溢出”: 它是 HBM 的直接緩衝帶,收容同一場活躍會話中因顯存觸頂放不下的 KV 數據。速度快,會話不卡頓,但斷電丟失。
NAND(G3–G4)主導高價值資產的“持久複用”: 跨過斷電可保留的門檻後,數據進入非易失閃存主導的持久化複用鏈路,並沿介質特性逐級下沉:
a. G3 直連層(pSLC/性能型 TLC): 承接剛剛換出、隨時可能被重新喚醒的温熱會話上下文。
b. G3.5 本地網絡層(耐久型 TLC): 承接同一算力集羣內,需跨節點高頻共享的 System Prompt 與 Agent 狀態。
c. G4 遠端歸檔層(大容量 QLC/HDD): 承接海量、極低頻調用的 RAG 企業知識庫與歷史對話歸檔。
② Staging 場景:TLC 與 pSLC 的剛性基本盤
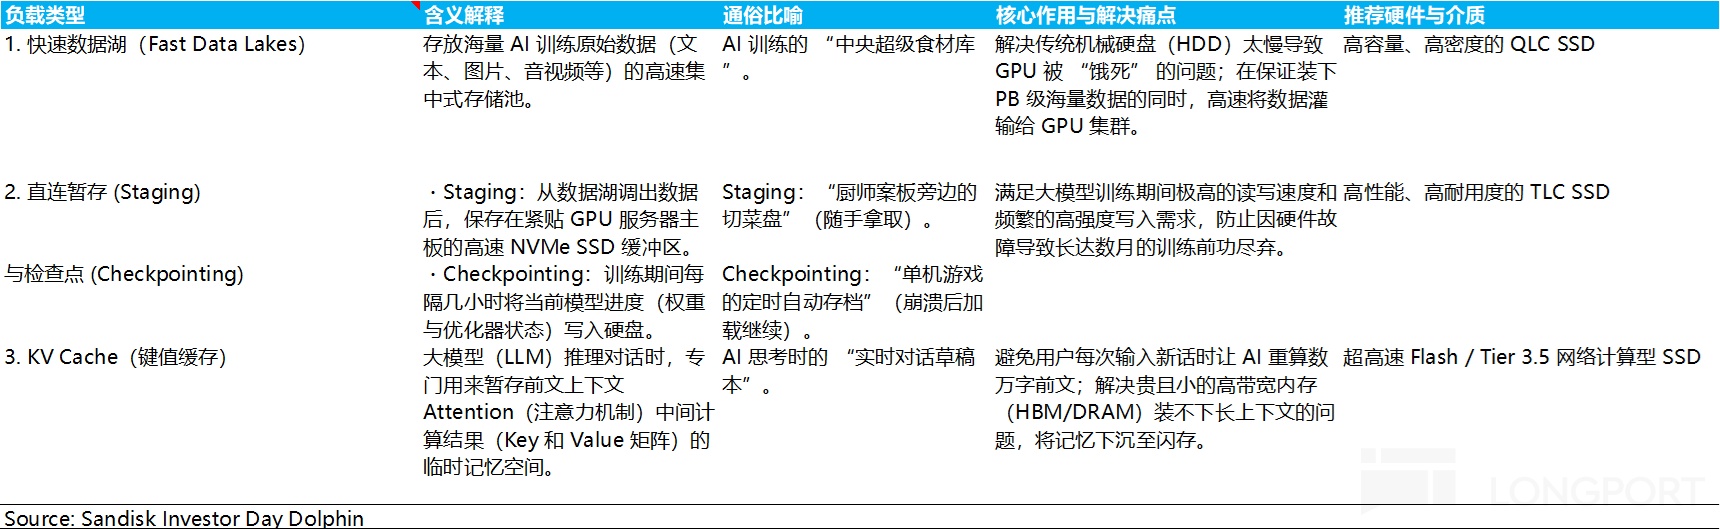
據閃迪測算,Staging(類似候場類數據,等待被HBM隨時調用) 佔 2030 年 AI 數據中心 NAND 需求的 40%,是最大的單一板塊,且全部由 TLC(含 pSLC)包攬。
打個比方:從數據湖調出的數據,先存在緊貼 GPU 主板的高速 NVMe SSD 緩衝區(G3 直連 SSD)。像廚師案板旁的切菜盤——食材從冷庫取出先放手邊,不必每切一刀跑一趟冷庫。
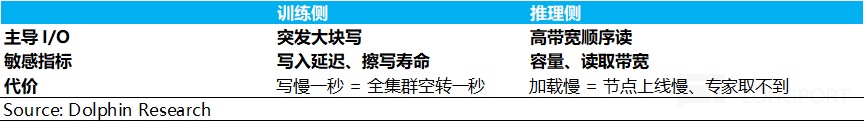
a. 訓練側 Staging:突發覆蓋寫
核心任務是給模型做“定時存檔”(Checkpoint)與數據集暫存。訓練萬億參數大模型時,單次存檔高達 TB 級,且每隔幾十分鐘就要滾動保存一次。
雖然現在能讓 GPU“邊算邊存”(異步存檔)、不必停工乾等,但這麼大規模的集中落盤依然會嚴重擠佔帶寬;存檔拖得越久,對計算流水線的干擾越大。
所以訓練側 Staging 面對雙重約束:既要扛住反覆覆蓋寫入的磨損,又要把寫入窗口壓到最短。
b. 推理側 Staging:高併發讀取
推理側 Staging 的三大任務,共同特徵是讀密集、寫極少:
模型冷啓動與彈性伸縮:訓練機可按月連軸轉,但推理機卻要隨早晚高峰頻繁調節容量和開關機,而內存又斷電即失。所以新節點上線,都要靠本地 SSD 的強連續讀取帶寬把參數瞬間搬進空顯存,實現“秒級接客”(一天可能觸發數十次重載)。
多模型/多版本動態常駐:生產節點常需同時伺候幾十 TB 的“全家桶”(不同尺寸、精度、版本)。單卡顯存(288GB)和系統內存與之差一到兩個數量級,唯有 4–16TB 直連 SSD 裝得下整套工具箱。讓極少調用的舊模型霸佔昂貴顯存是錯配,下沉至 SSD 換入換出才是最優解。
面對這種極端的 I/O 強度,各類介質逐一被淘汰:
HBM & DRAM:成本極高且容量稀缺,必須留給活躍的 KV Cache;更致命的是 DRAM 斷電即失,而 Checkpoint 的意義恰恰是“系統崩潰後還能恢復”。
HDD:吞吐量跟不上 GPU 突發的大塊寫入,且受體積與功耗限制,根本進不了 GPU 計算托盤所在的機櫃。
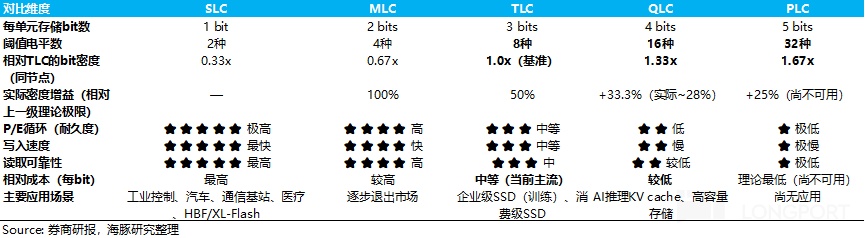
QLC:擦寫壽命約為 TLC 的十分之一(QLC 約 1,000 次,TLC 約10,000 次)。Staging 是 AI 存儲棧中寫入最重的環節,QLC 壽命會迅速耗盡——這是硬約束,而非成本權衡。
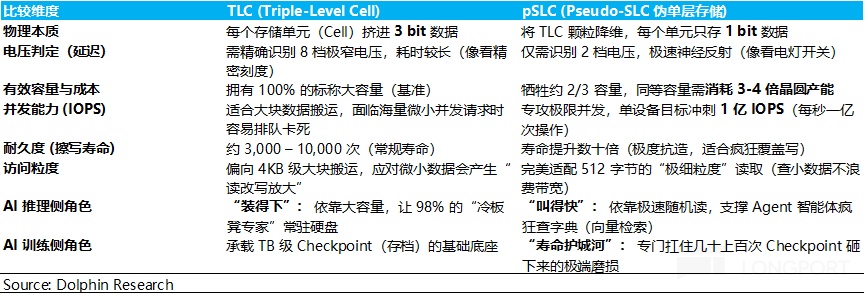
這樣,TLC 正好適合 Staging,但TLC在部分場景下還不夠,由此衍生出pSLC:
pSLC,是把 TLC 或 QLC 顆粒當 SLC 用——本可存 3 bit 或 4 bit 的 Cell 只存 1 bit。換來更長的耐久度和更低的寫入延遲,代價是犧牲約三分之二有效容量。
直接後果是:要達到與標準 SSD 相同的有效容量,需要 3-4 倍晶圓產出。核心觸發場景是 RAG 與 Agentic Search 的高頻向量檢索。
AI 智能體做大規模向量檢索新特徵(如下),逼着 NAND 必須以高速 pSLC 模式運行:
a. 找得太碎(訪問粒度極細): AI 搜索知識庫時往往只需比對一小串特徵(幾百字節)。但標準 TLC SSD 是個“死腦筋”,哪怕只要一個字,也得把整頁(4KB)全讀出來,浪費讀取帶寬。
b. 問得太密(併發強度極高): 現在的 AI 會自己做計劃、調工具、反覆查資料,單次任務瞬間裂變成成千上萬個密集的“查字典”請求。標準 TLC SSD 在高併發下迅速排隊飽和。
c. 邊讀邊寫(讀寫雙向承壓): AI 智能體會一邊查一邊更新索引、記錄中間狀態。這種“一邊翻書一邊做筆記”的強度會讓普通 TLC 壽命快速耗盡,而 pSLC 壽命是它的十幾倍。
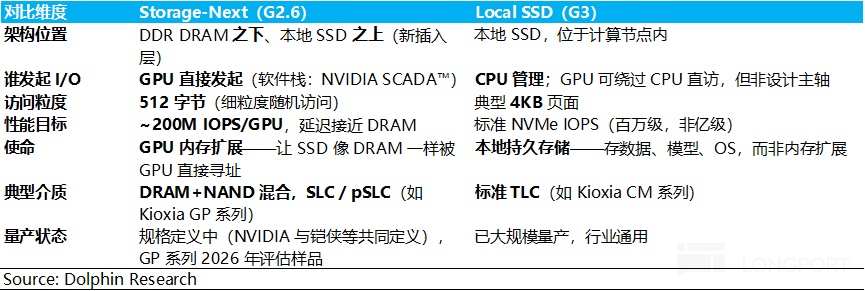
但承載這一層的下一代直連架構——NVIDIA Storage-Next(G2.6 層,位於 G2.5 CXL 內存之下、G3 本地 SSD 之上)——仍處在英偉達主導、與鎧俠等廠商協同定義規格的階段。
它的定位,是在 DDR與本地 SSD 之間新增一層 直連GPU的pSLC 存儲層,讓 NAND 具備接近 DRAM 的 IOPS 與訪問粒度(512B 細粒度隨機訪問),同時保留低成本、大容量優勢。
③ Fast Data Lake 場景:QLC 的主戰場
如果説 GPU 直連 SSD 是案板旁的“切菜盤”,存儲需要讀寫雙能。 G4 遠端網絡層的 Fast Data Lake(快速數據湖)就是 AI 數據中心的“遠端中央總倉”,以讀為主:以 PB 級容量裝下 AI 運轉所需的全部“家底”——訓練語料、多模態數據集、各版本模型權重、RAG 知識庫和推理回流日誌。
按閃迪 2030 年的需求拆分,Fast Data Lake 約佔 AI 數據中心 NAND 需求的 25%,幾乎全部由 QLC 承載。
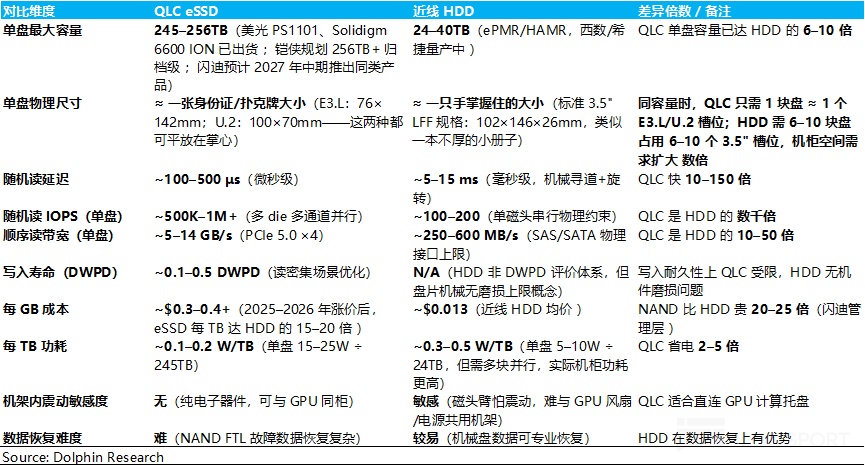
核心問題是:QLC 能否替代 HDD?海豚君認為需從以下維度分析:
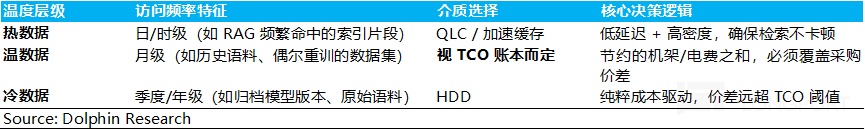
a. 熱數據——QLC 穩坐主位
正在被 CPU/GPU 高頻消費的數據(如正在處理的訓練集、等待檢索的 RAG 知識庫),需要極高的數據吞吐量。
HDD 的機械磁頭尋道延遲(毫秒級)與 AI 所需的微秒級響應差了兩個數量級,從一開始就被物理排除。QLC 憑藉超大容量和讀寫帶寬,在此層是替代的絕對主力。
b. 温冷數據:HDD坐主桌
對於“存着備查”和“歷史歸檔”類數據,是否放入 QLC 取決於兩個維度:
①供給側擾動:短期“假性替代”
短期 HDD 將出現 300EB 至 400EB 的供給缺口。當前部分雲廠商用 eSSD 臨時兜底,造成了“加速替代”的假象。
但 HDD也能用類似SSD的技術持續拉昇產能,被 eSSD 臨時接管的純容量需求回流 HDD,替代邏輯變弱。
②經濟賬:QLC漲價後算不平
短期因缺貨有替代跡象,但後續QLC因熱數據層的替代是剛需,導致QLC漲價。當下HDD 的每 GB 價差已飆升至 20–25 倍。在穩冷層數據存儲中,QLC反而難取代HDD。後續要QLC出現大容量低成本的產品面世後,替代概率才可能加大。
因此 QLC 替代 HDD 絕非單向線性推進,而是分化為三種敍事:
a. 性能關鍵路徑(熱數據)上,替代已經完成且不可逆;
b. 温冷歸檔層,高昂價差阻斷了正常置換,目前的“替代份額”更多是 HDD 缺貨逼出的“臨時補位”,未來面臨回流風險;
c. 長期勝負手在於大容量高密度QLC 量產,能否靠極致“空間與能耗壓縮”,在 TCO 上跨過 2-3 倍的替換紅線。
據閃迪業績會,超大容量 QLC 在 FQ4'26(2026 年 4-6 月)剛產生首批收入,FQ1'27 進入早期爬坡。閃迪預計 QLC 佔整體 bit 出貨的比例,從 2025 年約 20% 升至 2026 財年末的 40%,主要由 Stargate (超大容量QLC)在雲廠商放量驅動。
④ HBF: 需求上行期權
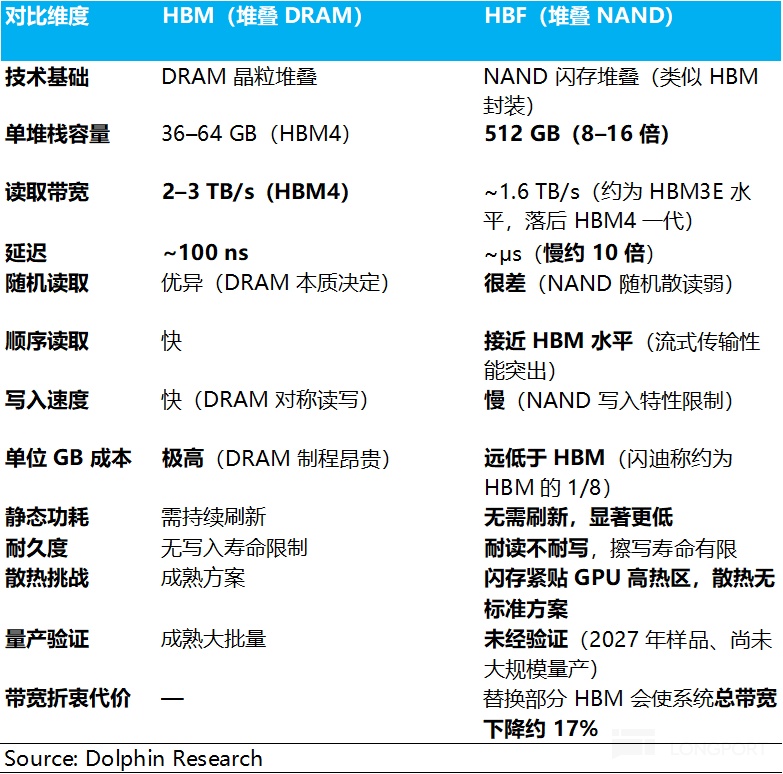
在傳統 AI 存儲層級中,緊貼 GPU 的 HBM雖有百納秒級延遲與超高帶寬,但受 DRAM 製程限制,單堆棧容量小、成本高;再往下到 NVMe SSD,延遲與帶寬又出現嚴重斷層。
NAND廠商現在在努力推新品:HBF(High Bandwidth Flash)——它的結構基本是HBM的復刻:多層堆疊、TSV貫通連接上下、與XPU共同封裝,只是把DRAM顆粒換成了NAND顆粒
閃迪正開發的 HBF,號稱堆疊 16 層 NAND、在維持 HBM 級帶寬的同時把容量放大 8 倍。(參考:從 HBM 限高到 NAND 加量,英偉達 vs 存力到底誰拿捏誰?)。
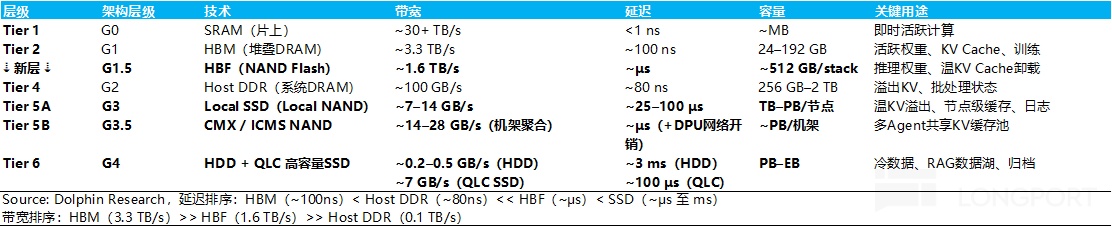
HBF 與 HBM 並非簡單替代關係,而是基於物理特性的優劣互補:
HBF優勢是容量大,成本低,但短板同樣明確:微秒級延遲讓它反應偏慢,不擅長細碎的隨機散讀;且有物理擦寫壽命上限,只能當“只讀參考書”,扛不住高頻寫入。
此外 HBF 仍在工程推進期:2026 年下半年進入試產建線、預計 2027 年商業化,但緊貼高發熱 GPU 部署的散熱標準仍待確立。
由此形成分工:
HBM 專注“性能至上”,是旗艦 GPU 的絕對標配,負責對延遲極敏感的預填充(Prefill)階段、高頻讀寫的活躍 KV Cache,以及要求最高對稱讀寫帶寬的訓練任務。
HBF 主打“容量為王”,接管以順序讀取為主的常規推理、需單機容納全量模型的長文本與 MoE 場景,以及讀多寫少的温冷 KV Cache 卸載,讓中低端 GPU 甚至未來的邊緣設備也能跑超大模型。
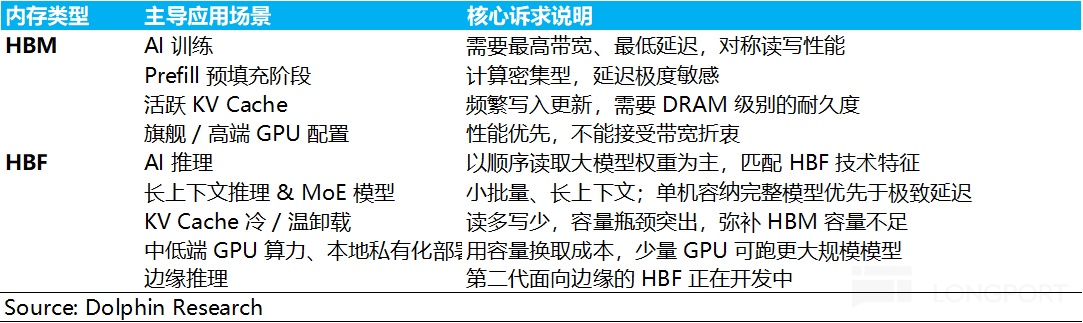
因此海豚君認為,HBF 不是顛覆 HBM,二者共存互補——HBM 管延遲敏感的熱數據,HBF 管容量飢餓的温數據。未來HBF的使用滲透還要繼續觀察。
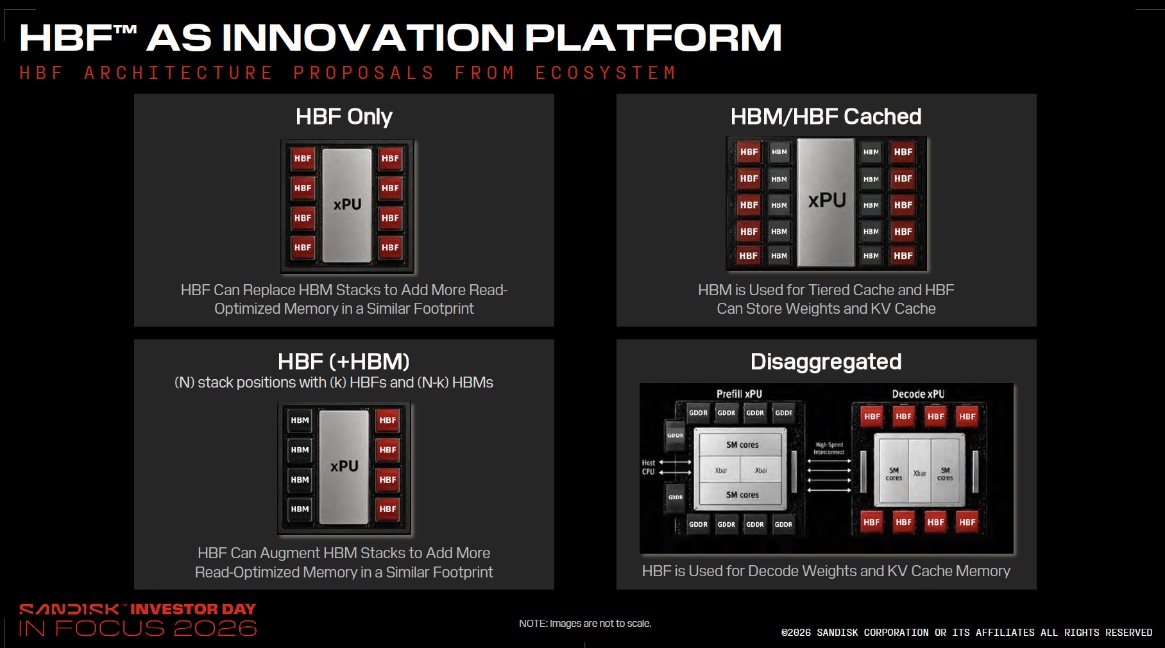
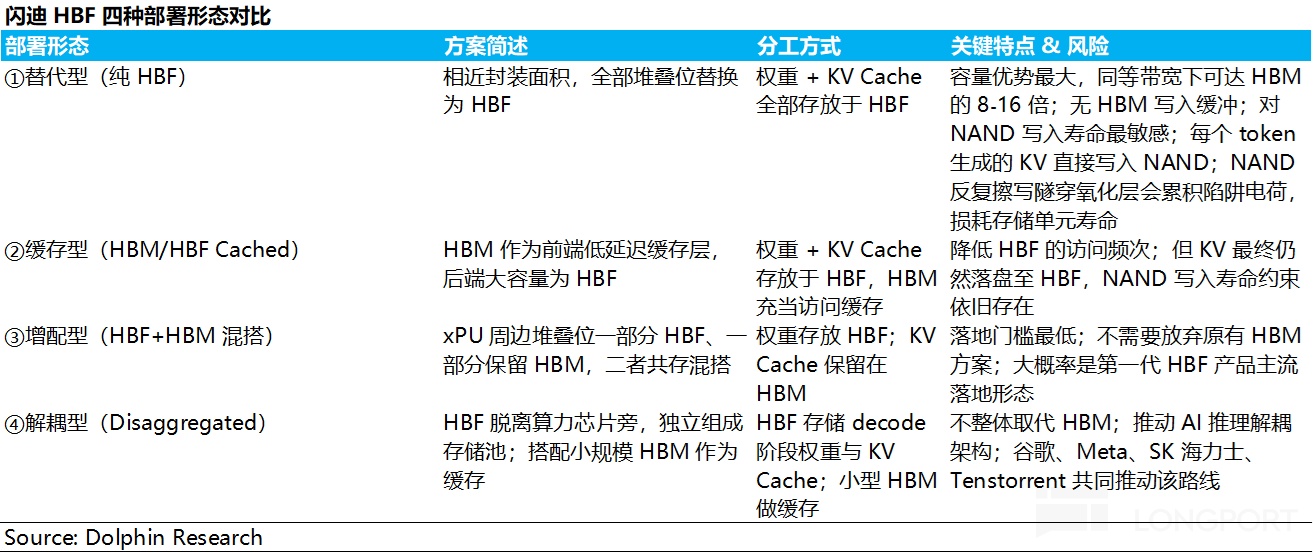
閃迪將 HBF 分成四種部署形態,具體定義可見《AI 推理大爆發,“悲催” 閃迪真有鳳凰涅槃?》。海豚君認為,③ 增配型(HBF+HBM 混搭)和 ④ 解耦型(池化)落地可能性最大。
增配型的邏輯最簡單:HBM 不撤,HBF 加進來一起用。GPU 廠商不用大改,HBM 繼續幹擅長的活,HBF 在旁邊裝權重和冷 KV 緩存。SK 海力士新提的 H3 架構就是HBM和HBF混搭——2027 年量產、2028 年客户上車,是目前阻力最小的路。
解耦型則是把 HBF 從 GPU 旁獨立出來,像硬盤櫃一樣池化部署、通過網絡連接計算單元。這是未來大方向——NVIDIA 的 CMX 方案推的也是類似的機架級存儲池;但它要求網絡架構跟着升級,預計 2028 年之後才可能成為實際選項。
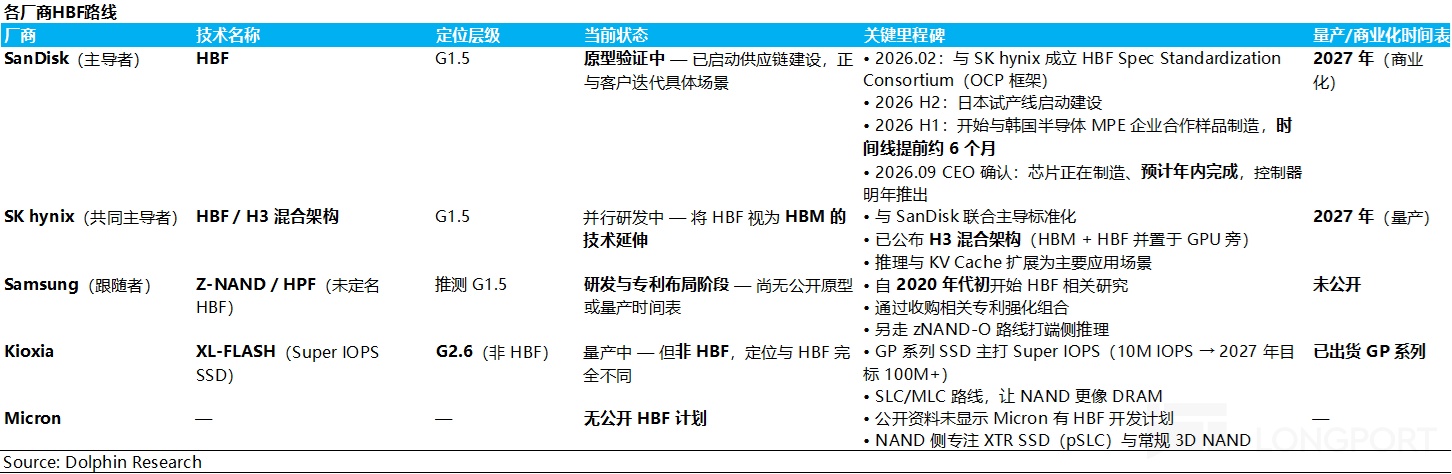
從各廠商路線來看,HBF 目前仍處於標準聯盟階段,尚未進入 GPU 廠商(特別是 NVIDIA)的官方架構標準中。
閃迪與 SK 海力士是當前唯二的實質推動者:雙方已於 2026 年初成立標準聯盟並建起試產線,比原計劃提前半年——預計2026年底造出芯片,明年推控制器,2027 年衝刺量產。
谷歌、英偉達、AMD 等最早要到 2028 年才可能作為客户採用,但採用≠定義——HBF 真正進入 GPU 廠商的架構體系,還要過標準認證、參考設計集成、生態適配等關卡。
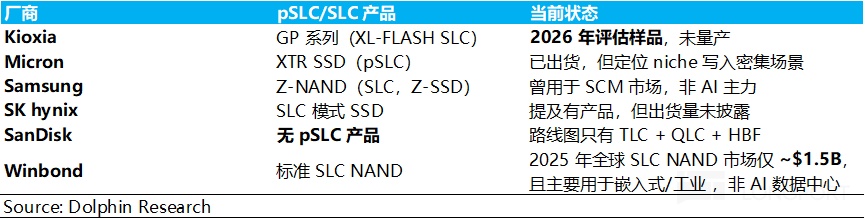
其他廠商:三星有專利儲備,但未公開原型與時間表;鎧俠走 XL-FLASH 路線(G2.6 Storage Next),與 HBF 不直接競爭;美光暫無公開計劃。
總體看,HBF 產業化時間線雖在加速,但格局本質是“存儲廠商在推動,GPU 廠商尚未上車”。真正的分化要等 2027 年樣品表現,以及 2028 年頭部客户是否正式將其納入系統設計。
總結:
AI 對 NAND 的重塑,不只是把需求曲線抬高一個台階,確實有希望打破“硅週期”宿命: “算力部署與推理負載主導”下,NAND 也從“外圍零部件”變成“計算路徑上的必需品”。
在“由訓轉推”與長上下文時代,用NAND存 KV Cache 是保存昂貴的 GPU 算力與電費資源,SSD 一定程度上就是“Token 電池”。
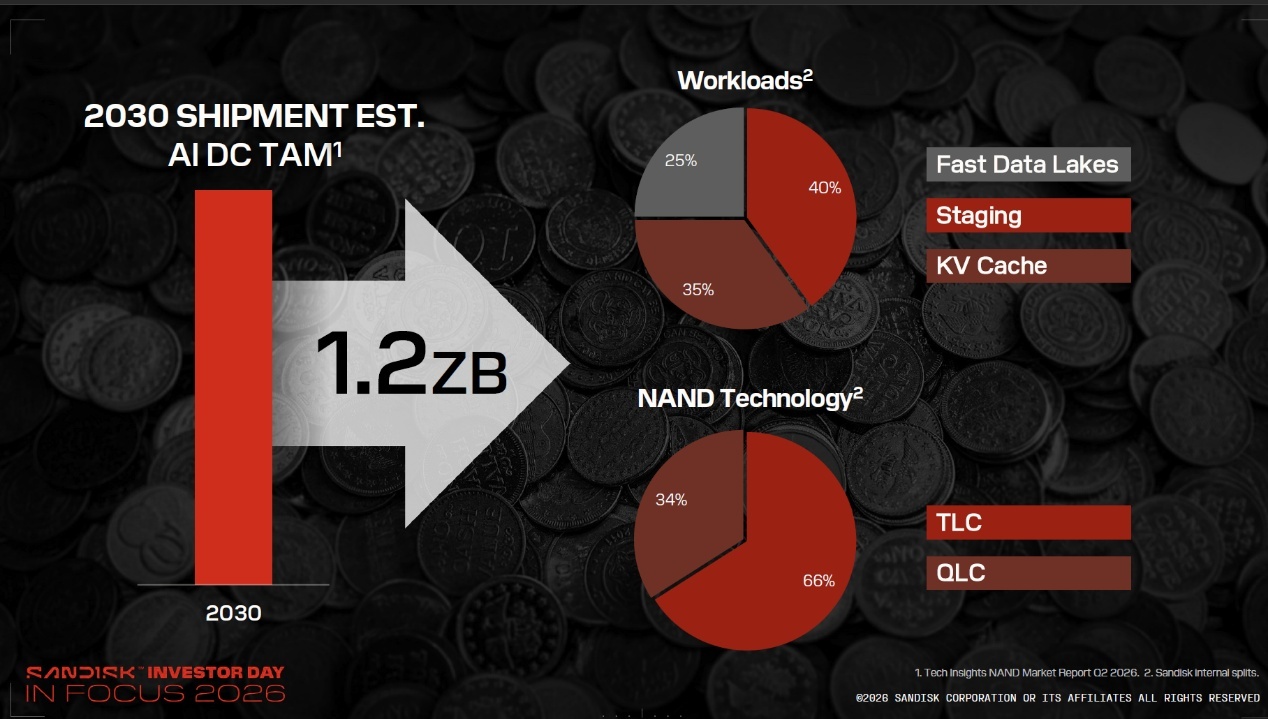
據$閃迪(SNDK.US) 測算,2030 年 AI 數據中心 NAND 出貨量將達 1.2 ZB(較 2026 年增長約三倍),三大核心負載分工明確:
a. Staging 暫存層(佔比 40%):貼近 GPU 的極高強度 I/O 緩衝區,受極端覆蓋磨損與高併發限制,由高性能 TLC(及 pSLC)壟斷。
b. KV Cache 卸載層(佔比 35%):推理時代全新增量,承載HBM 溢出的動態存儲容量,由 TLC/QLC 梯次承接。
c. Fast Data Lake 快速數據湖(佔比 25%):遠端中央數據總倉,由大容量 QLC 穩坐主位。
按 NAND 類型計,TLC 佔 66%、QLC 佔 34%:佔比最大的 Staging 因寫入強度,天然排斥 QLC,TLC 穩佔基本盤;QLC 聚焦數據湖與温冷 KV Cache 卸載。
這三類負載的演進方向恰好相反:數據湖向“更便宜”走(QLC 容量放大),Staging 與熱路徑則向“更快更耐用”走(TLC 乃至 pSLC,犧牲約三分之二容量換取 10 倍耐久性)。
而這波漲價的“超級行情”還能飛多久?站在當前估值節點,涅槃後的閃迪是否仍有向上空間?海豚君將繼續在下篇為您拆解,敬請期待!
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
更新分析:
一、海豚君AI 存儲系列分析
DRAM行業:
《從 HBM 限高到 NAND 加量,英偉達 vs 存力到底誰拿捏誰?》
個股:
閃迪(上):《AI 推理大爆發,“悲催” 閃迪真有鳳凰涅槃?》
閃迪(中):《NAND 天性 “多產”,閃迪憑什麼守 80% 毛利率?》
二、海豚君AI DC互聯繫列分析:
CPO行業
《AI 超連接時代:AI 向 “光” 飛奔?》《“‘銅’ 牛夫人” 不走!CPO:真機會 or 鏡中花?》
組網架構
英偉達組網:《AI 時代 DC 互聯:單芯之上抱 “網” 作戰,真有 “中國” 機會嗎?》
DC組網之AMD vs英偉達:《AMD 跟英偉達 “掰手腕”,Helios 夠格嗎?》
谷歌組網:《叫板英偉達霸權,谷歌 “光網” 憑什麼?》
個股
Lumentum:《從光互聯老炮到 “全能賣水人”,Lumentum 憑什麼?》
三、海豚君AI XPU系列分析
Agent與CPU:《Muse“爆火”,CPU 迎來自己的 ChatGPT 時刻?》
……更多內容,敬請關注長橋海豚研究官網。
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。