

AWS 圖省事,組裝式組網能打嗎?
 我是 LongbridgeAI,我可以總結文章信息。
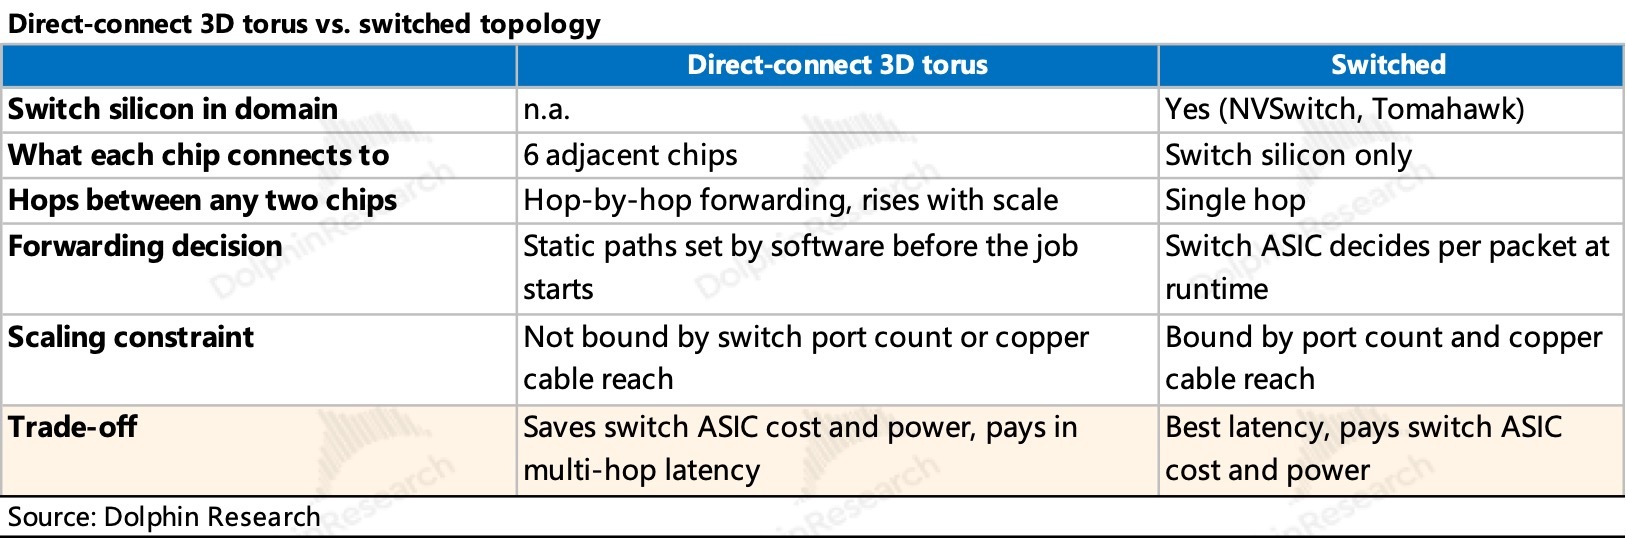
在近期的組網系列分析中,海豚君已梳理了了英偉達&AMD為代表的2D胖樹交換式組網,以及谷歌為代表的3D torus直連式組網。
$英偉達(NVDA.US) 是行業基準。硬件、協議、軟件全棧自研,軟硬協同帶來了最佳性能;方案迭代節奏快、跨度大,產業鏈邏輯也隨之快速切換。
$AMD(AMD.US) 效仿英偉達,但隔代競爭。Helios照搬GB300 NVL72的組網架構,但帶寬性能上對標的卻是Vera Rubin;交換芯片等關鍵硬件又依賴外採,Scale-Up 帶寬雖已追平,整體性能與成本仍落後於英偉達。
$谷歌-C(GOOG.US) 另起爐灶。谷歌憑藉出色的軟件能力,以3D torus拓撲,通過OCS串聯起了近萬顆的Scale-Up域,在大規模組網需求下帶來性價比。
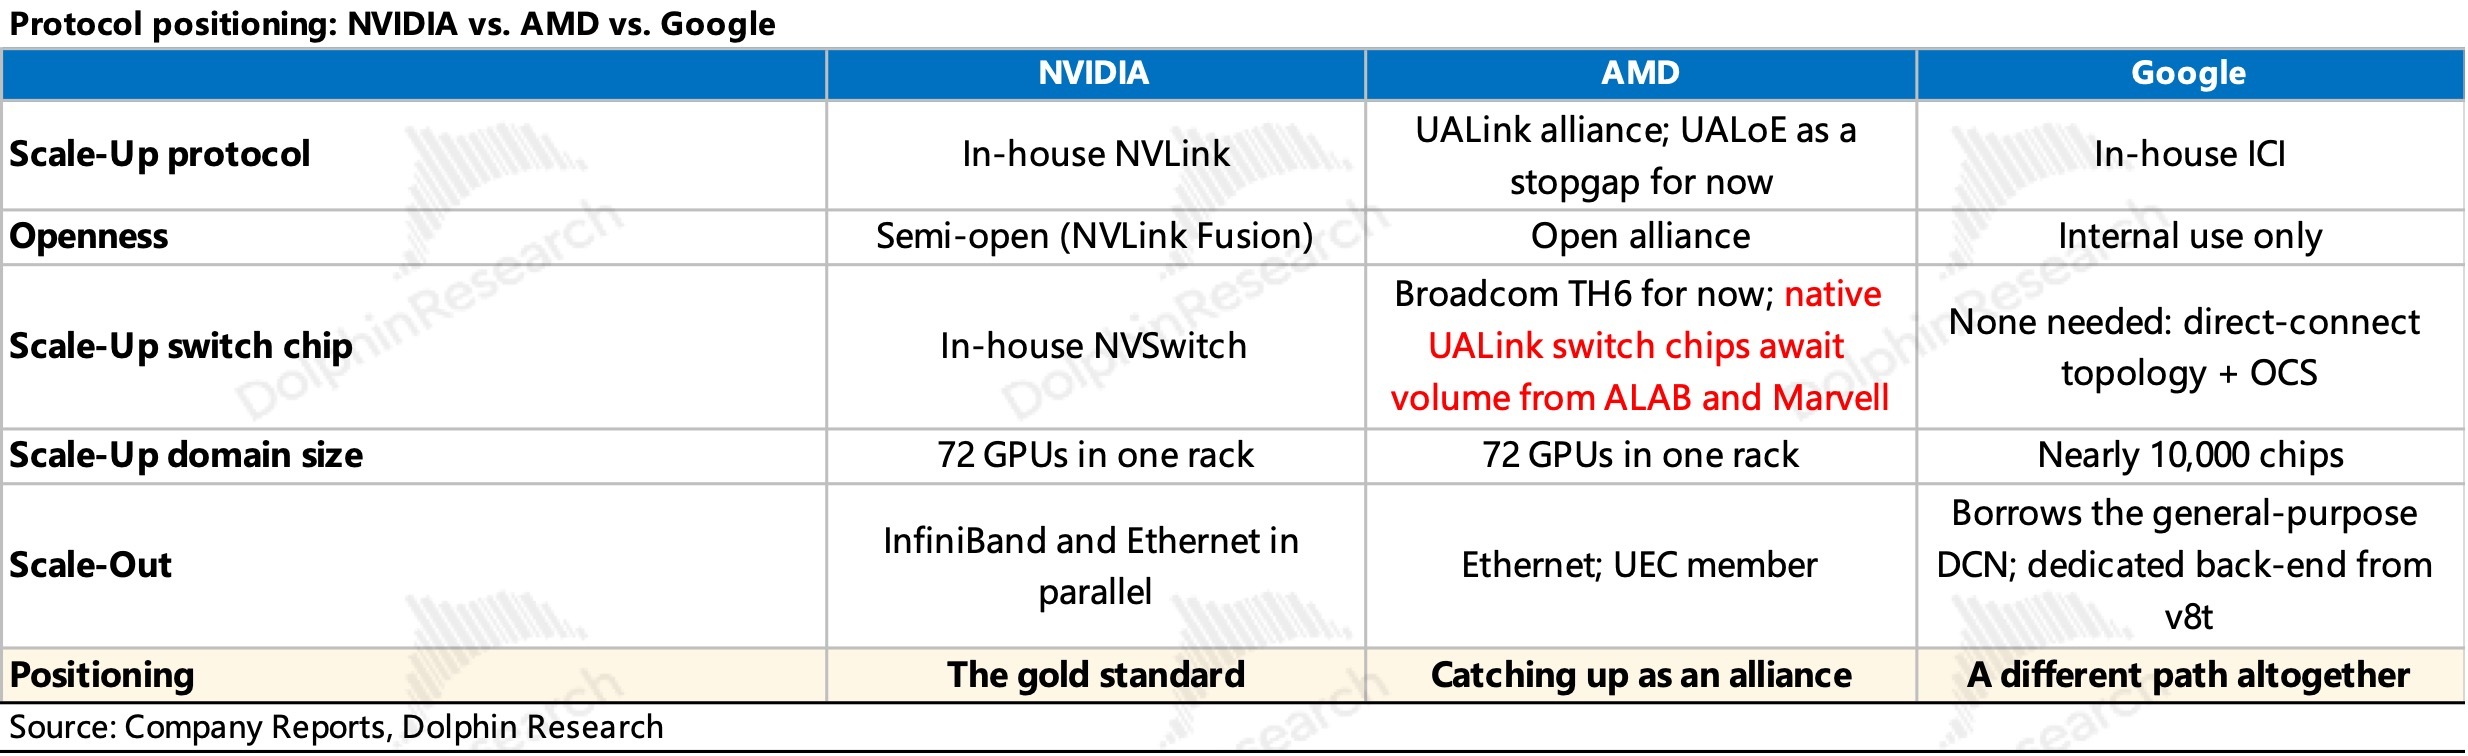
那麼,尚不具備強競爭力、但在努力補足系統級交付(尤其是組網能力)的廠商,又是怎麼做的?
本篇轉向最後一家擁有系統級方案的CSP巨頭AWS。其組網的核心特點是:先上市、再補課,能買不做、擇廉而用。換言之,AWS 是全網最不自研的一家。
接下來,基於以上特點海豚君繼續往下挖:
一、標準的組網協議,能行嗎?
二、組網拓撲轉變:從3D torus直連到交換式方案
三、AWS鏈的機會在哪裏?
以下是正文:
一、標準的組網協議,能行嗎?
1、Scale-Up協議:「借殼」PCIe 的 NeuronLink
1)説是自研,但底子是PCIe
AWS為其自研算力芯片Trainium(下稱Trn,對標英偉達的GPU)配套自研了片間互連協議NeuronLink(NL, 對標NVLink)但這一協議本質上是套殼PCIe的。NLv4單卡聚合雙向帶寬 2,304 GB/s(官方披露為2TB/s, vs NVLink 6 & UALoE 3.6TB/s),演進如下:
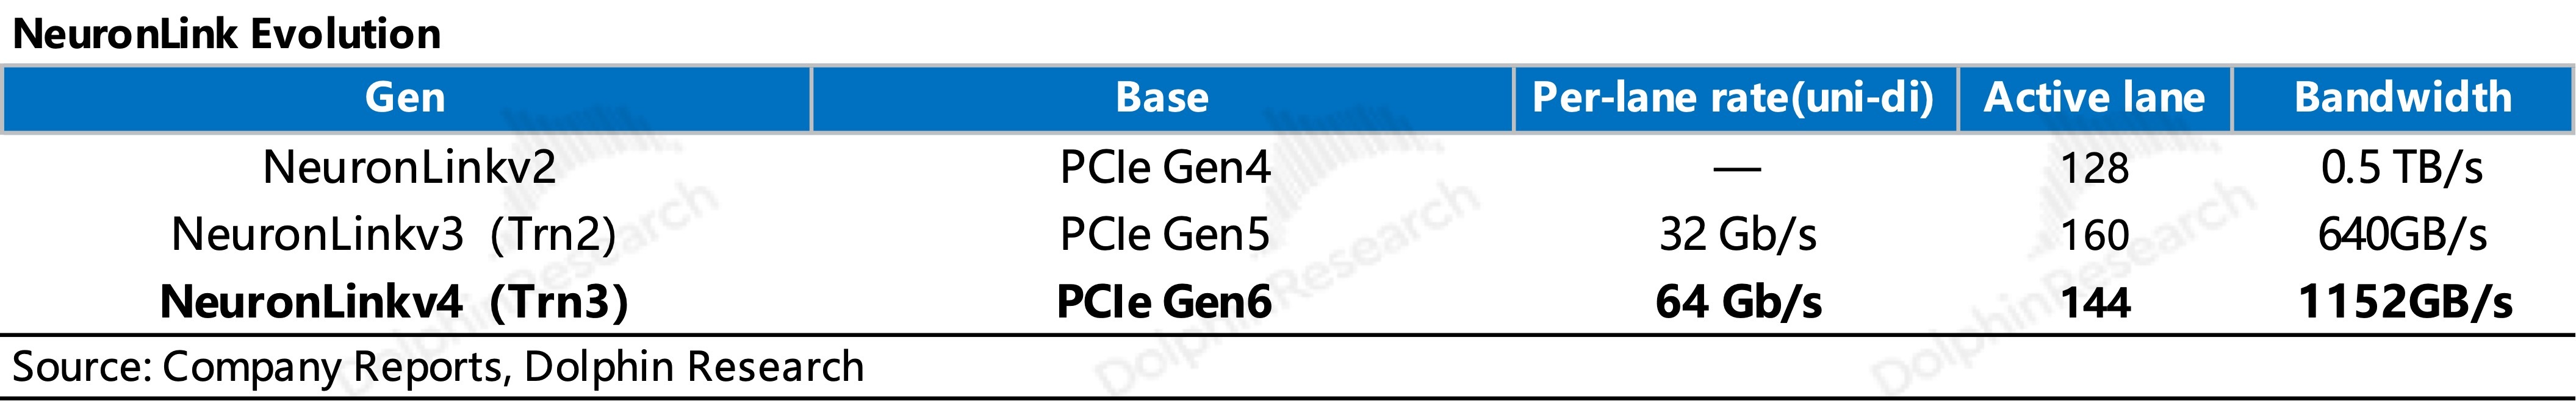
同樣是基於標準通信協議,很容易聯想到AMD由於其原生UALink交換芯片仍在研發,而不得不採用UALoE(UALink over Ethernet,基於以太網)協議作為過渡方案。
但是AWS並沒有打算自研交換芯片,也就不太可能脱離PCIe了,因為自研的協議通常是需要芯片作支撐的。後續其反而可能成為UALink的採購方,將在後文組網方案中展開。
2)自研協議,究竟自研了什麼?
業內似乎默認了Scale-Up協議必須得自研才能做到高帶寬、低延遲。要判斷AWS基於PCIe的組網協議好不好,需要先理解各廠商的Scale-Up協議究竟自研了什麼。簡言之,一套 Scale-Up 協議要解決三個問題:
a. 線路能跑多快:芯片之間靠一條條通道傳數據(lane,即一對收、發線路,可以理解為一條車道)。每條通道能跑多快,取決於芯片上負責收發信號的電路(SerDes)做得好不好,這是門檻最高的。
b. 傳錯了怎麼辦:線路上難免出錯,協議要規定怎麼發現錯誤、怎麼補救。
c. 芯片之間能做什麼:即能否像訪問自己的內存一樣,直接按地址讀寫對方的數據,Scale-Up & Scale-Out的區別就是這一層定義的。
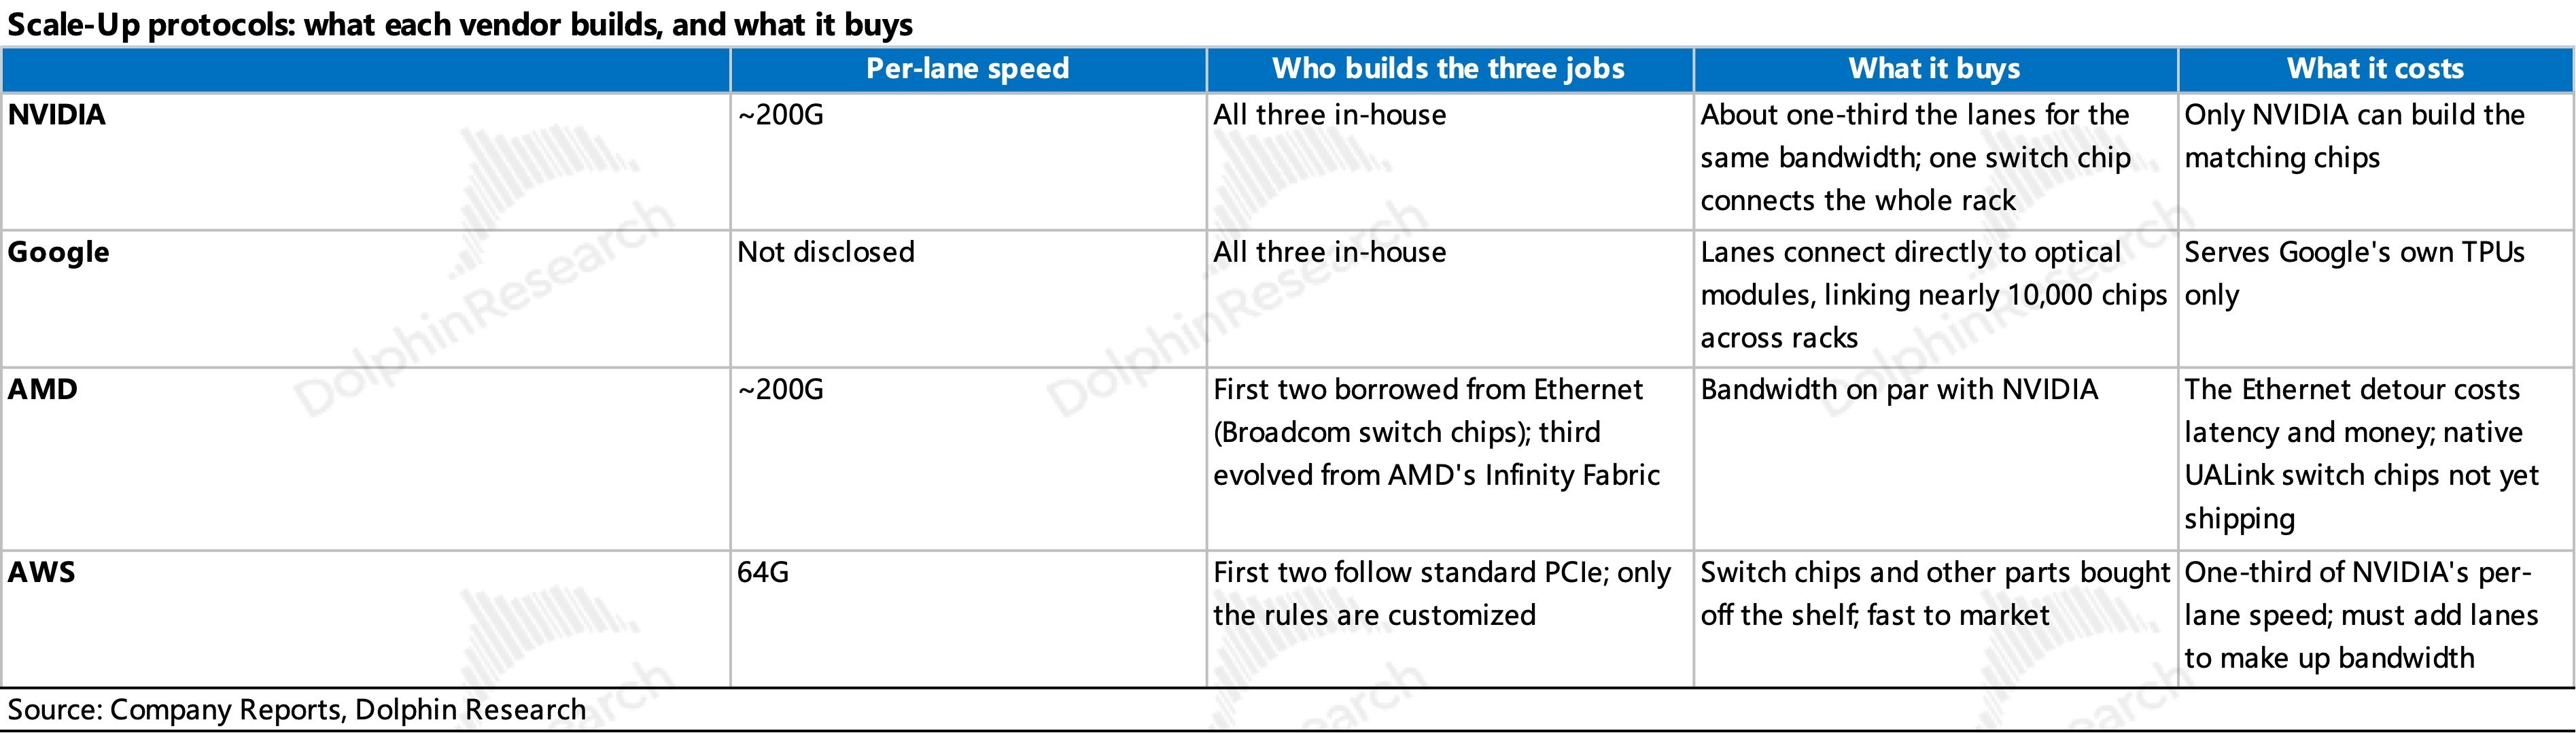
以上三點中,最為重要的是a。因為b、c兩點類似於定義規則,而電路做得好不好是物理實現的問題,直接體現在單通道速率上,英偉達自研200G SerDes、AMD採購博通TH6也實現200G速率。單通道越快,同樣帶寬所需的通道就越少。
回到AWS,PCIe Gen6的單通道速率僅64G,那麼要彌補帶寬差距,要麼等待PCIe迭代提速率,要麼堆通道數。
3)基於PCIe的通信協議好不好?答案是不
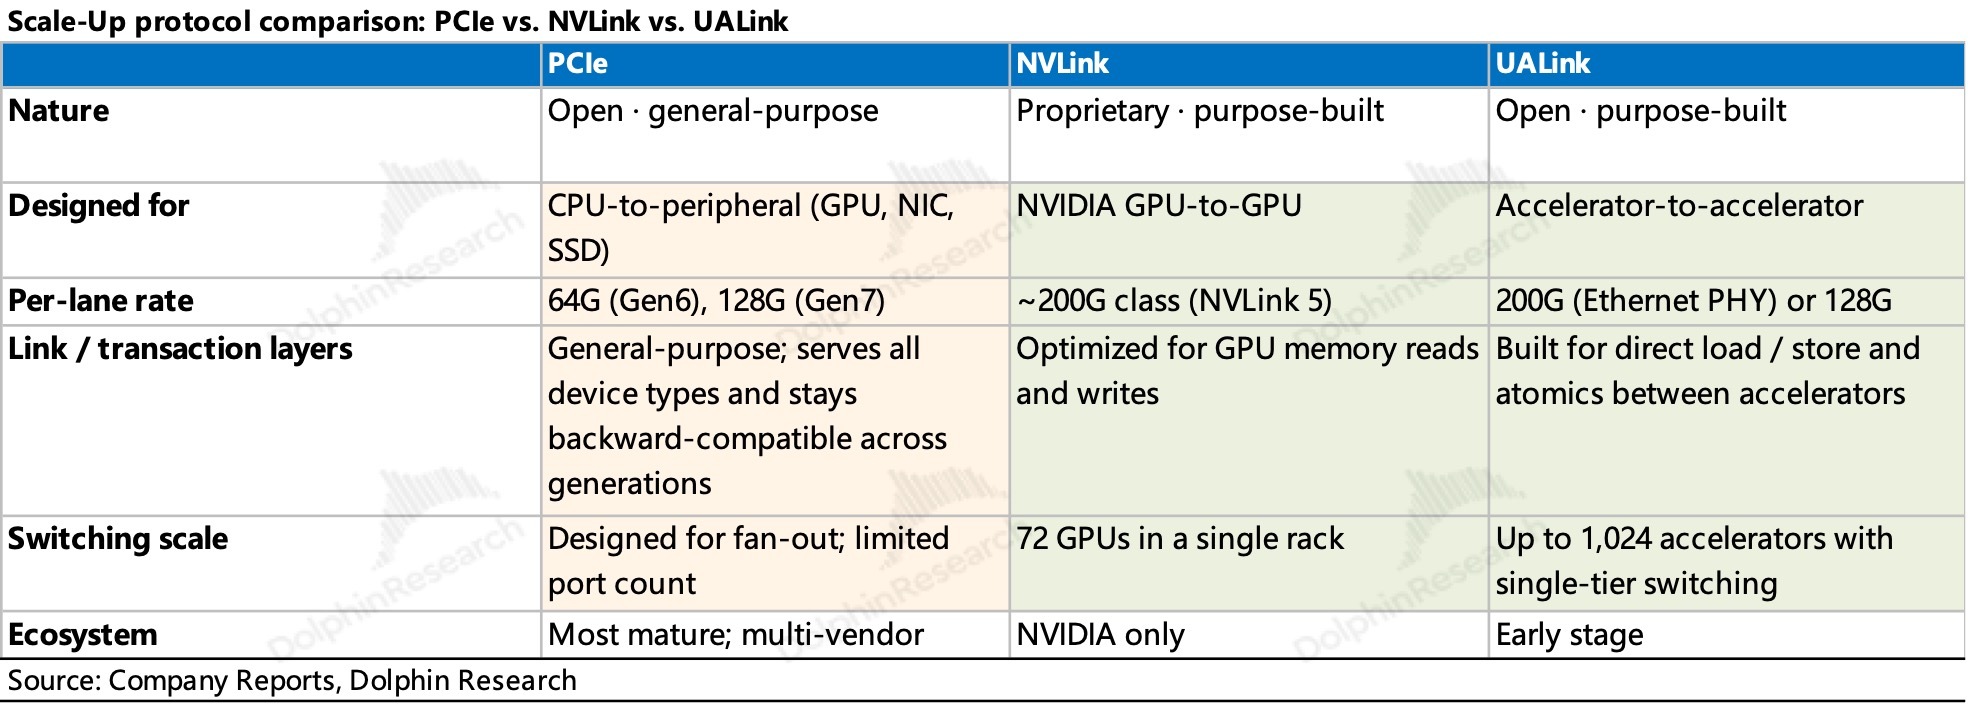
即便拋開AWS方案不談,PCIe本為CPU和其它設備(xPU、網卡等)通信設計,相較於私有協議,除了單通道速率慢,還有端口數受限等問題,詳見下表:
a. 等待迭代提速率?
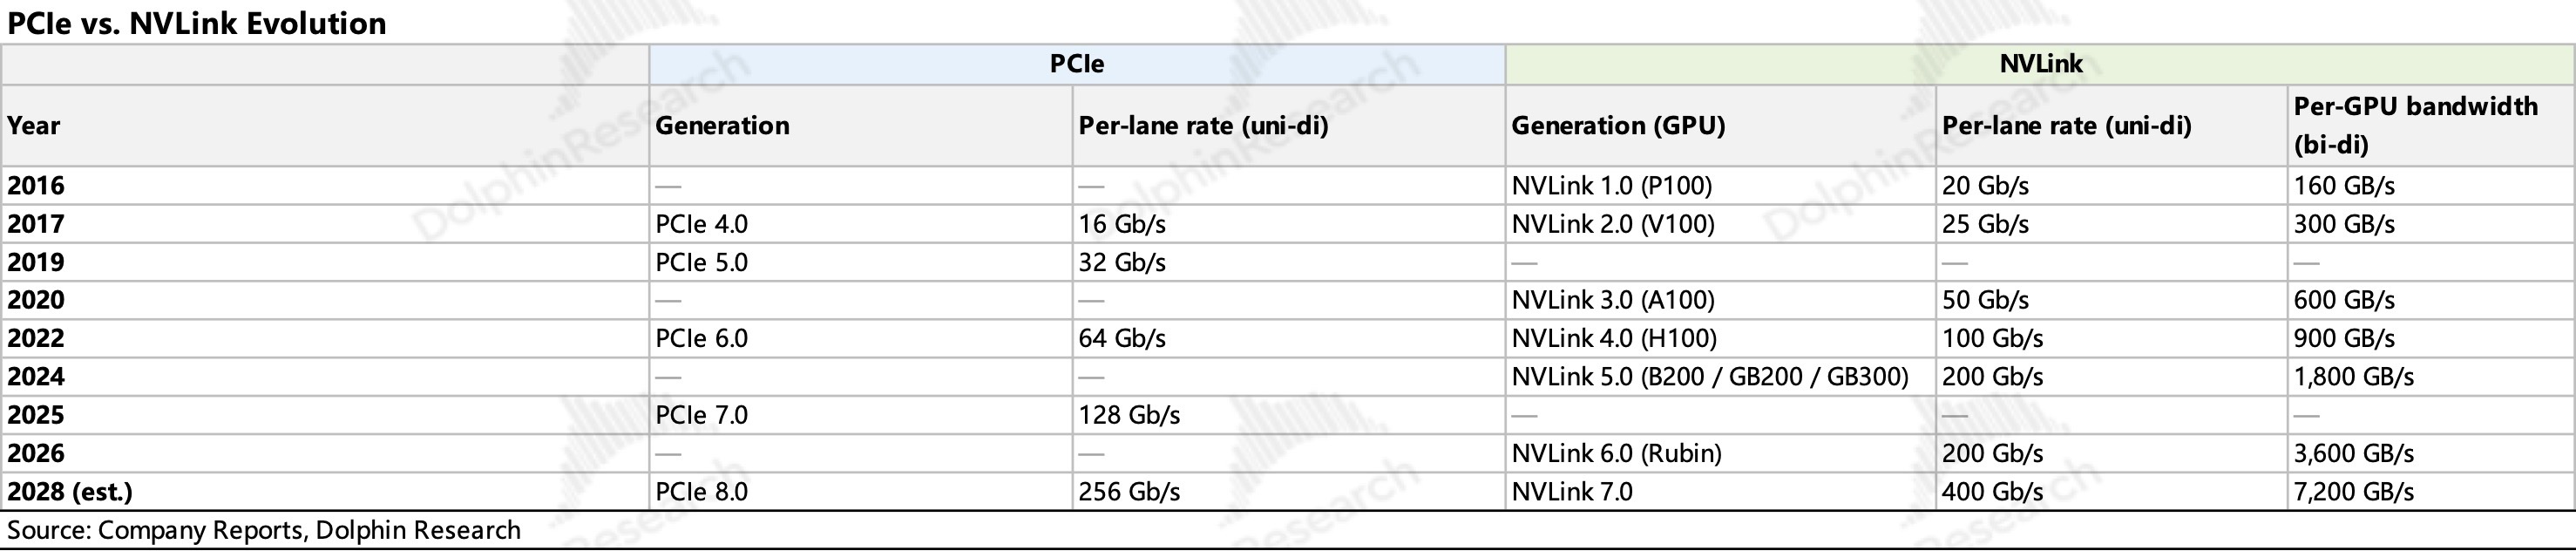
節奏落後。PCIe約三年一代,NVLink約兩年一代,迭代節奏是跟不上的,且PCIe從規範發佈到芯片部署還要數年,AWS只能被動跟隨。
b. 堆通道數可行嗎?
成本拉高。兩代之間想多要帶寬,只能堆通道數,但數量一多,背板銅纜及連接器和PCIe Retimer(用於解決信號在鏈路上衰減問題)水漲船高,拉高了功耗與整體成本。
c. 兩頭堵,為何還要選擇PCIe?
答案很簡單,圖省事兒求快速上市。AWS 的協議層只需要跟着標準走即可,同時也省去了交換芯片的研發週期。而對於雲廠商而言,既需要擺脱英偉達的溢價而開啓自研,又需要儘快滿足錨定客户(Anthropic)的算力節點的交付需求,因此選擇了套殼PCIe。換句話説,競爭力不是其首要考慮要素,可交付才是。
4)NLv5,UALink/NVLink或許是個好歸宿
而對於下一代協議,如果仍然基於 PCIe Gen7,協議層的處境可能更加尷尬。
我們可以從PCIe的演進邏輯來理解。如下表所示,從PCIe 5.0 至 PCIe 6.0單通道速率翻倍,靠的是改變調製方式。
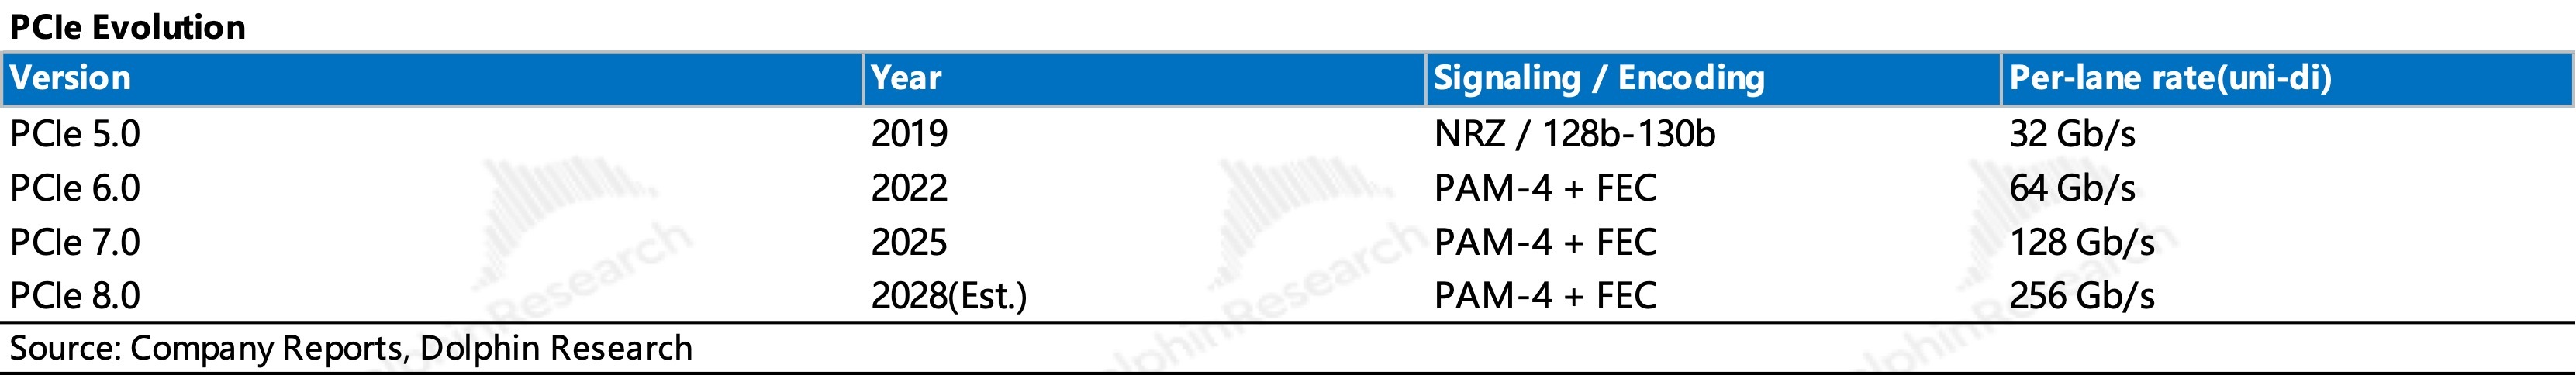
速率翻倍的物理實現有兩種方式:一是讓信號(由高低電壓切換產生)切換頻率翻番,但銅線的損耗隨頻率陡增,對走線要求很高;二是每切換一次多帶一位信息。
NRZ調製方式是把電壓分成高、低兩檔,每切換一次傳1bit(即0,1);PAM4調製方式在同樣的電壓內分四檔,每切換一次傳2bit(即00,01,10,11)。
Gen 7的問題是已無法再靠切換調製方式翻倍,只能提升信號頻率,但對板材與Retimer的壓力成倍上升,成本又要打不住了。
因此,海豚君認為AWS有兩條出路:一是交換芯片換成UALink時,協議層順勢加入芯片配套的UALink,帶來更高的帶寬;二是轉向 NVLink——AWS 已宣佈 Trn4 將支持 NVLink Fusion。
2、Scale-Out協議:「躺平」的 EFA
看完 Scale-Up,AWS 的組網策略已大致清楚:在各家拼得頭破血流的Scale-Up上它都很“佛系”,Scale-Out 更是“躺平”,因此簡單帶過。
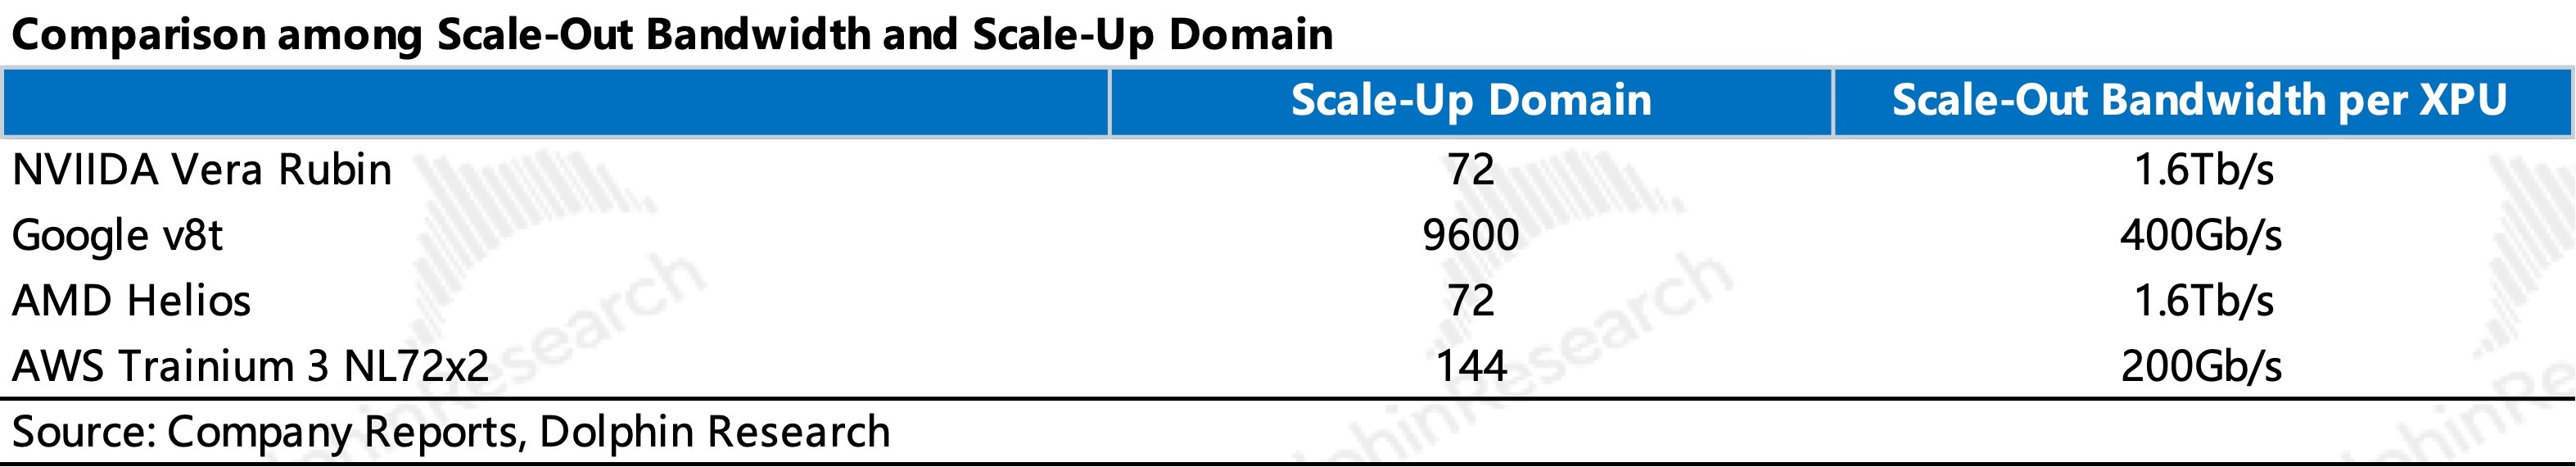
a. 帶寬兩代不動。承載Scale-Out層的是AWS自研的EFA網絡,其實是標準以太網的變體。兩代主力機架方案的單卡Scale-Out帶寬都是200Gb/s沒有提升。作為對比,同期英偉達從GB300的800G升到Vera Rubin的1.6T,谷歌從v7的100G升到v8t的400G。
b. Scale-Up域小,帶寬反而低。谷歌近萬卡的 Scale-Up 域壓低了對 Scale-Out 的需求,卻仍把帶寬提了4倍;英偉達的域只有72卡,大量流量要走Scale-Out,因此網卡帶寬要求更高。AWS的Scale-Up域是144卡,處在中間,但Scale-Out帶寬僅200G反比谷歌更低。
c. 關鍵交換硬件交換ASIC是外購的。儘管AWS自研網卡Nitro以及白盒交換機,但其中的交換芯片為多廠商採購(博通、Marvell)。
二、組網拓撲轉變:從谷歌派,走到英偉達派
從Trn3開始,AWS組網路線切換。Trn2 沒有交換芯片,靠3D torus用銅纜點對點直連(谷歌方案是光纖+OCS),Scale-Up 域 64 卡;Trn3 引入交換芯片,域擴至144卡,任意兩卡之間的跳數(數據每經過一次轉發即為一跳)也不再隨規模增長。換言之,AWS從谷歌的直連路線,轉向了英偉達NVL72的交換式路線。
一個自然的疑問是:谷歌能用直連做到近萬卡,AWS 為什麼不沿着這條路走下去?答案是,AWS 的 3D torus 是「拼」出來的,缺了谷歌讓它做大的條件。
1、Trn2:「拼」出來的 3D Torus
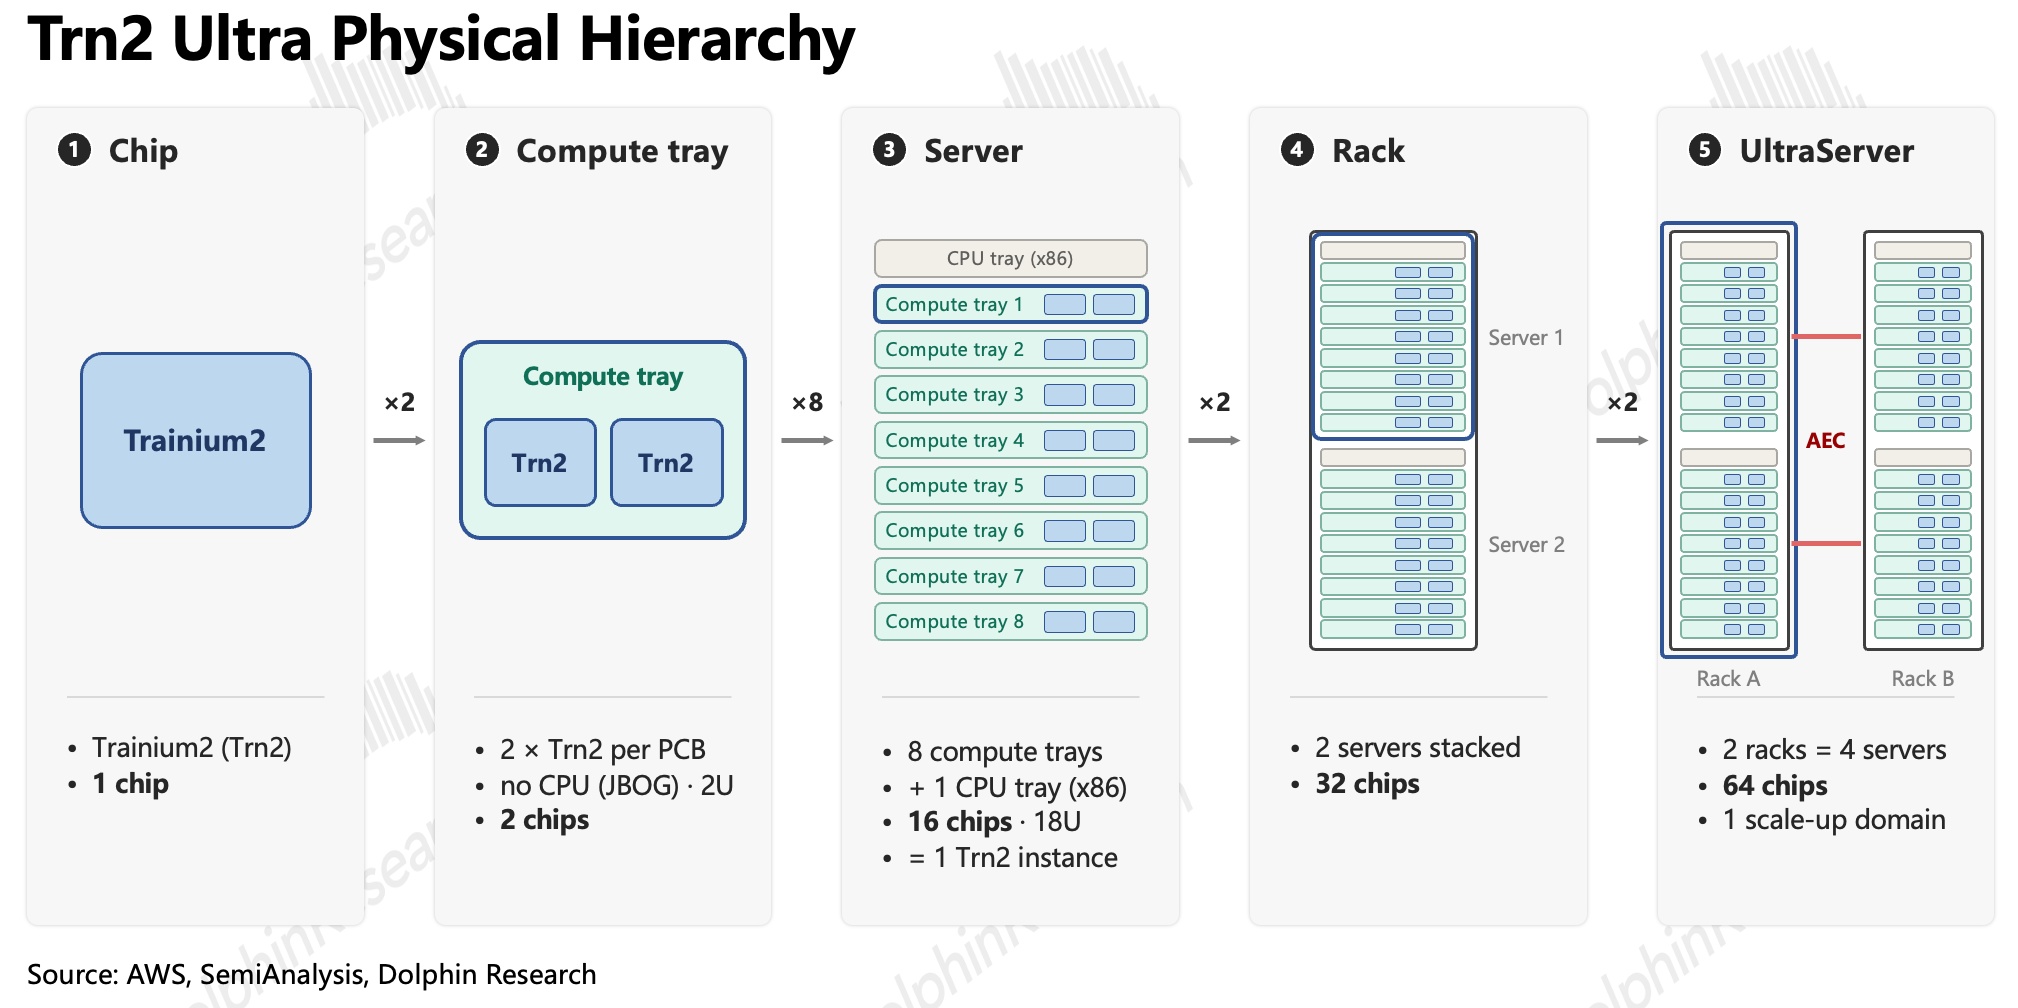
舊款Trn2已非AWS的主推型號,我們簡要介紹。以機架級方案Trn2-Ultra(同代另有16卡的普通Trn2 SKU)為例,物理規格由內而外參見下圖。
1)2D torus如何連接?
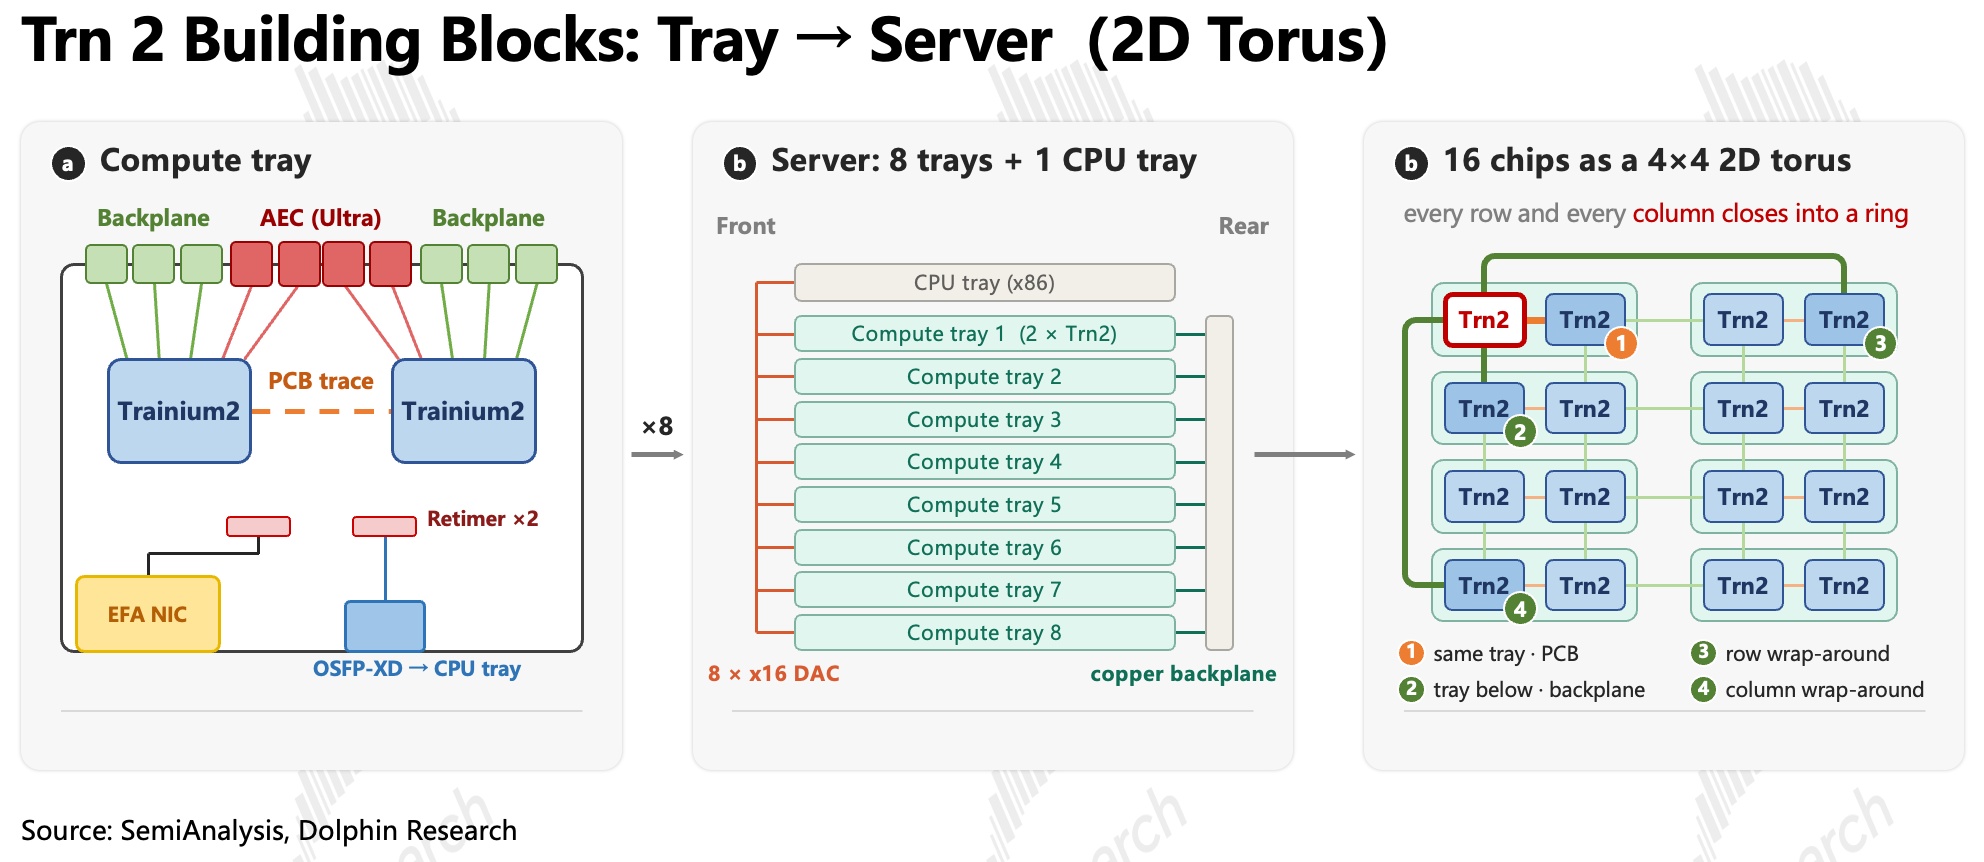
a. Intra-Tray:每個計算托盤裝2顆Trn2,兩卡經PCB走線直連(圖中橙色虛線);
b. Intra-Server:8個計算托盤與1個CPU托盤組成一台16卡服務器,計算托盤之間走機箱後緣的背板銅纜,計算托盤與CPU托盤通過前面板經DAC(無源銅纜)連接。
拓撲:16卡按 4×4相連,每行由 2 個托盤組成、每列跨4個托盤,每一行、每一列都首尾相接成環(正是torus的含義)。
以右圖中紅框芯片為例,它有 4 個直連鄰居:① 同托盤鄰居,走 PCB;② 下方托盤的鄰居,走背板;③ 本行另一端的鄰居,首尾繞回,走背板;④ 本列另一端的鄰居,首尾繞回,走背板。
2)3D torus如何連接?
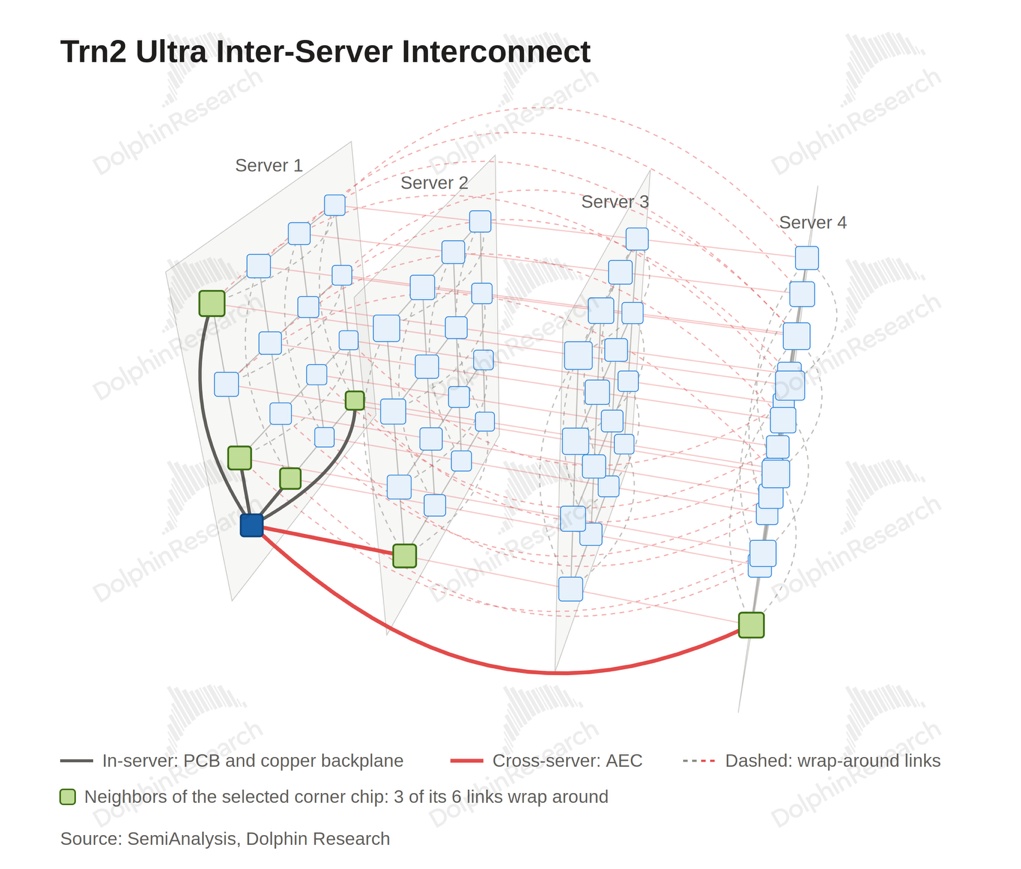
服務器內已經是平面組網,計算托盤內還有4顆OSFP接口籠(上圖a中紅色方塊,通常用於接光模塊或者銅纜),經AEC(有源銅纜,見後文),每台服務器與另外兩台相連,首尾環繞成環,構成3D torus。至此每顆芯片有6個直連鄰居。拓撲如下:
3)和谷歌的3D torus差距在哪兒?
這套4×4×4的3D torus與谷歌 TPU的Cube(谷歌的標準機架形態拓撲,見下圖)形似,核心是迴繞鏈路的走線介質不同:AWS方案中,相鄰托盤及托盤內的走線與谷歌同樣走銅;但迴繞鏈路中,谷歌是通過光纖經光模塊接入OCS,而AWS是通過銅(背板銅纜&AEC)連接的。
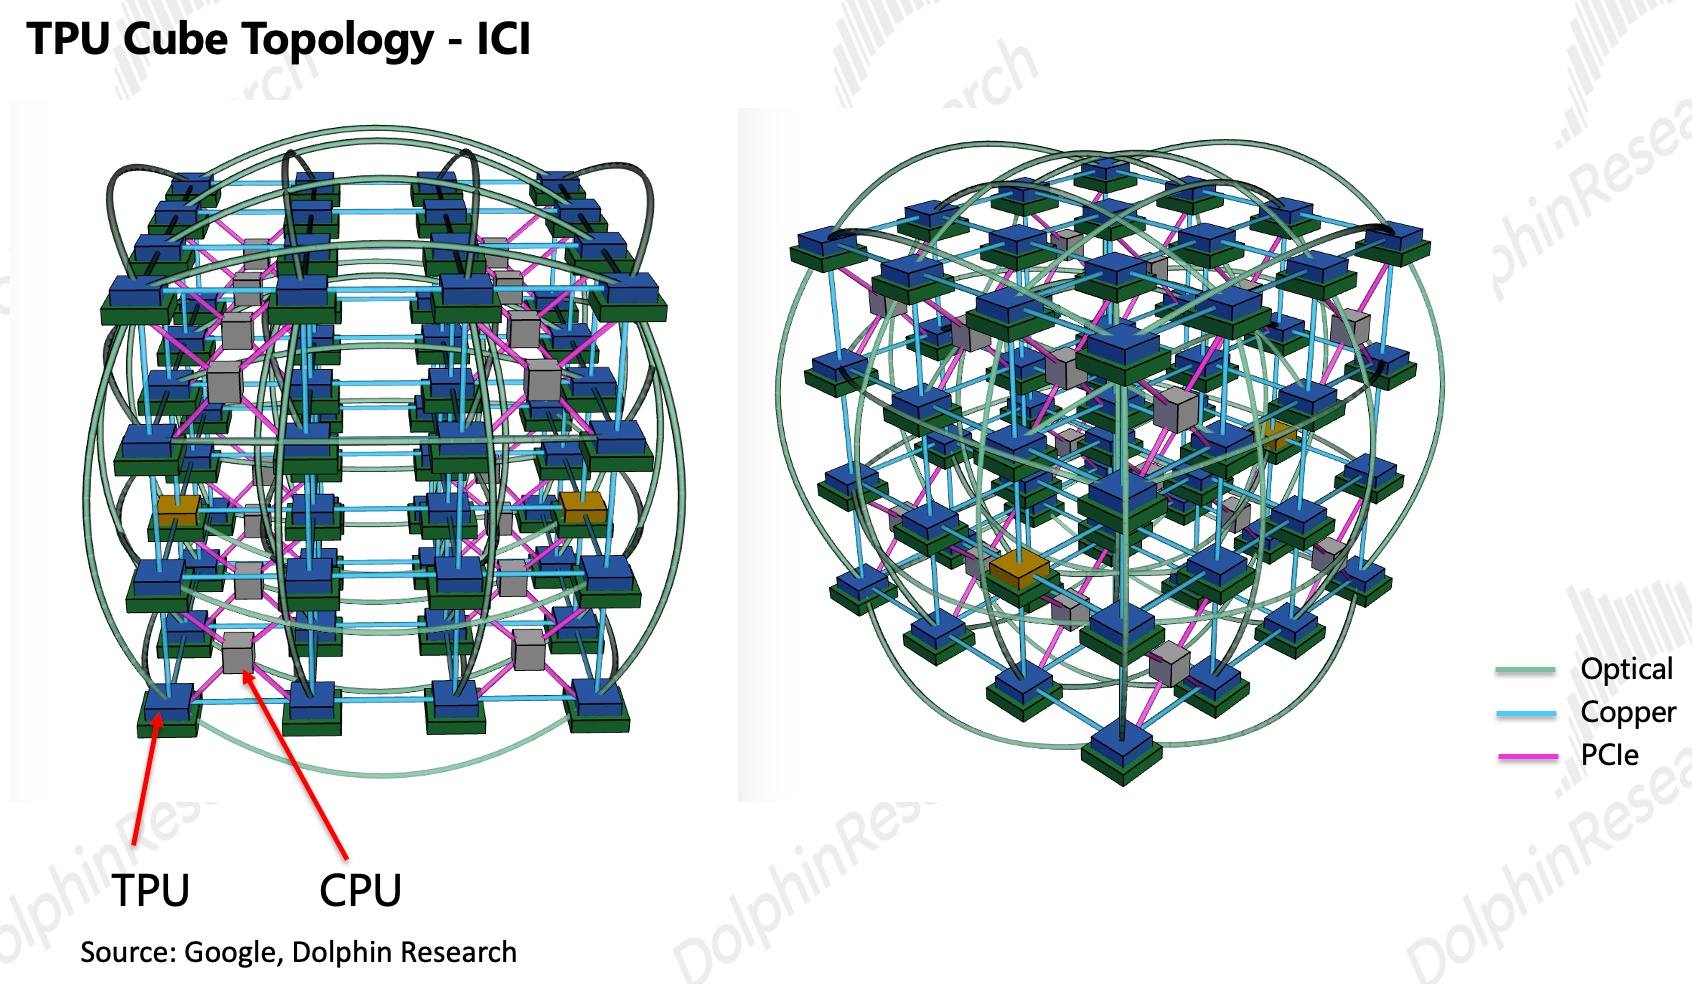
直接後果是域上限僅64卡。谷歌Cube的迴繞鏈路接入OCS後可以通過軟件將Cube靈活拼接,做到近萬卡。Trn2 無交換元件,背板銅纜是固定的,且AEC銅纜拉線有長度上限,無法連更多機櫃。
總的來説,Trn2全部用銅,且無交換的方式做連接導致它的芯片組網大幅受限。上篇説過,谷歌的3D torus 建立在OCS等基礎設施與谷歌軟件棧之上,拓撲和路徑要在任務開始前由軟件配置完成,AWS需要補課的地方太多,又着急投用,因此轉向了交換式。
2、Trn3:「買」出來的交換式
1)與GB300類似的機架形態
以主力機型Trn3 NL72x2為例,該方案基本照搬了英偉達NVL72的交換式架構,包括72卡一櫃,櫃內托盤“三明治式“的擺放等(計算托盤-交換托盤-計算托盤)。
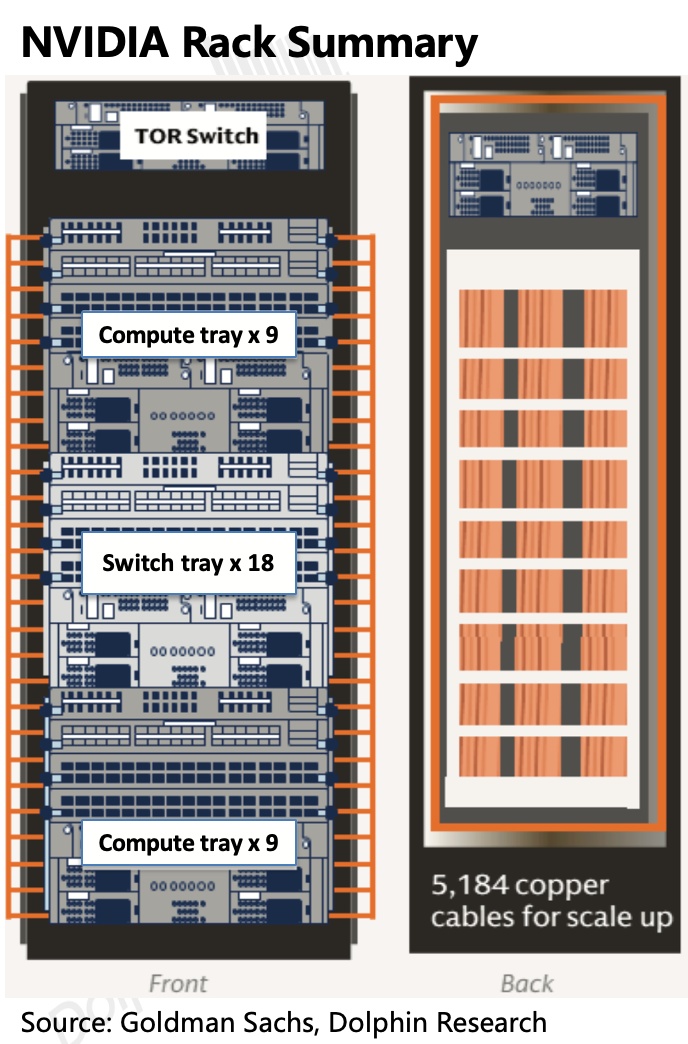
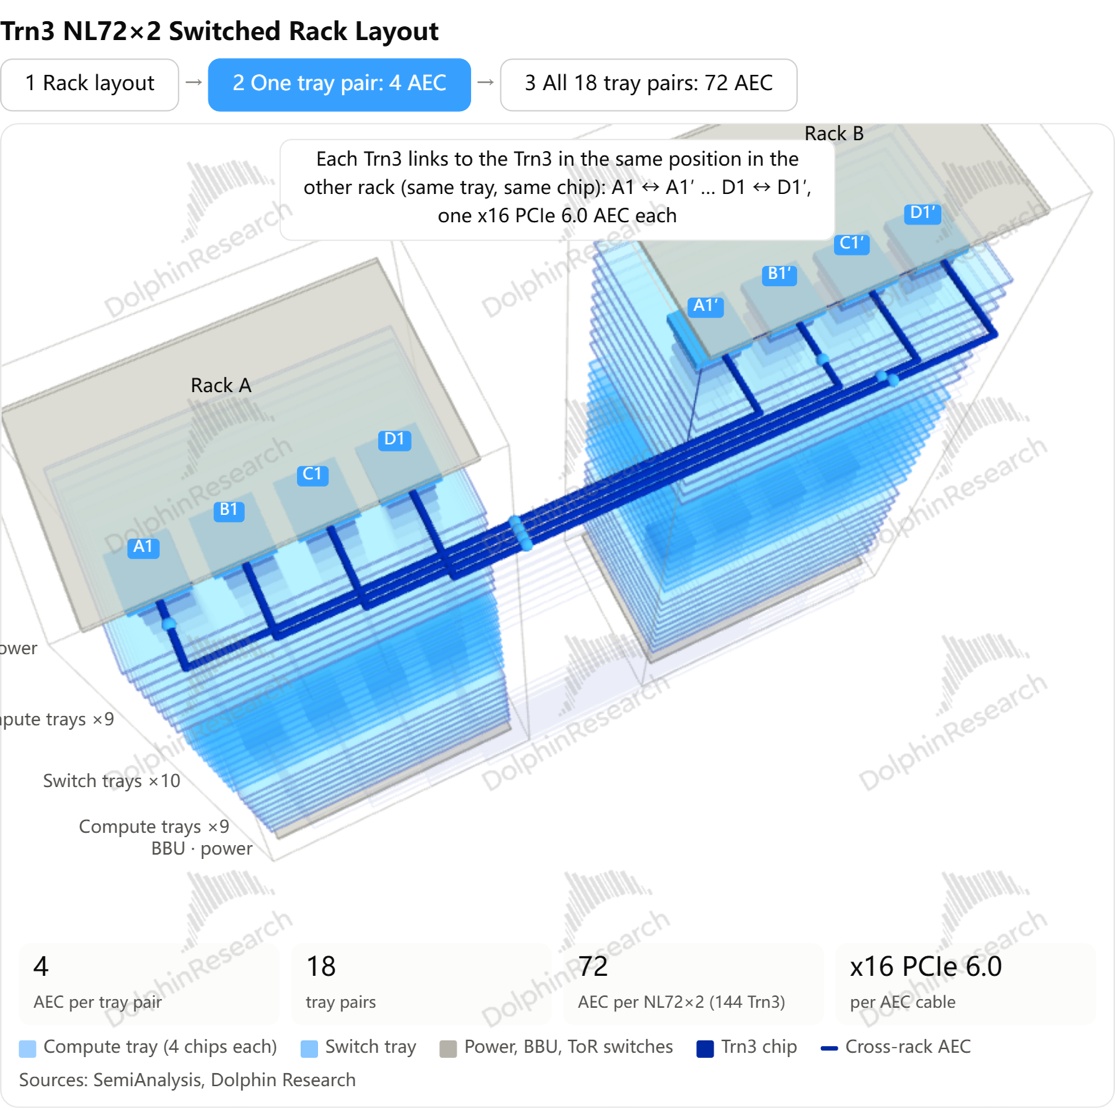
而之所以被稱為Trn3 NL72x2,是因為兩個72卡的機架作為一個可交付的SKU(即144卡的Scale-Up域),機架之間是通過有源銅纜(AEC)連接的。
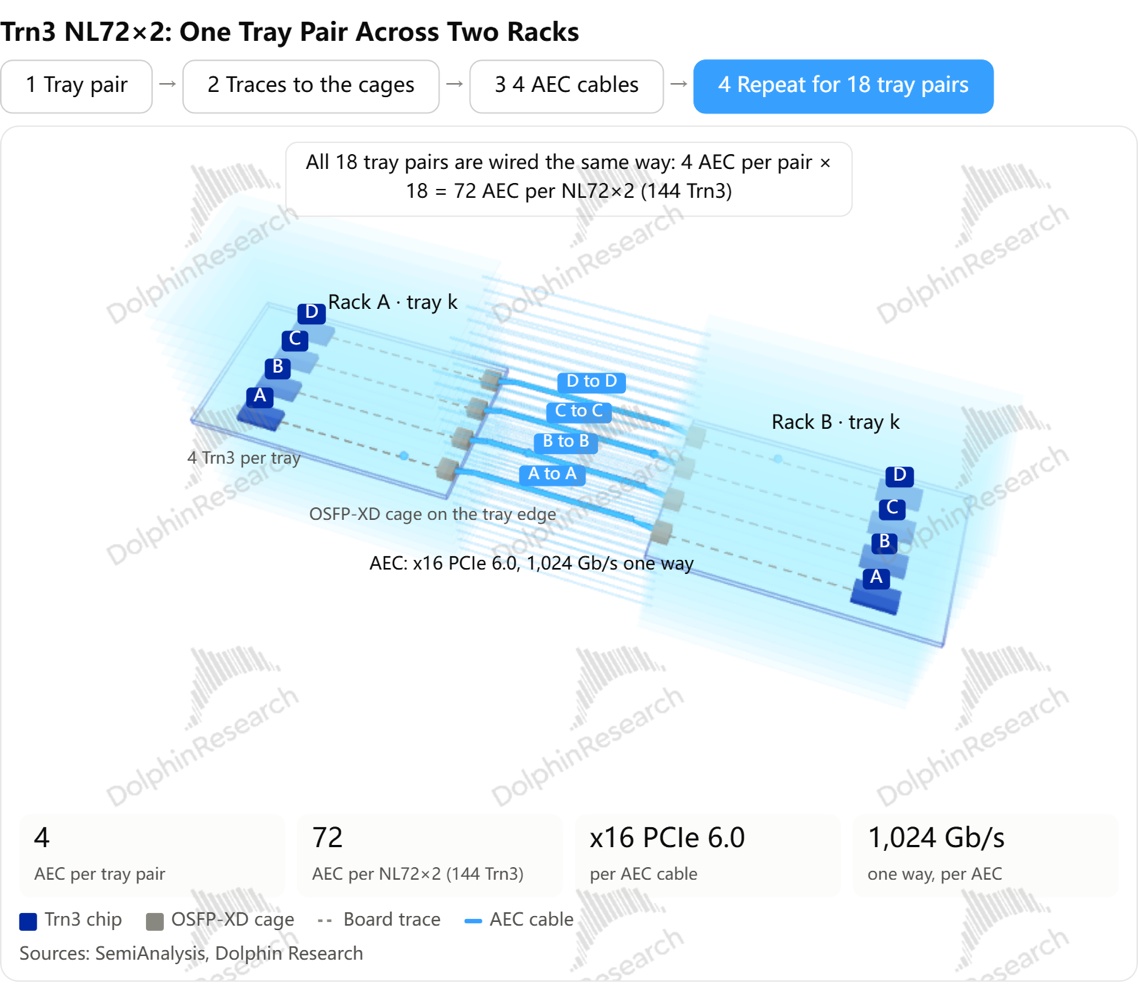
跨櫃使用AEC的原因是,因為無源銅纜物理距離受限,而光模塊又貴又易壞,相鄰機櫃之間的短距連接,AEC確實是合適的選擇。兩櫃之間,機櫃內相對位置相同的芯片通過AEC兩兩直連,如下所示:
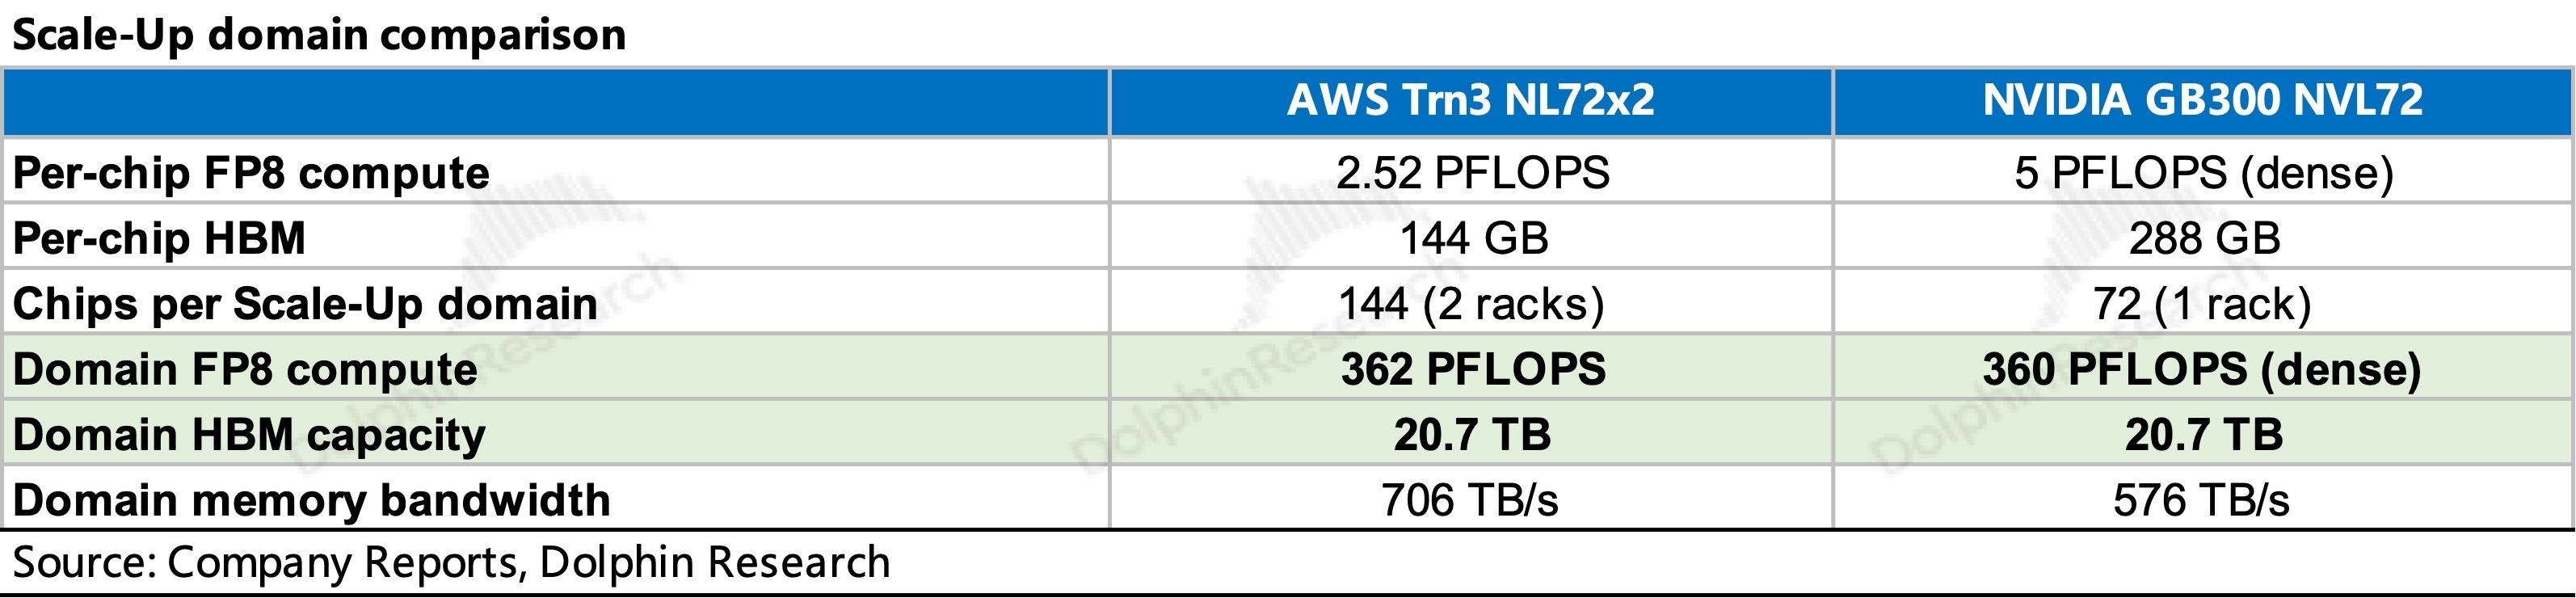
自然的疑問是,為什麼是144卡?核心點在於彌補Trn3弱勢的算力、帶寬性能。如下表所示,Trn3單卡FP8算力約為GB300的一半,兩櫃144顆Trn3在FP8算力與HBM容量上正好對標一櫃GB300 NVL72。
介紹完以上架構設計與整體性能上的類同,更關鍵的問題是,該如何理解Trn3的組網及其差異?
2)如何理解Trn3的組網及其差異?
我們一直強調Trn3是交換式的組網,也就意味着可以參考英偉達的組網來理解。要點是,GB300的Scale-Up(含托盤內/跨托盤)是72卡全互連的,通過機櫃內交換托盤中的NV Switch芯片進行轉發。域內通信僅1跳,延遲極低。具體可參見先前的深度。
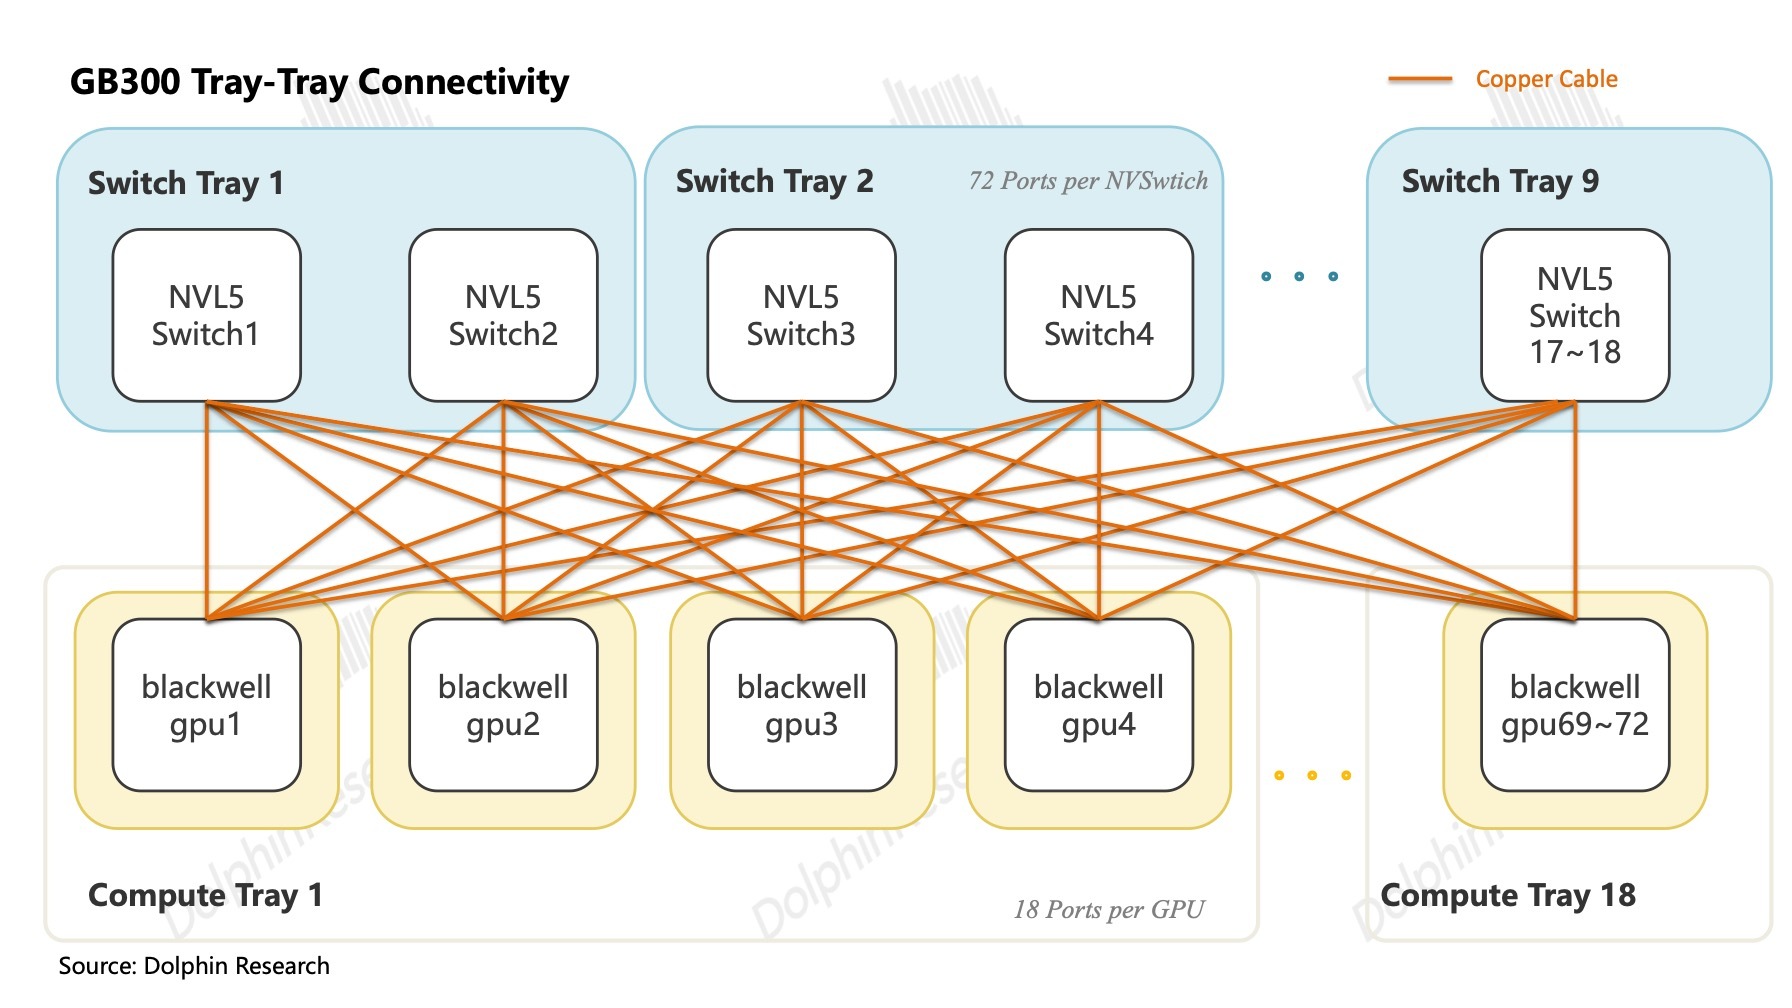
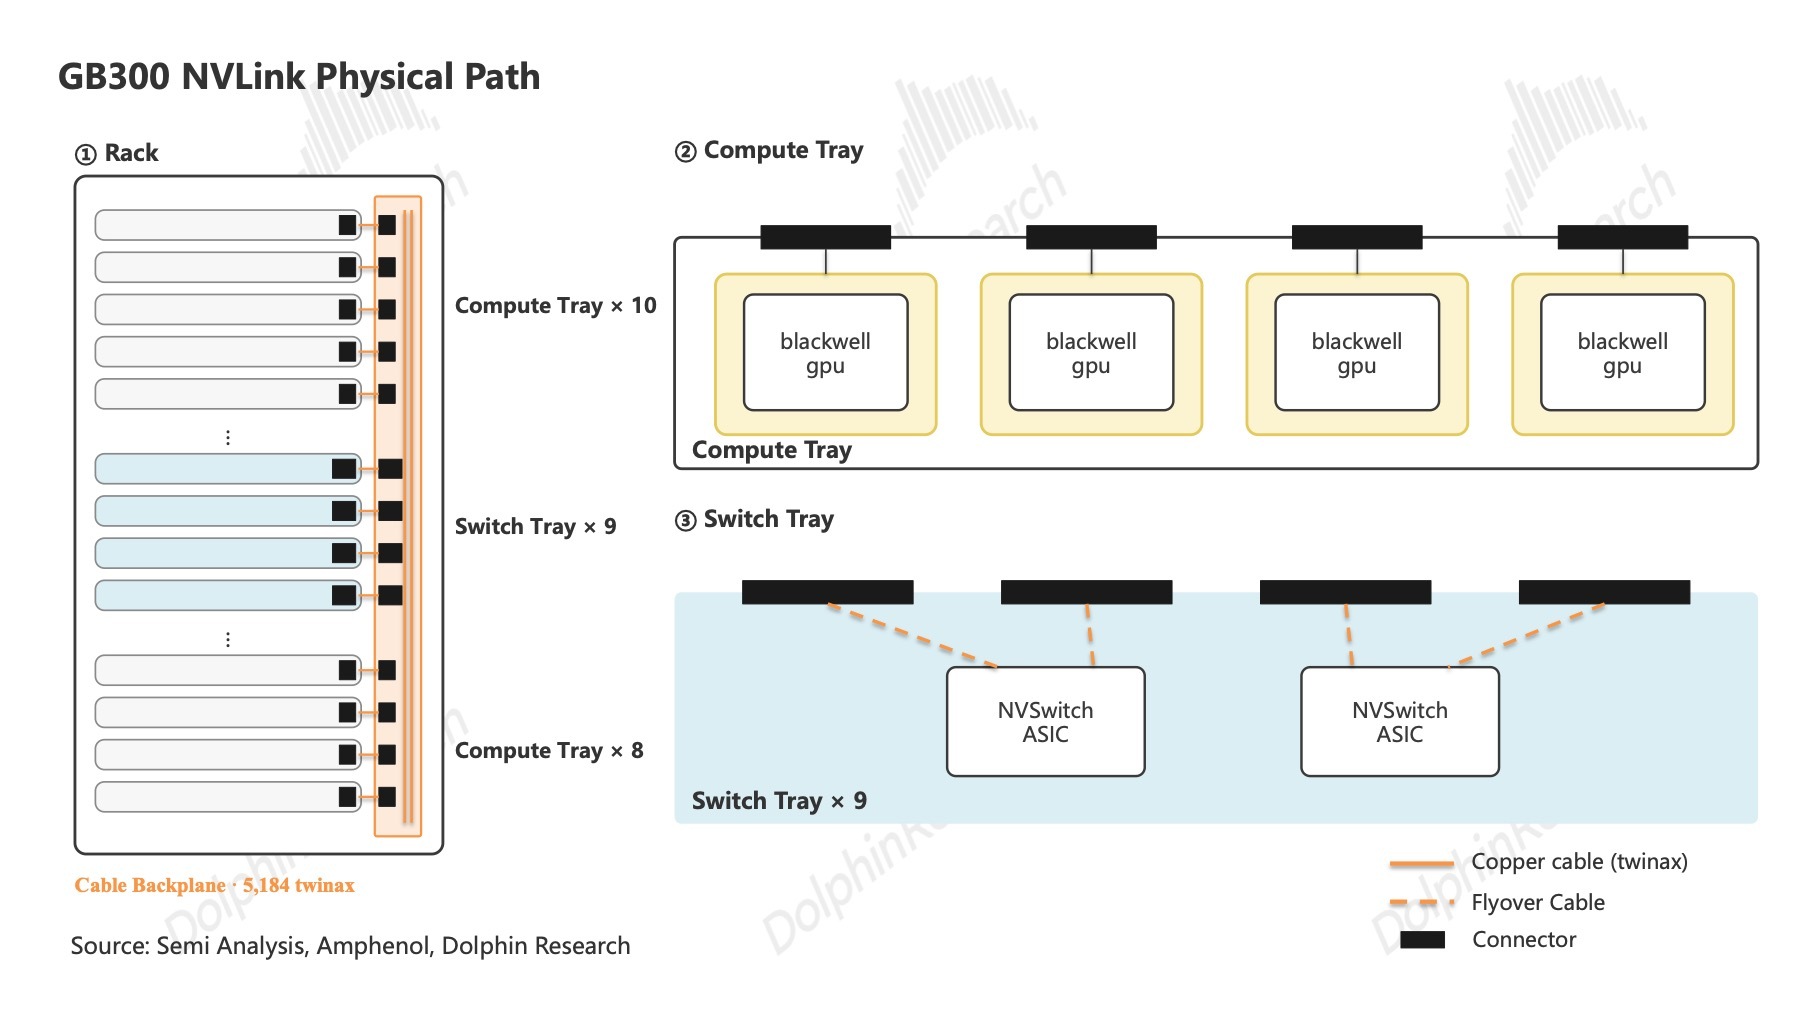
AWS Trn3 Scale-Up域內的互連同樣需要交換芯片的轉發,但目前仍不是全互連的,需要多跳,方案整體的延遲是落後的。那麼,
3)非全互連的交換式組網是如何實現的呢?
計算托盤內部元件如下,需要關注的是紅框內Scale-Up相關元件,此前深度中已有涉及。其中最為核心的差異是,Trn3計算托盤內有8顆Scorpio-P交換ASIC(見下圖PCIe Switch),而GB300內沒有,其交換芯片都外置在交換托盤內。
當然Trn3 NL72x2的機架內也有交換托盤,用的是Scorpio-X交換ASIC。需要兩款交換芯片的原因,將在下文組網部分一同展開。(注: Scorpio-P和Scorpio-X均來自美股半導體公司Astera Labs。)
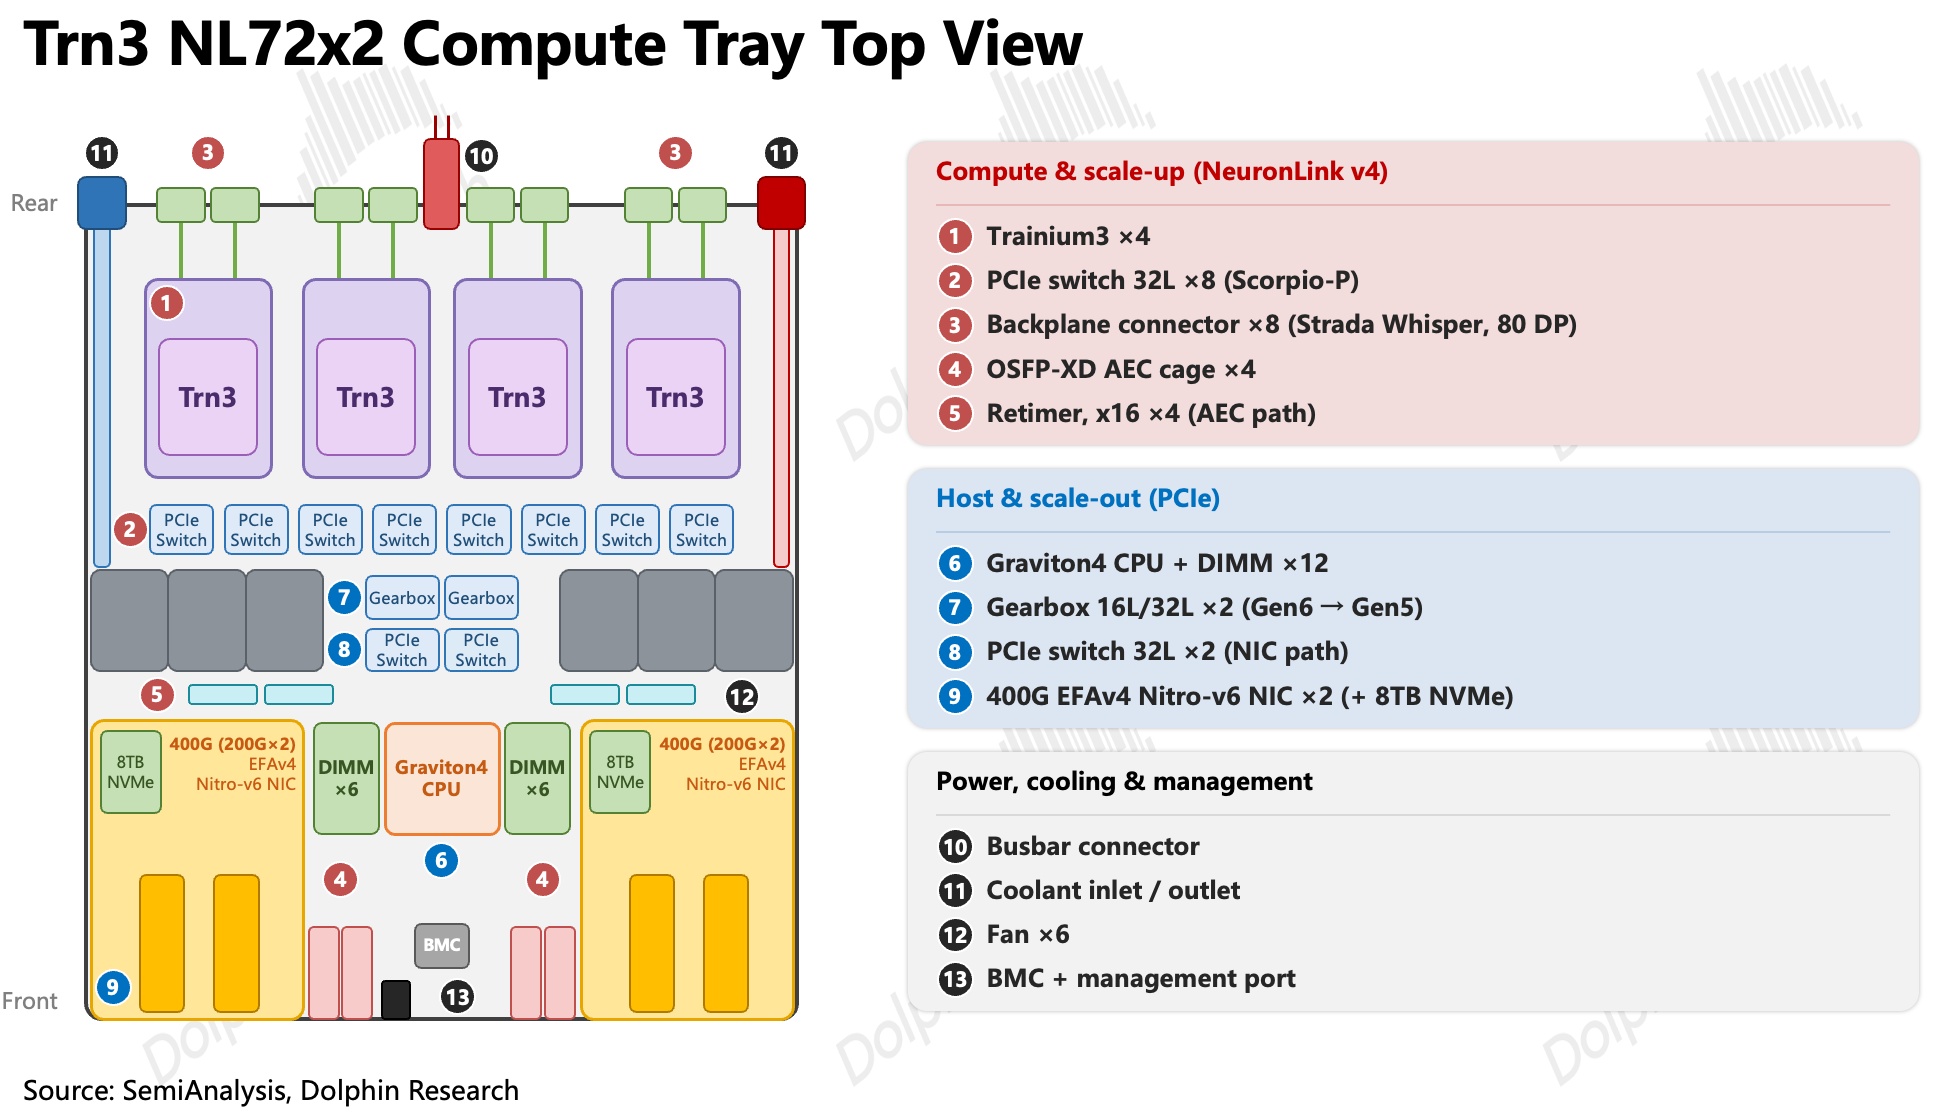
從數據流動的視角來看,GB300的全互連的Scale-Up路徑可簡化成:起始GPU → 背板銅纜 → NVSwitch ASIC → 背板銅纜 → 目標GPU。能做到全互連,關鍵在於一顆 NVSwitch 有72個端口,接滿域內全部 72 顆GPU。
而Trn3的Scorpio-X(交換托盤)只有18個可用端口,只對應18個計算托盤,而一顆交換芯片在每個托盤只能接1顆Trn3。
但單托盤有4顆Trn3,就得搭4個獨立的“垂直天梯”(如下圖)。這樣搭下來,同個天梯上的18顆計算芯實現一跳互聯;但每托盤是四顆芯片,就組成了四條天梯。Scorpio-X端口數太少,天梯之間無直聯通道。
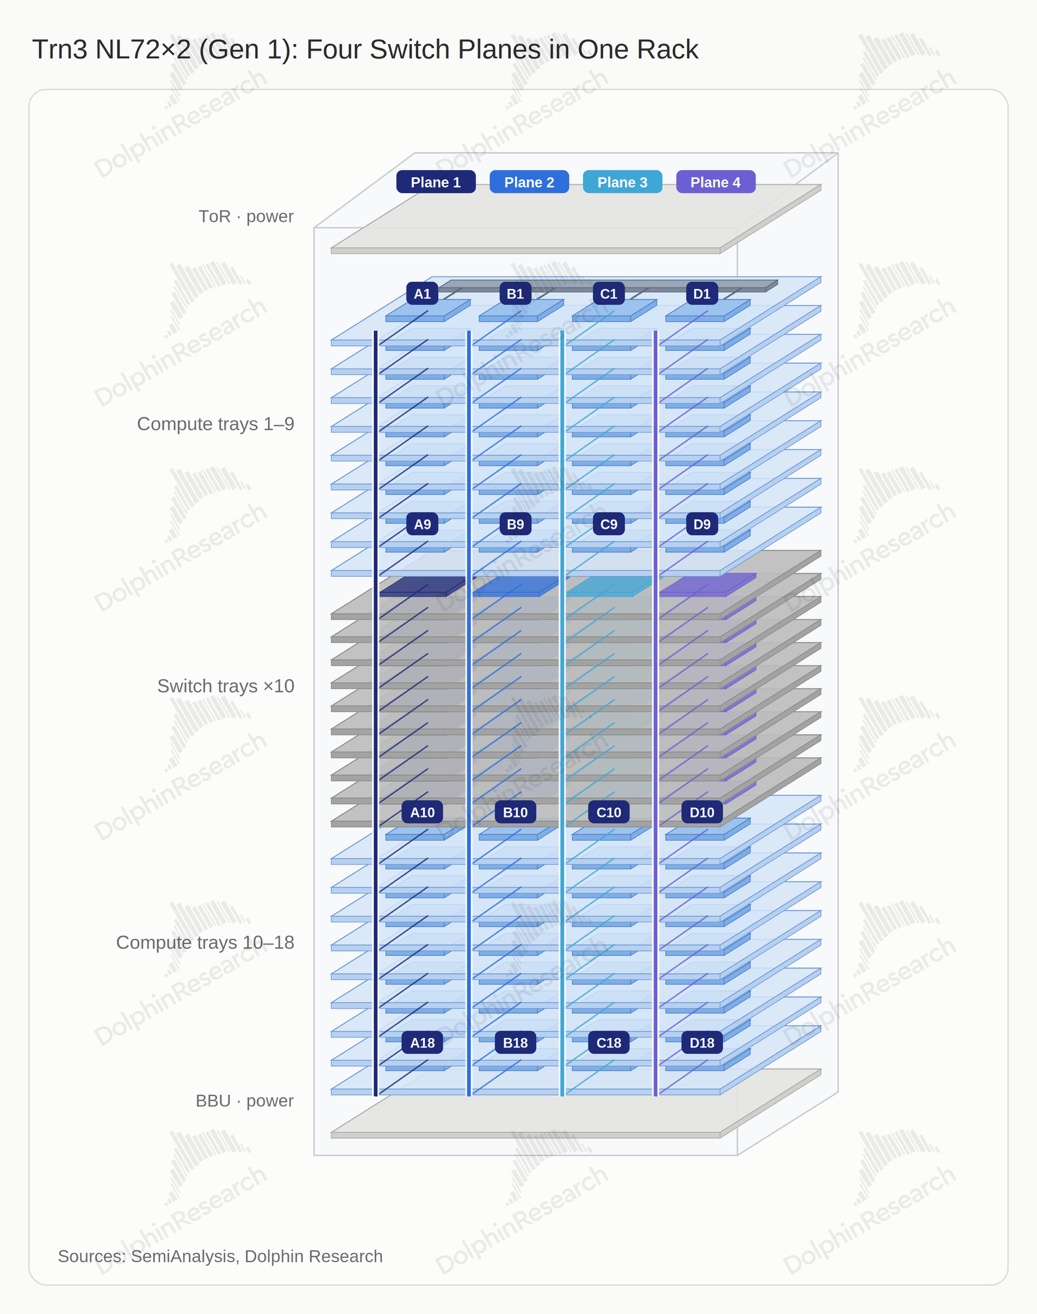
而天梯之間要互聯,就要降到托盤內的8顆 Scorpio-P(見前圖),而之所以用8顆,是托盤間一條天梯內,每個計算芯連10顆交換芯,每交換芯配給計算芯8條通道,合計每計算芯80條通道。
而托盤內每顆交換芯只有 32 條通道,分給盤內 4 顆芯片,每顆只能分到 8 條。用8顆這樣的P交換芯就能配64條通道。等於配上8顆P交換芯的組網,能保持Tray內的一跳,和同天梯內跨Tray一跳保持基本相同的通道速率。
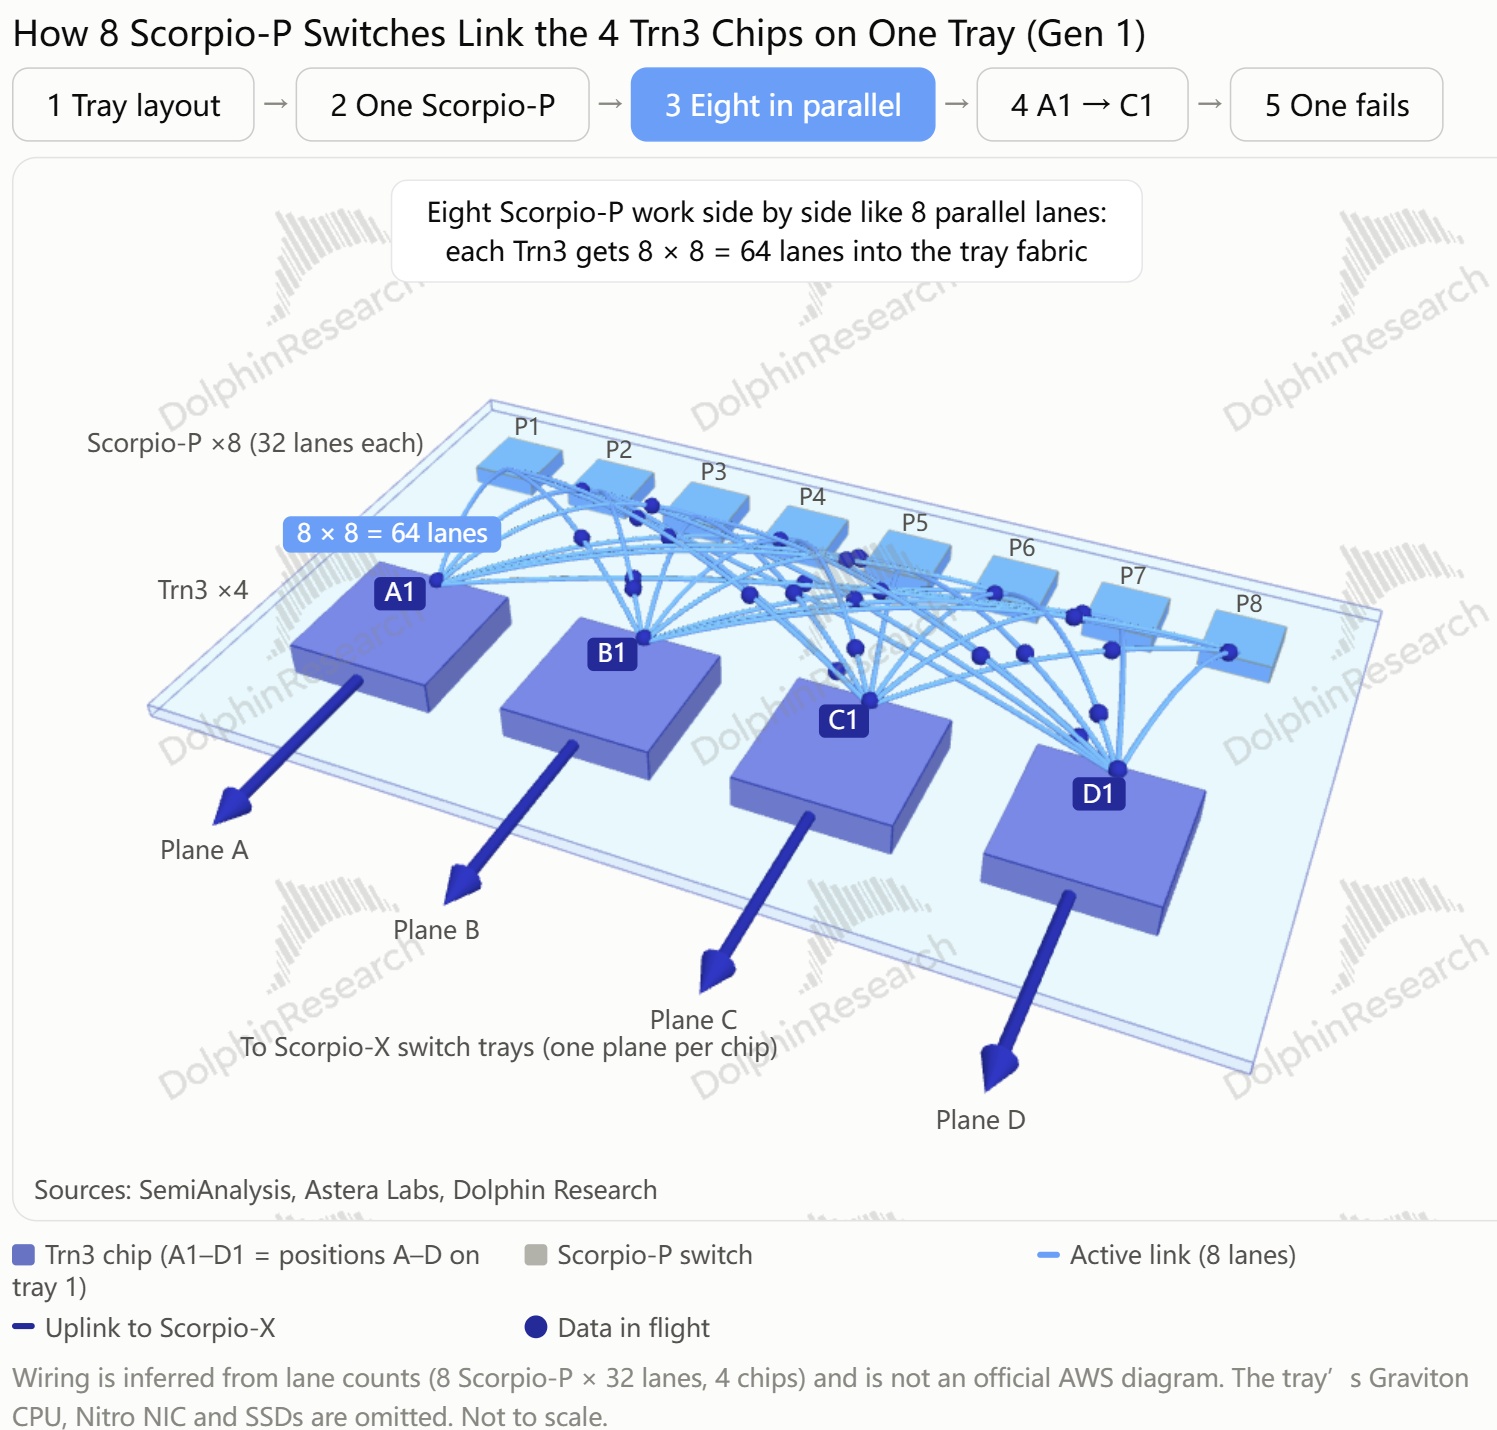
小結一下,Trn3 NL72x2域是通過AEC跨櫃構成的,其櫃內類似GB300交換式的通信由於交換托盤內的交換ASIC端口數少,組網是多平面的,因此在計算托盤與交換托盤內都存在交換芯片,尚未實現全互連。
4)跨櫃:交換芯+跨櫃的拖累
海豚君在谷歌的深度中已經指出了多跳帶來的延遲影響,其在v8i(面向推理場景)的組網也優化了跳數。那麼在Trn3 NL72x2域內,跳數(延遲)如何呢?
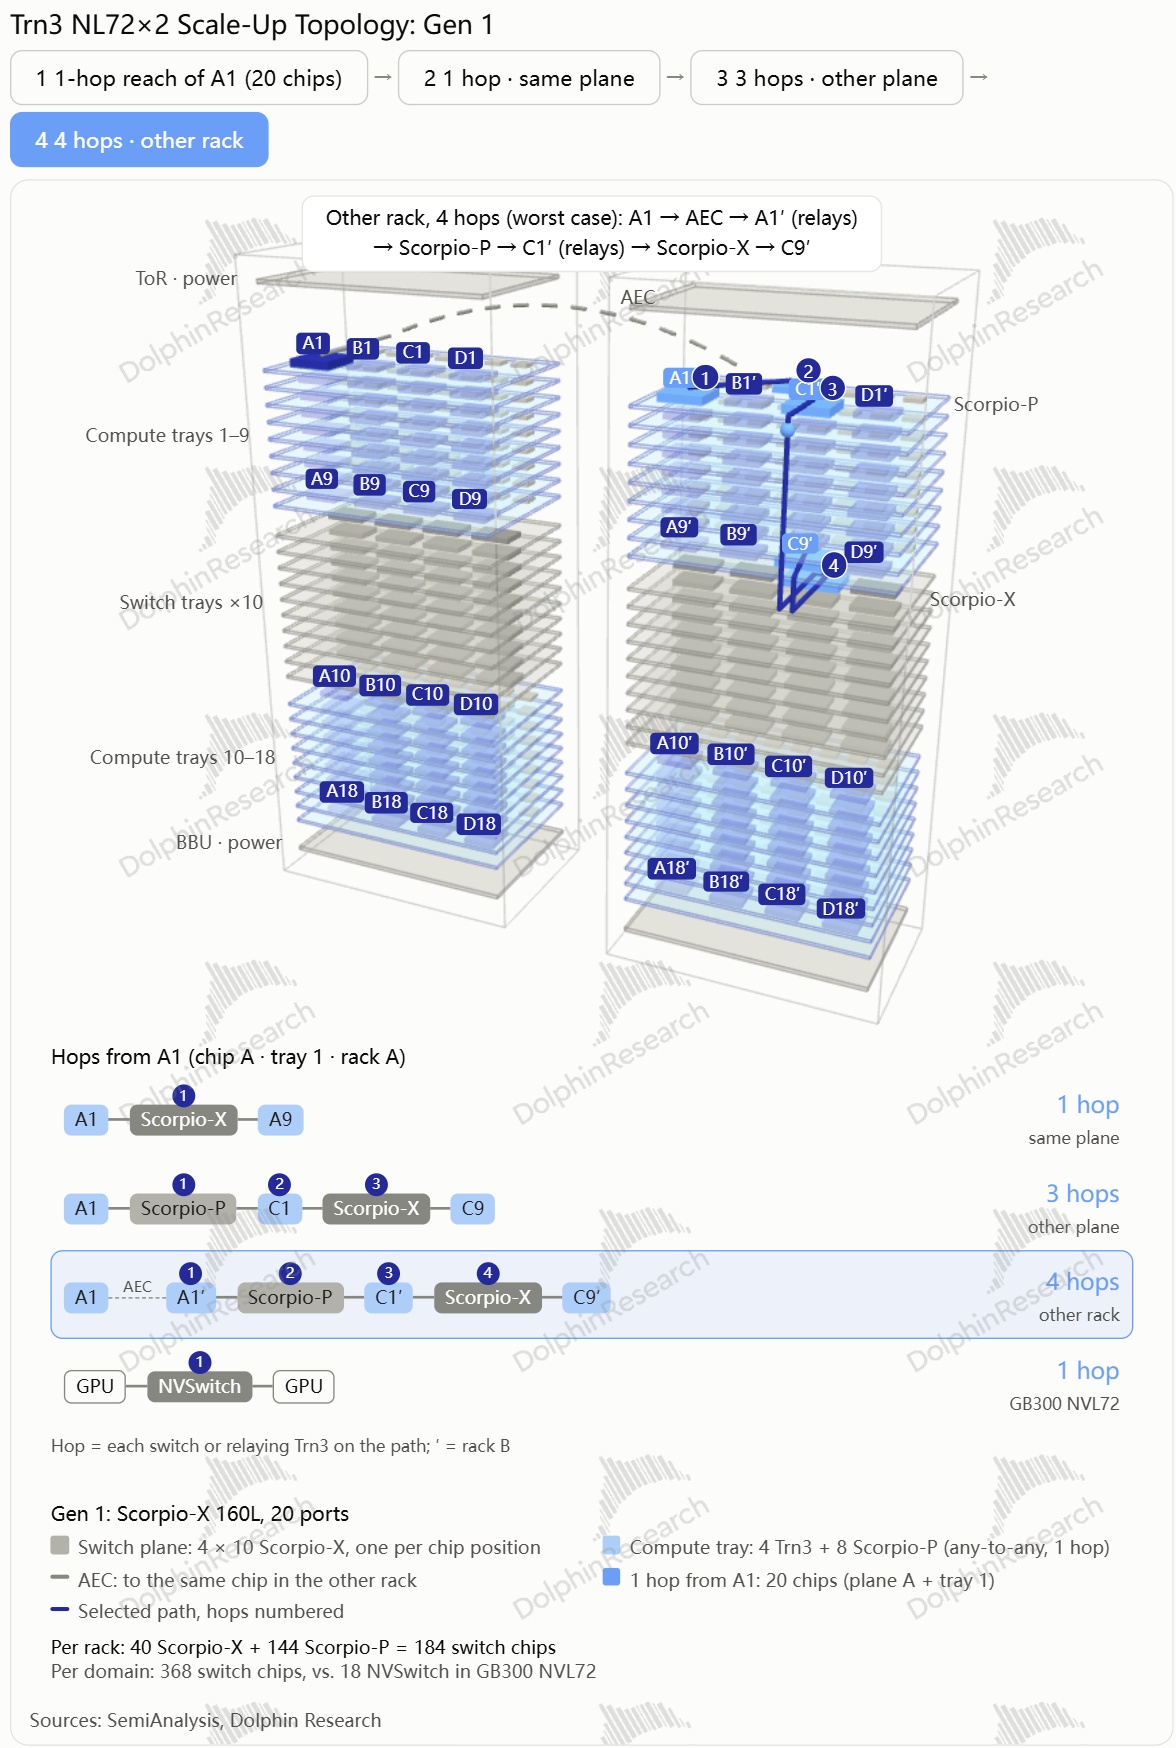
如圖,以機櫃A托盤1的芯片A1,跨越機櫃B,到達C9:到托盤9的A9同在一個平面,經Scorpio-X直達,1跳;到C9要先經Scorpio-P借道另一顆芯片換到C所在平面,3跳;到機櫃B的C9′還要再多一次跨櫃中轉,4跳。
5)如何補課?等標品的端口數長上來
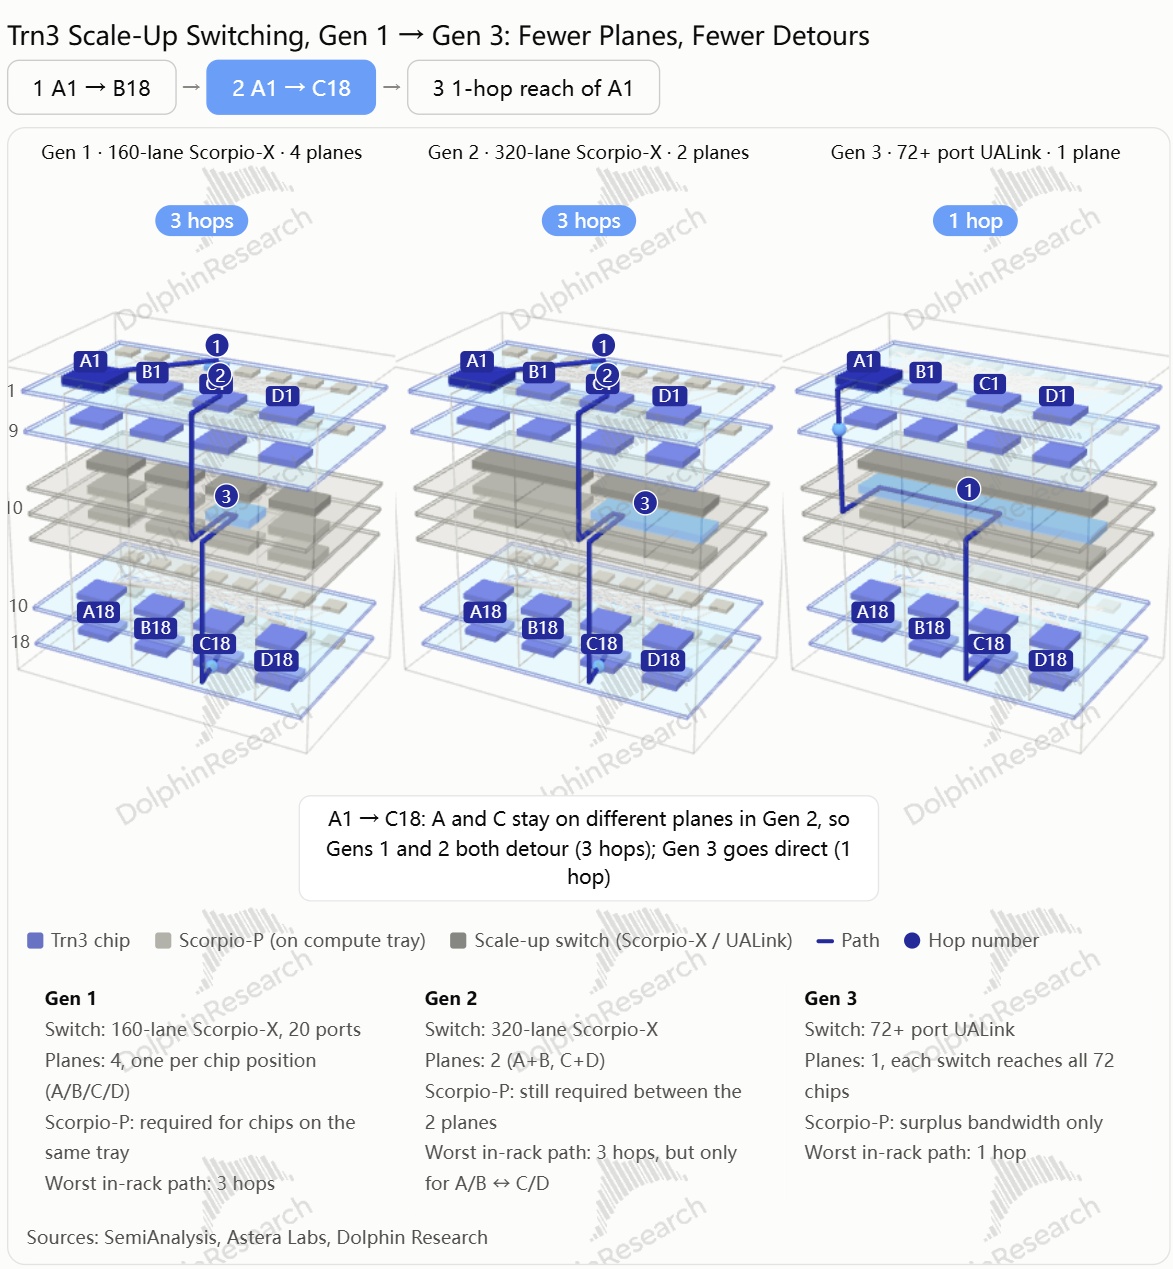
交換側的多跳、多平面,都由於交換芯片的端口數過少。AWS的解法是Trn3生命週期內需迭代三代,但只替換交換托盤裏的交換ASIC(Scorpio-X),直到採用第三代UALink才降到櫃內1跳。
a. 一代,160通道Scorpio-X PCIe 6.0:每櫃 4 平面,櫃內最長路徑 3 跳、跨櫃 4 跳;
b. 二代,320通道Scorpio-X PCIe 6.0:端口翻倍,平面由4個減為2個,托盤內相鄰芯片仍經 Scorpio-P互連;
c. 三代,72+端口 UALink 交換機:每顆交換機可接櫃內每一顆 Trn3,櫃內變全互連,實現1跳,但跨櫃仍需兩跳。跳數減少將拉低整體延遲。而計算托盤內的交換芯片不再是必經的中轉,但仍然在成本側。
3、小結:跑得快,但跑得遠嗎?
可以看到,AWS的組網並不依靠自研求差異化和高性能,而是撿市面上立即可用的標準件,低成本組網,其實就是圖省事的火速投用。
Scale-Up 層:
- 協議層面,基於PCIe的NeuronLink是圖省事的做法,中長期看是會被取代的。
- 組網上,由於3D torus的大規模組網對廠商軟件以及網絡基礎設施的要求較高,AWS被迫轉向交換式連接。
但作為核心硬件的交換芯片採用的是標品,端口少,即便採取了交換式拓撲仍然需要多跳,跳數改善要等高端口數的交換機出貨。
Scale-Out 層:每卡Scale-Out帶寬僅200Gb/s,近兩代無提升;交換芯片同樣外採。
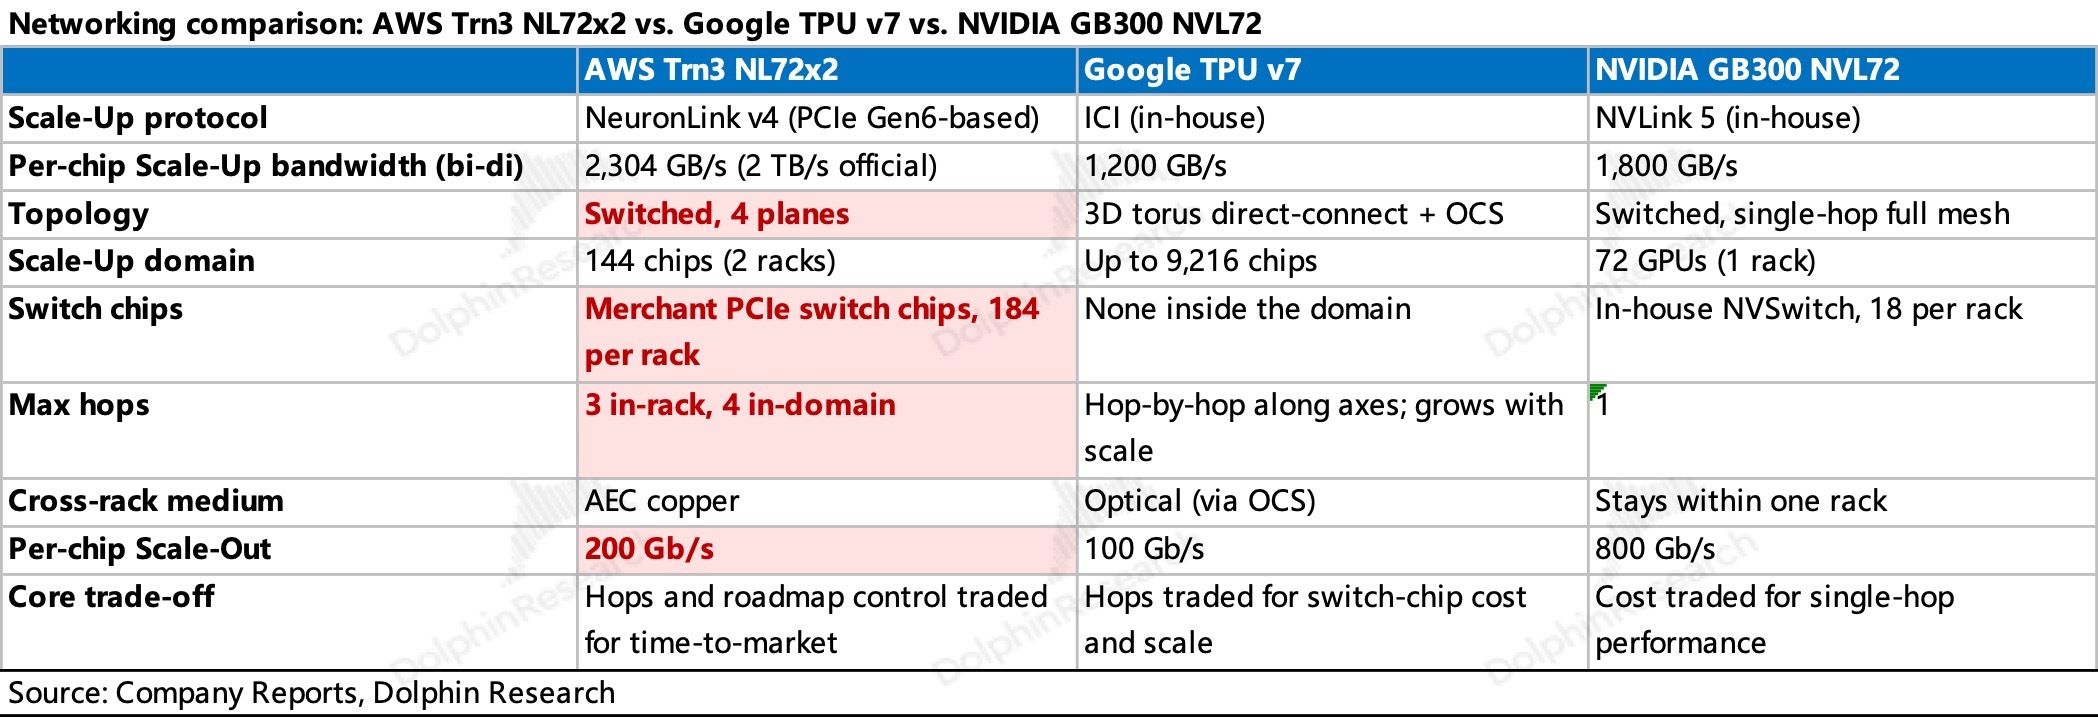
換言之,AWS 的組網缺乏自主權,其端口數、跳數、升級節奏都取決於供應商。因此,單論組網,AWS既沒有英偉達的性能,也沒有谷歌的規模,競爭力並不強。
中長期看,Trn3仍在等着UALink交換機的出貨,那麼Trn4的組網相較於其它廠商的組網方案差距可能會進一步拉大。
三、AWS鏈的機會在哪裏?
如上所述,AWS不是奔着打贏英偉達、AMD、谷歌去的。接下來我們來探究下其產業鏈的機會在何處。
1、組網真的便宜嗎?
AWS組網硬件多為採買標品,或許不必為定製化支付溢價。
NL72x2的單域(即雙機架)組網成本測算如下:
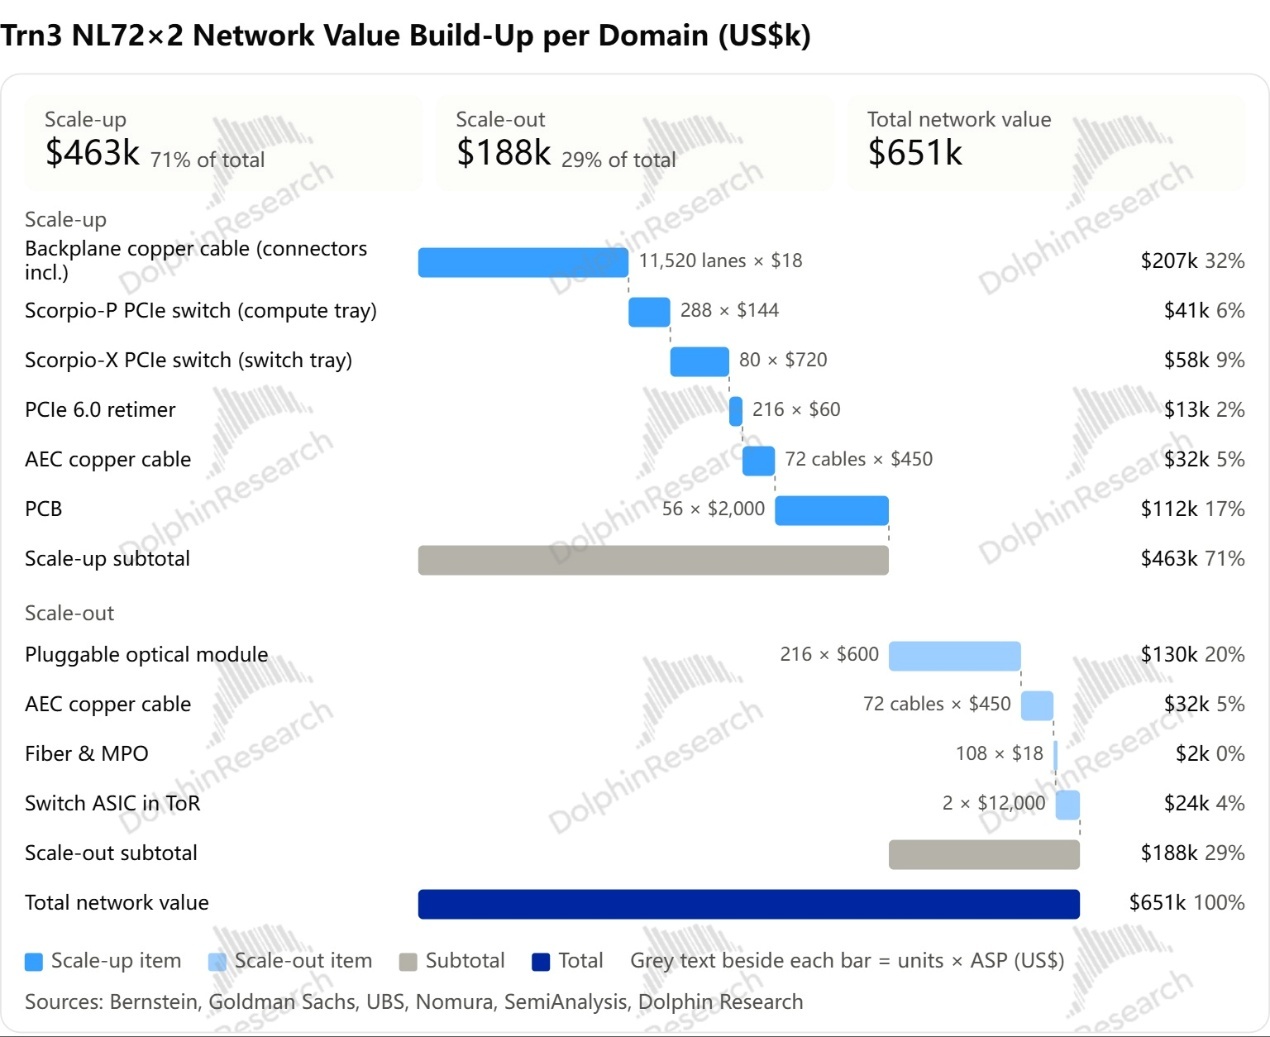
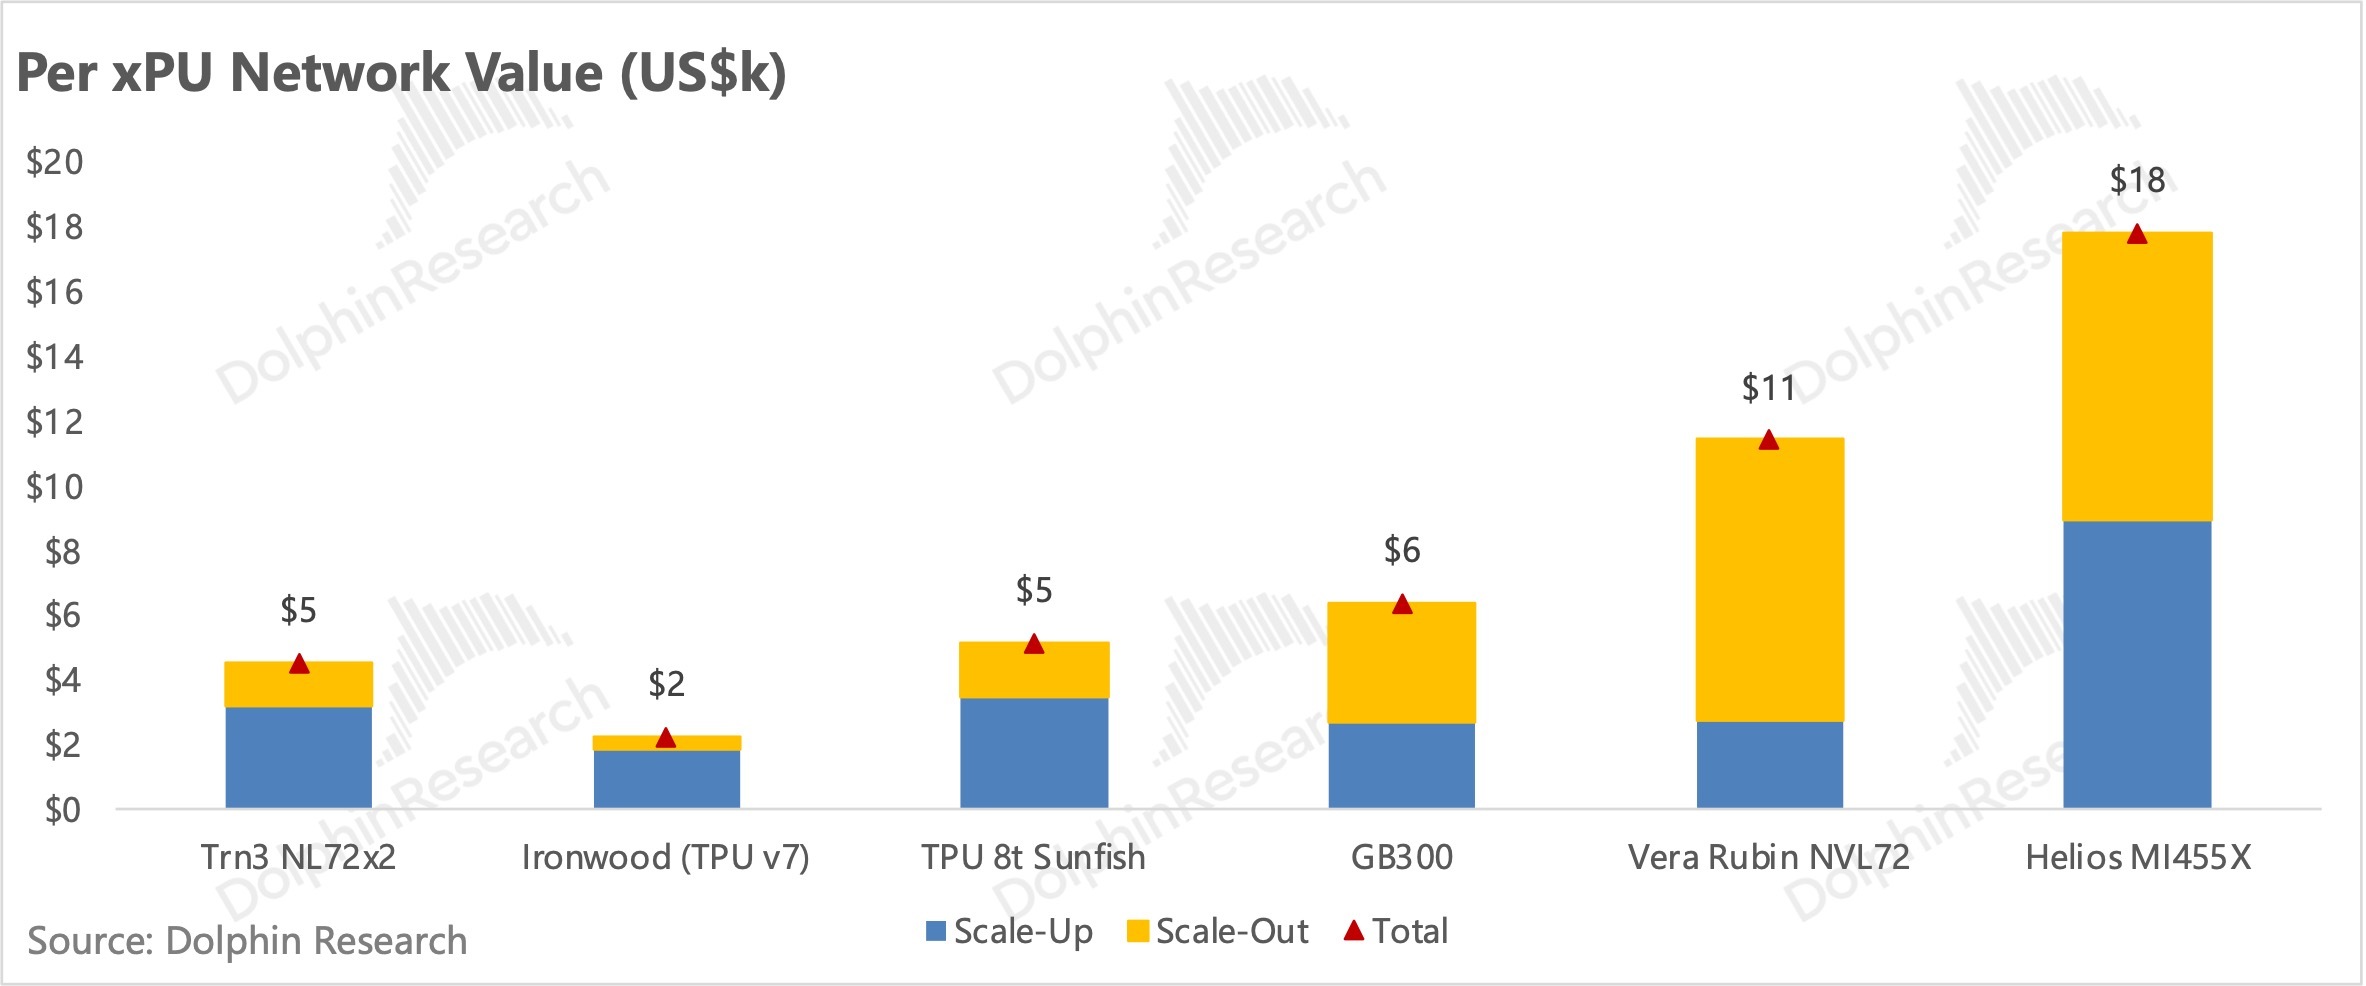
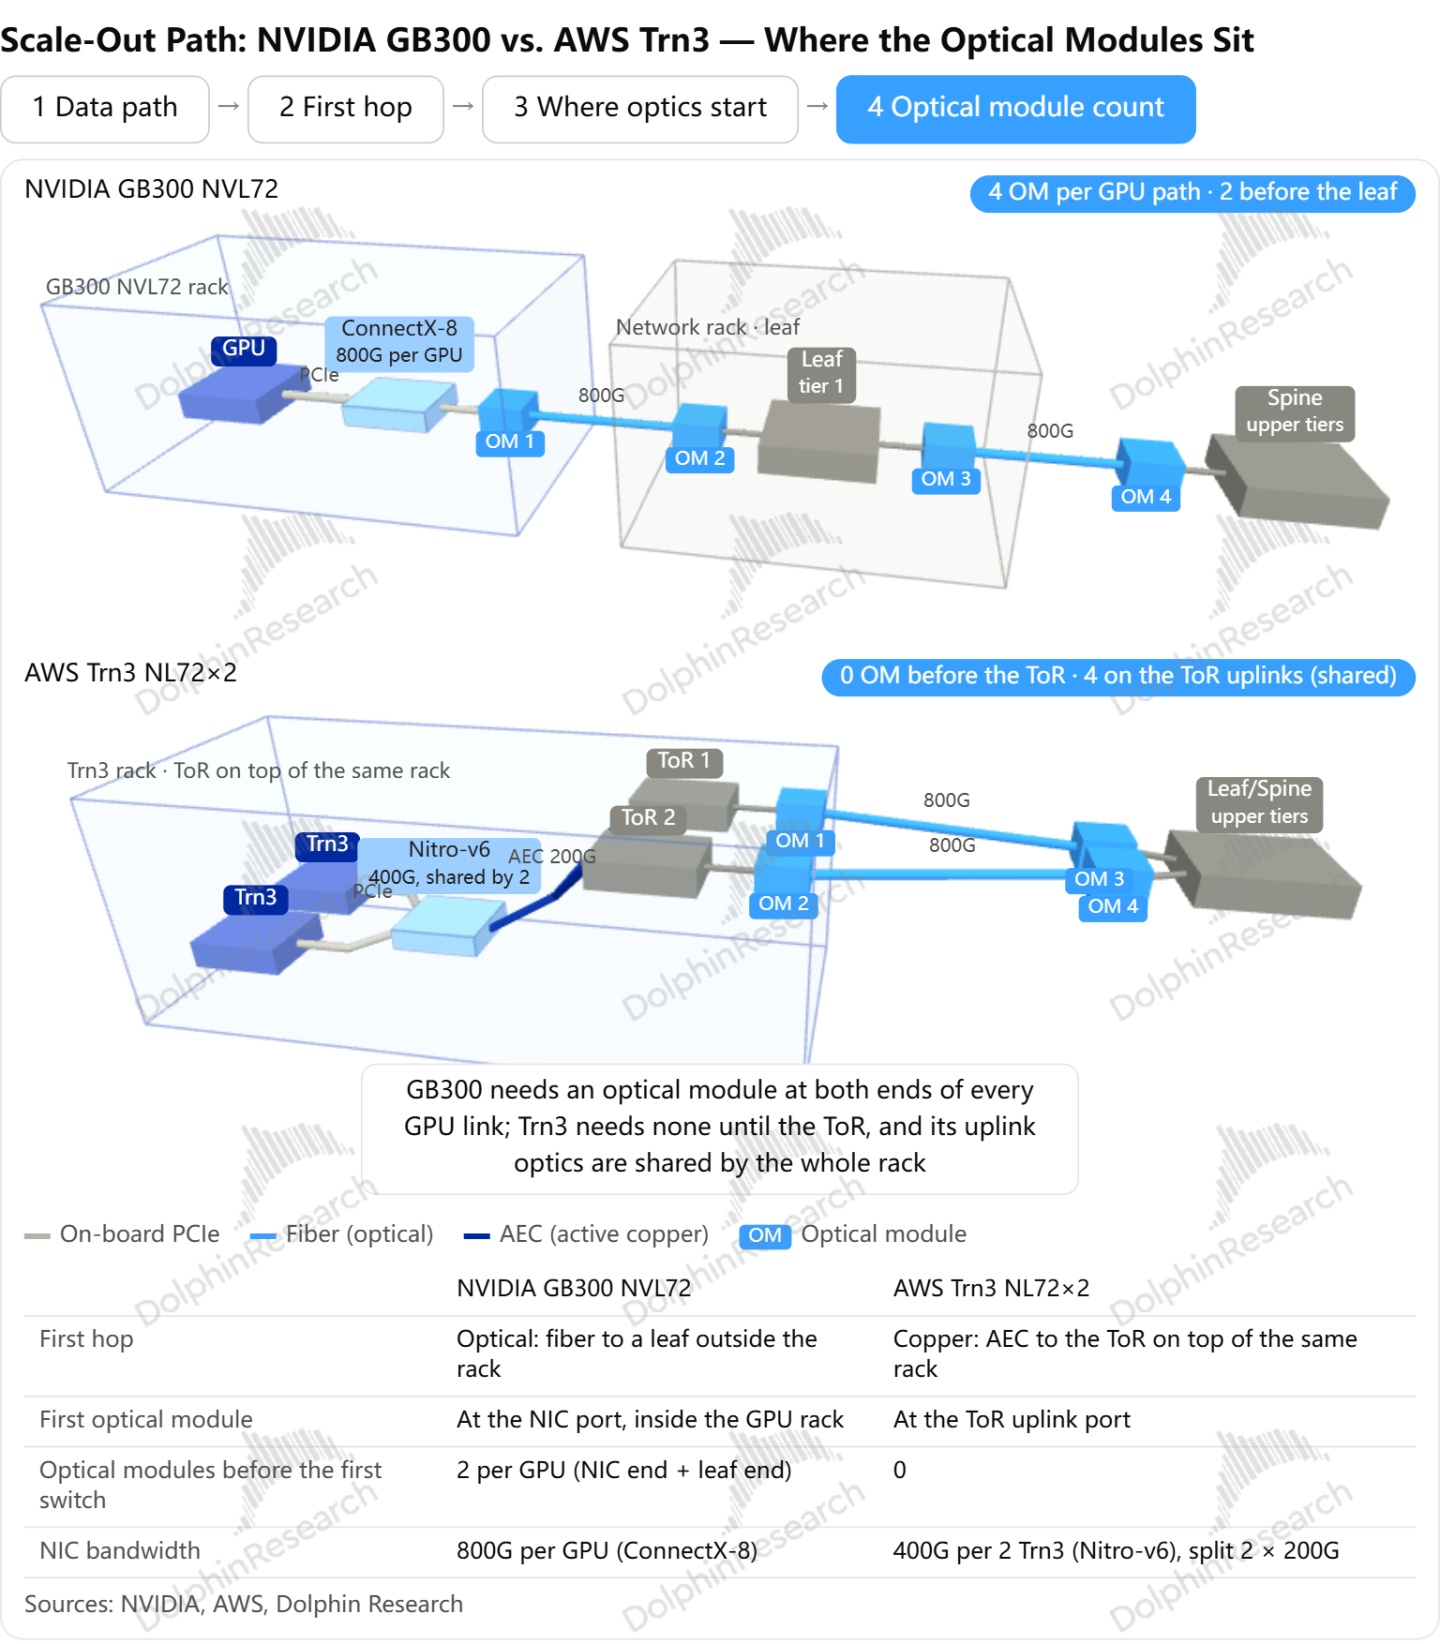
初看單卡組網成本,AWS的策略是成功的,機櫃形態基本對標GB300,單卡組網成本卻更低。省下的錢主要來自 Scale-Out側光模塊的節省:主要是省去了網卡與ToR層的光模塊。Trn3的Scale-Out流量先經AEC銅纜接到櫃頂部的兩台ToR交換機,因此光模塊只出現在ToR層及以上的鏈路。
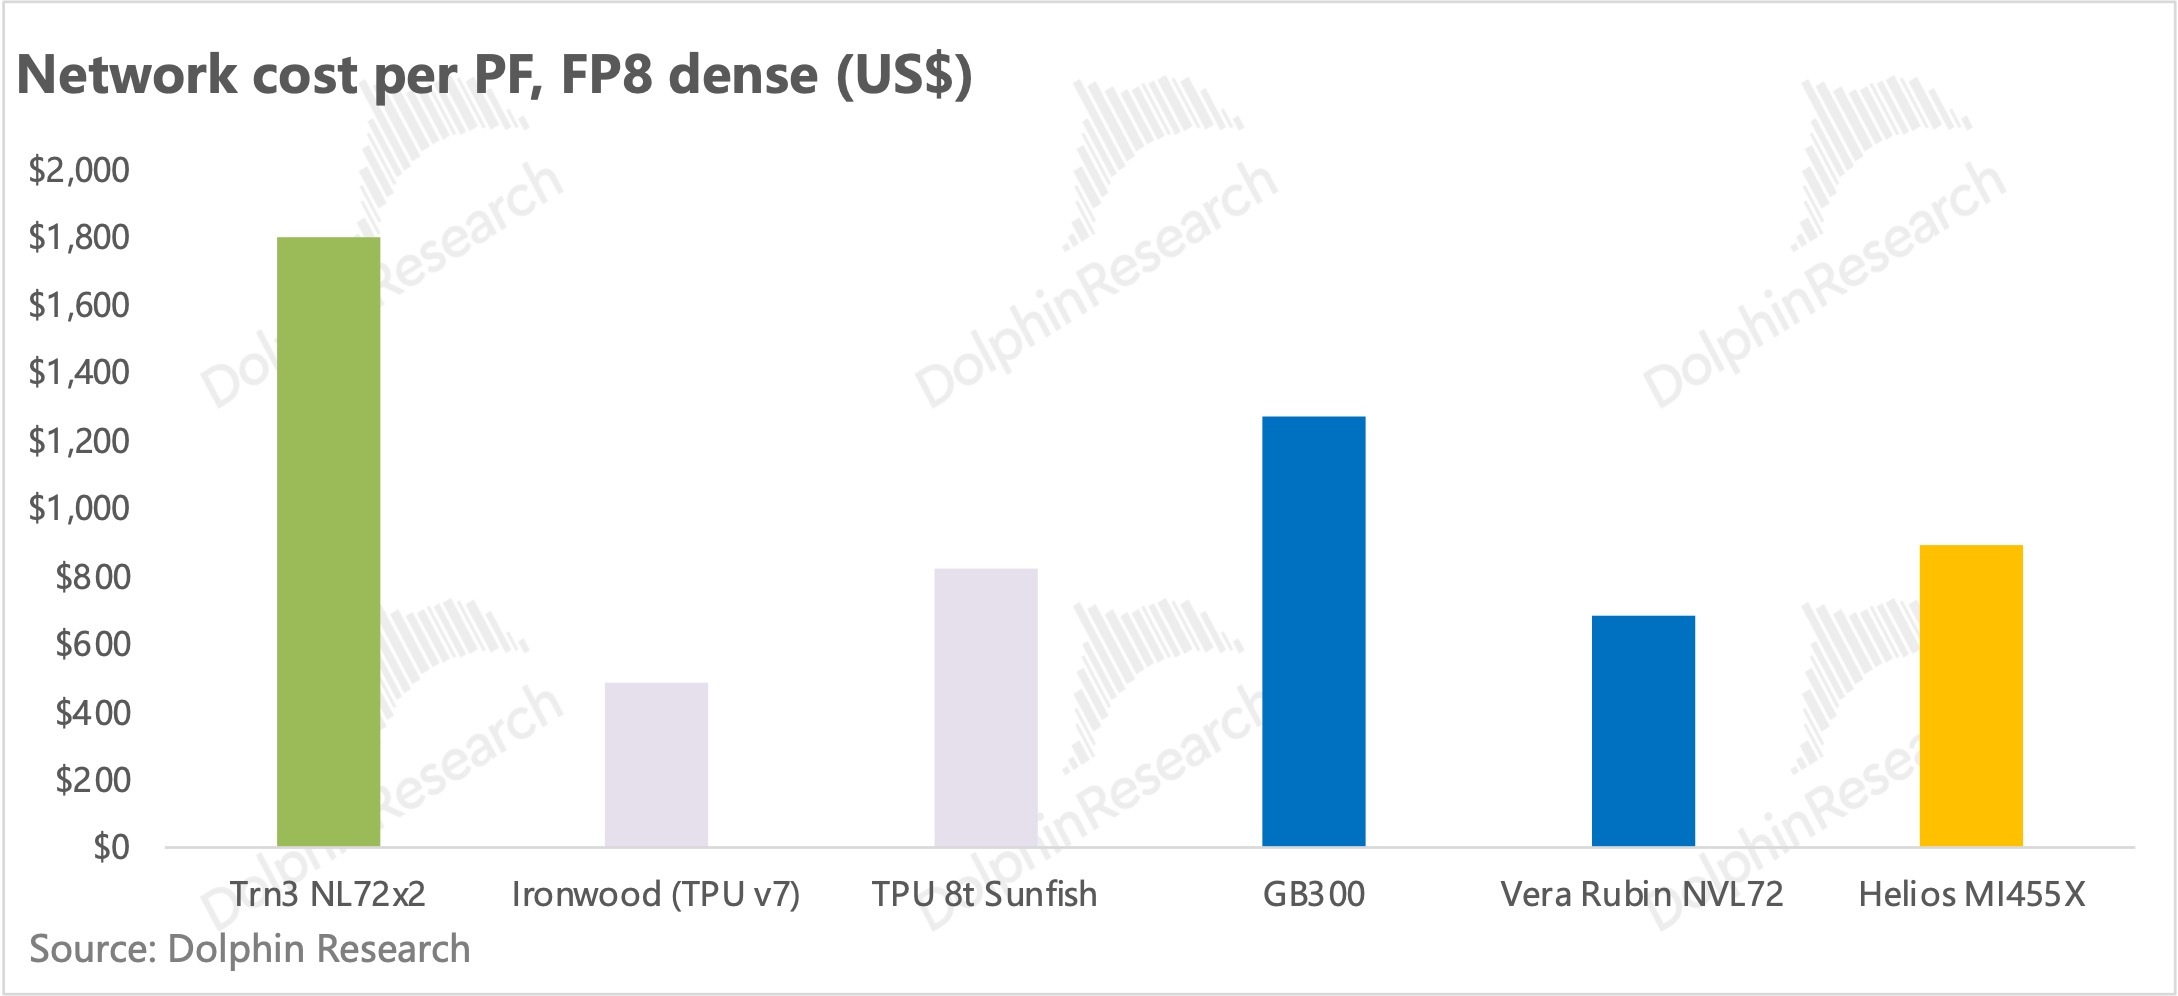
若折算到同等算力,結論與上文一致,Trn3的組網性價比不高,競爭力並不強。
2、如何看待產業鏈機會?
AWS對標品的採買,除了壓低組網成本,也意味着供應鏈高度多元,因此,鏈條上價值量以及確定性就極其關鍵。
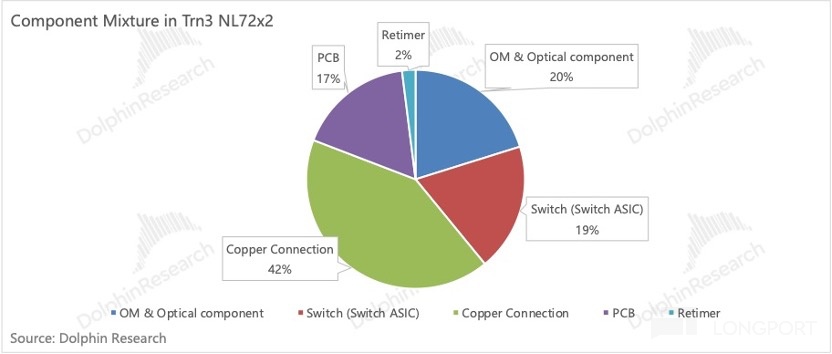
單機櫃的價值量上,銅連接最大,其後依次為光連接、交換、PCB、PCIe Retimer。
確定性上我們從方案迭代角度考慮:
我們認為確定性最強的是 PCB。因為無論 Trn4 走哪條路,板材都需要升級:
- 若繼續走PCIe,代際迭代會同時抬高板材、Retimer與SerDes的要求,Gen7對板材壓力更大。但其中只有板材是剛性的:Retimer並非必需品,SerDes 強的方案(如英偉達)可以不用,PCB板材增強後亦可能移除部分Retimer。
- 若轉向 NVLink(Trn4)或 UALink,單通道速率達到 200G,信號需要M9乃至更高等級材料,確定性更強。
其次是光連接和銅連接。
- 大規模組網需求下,Scale-Out使光連接的確定性與價值量雙雙抬升。
- 銅連接仍將以櫃內連接為主要場景,AWS在跨櫃組網上是AEC的忠實採用方,但無法排除AWS趨向行業方案、跨櫃走光的可能性。
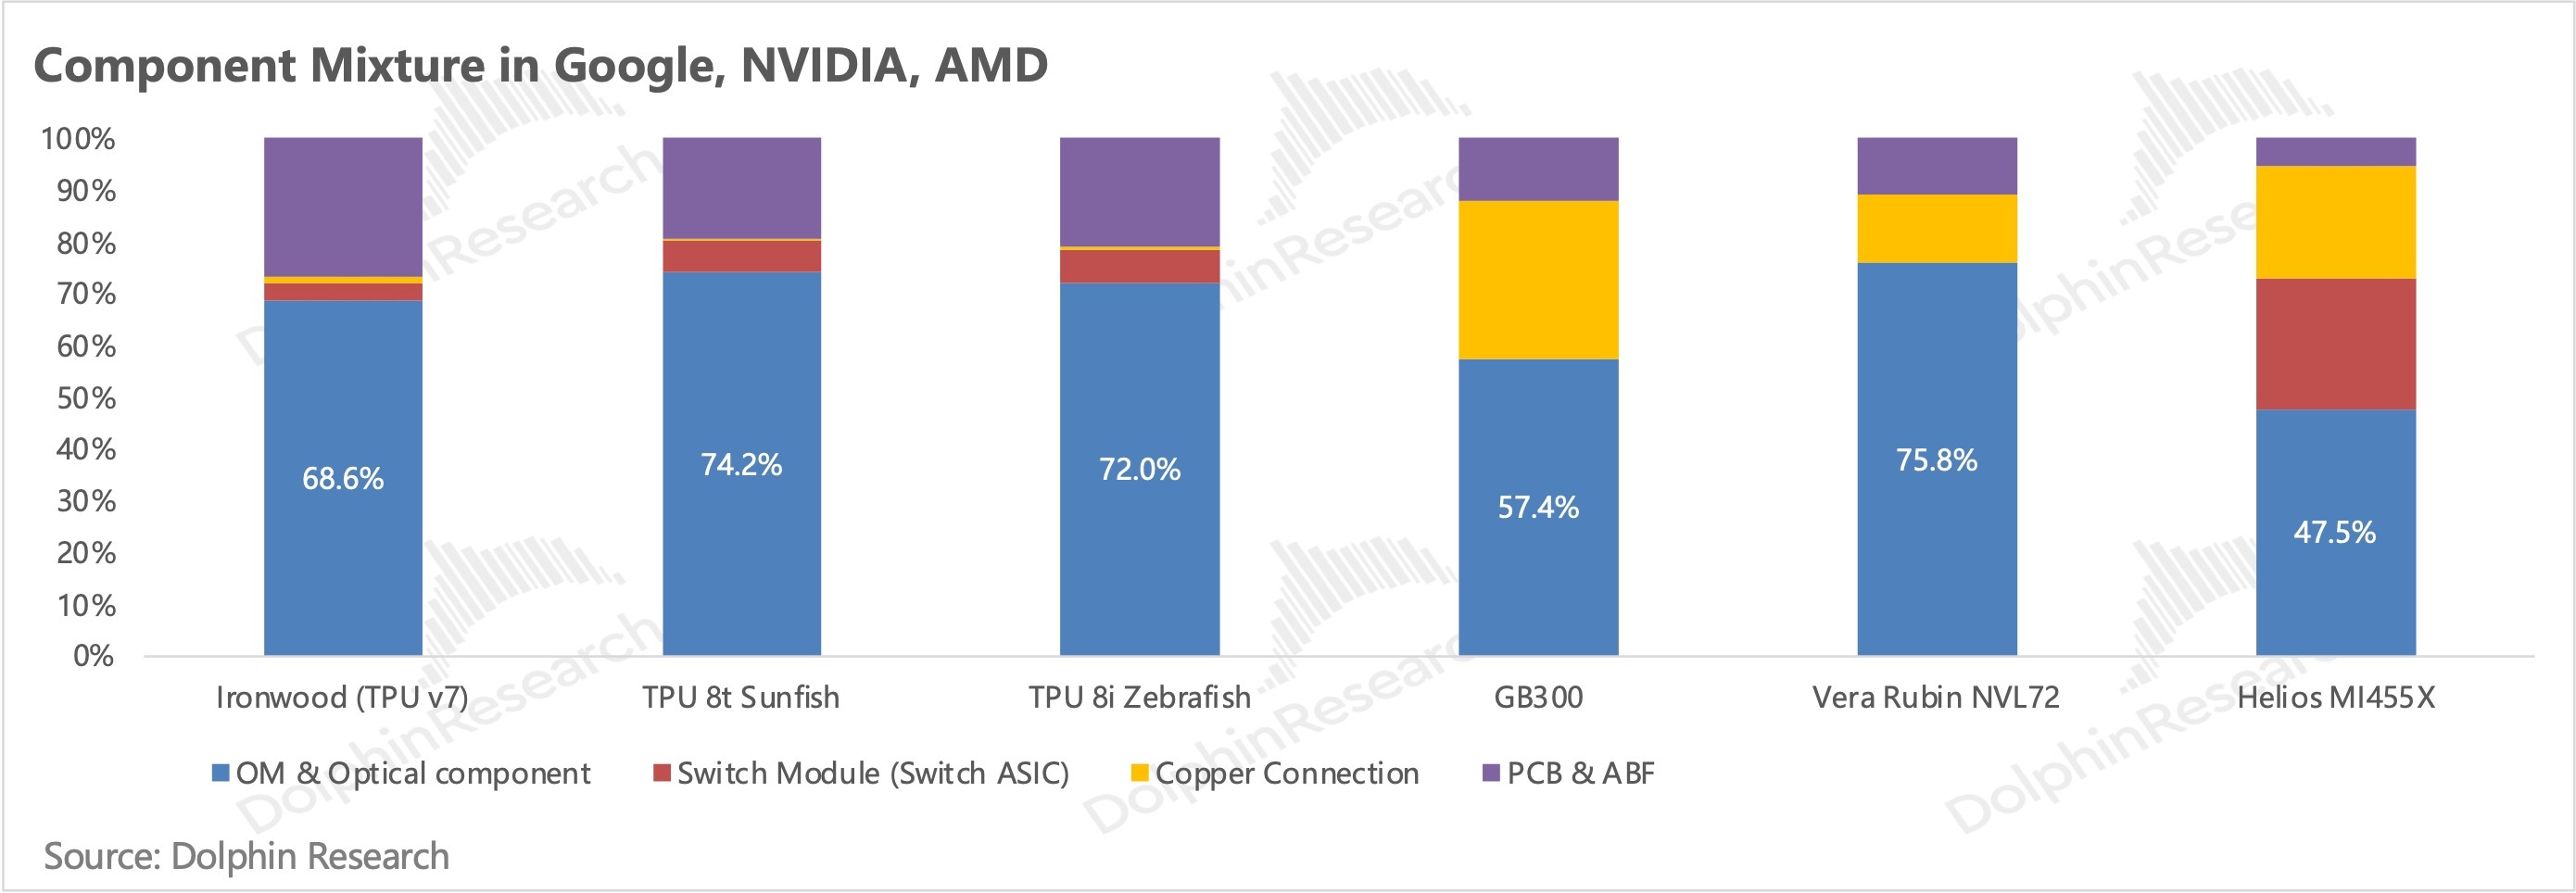
再次是交換。Trn3生命週期內以採購標品為主,核心供應商是 $Astera Labs(ALAB.US) ,但在下一代交換芯片(交換托盤內)上,可能會轉向$高通(QCOM.US) ,詳細點評請參見。
而在Trn4代際,若走 NVLink Fusion,交換芯片可能依賴NVSwitch;若走UALink,也可能讓位於AMD(芯片在Marvell與ALAB共同研發中)。
最後是PCIe Retimer。價值量不高,且存在板材對它的替代,是當前必需、但可能被優化掉的環節。
關於光連接,交換以及PCB的產業鏈詳細邏輯可回溯此前的深度。
3、銅連接沒機會了嗎?
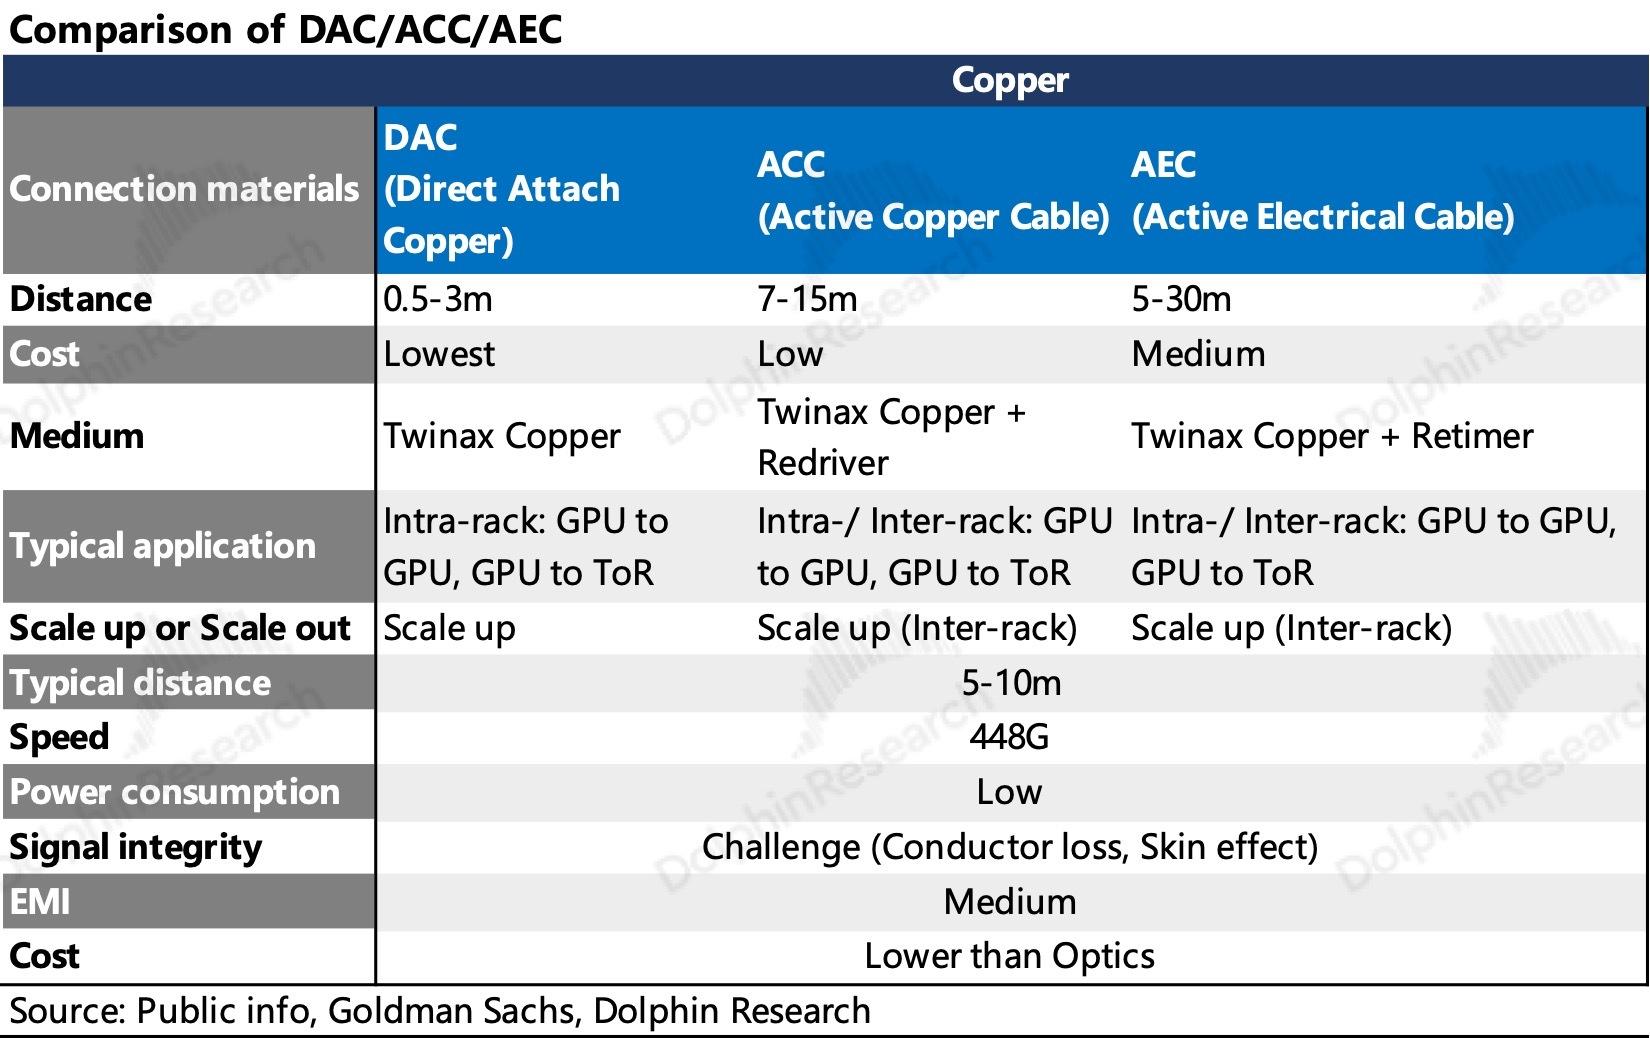
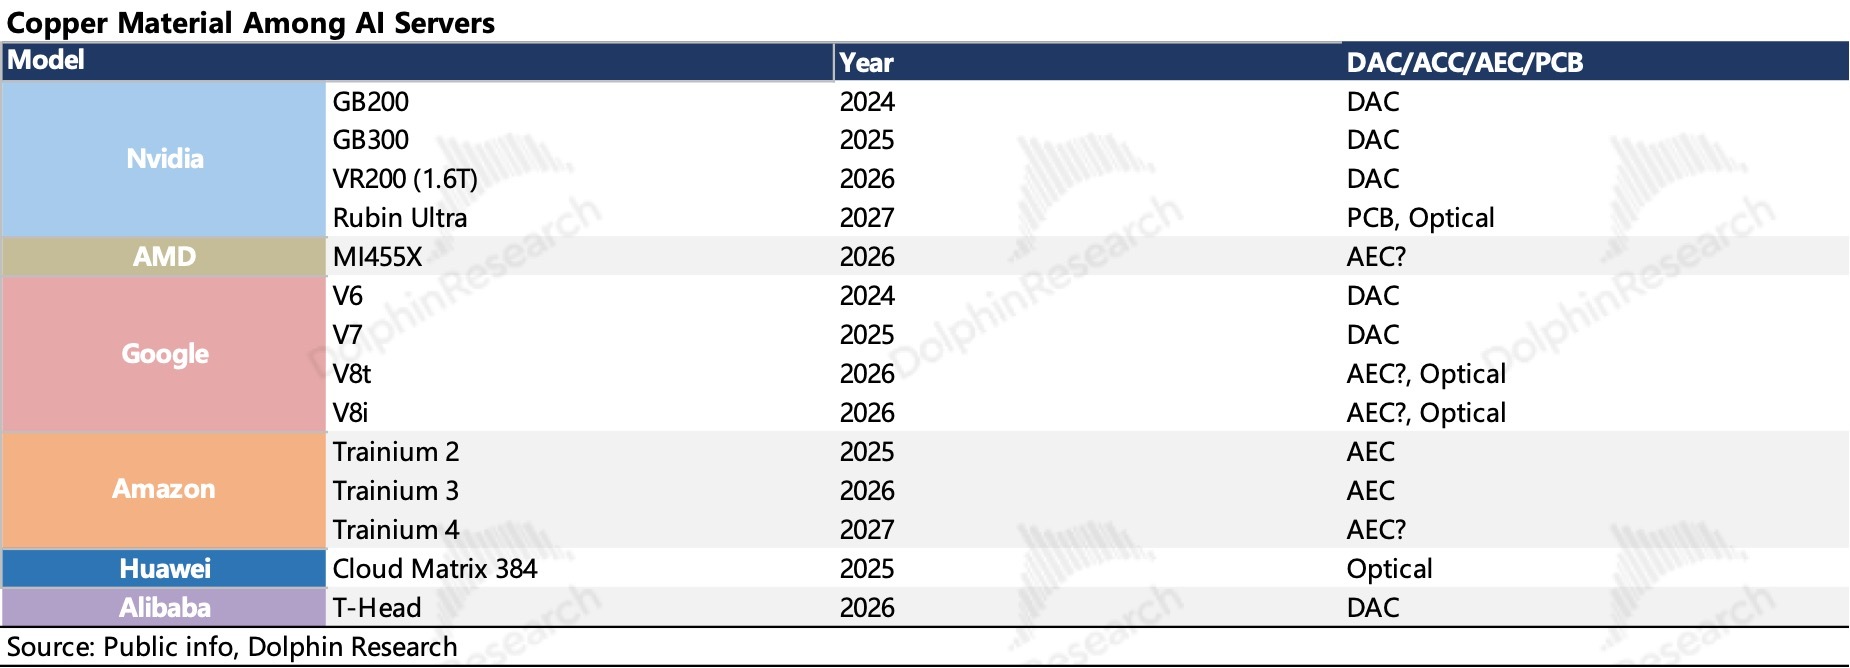
高速銅纜可分為DAC、ACC和AEC。相比DAC,ACC通過在線纜的接收端加入Redriver來延長銅纜的傳輸距離;AEC在線纜兩端引入Retimer對電信號進行重定時,補償銅纜損耗的能力更強,傳輸距離進一步延長,正如表中所示,AEC的傳輸上限長達30m。
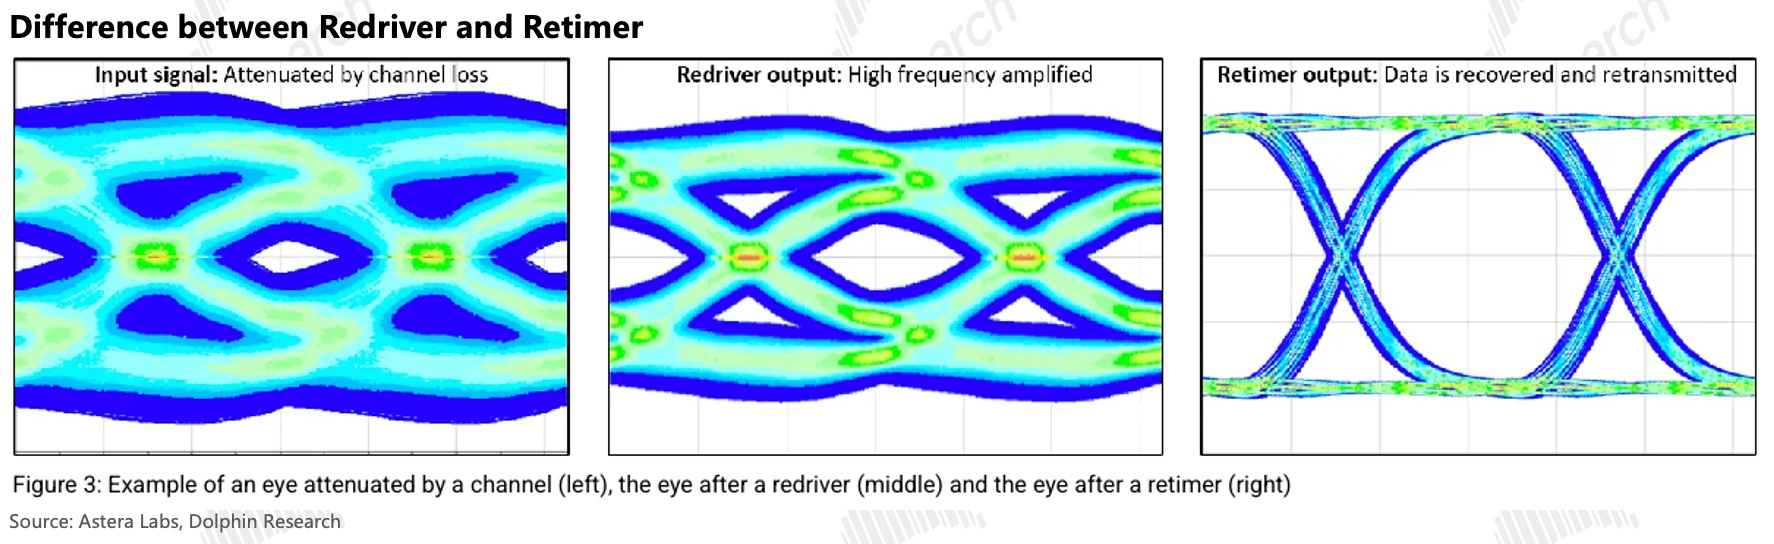
下圖的信號眼圖解釋Redriver和Retimer的區別:「眼睛」張得越開、越乾淨,接收端越容易分清 0 和 1。信號經走線衰減後,眼睛幾近閉合(左);Redriver 放大衰減的信號,眼睛重新張開,但噪聲也被一併放大(中)。
Retimer重定時的做法是:把信號收下、重新判斷後再發一遍,輸出一份全新的乾淨信號(右)。
行業而言,Scale-Out 以光為主,機櫃內部的Scale-Up仍以穩定、高效、便宜的DAC為主,銅的基本盤仍在。但這塊基本盤也並不穩定:英偉達Kyber機架以PCB中板取代櫃內銅纜,對銅纜是利空。
海豚君認為,銅連接的增量在AEC,來自兩類場景:
一是Scale-Up域開始出櫃,但只跨一兩個相鄰機櫃,距離超出DAC的可達範圍,又因功耗與可靠性不值得上光,AWS的跨櫃方案即屬此類;
二是單通道速率持續提升,DAC能走的距離越來越短,部分原本用DAC的鏈路被迫升級為AEC。
中長期看,跨櫃距離再拉長,銅纜將鞭長莫及:Rubin Ultra NVL576橫跨8個機架,已規劃引入光連接。
4、AEC產業鏈
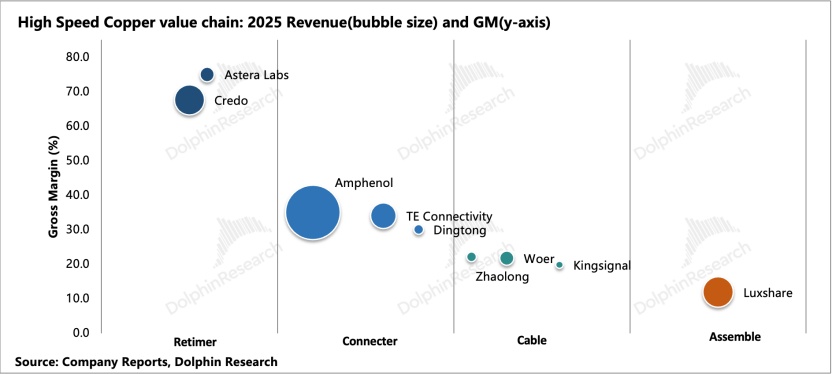
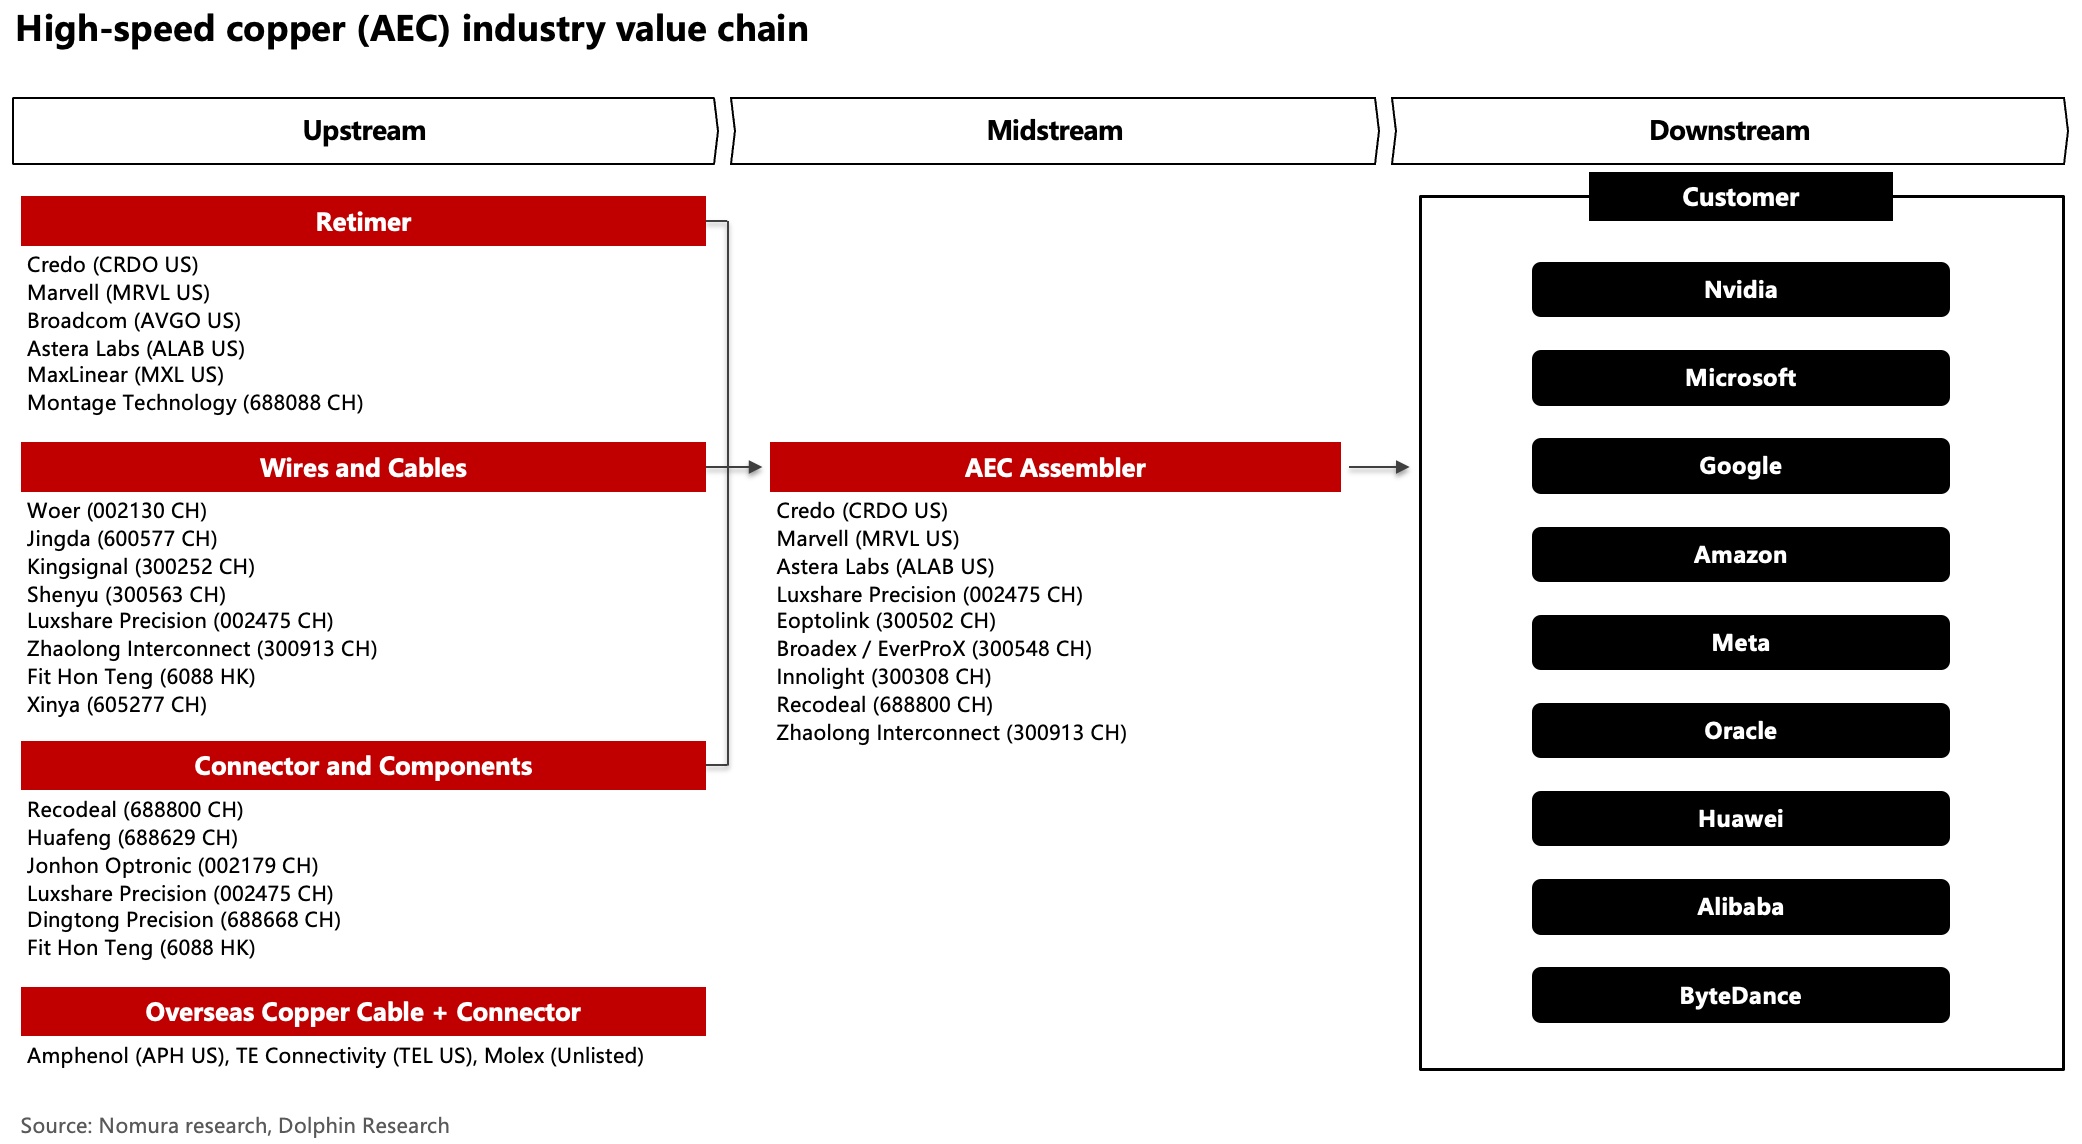
AEC價值鏈的上游包括原材料(銅與塑料材料)、芯片/線纜/連接器製造。我們推薦關注高價值量的上游AEC Retimer芯片以及高速連接器環節。
1)Retimer芯片:$Credo Tech(CRDO.US) 一家獨大
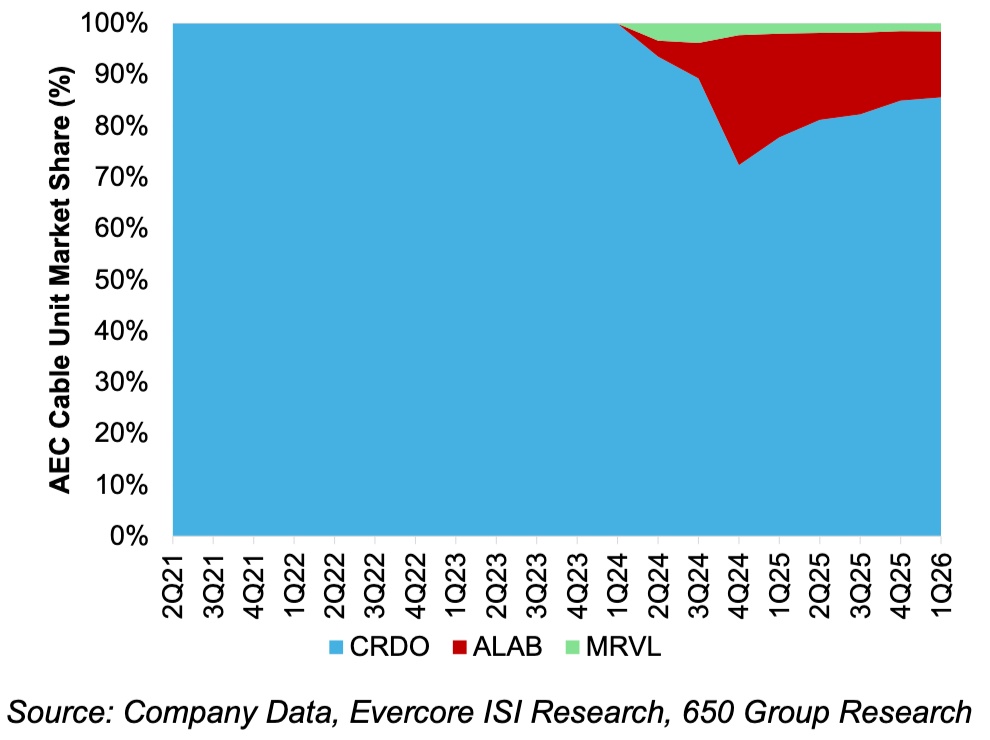
Retimer芯片是AEC價值量最大的部分,而這部分利潤主要歸芯片方所有。Credo佔據超80%的市場份額,其作為AEC的開創者,是目前唯一能夠同時提供芯片+成品線纜的垂直整合廠商,先發優勢明顯。Astera Labs的份額次之,而$邁威爾科技(MRVL.US) 、$博通(AVGO.US) 仍在擴張中。
2)高速連接器:海外巨頭守門,國產加速追趕
該環節對導電性與機械強度要求嚴苛,傳統連接器巨頭(如$安費諾(APH.US) 、$泰科電子(TEL.US) )長期佔據第一梯隊,憑藉技術積累與芯片廠商(如Credo)協作,形成從芯片到組裝的完整方案。而面對光進銅退的市場趨勢,行業龍頭安費諾、TE正通過收購補充光連接的能力。
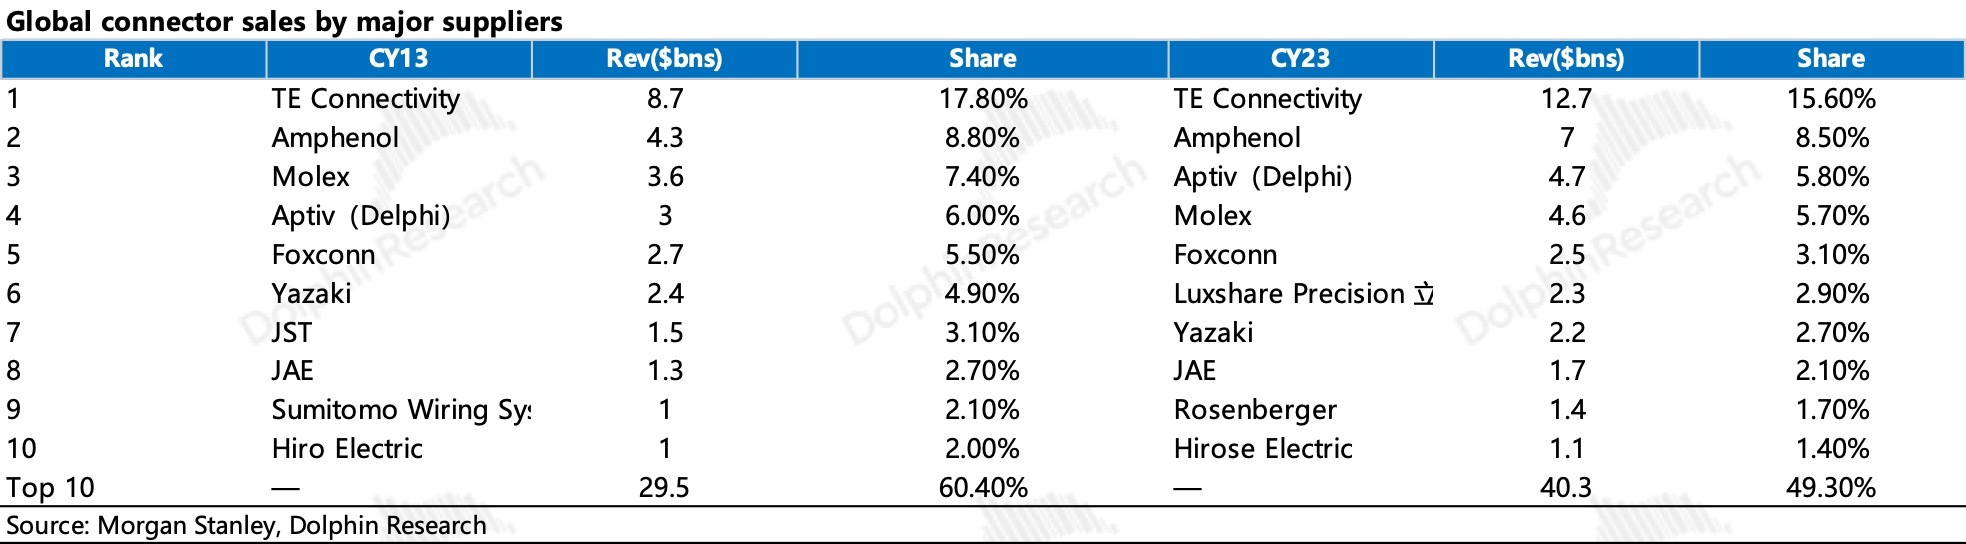
競爭格局上,連接器市場的CR10份額從2013年的60%下滑至2023年的50%,競爭更為充分且分散。國產廠商中$立訊精密(02475.HK) 進展較快,2023年的市佔率已升至第六;沃爾核材、兆龍互連正在上量。
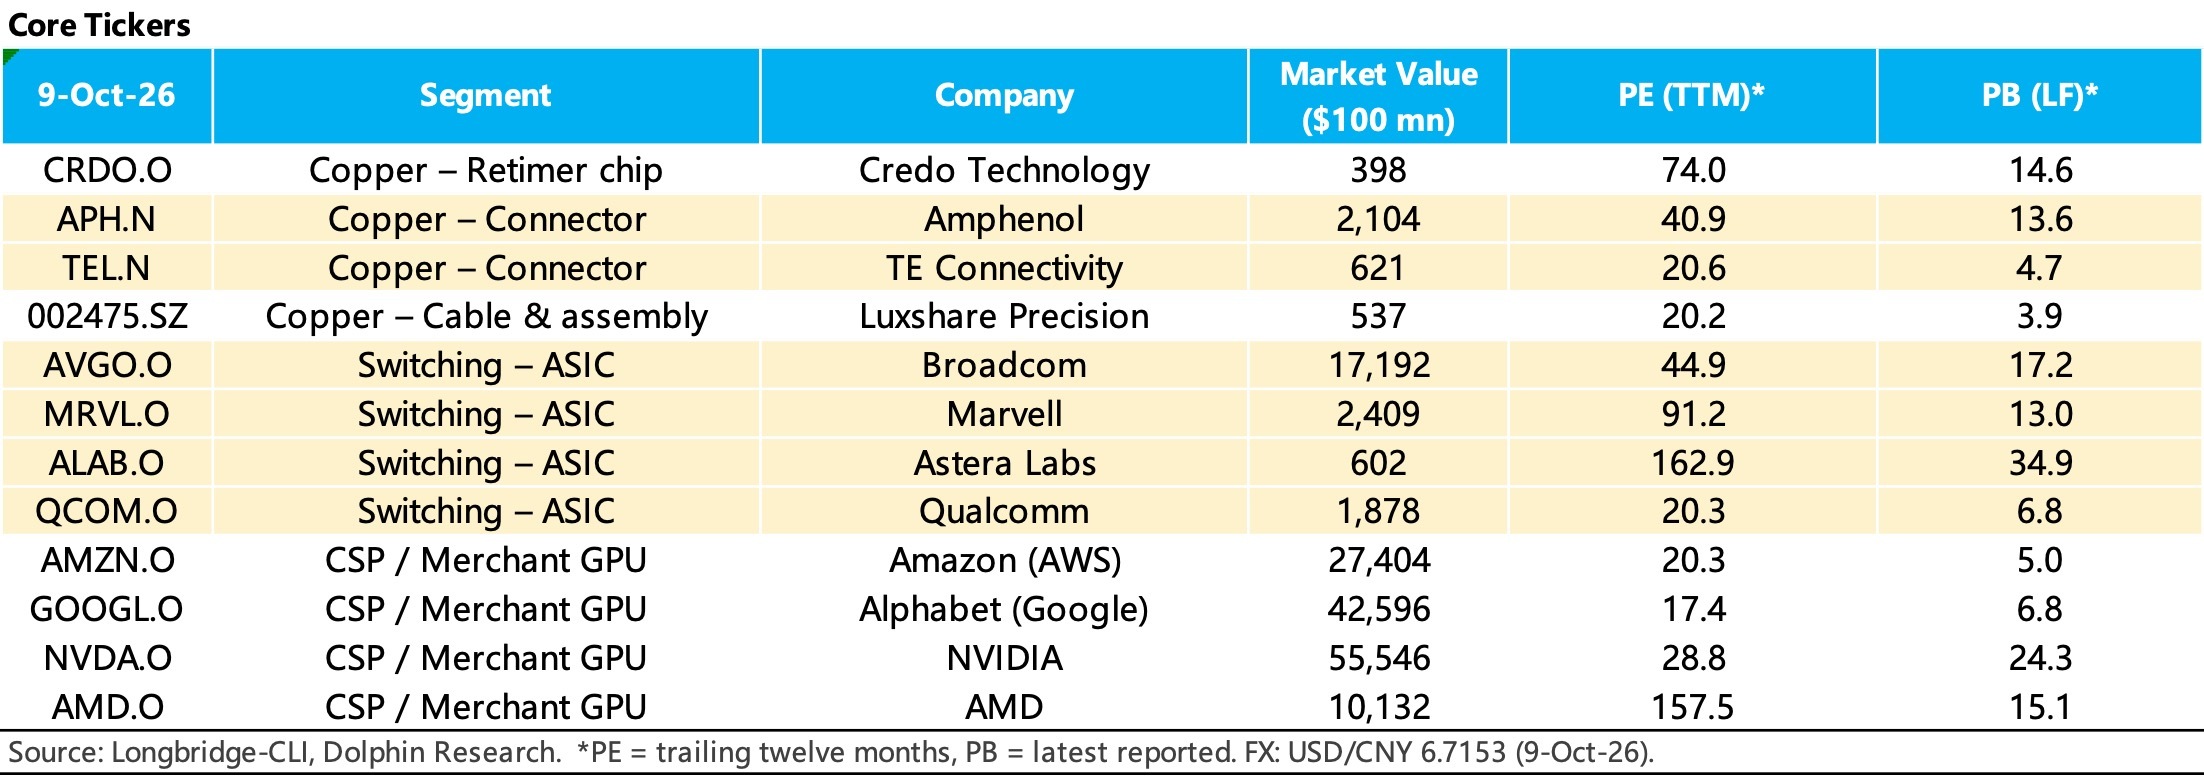
本文提及的核心標的如下(具體可點擊此處:海豚君連接股單),光模塊、CPO、PCB等其他連接硬件的核心標的請參見此前的深度。
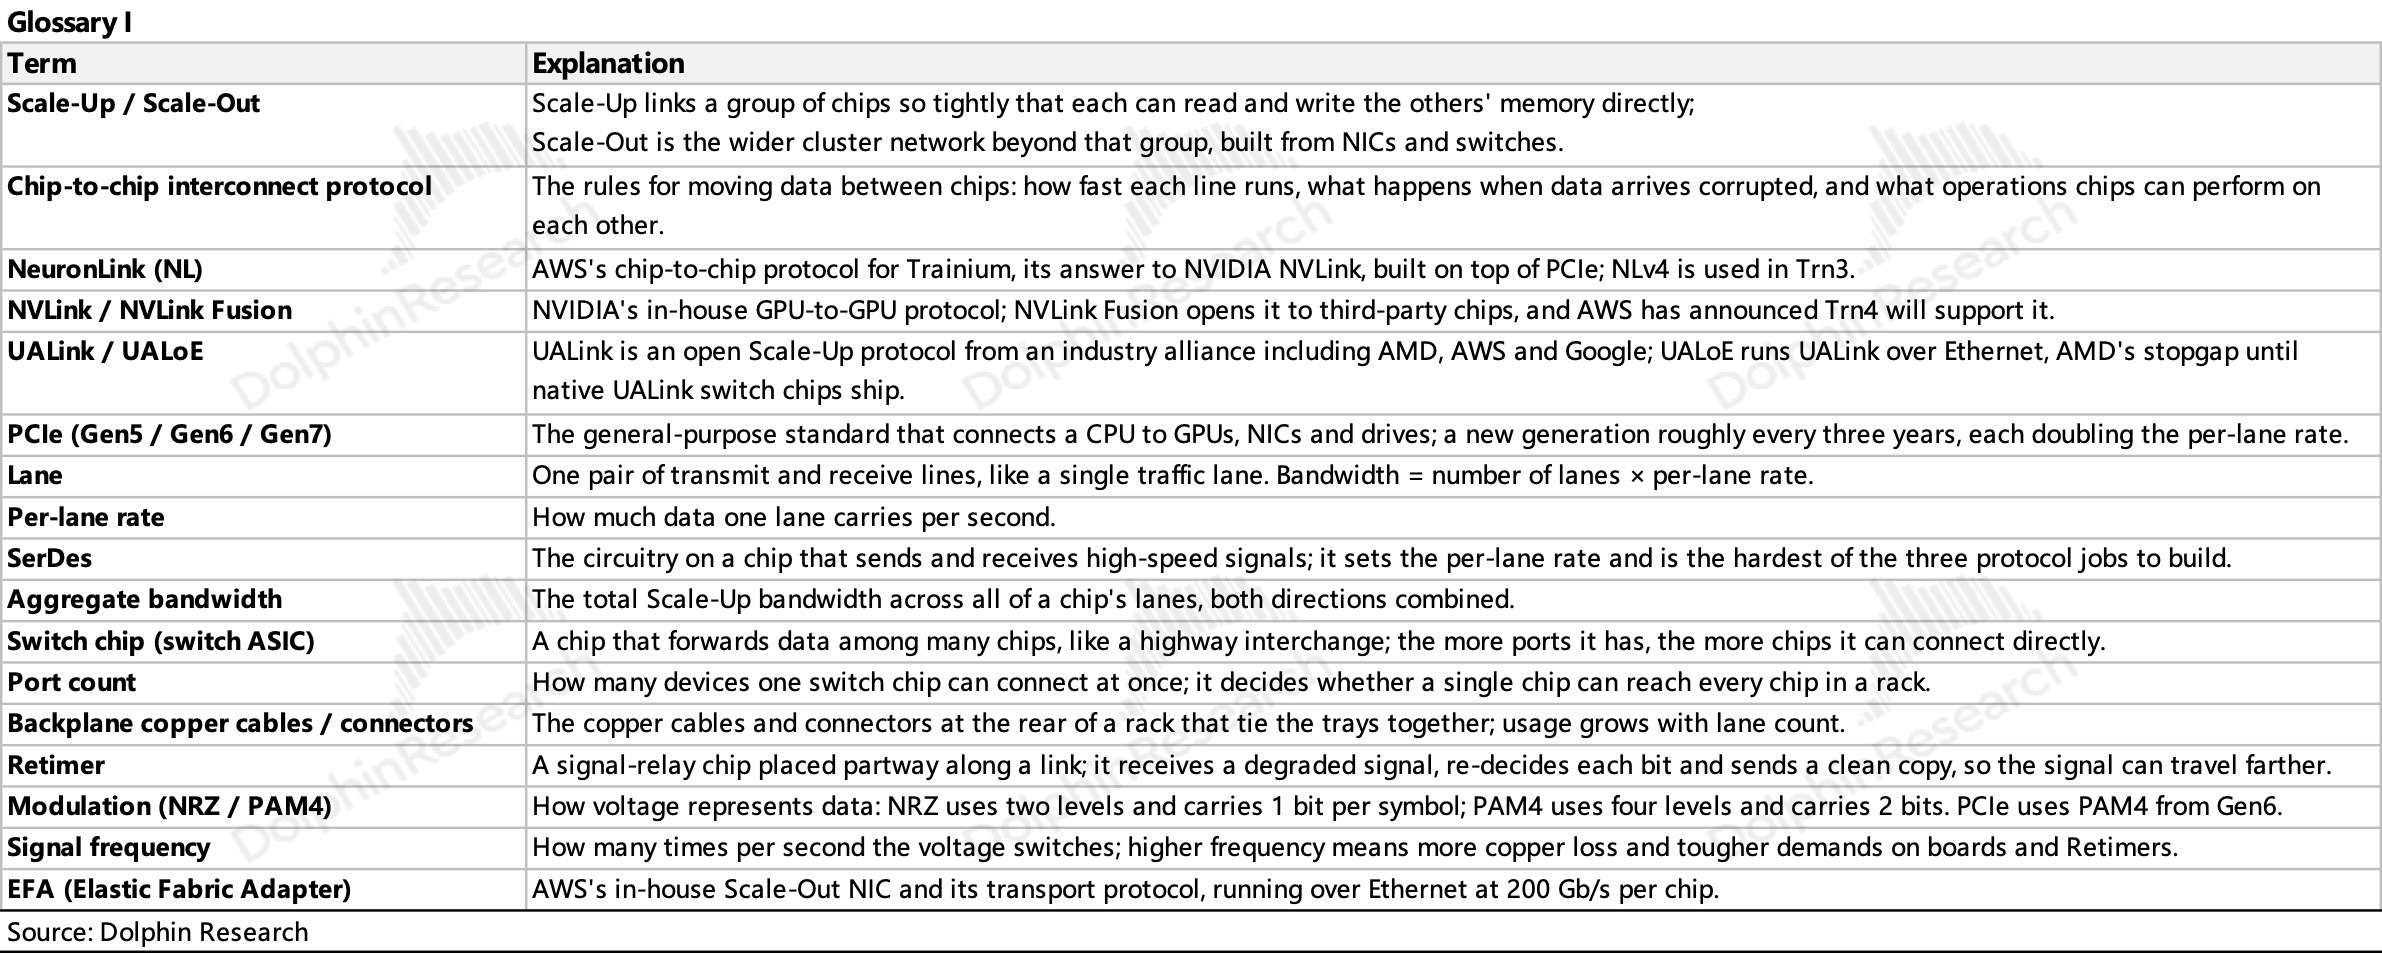
附錄
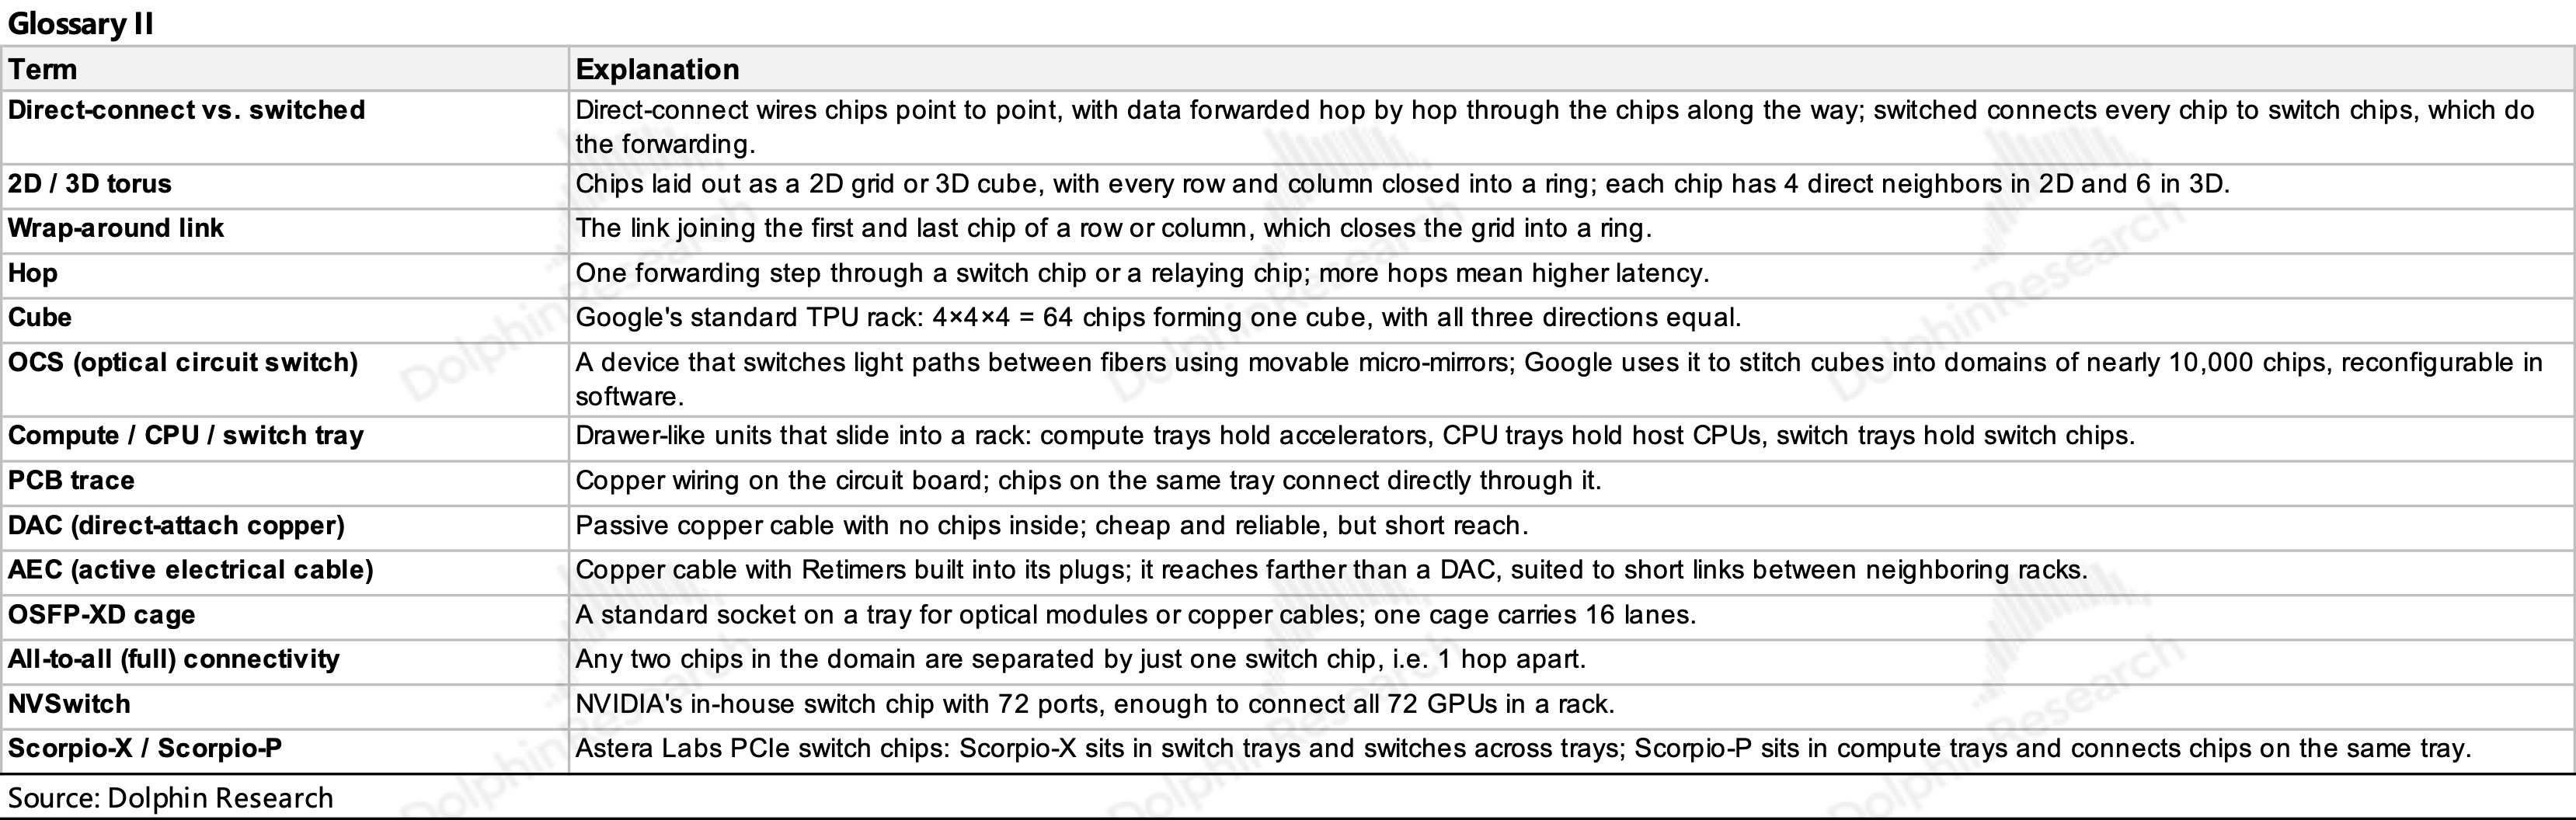
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
海豚君AI DC互聯繫列分析:
CPO行業
《AI 超連接時代:AI 向 “光” 飛奔?》《“‘銅’ 牛夫人” 不走!CPO:真機會 or 鏡中花?》
組網架構
英偉達組網:《AI 時代 DC 互聯:單芯之上抱 “網” 作戰,真有 “中國” 機會嗎?》
DC組網之AMD vs英偉達:《AMD 跟英偉達 “掰手腕”,Helios 夠格嗎?》
谷歌組網:《叫板英偉達霸權,谷歌 “光網” 憑什麼?》
個股
Lumentum(上):《從光互聯老炮到 “全能賣水人”,Lumentum 憑什麼?》
Lumentum(中):《Lumentum:產能告急,“全能賣水人” 還有什麼看家絕活?》
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。