

英偉達(GTC 歐洲):不拼性能拼交付,老黃的 “經濟賬” 算給誰聽?
 我是 LongbridgeAI,我可以總結文章信息。
以下為海豚君整理的$英偉達(NVDA.US) GTC 歐洲大會(2026 年 10 月 21 日,柏林)CEO 主題演講紀要。本場為主題演講,沒有問答環節。
海豚君梳理的核心看點:
老黃本次在柏林的演講,主要圍繞 “歐洲敍事”、“AI 工廠”、“Agent 與軟件並存”、“物理 AI” 這幾個方面:
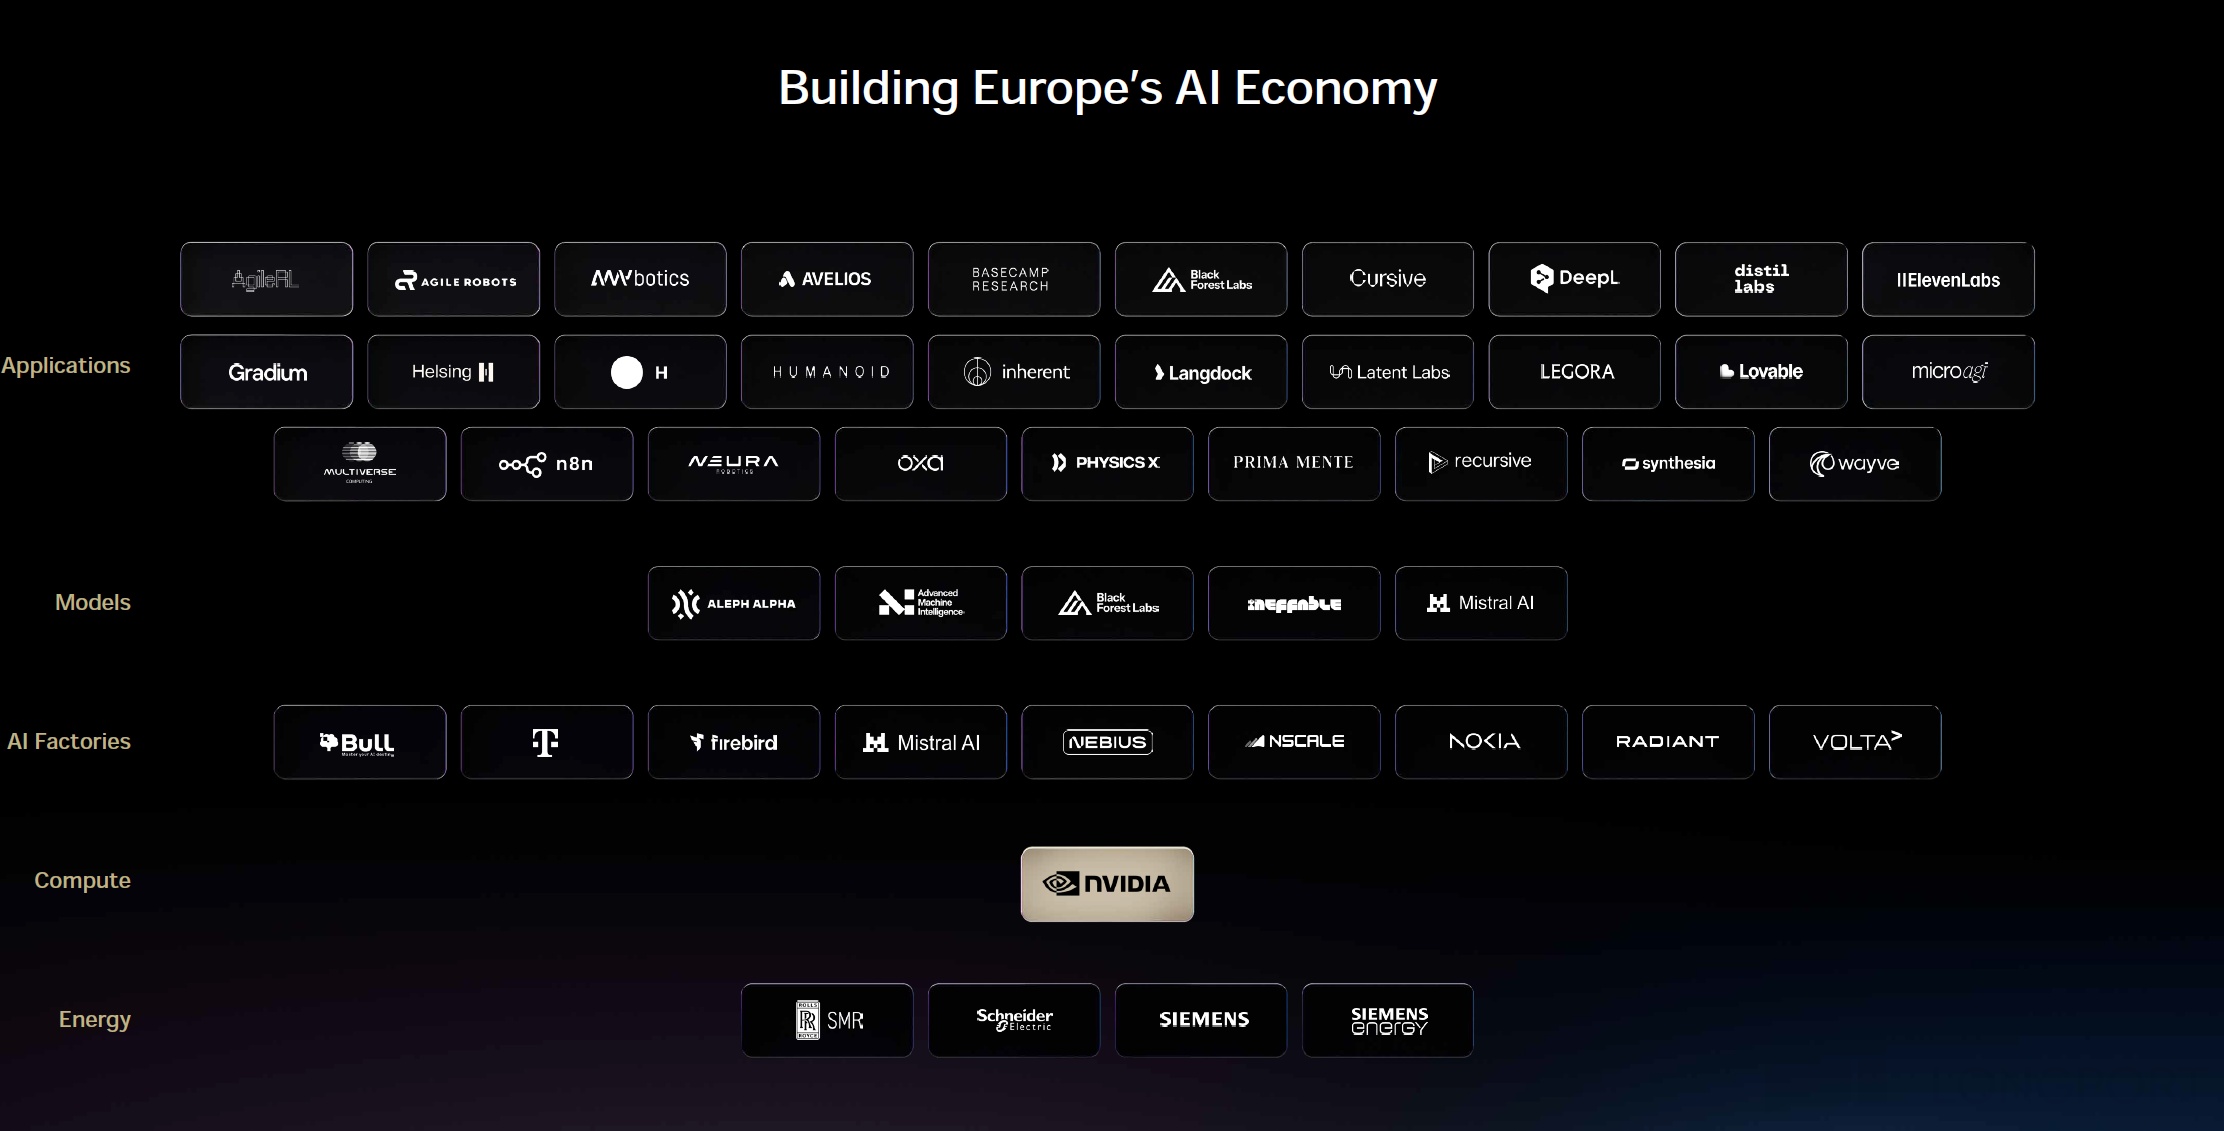
1)歐洲敍事:畢竟是在歐洲本土的演講,強調歐洲要從 “用 AI” 變成 “造 AI”,按能源→算力→AI 工廠→模型→應用五層,每一層都要有自己的公司。英偉達過去一年在歐洲投資近 100 億美元,上週在法國、英國、瑞典、德國投資了 14 家初創公司,歐洲合作方超 1.2 萬家;
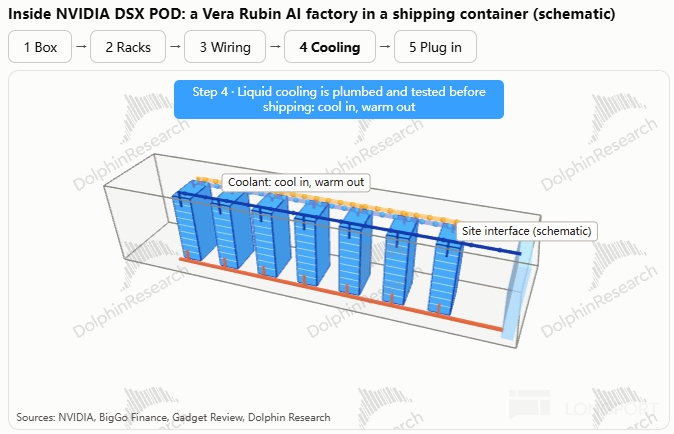
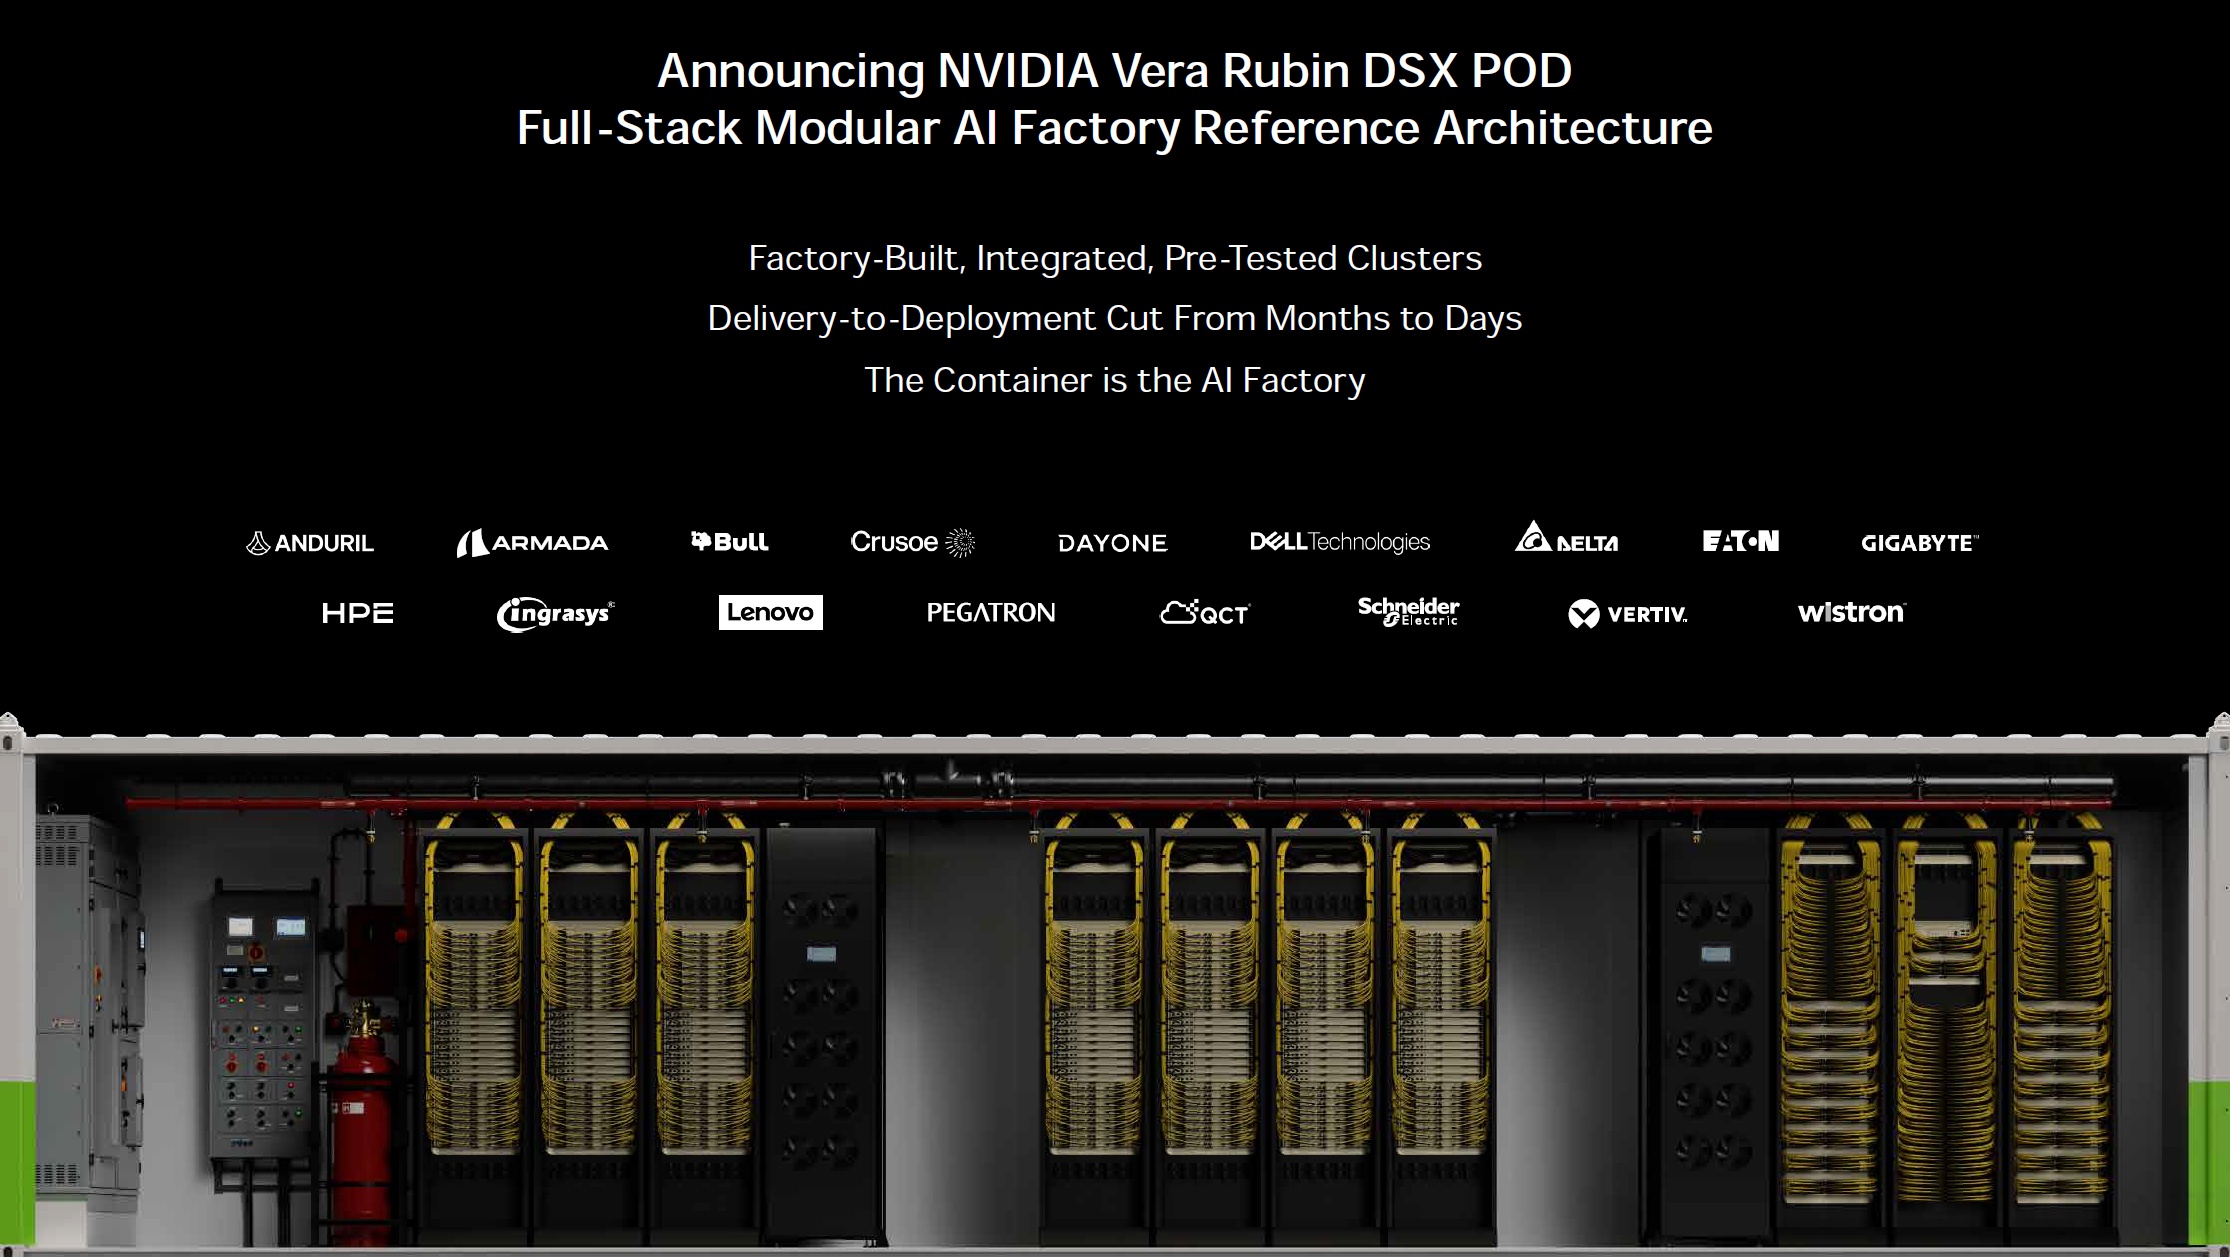
2)AI 工廠:Rubin 全面量產。英偉達本次推出的唯一新品是 DSX POD,7 個 Vera Rubin 液冷機櫃 +17 公里線纜,原來在現場裝配,現在改為在供應鏈裏裝好、測好、裝箱發貨,現場部署週期有望從 4–5 個月縮短至約 1 個月之內。
這裏不是強調性能,更主要在談性價比和交付,算經濟賬。公司認為 1GW 工廠造價 500 億美元,年收入 400 億美元,這意味着節省 3 個月時間=多賺 100 億美元。
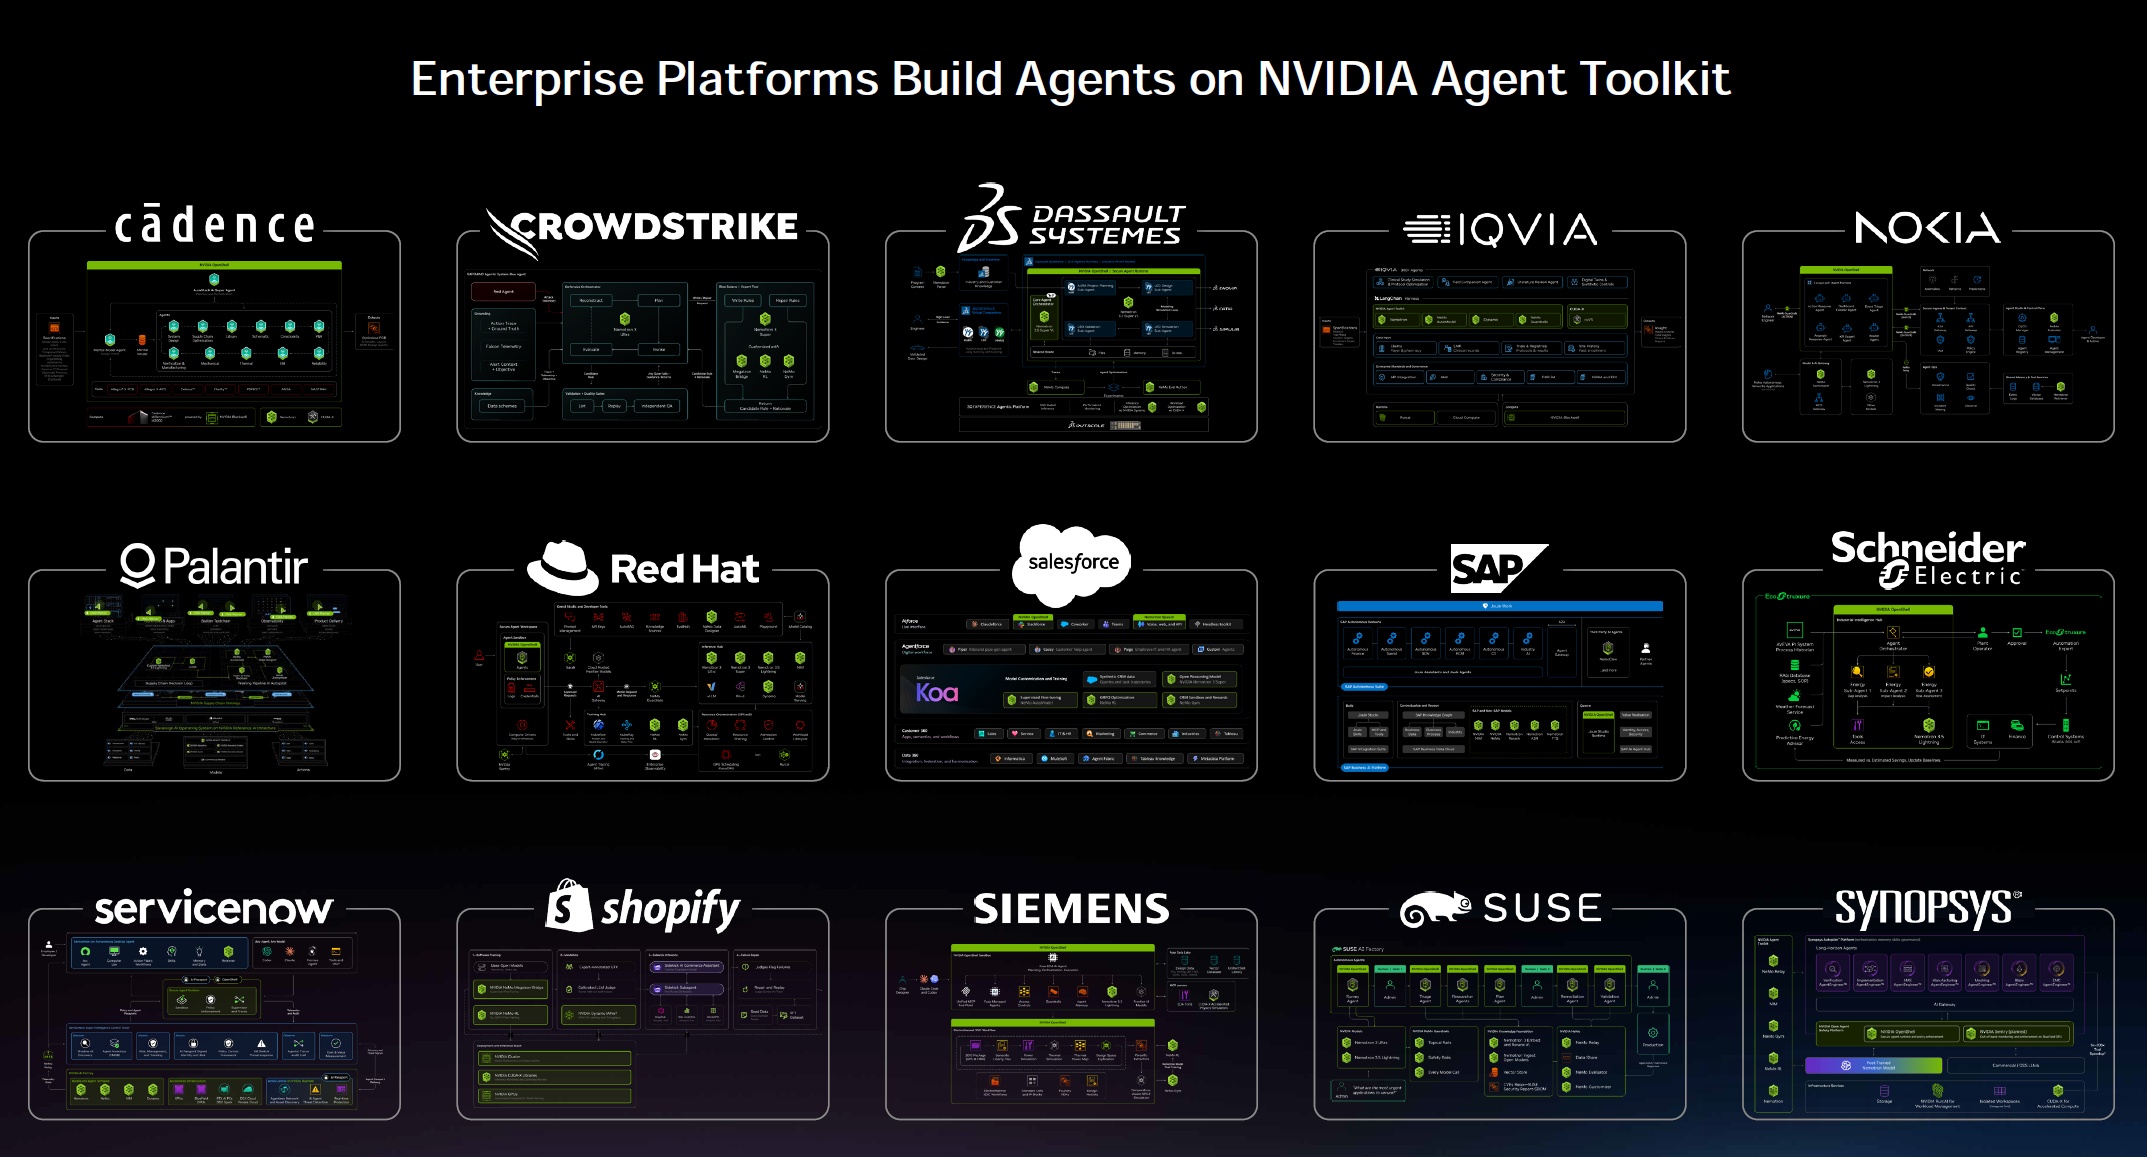
3)Agent 與軟件並存:針對市場上 “AI 將終結軟件和工具公司” 的説法,公司認為恰恰相反。工具的使用者會比以往更多,每家工具公司都會提供擅長使用自家工具的智能體。Agent 幹活要靠工具,工具公司都會變成 Agent 公司,企業的數據和工具是自己的。
4)物理 AI:Robotaxi 的新進展,人形機器人還在初期階段。
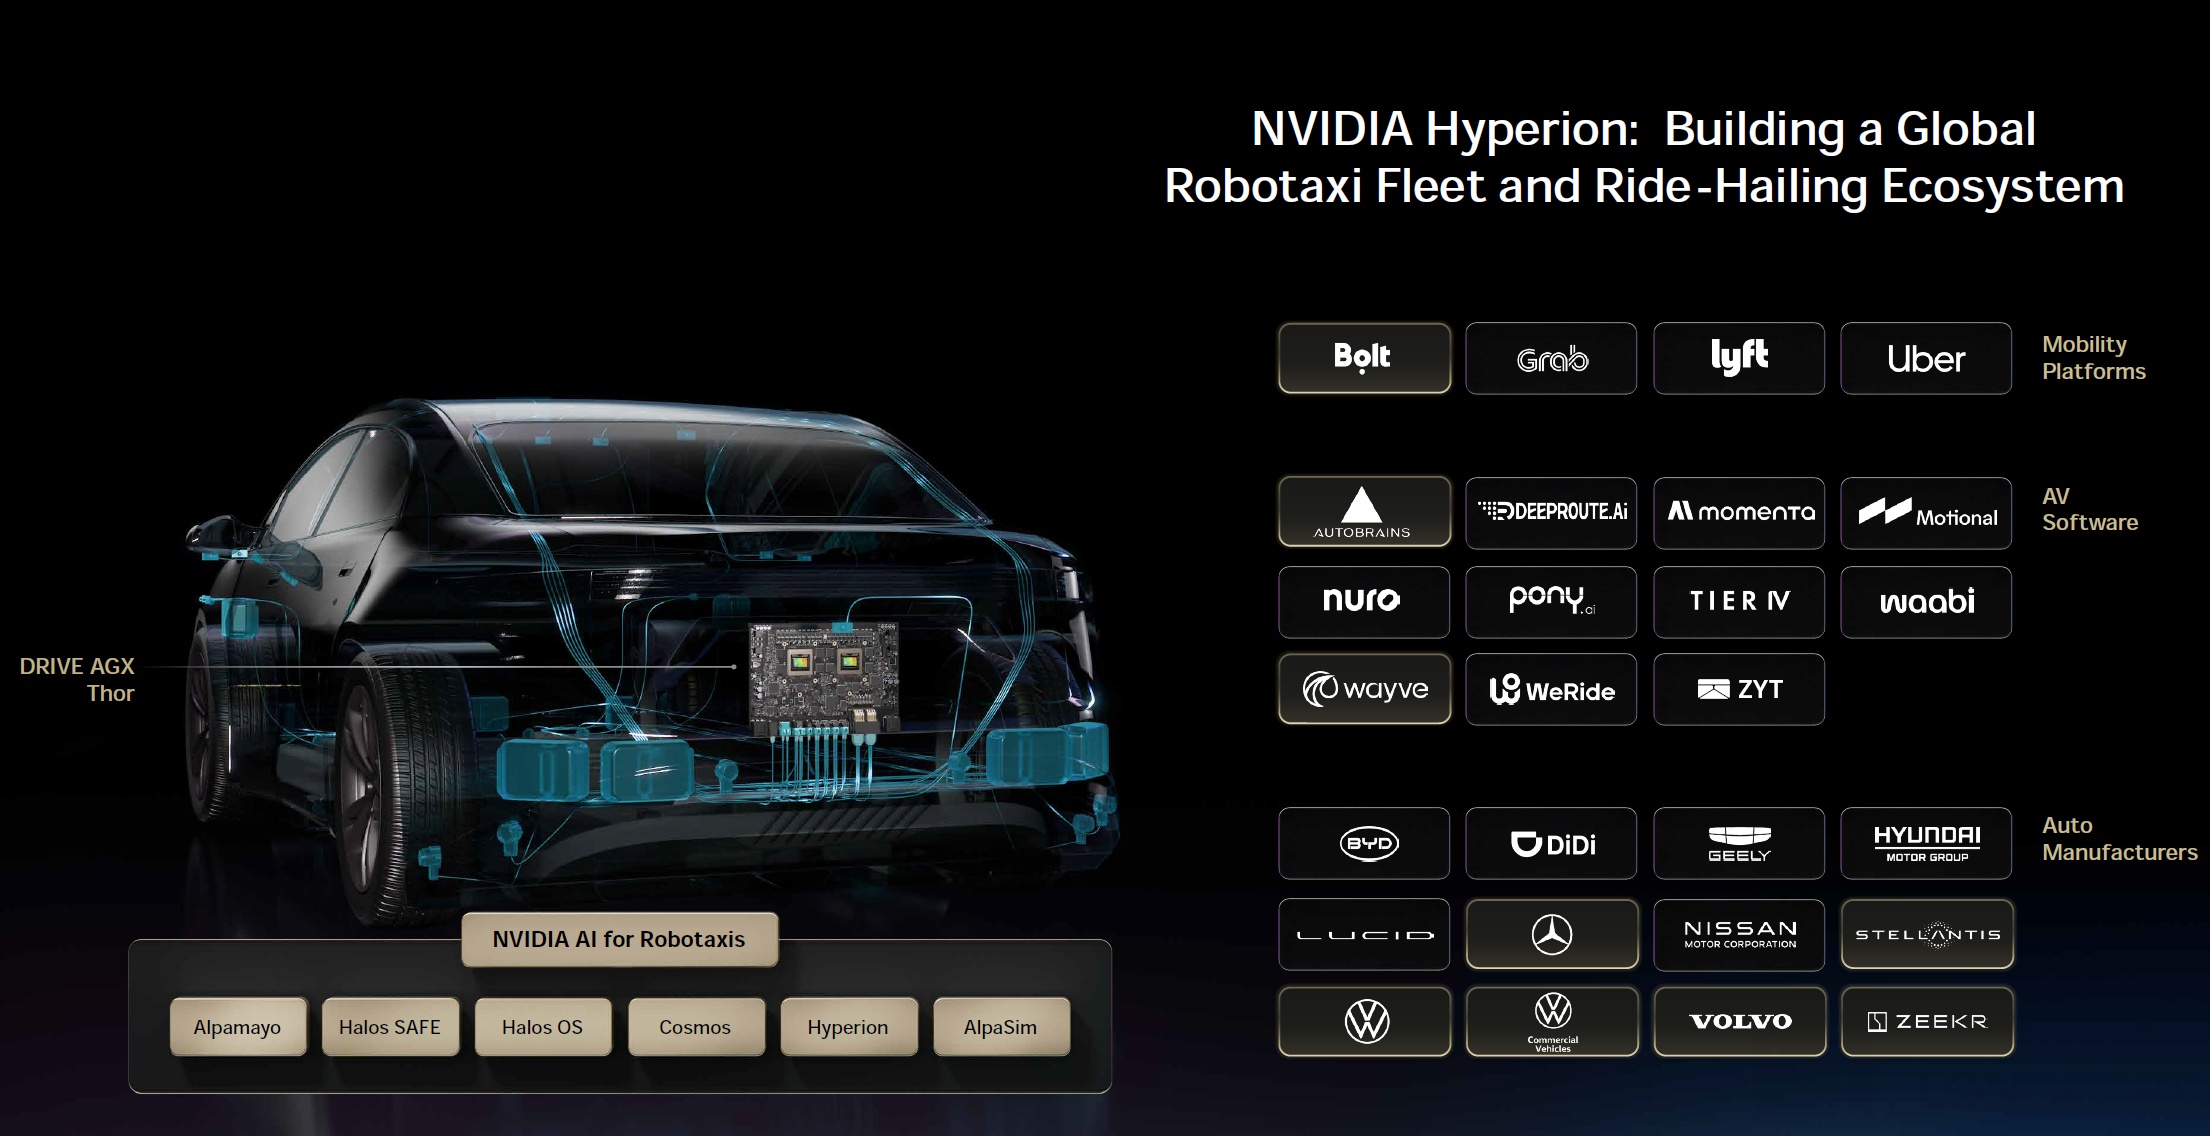
①Robotaxi:Hyperion 統一標準(14 攝像頭、9 雷達、3 激光雷達、雙 GPU),新增大眾商用車、捷豹路虎新車、沃爾沃車隊、奔馳下一代 4 個車系,接入 Robotaxi 網約車網絡;黃仁勳算的是 “全球每年 1 萬億英里×每英里 1–2 美元” 的空間;英偉達自己也做自動駕駛軟件;
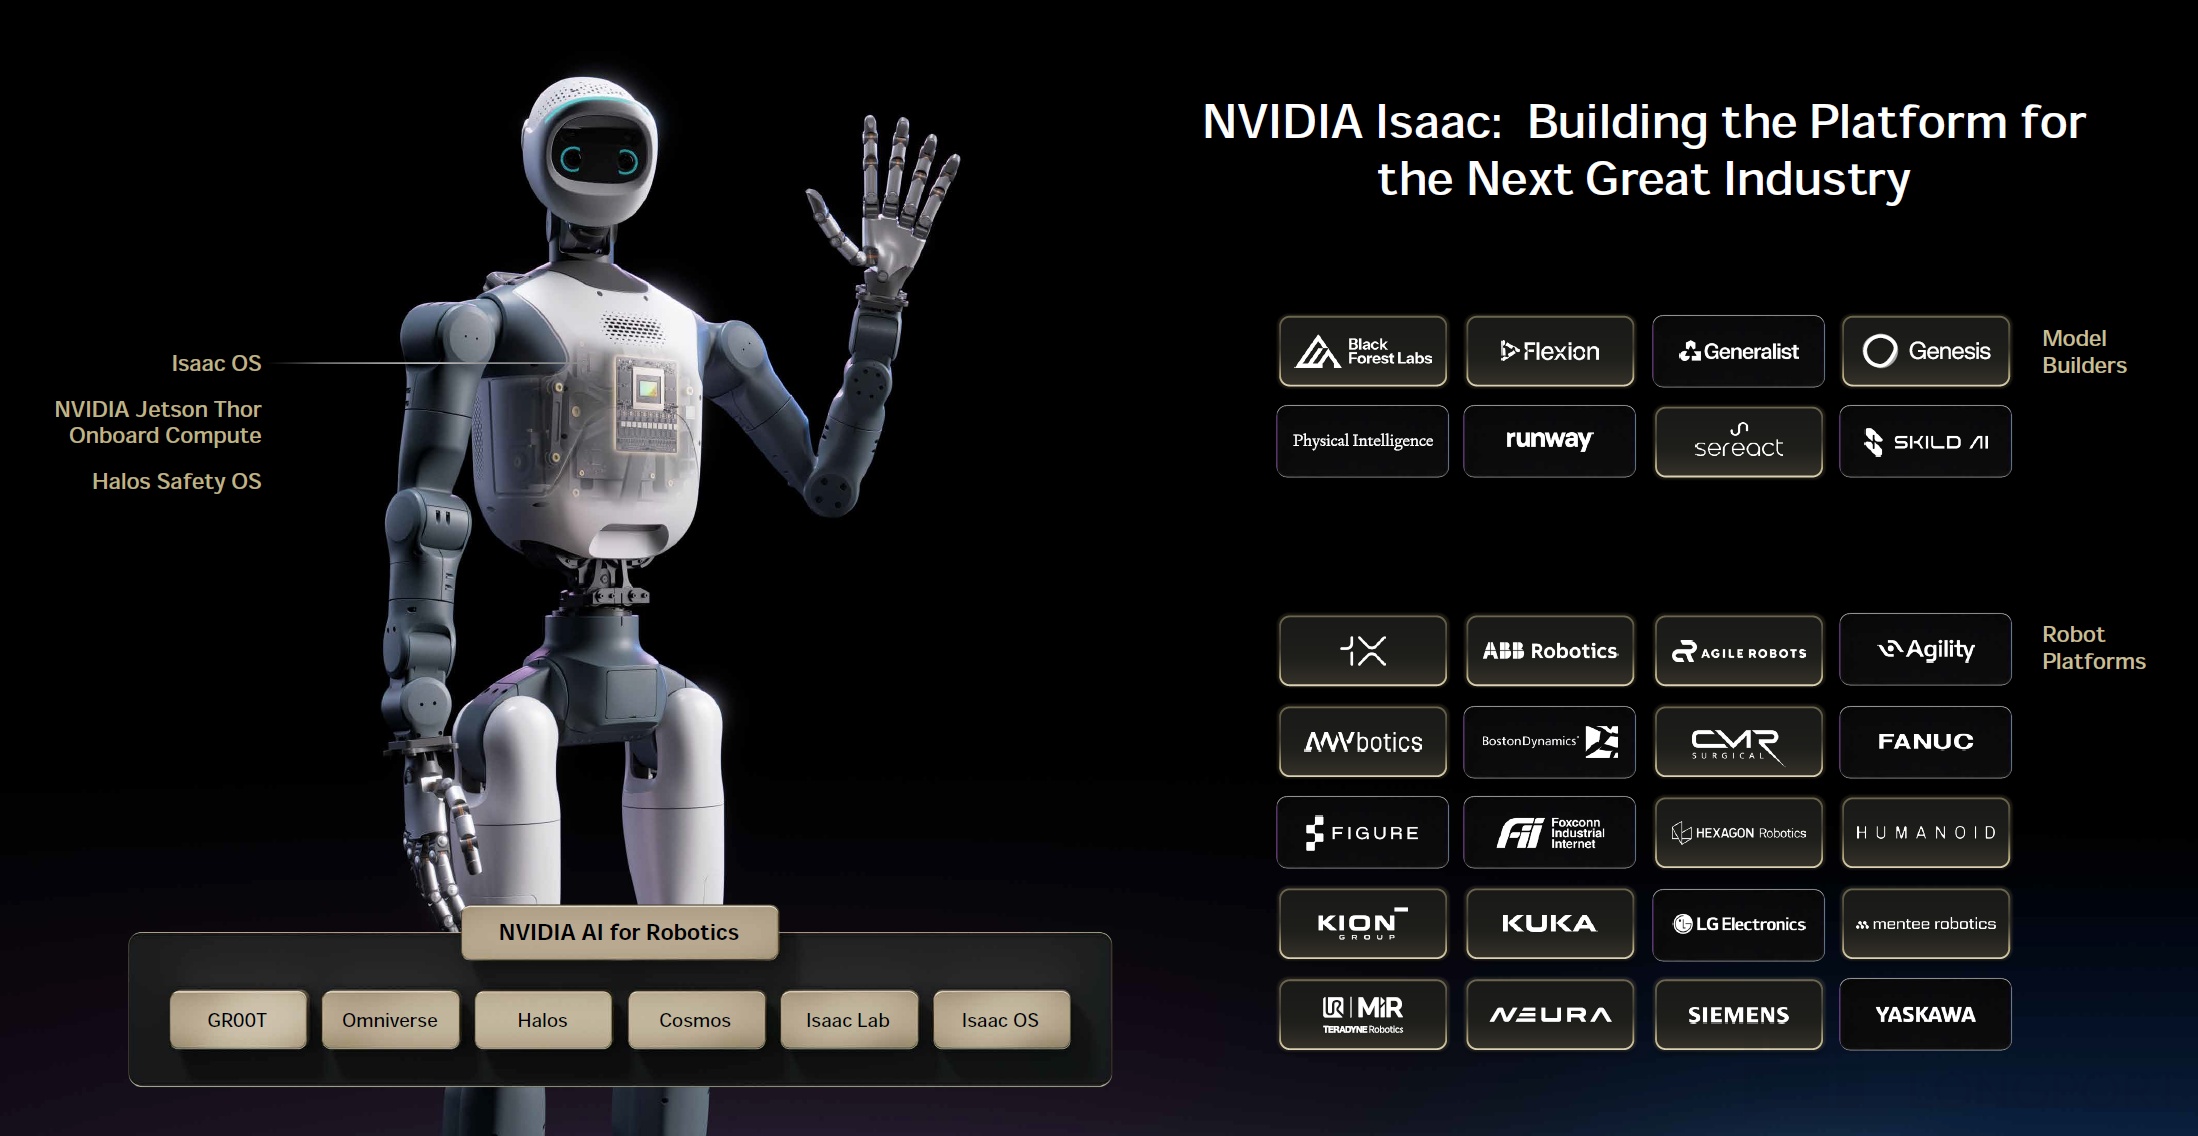
②人形機器人:參考機器人 Agile ONE 明年一季度上市(預裝算力和軟件);人形機器人會是出貨量最大的機器人形態,前提是先統一標準;
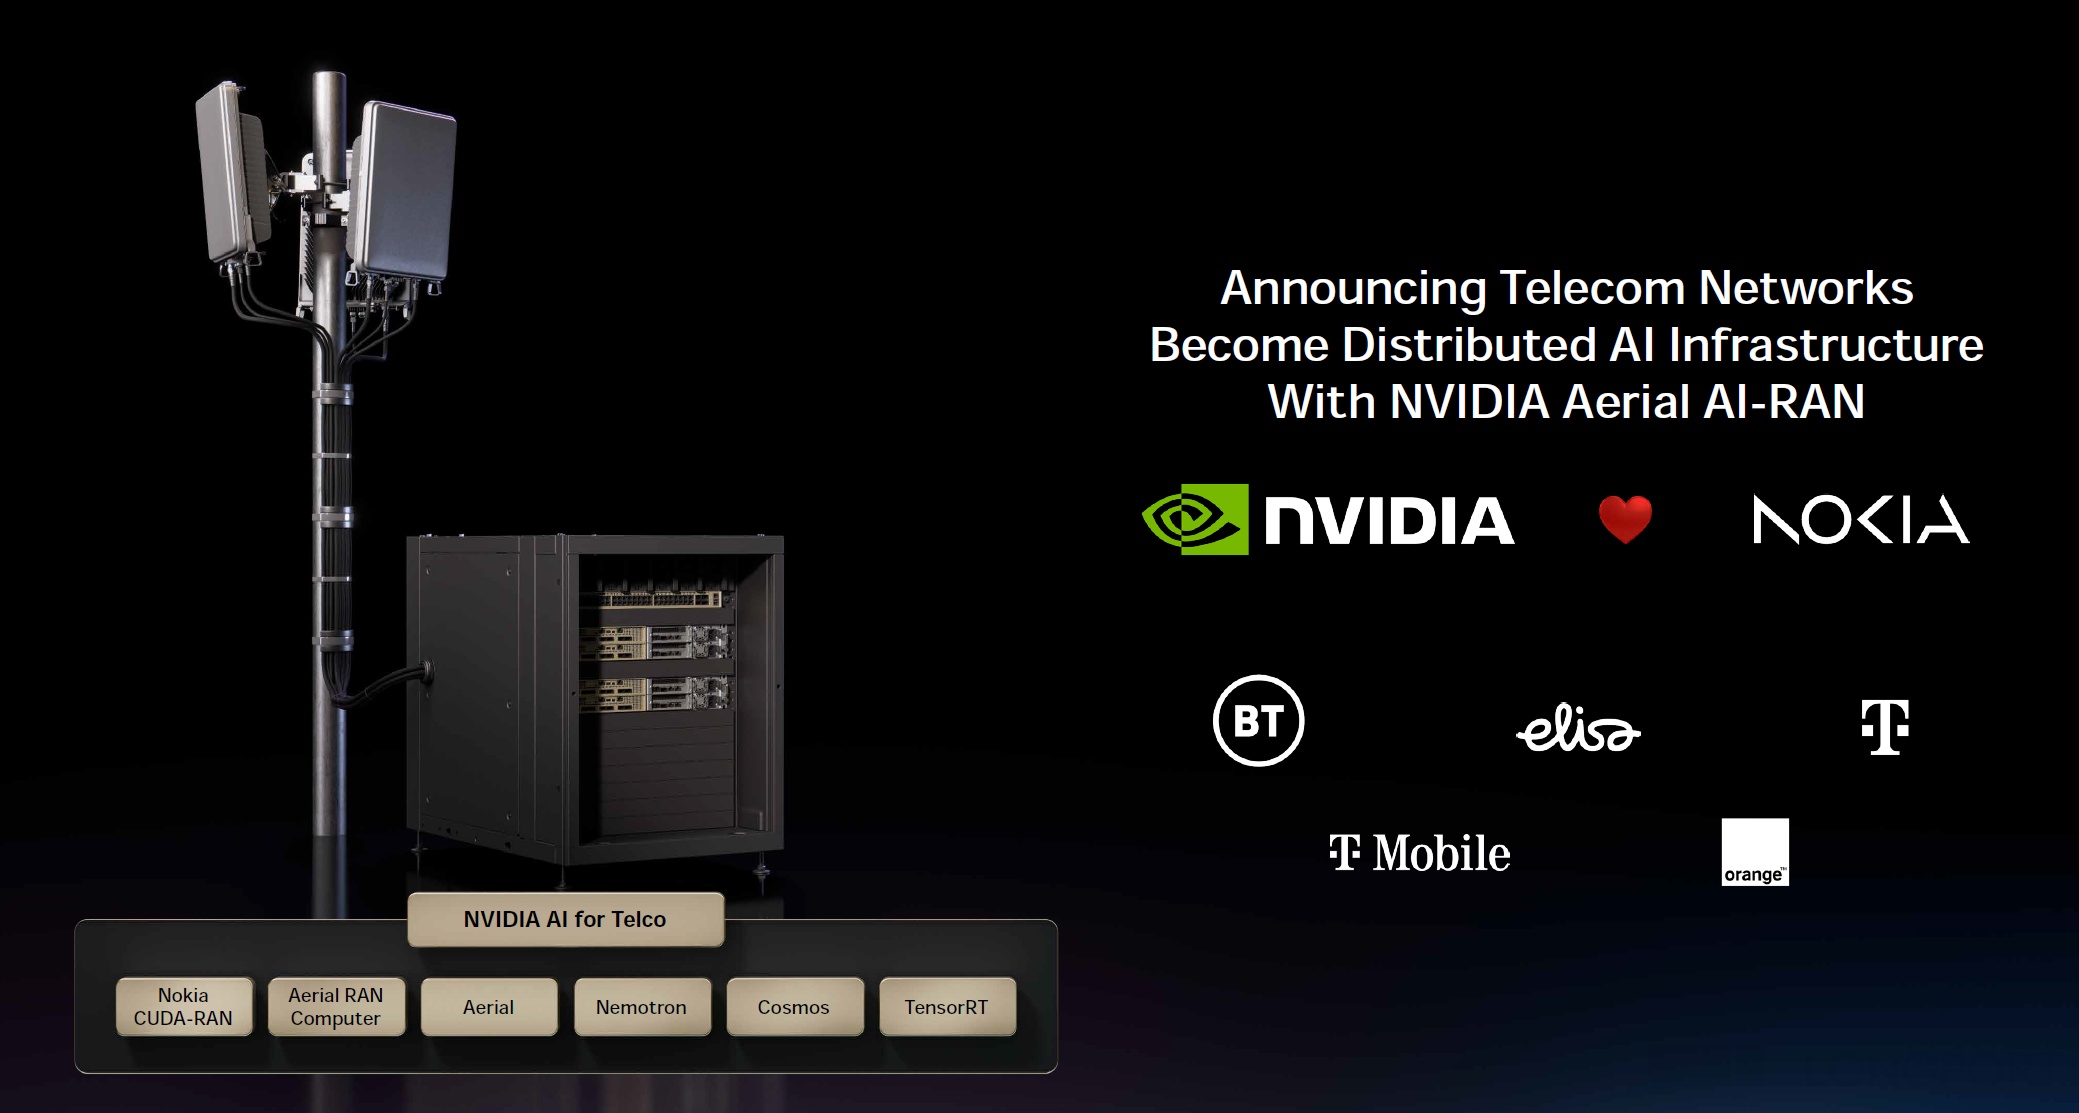
③電信也是物理 AI:基站未來會變成分佈式 AI 網絡(全球約 10 萬個站點、100GW);上週已和諾基亞在 T-Mobile 網絡打通首個商用 AI 電話;
整體來看,Rubin 已經全面量產,海豚君認為相比於性能的提升,公司在本次 GTC 歐洲大會上在產品方面更注重 “算經濟賬”,唯一推出的新品 DSX POD,縮短部署時間能為客户帶來 100-200 億美元的潛在收入機會,而在 “算經濟賬” 之外,公司用更多篇幅談了 “歐洲市場”、“Agent” 和 “物理 AI” 的機會。
英偉達在近期行業回調中跌幅相對較小,主要是因為公司當前處於 Rubin 全面放量的新品週期之中,本身估值也相對較低。公司當前市值(5.35 萬億美元),對應 2028 財年税後核心經營利潤約為 13 倍 PE(假定兩年營收復合同比 +89%,毛利率 73.5%,税率 16.5%)。
英偉達估值壓制在 15 倍 PE 以下,主要是受競爭對手搶單風險以及 AI 行業整體回調的影響。但結合增速來看,在年增 80%+ 的情況下,估值僅有 13 倍 PE,下跌的空間也相對有限(也是股價相對抗跌的一個因素)。近期市場傳出 OpenAI 將用英偉達 GPU 支撐 GPT-6.1 Sol 的 Ultrafast 模式,依然體現了公司在市場中的產品優勢。
當然也需要注意到英偉達當前的體量已經達到 5 萬億美元以上,大幅上漲需要大量資金才能拉動。在當前 AI 產業鏈承壓的情況下(如 Anthropic ARR),英偉達更大可能在 10-15 倍 PE 之間震盪,大致對應於 180-260 美元的區間內。
以下是本次 GTC 歐洲大會的主要內容:
一、主要信息回顧
1. 歐洲投入:過去一年在歐洲投資近 100 億美元,覆蓋初創公司與大小合作項目;僅上週就在法國、英國、瑞典與德國的行程中宣佈投資 14 家初創公司,歐洲合作伙伴累計超過 1.2 萬家。
2. AI 工廠經濟賬
a. 造價:1 吉瓦 AI 工廠總造價約 500 億美元,涵蓋土地、電力、廠房以及計算、網絡、存儲、供電與散熱。
b. 延期成本:每吉瓦預期每年產生數百億美元收入;按每年 400 億美元測算,上線每推遲 3 個月即少收約 100 億美元。
c. 公司判斷:DSX POD 預計把設備到場至產出 token 的時間由 4–5 個月縮短至約 1 個月,公司希望藉此減少閒置算力與閒置資本開支,提升各方盈利。
注:DSX POD 是一套預製化、集裝箱化的 Vera Rubin 機房參考設計。英偉達出設計,合作伙伴在工廠裏生產和組裝。集裝箱內是完整的 Vera Rubin AI 工廠,在交付前完成集成和驗證,運到現場後直接接入場地已備好的電力、冷卻、網絡等配套設施。計算、網絡、佈線、機櫃級供電和液冷全部在製造工廠裏集成安裝好。
3. 量產與需求
a. 量產:Vera Rubin 已全面量產;Spectrum-X 共封裝光學(CPO)交換機為全球首個完全量產的 CPO 產品。
b. 需求:智能體需要思考、推理、反覆迭代並調用工具,token 消耗與 GPU 需求隨之急劇上升;僅為定性表述,未給出量化數據。
c. 交付:NVL72 整機櫃組裝此前已移入供應鏈,全球整機廠都在生產 NVL72,可同時支撐全球數百個數據中心的建設。
二、主題演講詳細內容
1. 平台佈局與性能節奏
a. 框架:把 AI 視為一種製造業,從能源、計算、AI 工廠、模型到應用分五層理解 AI 經濟,公司稱每一層都在增長,英偉達處在計算層。
b. 全棧硬件:Vera Rubin GPU、NVLink 交換、Vera CPU、Spectrum-X 以太網(公司稱已是全球最大網絡公司)、用於 token 生成的 Groq 3 解碼加速器、BlueField-4 存儲加速與 RTX 計算。
c. 軟件:包括 AI 工廠系統軟件、cuDNN 之外的 350 個 CUDA-X 庫以及各領域模型;公司稱 CUDA-X 庫是其開拓新市場的方式。
d. 性能:十年六代架構把 AI 性能提升 100 萬倍,同期摩爾定律約 100 倍;大模型與智能體處理上,Blackwell 約為 Hopper 的 30 倍,Vera Rubin 兩年內再較 Blackwell 提升約 30 倍。
e. 計算範圍:Blackwell 首推機架級計算;Vera Rubin 把處理對象從模型擴展到整個智能體:GPU 跑大模型,Vera CPU 跑 harness(智能體的編排框架),另有計算機負責知識所需的數據處理與 CUDA-X 工具。
2. Vera Rubin 硬件
a. 計算托盤:無線纜、100% 液冷(Grace Blackwell 為 80%),單節點組裝時間由約 2 小時縮短到 5 分鐘以內,製造週轉、可靠性與性能都更好。
b. NVLink:交換托盤把 72 顆 GPU 連成一個整體,單顆 GPU 算力 20 petaFLOPS。
c. Vera CPU:每時鐘週期 8 條指令,採用 LPDDR 內存系統兼顧高帶寬與能效,公司稱片上互聯為業界最快,主要承擔數據處理與智能體會話。
d. CPO 交換機:512 個 200Gb/s 端口;激光經光學器件直連芯片,硅光通過與台積電共同開發的 COUPE 工藝直接貼裝在芯片上,信號不再經過 PCB 與光模塊,數據速率與質量更高。
3. AI 工廠交付:DSX 與 DSX POD
a. DSX:全棧 AI 工廠參考架構,與 PTC、達索系統、施耐德電氣、Jacobs、西門子、Procore 等共同設計,建設前先在 Omniverse 數字孿生中驗證性能、功耗、用水與規模。
b. 供電:端到端控制迴路按負載動態分配電力,同等產出省電 30%。
c. 散熱與用水:Vera Rubin 系統按閉環液冷設計,冷卻液温度最高 45°C;適宜氣候下用乾冷器向空氣散熱、不蒸發水,2 吉瓦規模每天可節水 5,400 萬升,相當於 18 萬户家庭的日用水量。
d. DSX POD(新發布):由 7 個 Vera Rubin NVL72 液冷計算機櫃加 17 公里 Spectrum-X 線纜組成,出廠前完成集成、佈線與測試,裝入可運輸的集裝箱交付。
e. 部署:以乾冷器替代蒸發冷卻,800V 直流供電到機櫃;場地水電就緒後,現場部署由數月縮短至數天。繼 NVL72 之後,這一步把佈線、聯調與老化測試也前移到供應鏈。
4. 競爭優勢與客户結構
a. 通用架構:公司稱其是唯一通用的加速計算架構,不只針對 Transformer 等單一算法,覆蓋流體、粒子、量子化學、圖像與數據處理等;架構 25 年保持一致,裝機量與覆蓋領域持續擴大。
b. 全棧交付:不少公司想自研芯片,但多數企業只想部署 AI 基礎設施來跑業務,自己設計芯片、搭建超算、編寫全部軟件超出其能力;CUDA 加全棧 AI 工廠讓英偉達能進入原本進不去的市場。
c. 客户版圖:雲廠商仍是很大的業務;此外有 AI 原生公司、新雲(各地區都想把本地能源留給本地企業,如 Mistral、Nebius,中亞的 Firebird、非洲的 Cassava),以及面向企業的 OEM 與 ODM。
d. AI 實驗室:去年只談 OpenAI,如今 OpenAI、Anthropic、Meta 的 Muse、Grok 與 Gemini 都在前沿競爭。
e. 終端行業與耐用性:公司稱最重要的是汽車、製造、醫療、金融等終端行業都轉型為 AI 公司;同一套基礎設施可用於數據處理、訓練、後訓練、推理與智能體處理全流程,軟件持續更新,因此可靈活調配且經久耐用。
5. 智能體:五要素與安全
a. 五要素:智能體由模型、harness、安全沙箱、知識與工具五部分組成;年初的開源智能體 OpenClaw 開啓了這一輪智能體浪潮。
b. OpenShell:開源(Apache 2.0)安全運行時,在系統調用、文件訪問與網絡連接層面執行策略,每次策略變更經形式化驗證、不超出權限上限;密鑰留在沙箱之外,對外網絡請求一律經沙箱外的監督程序審核。
c. Sentry:可選的硬件級防護,運行在 BlueField-4 上,在硬件隔離域內監控智能體,發現異常可在毫秒級切斷與模型的連接並隔離,同時留下防篡改記錄。
d. 採用:公司稱前沿實驗室、操作系統、網絡安全與平台公司幾乎都已宣佈採用 OpenShell,並與 Anthropic 合作推出 Claude OpenShell 智能體;每個任務、每個用户所需權限都不同,授權、執行與監控都要動態完成。
6. 智能體:模型與知識
a. 模型:未來會同時用閉源、開源與定製模型;英偉達開源 Nemotron(語言)、Cosmos(世界模型)、GR00T(人形機器人)、Alpamayo(自動駕駛)、Ising(量子 - 經典計算)與 Earth-2(物理),並開放訓練數據與復現腳本。
b. 定位:公司承認自家開源模型(尤其是語言模型)未必最前沿,但經私有數據後訓練可達前沿水平,如 AI21 與 Alice、Baseten 與 CodeRabbit、Trajectory 與 Harvey、Scale 與 Skydance、Palantir 與 Tampa General Hospital。
c. 知識:Agent Knowledge Foundation 包括 Nemotron Parse(解析非結構化文檔)、Embed(向量檢索)與 Rerank(結果重排序),公司稱均居排行榜首位。
d. 結構化數據:Kumo 基於結構化數據庫做預測,例如結合供應商延期通知,預判哪些訂單會缺貨、延誤多久,再用向量檢索找到替代零部件的工程文檔。
7. 智能體:工具與軟件公司
a. 工具:CUDA-X 讓智能體調用的仿真、求解與數據處理工具比純 CPU 快 10–100 倍,公司稱工具是智能體能做實際工作的關鍵。
b. 案例:Lila Sciences 用 BioNeMo 設計 B 細胞淋巴瘤療法;西門子埃爾朗根電子工廠用 Cosmos 導入新品;達索系統用 Nemotron 與 SIMULIA 把大眾 Golf 車門改型到 Tiguan。
c. 軟件公司:針對"AI 將終結軟件和工具公司"的説法,公司認為恰恰相反,工具的使用者會比以往更多,每家工具公司都會提供擅長使用自家工具的智能體;Cadence、CrowdStrike、達索系統、IQVIA 等都在構建智能體。
8. 物理 AI:電信與醫療
a. 電信:AI 將大幅提升頻譜效率;公司預計電信運營商約 10 萬個站點、約 100 吉瓦的分佈式基站與數據中心,未來都會演進為分佈式 AI 基礎設施。
b. 進展:經過近 8 年研發,上週與諾基亞在 T-Mobile 網絡上打通首個商用電話,先由 CUDA 處理傳統通話,再在其上疊加 AI。
c. 醫療:自適應放療需要實時感知腫瘤與身體形變、精準分割並引導放療,公司將其視為一種機器人手術。
9. 物理 AI:自動駕駛與人形機器人
a. Robotaxi:公司認為每家車企都會讓車輛接入網約車平台(Uber、Bolt、Grab、Lyft 等);全球每年行駛約 1 萬億英里,未來很多里程將以每英里 1–2 美元在 Robotaxi 上發生,機會巨大但高度分散。
b. Hyperion:標準架構含 14 個攝像頭、9 個雷達、3 個激光雷達與多個超聲波傳感器,由雙 NVIDIA GPU 計算,已成為行業標準並逐一導入各車隊;英偉達自身也是自動駕駛軟件商之一。
c. 新增車型:大眾廂式車、捷豹路虎全新車型、沃爾沃車隊與梅賽德斯 - 奔馳下一代車型將兼容 Hyperion,接入 Robotaxi 網約車網絡。
d. 人形機器人:可能是下一個規模極大的產業和出貨量最大的機器人構型;標準化構型才能帶來規模與技術飛輪,中小企業無需機器人團隊,演示即可教會機器人;歐洲在機電一體化與精密製造上積累深厚。
e. 參考機器人:物理 AI 需要訓練、數字孿生中的技能學習與機器人本體三台計算機;與 Agile Robots 合作的參考機器人 Agile ONE 將於 2027 年一季度上市,預裝計算機與軟件、開箱即用。
10. PC 與工作站
a. RTX Spark:與微軟合作四年研發 N1X 芯片,聯合 PC 產業推出台式機、筆記本與工作站,現已上市;算力 1 petaflops、內存 128GB,相當於 2016 年交付 OpenAI、需兩人抬上樓的 DGX-1。
b. DGX Station:運行 Windows,算力 20 petaflops、內存 748GB,可運行 CATIA、Autodesk、Adobe、Cadence、Synopsys 等軟件,預計今年底上市。
c. 演示:在 RTX Spark 上用 Hermes harness 加 Nemotron 與 OpenAI 的 GPT-6 Astra 模型,調用 FreeCAD、Blender、Isaac Sim 等工具,為 Pollen Robotics 的小型機器人建模,雲端訓練後部署到實體機器人。
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。