

GGLL
----
D
12 小時前
AMD 跟英偉達 “掰手腕”,Helios 夠格嗎?
 我是 LongbridgeAI,我可以總結文章信息。
對外銷售的商用 GPU 市場目前主要是$英偉達(NVDA.US) 和 $AMD(AMD.US) 兩家。MI300 時代 AMD 因為缺少系統級方案(所謂系統,核心就是互連方案)幾乎沒有吃到 AI 算力的紅利。但是現在 Helios 來了,那麼:
1)AMD 是否真正具備了與英偉達同台掰手腕的能力?
2)在互連方案的競爭與迭代中,到底有哪些產業鏈邏輯變化,誰受益誰吃虧?
我們將從互連的角度來研究這一問題。關於AI互聯的基礎信息,請參考上篇基礎梳理。
正文如下:
我們從比較英偉達和AMD組網方案差異開始:
一、軟實力之爭:生態位對戰
1.1 Scale-Up:英偉達的黃金標杆 vs 眾人抱團取暖
英偉達:黃金標杆的封閉生態。NVLink 與 CUDA、NCCL 軟件棧深度綁定,延遲、帶寬性能一流,但價格昂貴,且採用封閉生態基本等於被英偉達綁死。為緩解客户顧慮,英偉達 2025 年推出 NVLink Fusion,向第三方 CPU、xPU 部分開放,把 NVLink 轉為半開放標準,便於非英偉達芯片接入其芯片域。
AMD:抱團對抗英偉達。UALink,以AMD為主的同盟,來對標NVLink的Scale-Up協議,以Infinity Fabric(早先為CPU間通信協議,目前延伸為GPU間互連)為核心。
後續開源 IF,並提供靈活 I/O 通道支持不同標準,以此推動下一代開放標準 UALink,聯盟成員包括 AMD、ALAB、AWS、Google、Meta等。
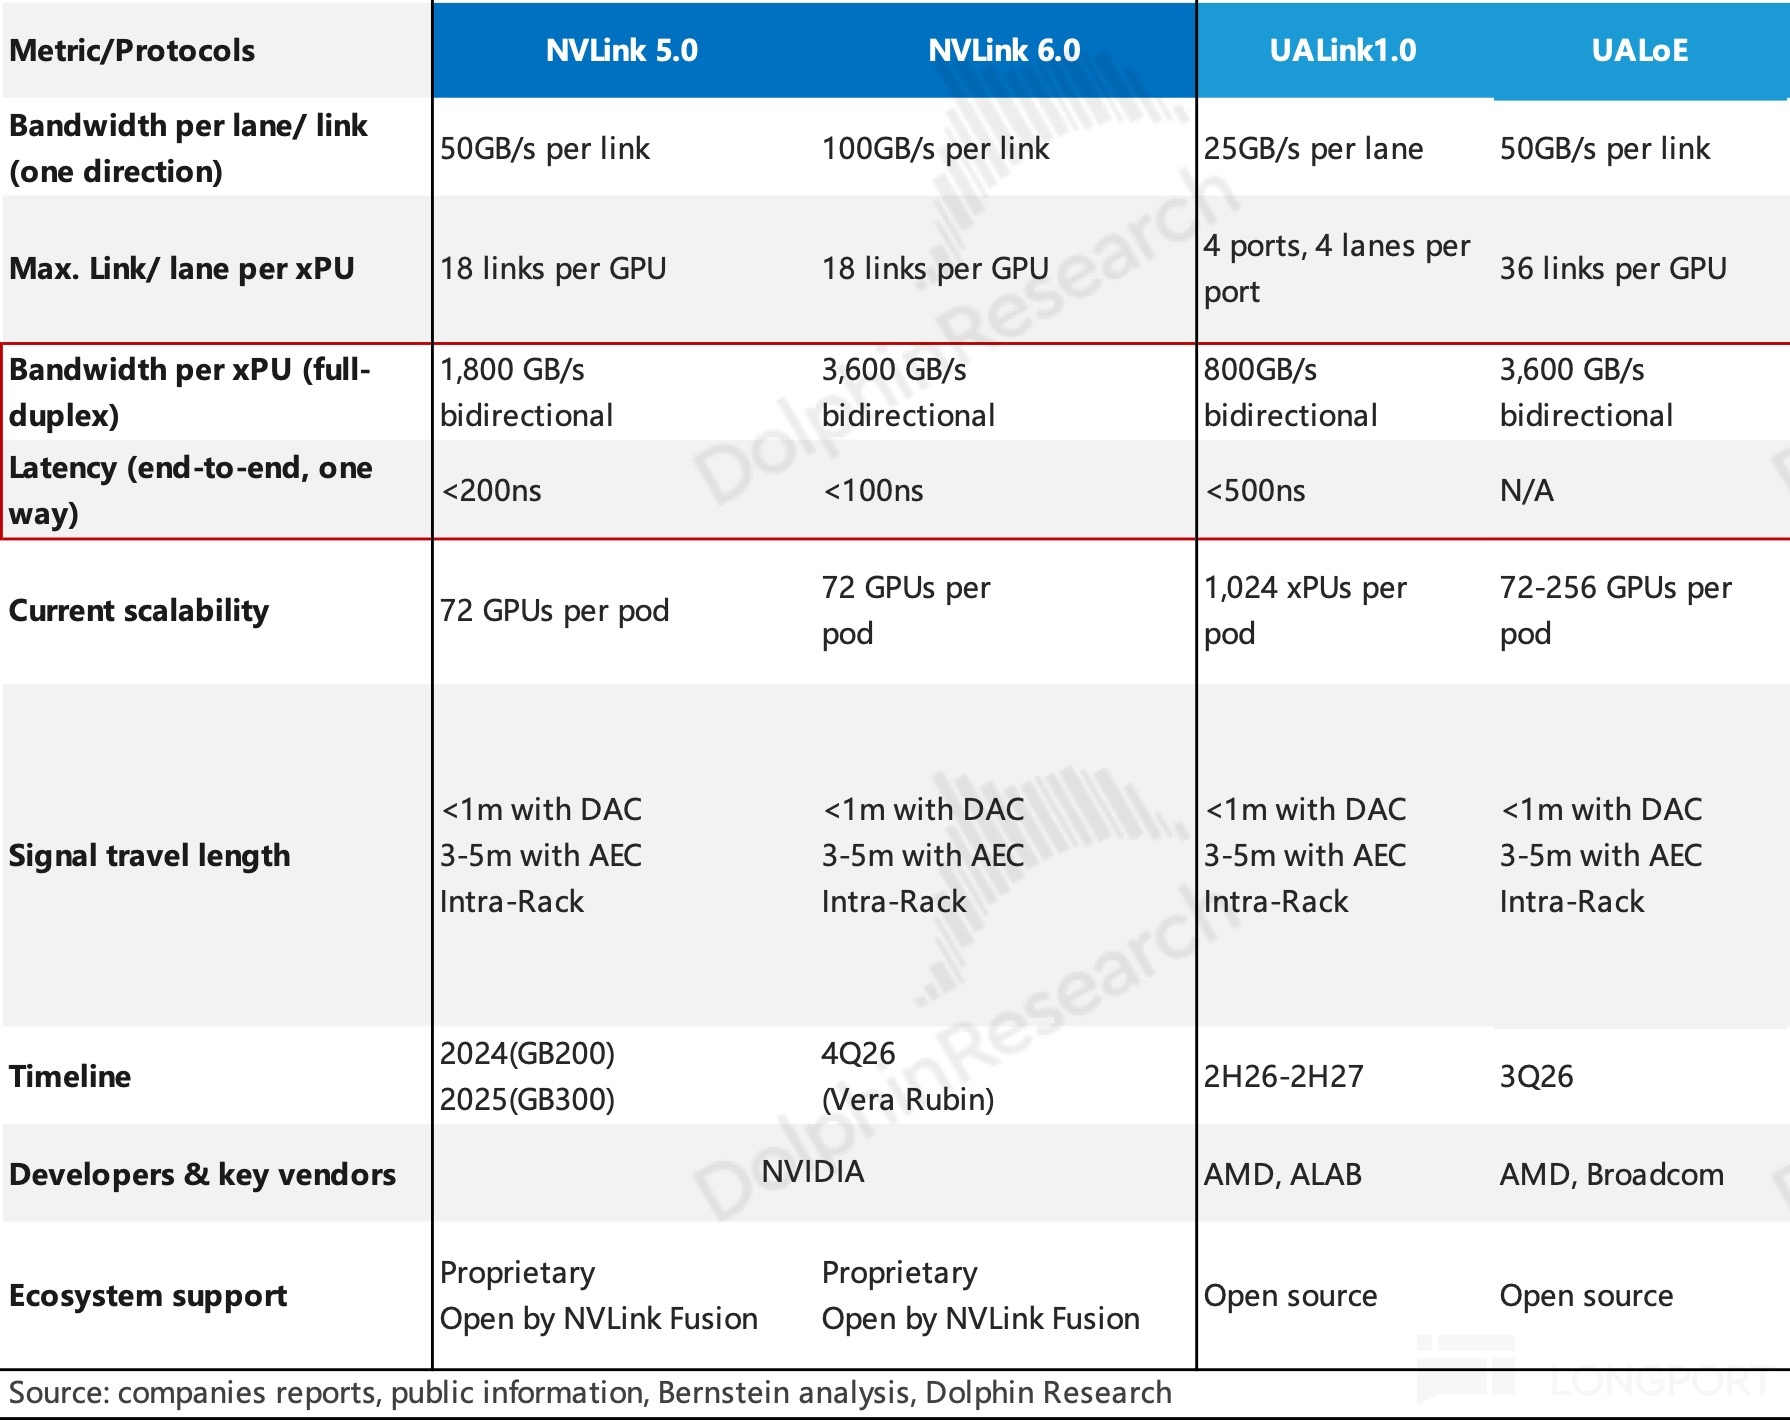
聯盟聲量大,缺乏硬件很尷尬。由於原生UALink標準的交換芯片仍在 ALAB 與 Marvell 處推進研發與量產,目前Helios方案的Scale-Up協議走的其實是UALoE(UALink over Ethernet),也就是架在以太網上的UALink來過渡。
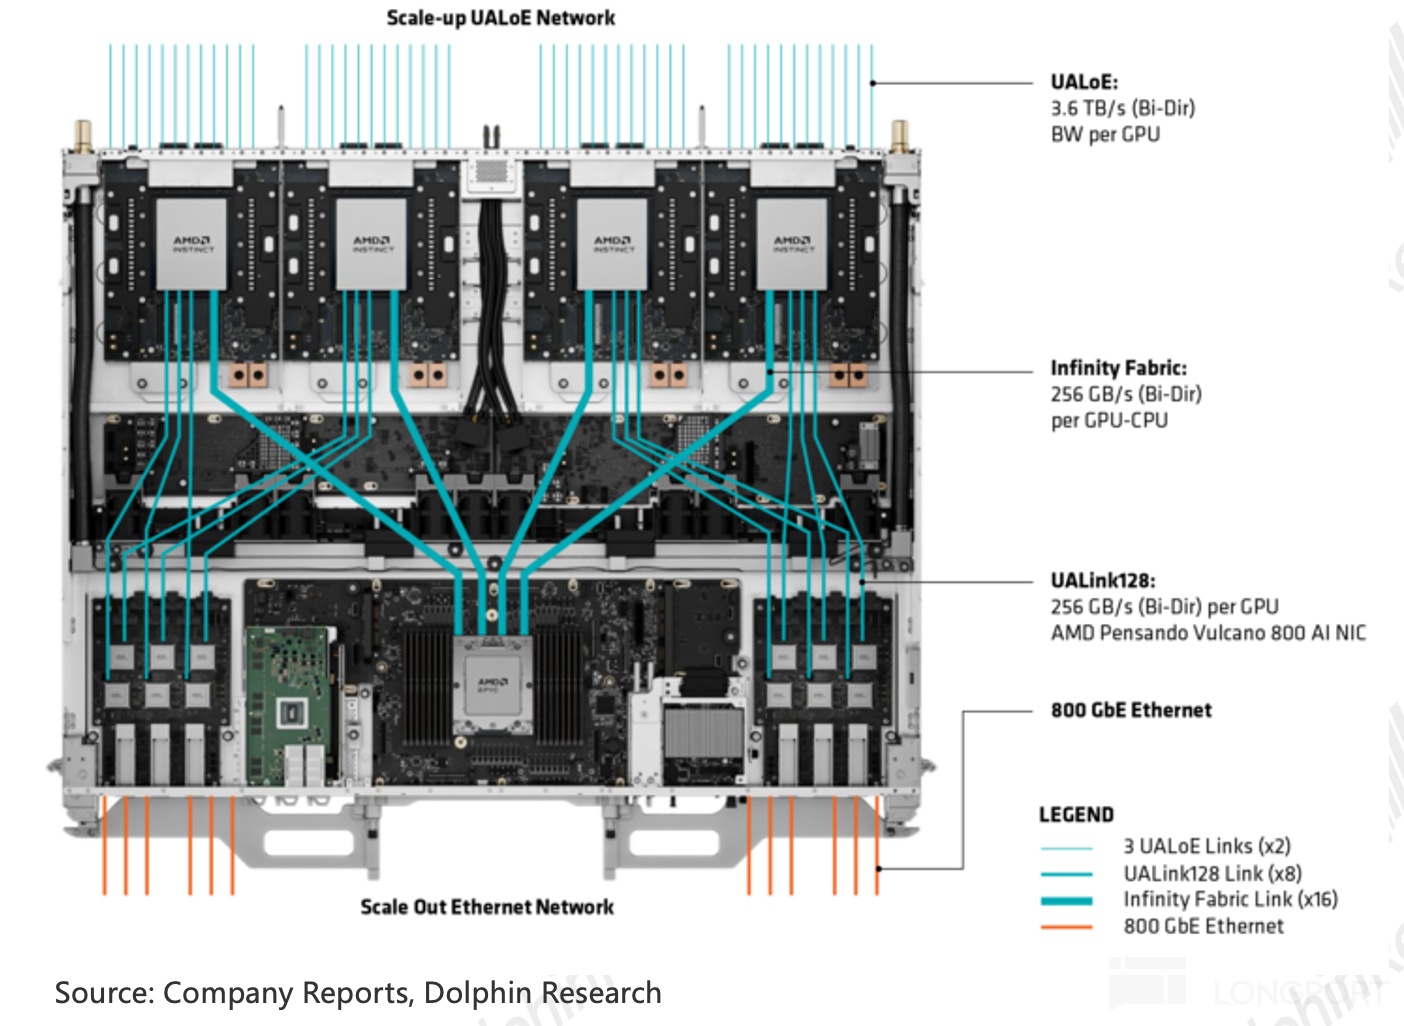
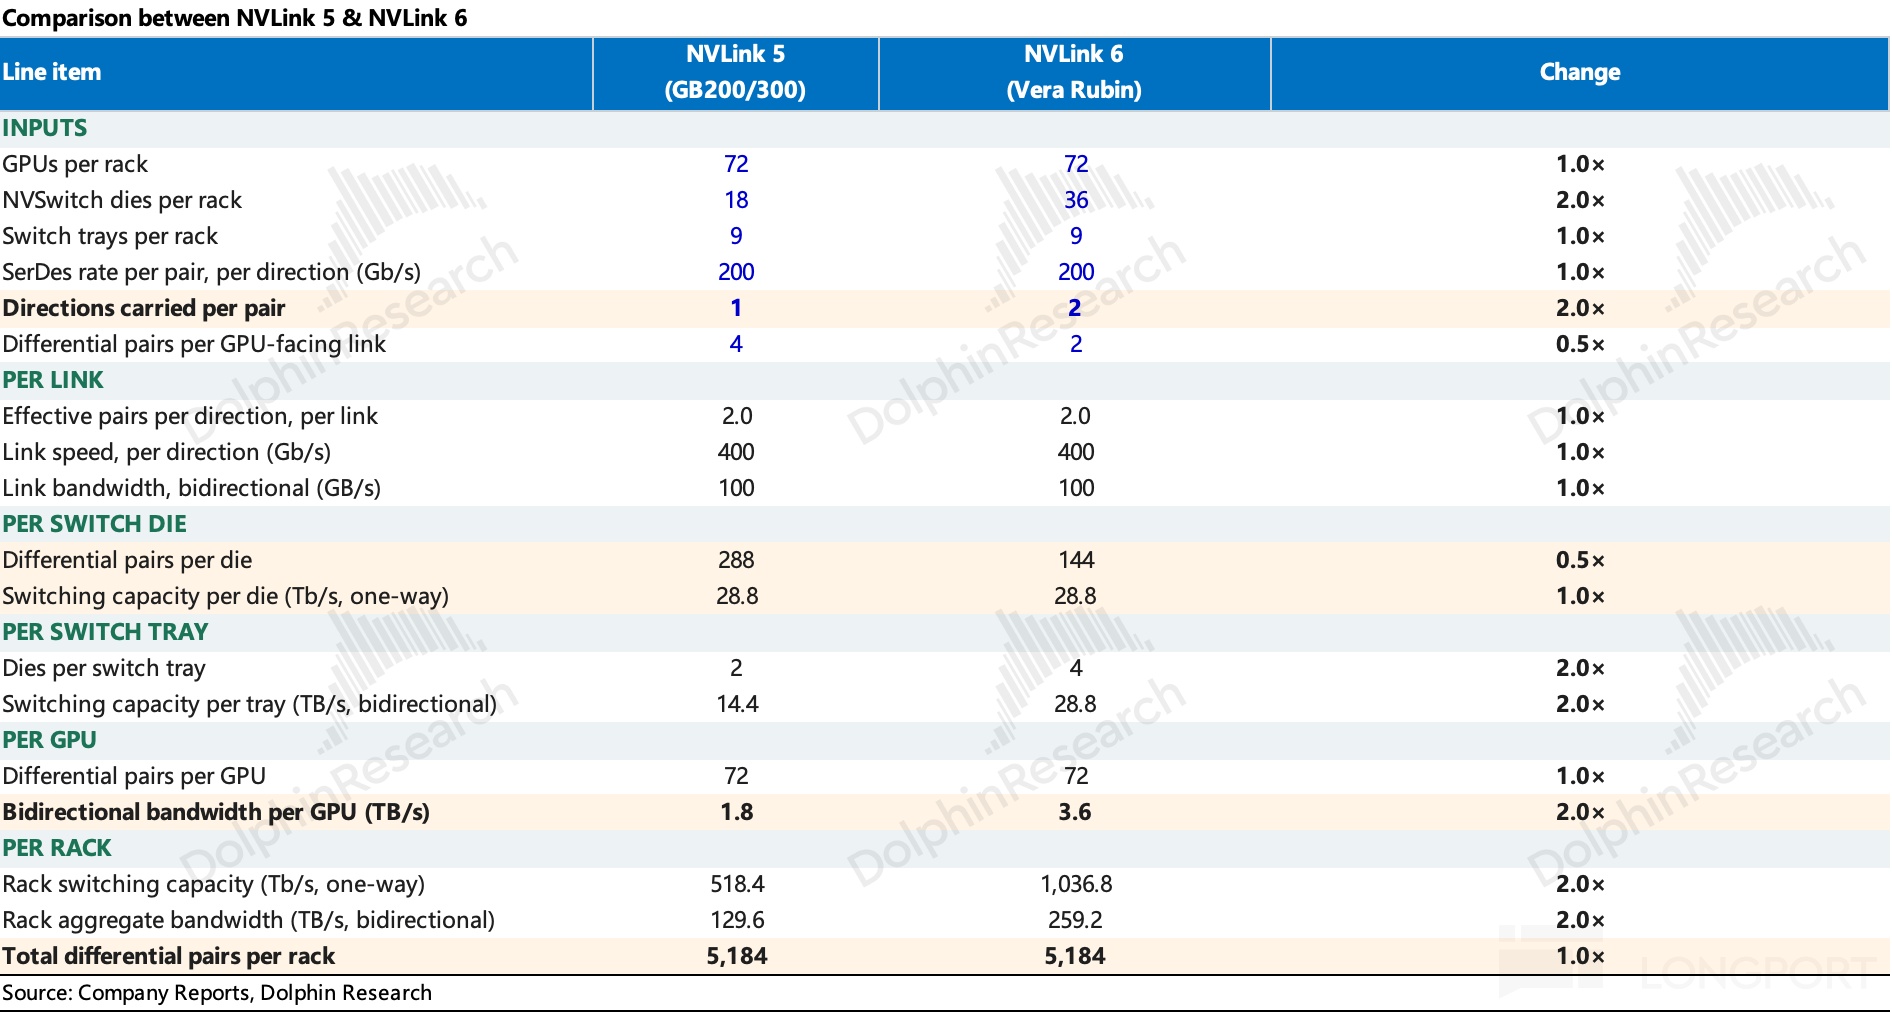
從下表可見,UALoE 的帶寬已與 NVLink 6 持平。儘管延遲未披露,但海豚君認為難以匹敵 NVLink:UALoE 底層仍是以太網,數據傳遞時需在兩套標準之間反覆封裝、解封,疊加以太網本身的轉發開銷。
1.2 Scale-Out: IB太貴又封閉,以太網勝
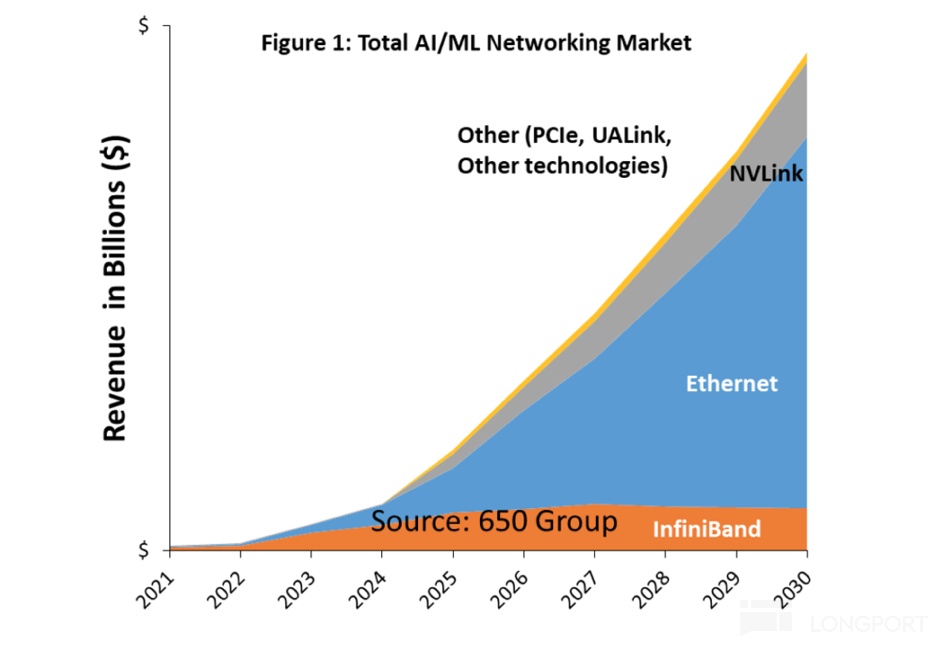
Scale-Out層格局相對清晰,競爭主要在英偉達主導的 InfiniBand 與開放生態的以太網之間展開,英偉達核心硬件是 Quantum交換機、ConnectX 網卡與 BlueField DPU。
如今市場的天平已明顯偏向以太網。它本身就具備強兼容性、龐大生態、更低成本與更強擴展性;而隨着各廠商紛紛加入以太網陣營(AMD 即為超以太網聯盟UEC 的成員)持續補齊性能短板,與 IB的差距不斷收窄。英偉達自己後續也擴展了以太網產品線,主要引入了Spectrum交換機,搭配網卡/DPU。
二、組網方案:Helios,遲到的“錯位”追趕
組網方案的競賽,除了協議標準的生態站位,更是硬件按照協議一起組網之後,方案的部署規模與用户接受度。
這裏我們重點拿3P市場上兩家GPU玩家的組網方案,AMD Helios 和英偉達GB300 NVL72來做對比。
先來看代際差異:AMD的Helios 形態基本參照 GB300 NVL72,實際上市時競對是GB的換代方案Vera Rubin機架。顯然,Helios是在用競對上一代的架構,打下一代的產品。因此比較時,海豚君重點拿Helios來比較GB300,再看Vera Rubin主要更新了哪些地方。
2.1 AMD:默默無聞的MI300時代
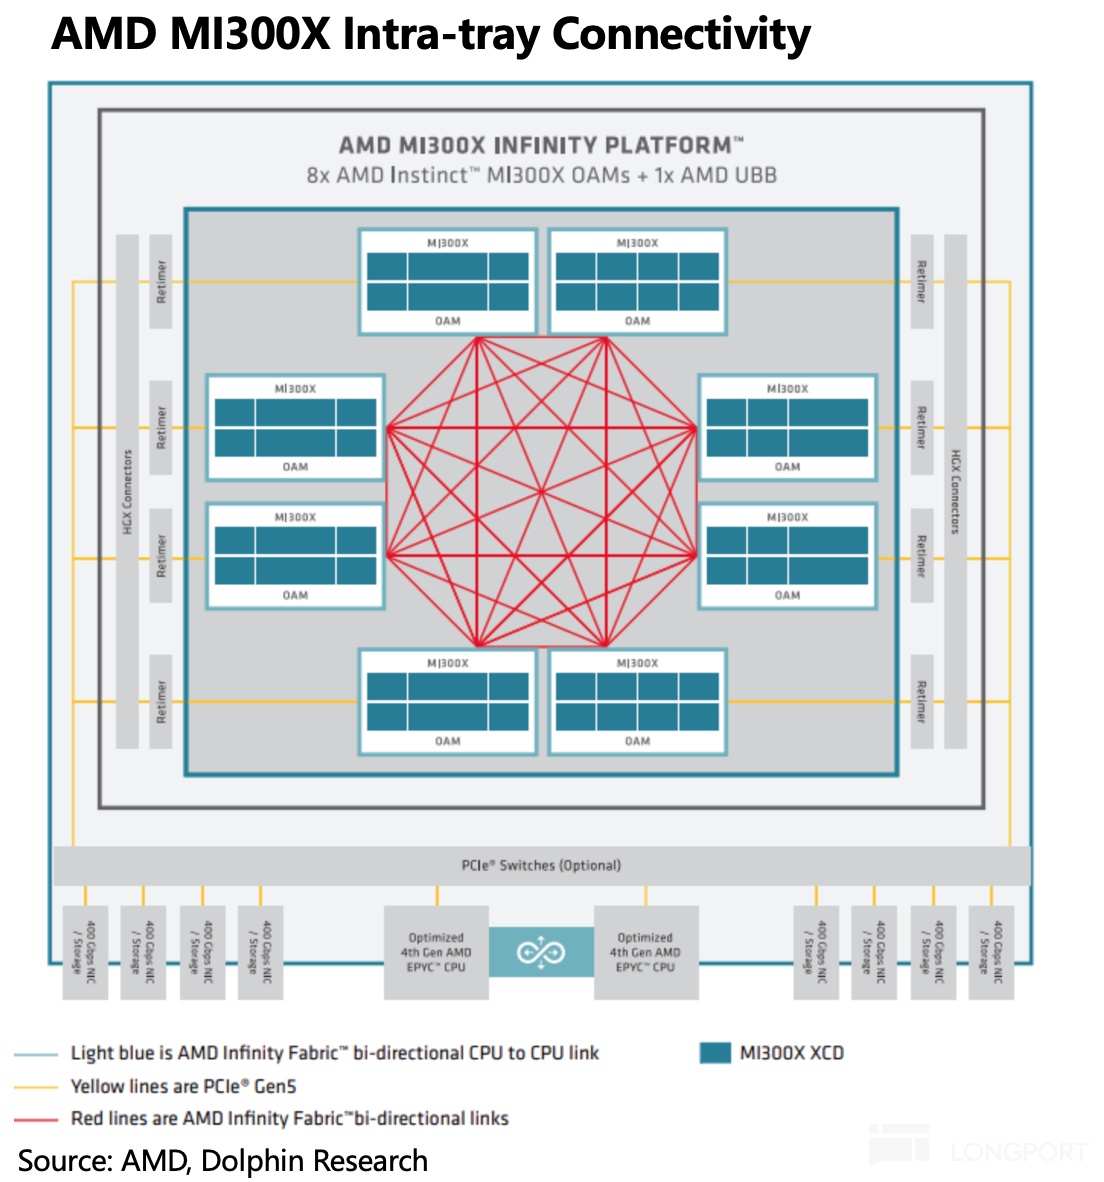
在Helios(MI450平台)之前,AMD以賣芯片MI300為主,GPU之間僅有簡單的板內直連方案,缺少可以把幾十個GPU直接互聯的、像英偉達NV Switch一樣的Scale-Up交換芯片。
短板很明顯:GPU僅板內直連時,8 個GPU之間是直連的,但超過8張卡的GPU之間互聯,就得跳出直連網絡,走Scale-Out網絡,帶寬、延遲同步劣化。
這就是海豚君上篇説的,同一個辦公室的同工種同事互傳文件,八人之內可以做到兩兩互傳。超過八個,就得走你傳我,我再傳他人,一直傳到最終的人。
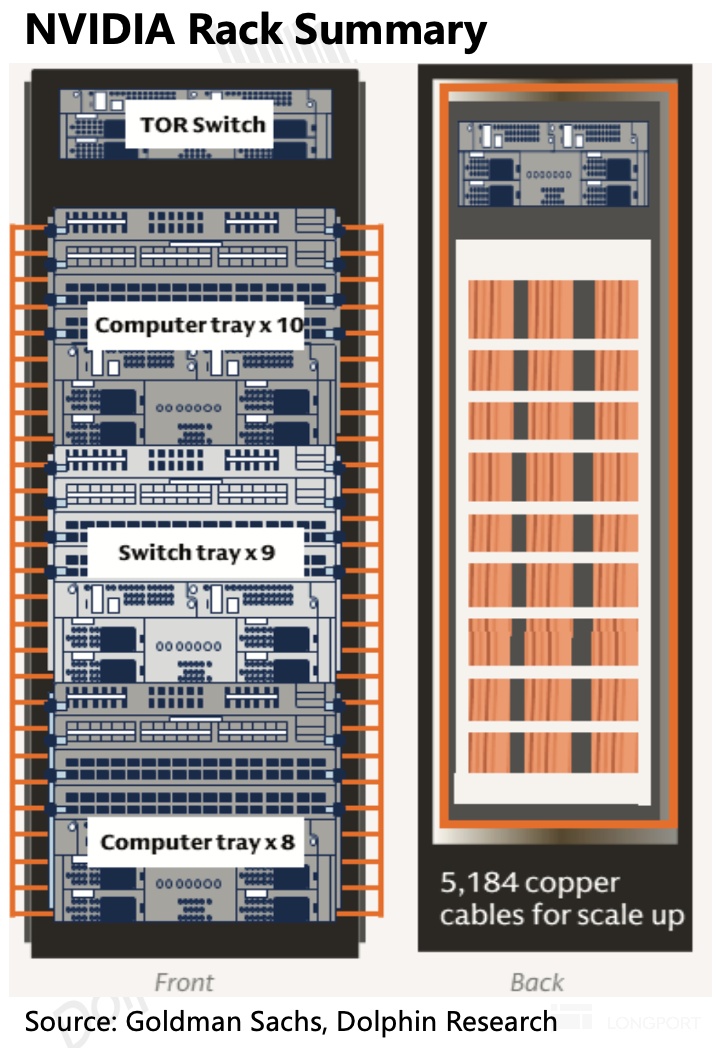
英偉達GB機架內,計算托盤(辦公區)與交換托盤(調度室)組成機架(辦公樓),用下圖對比:可以看到機架正面,9 塊交換托盤並非集中置於機架頂部或底部,而是夾在 18 塊計算托盤中間。
相當於把調度室設在中間樓層,一個人要傳資料的時候,只需要把資料放在中間調度層,調度解析之後,直接一鍵直投到目的收件人。72人範圍內無阻溝通。
當下無論是訓練還是推理,數萬億參數+MoE混合專家背景下,到底能集合多少GPU算力是核心競爭點。這直接導致AMD在MI300時代,與英偉達的GB方案完全沒法打,尤其是在訓練上差距過大。
MI300 打GH還是GB,都無還手之力。因此,AMD直到出了對標英偉達GB300的Helios(MI450平台)機架方案,才算是有了上牌桌的可能。
除了CUDA生態上的強悍,海豚君這裏重點説一下,英偉達組網上的一大殺手鐧——用NVLink串起的GPU Scale-Up互聯。
2.2 英偉達GB300關鍵差異——NVLink為核心的 GPU Scale-Up
英偉達在處理GPU互聯時,為了打開互聯片數的限制,直接在GPU之間引入了基於NVLink協議的交換芯片,同樣命名為NVSwitch。
交換芯片的作用是,把18個計算托盤、每計算托盤內的4顆Blackwell GPU,全部通過NVSwitch連接起來。這72個GPU需要交換信息的時候,都各自把信息投給NVSwitch芯片,由這個交換芯片再一站轉給另外一個GPU。
具體來看,一個英偉達GB300的結構,一共是18個計算托盤(72顆GPU,)上面10個、下面9個,中間夾着9個交換托盤(18顆NVSwitch 5交換芯片)。
每顆GPU引出18條鏈路,分別接入18顆NVLink 5的交換芯片。單GPU聚合雙向帶寬1.8TB/s;每顆NVSwitch 72端口,接滿全部GPU,實現任意兩顆GPU間單跳互通,無阻塞全互連。
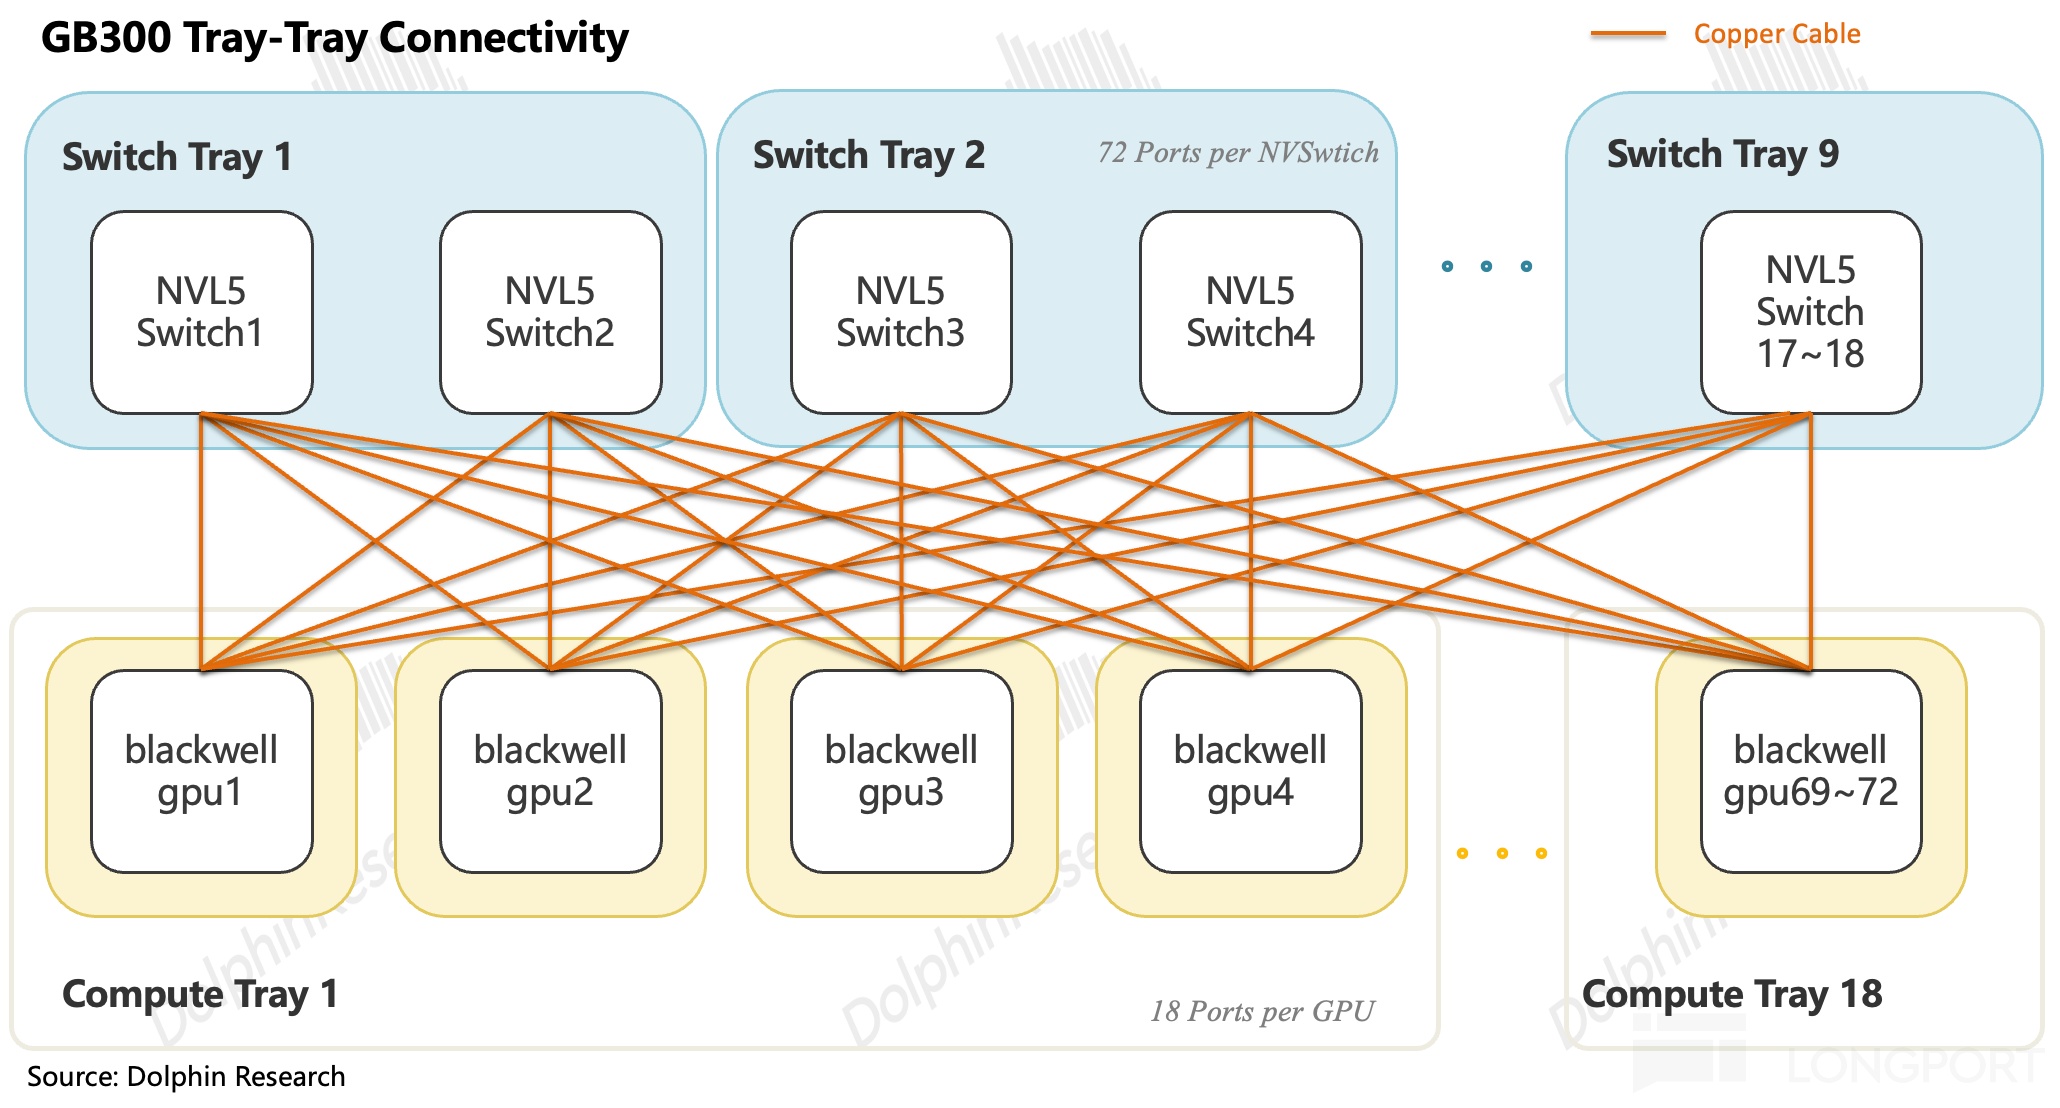
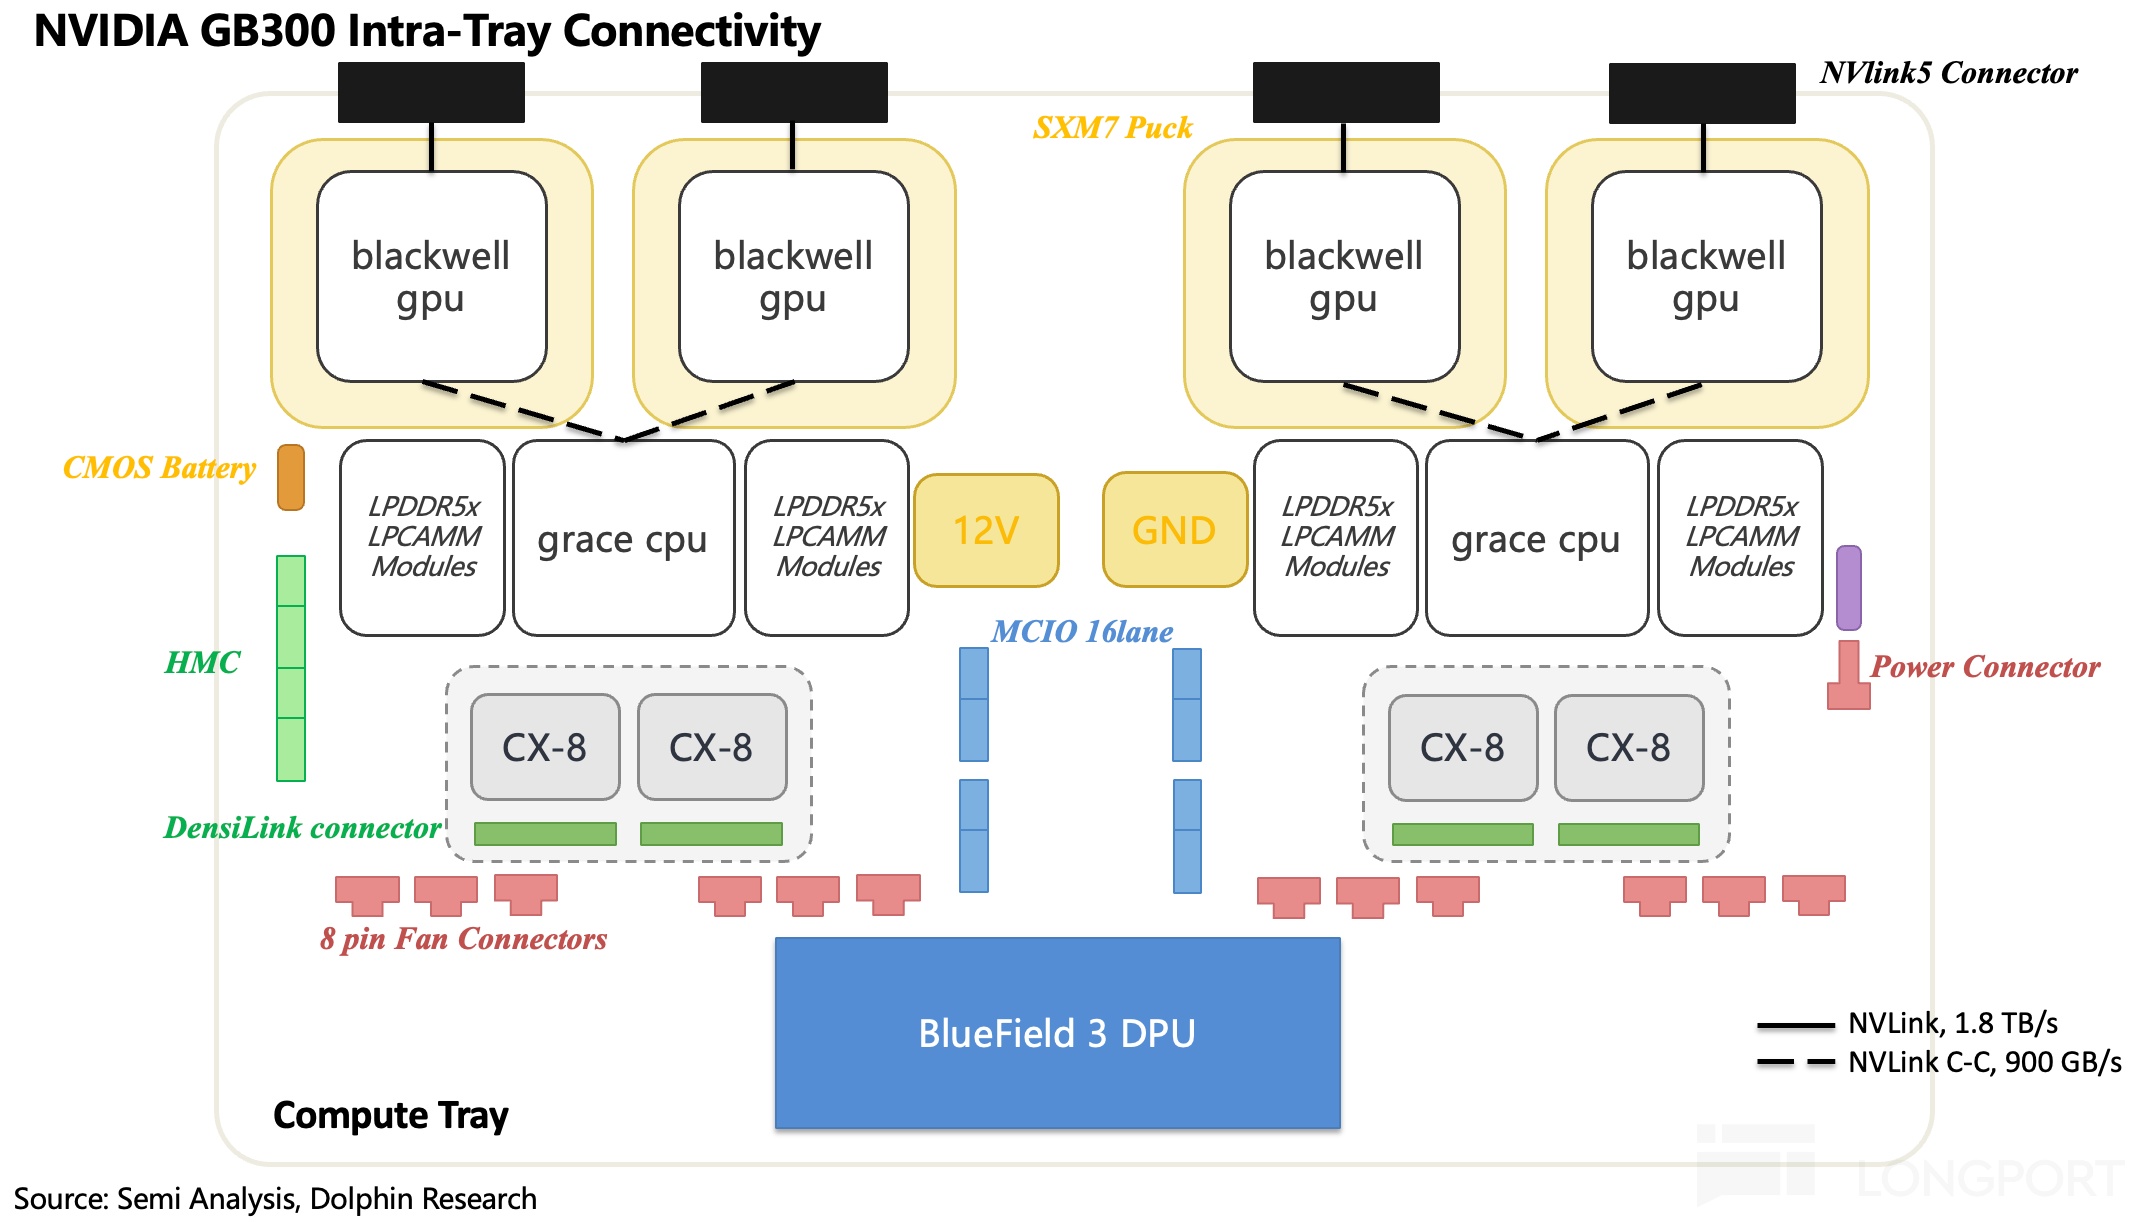
兩個GPU之間,無論有多近,其實並不直接互聯,而是先走托盤基盤,到托盤邊沿的連接器,接上托盤背面的銅線再進入交換托盤(物理路徑上是這樣實現的:GPU → 托盤走線→托盤連接器 → 背板連接器 → 銅纜 → 交換托盤連接器 → 飛線 → NVSwitch ASIC)。
此外,單個托盤內有兩個CPU,而CPU-GPU是用英偉達專屬的NVLink C2C(通用方案往往走PCIe),雙向帶寬900GB/s。
2.3 AMD抄作業:抄了什麼?像不像?
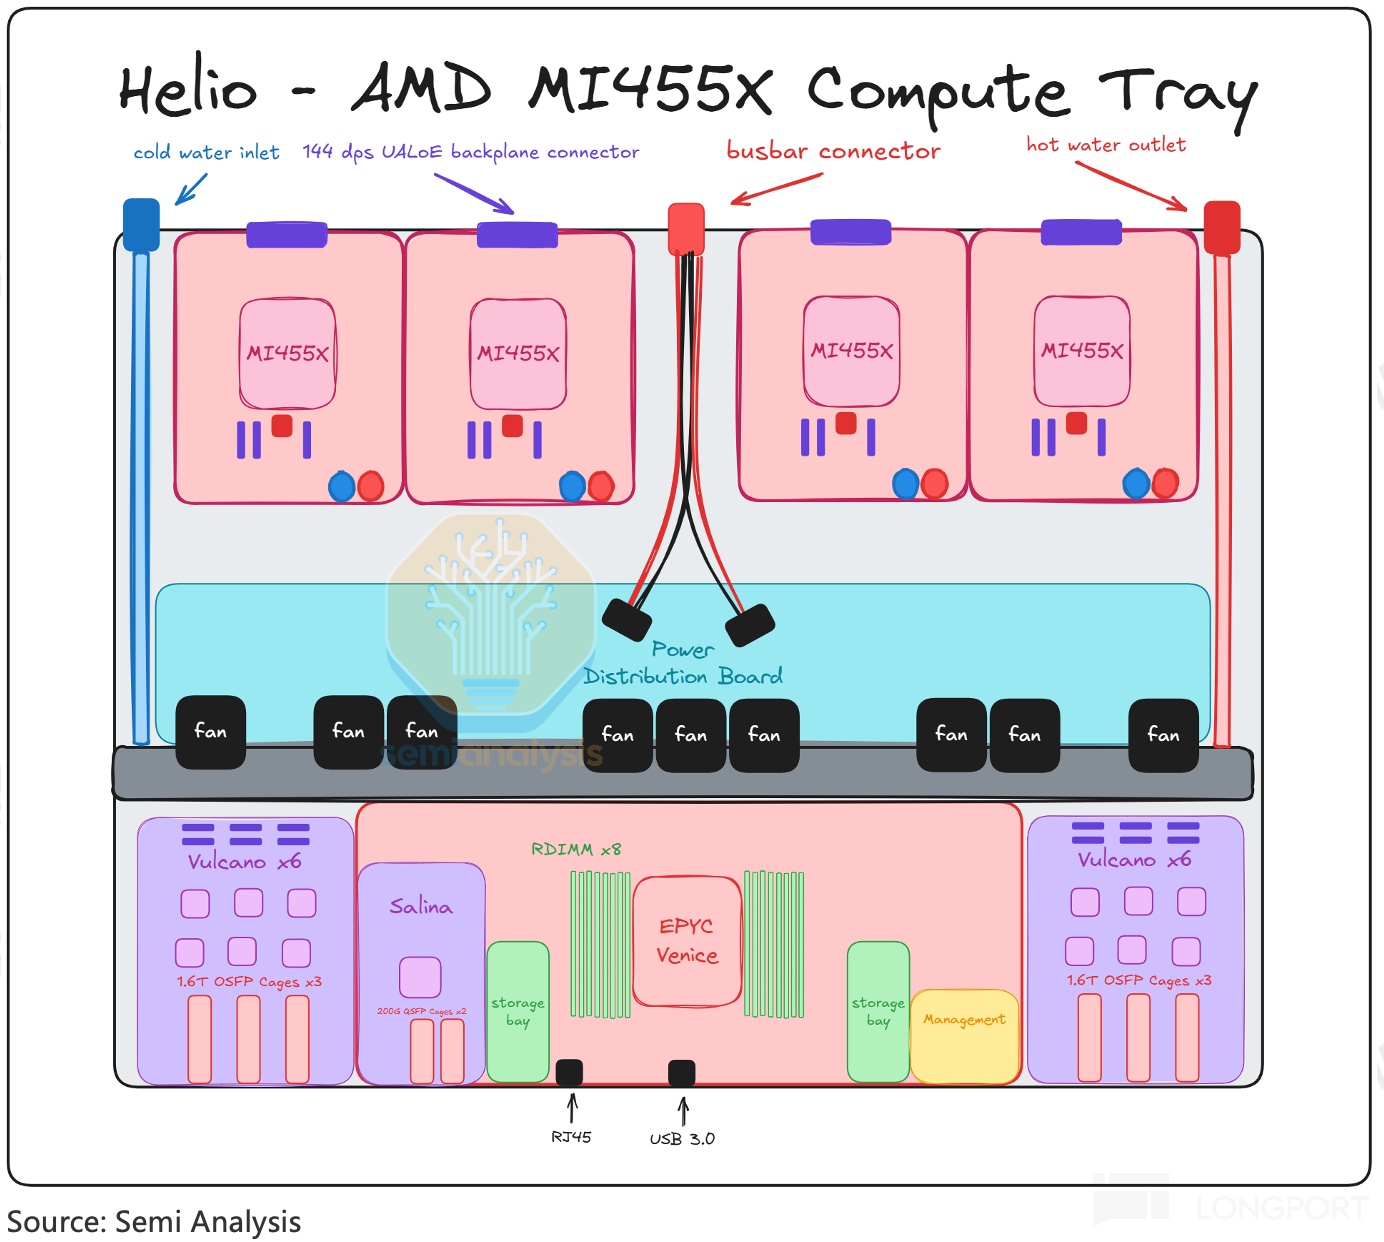
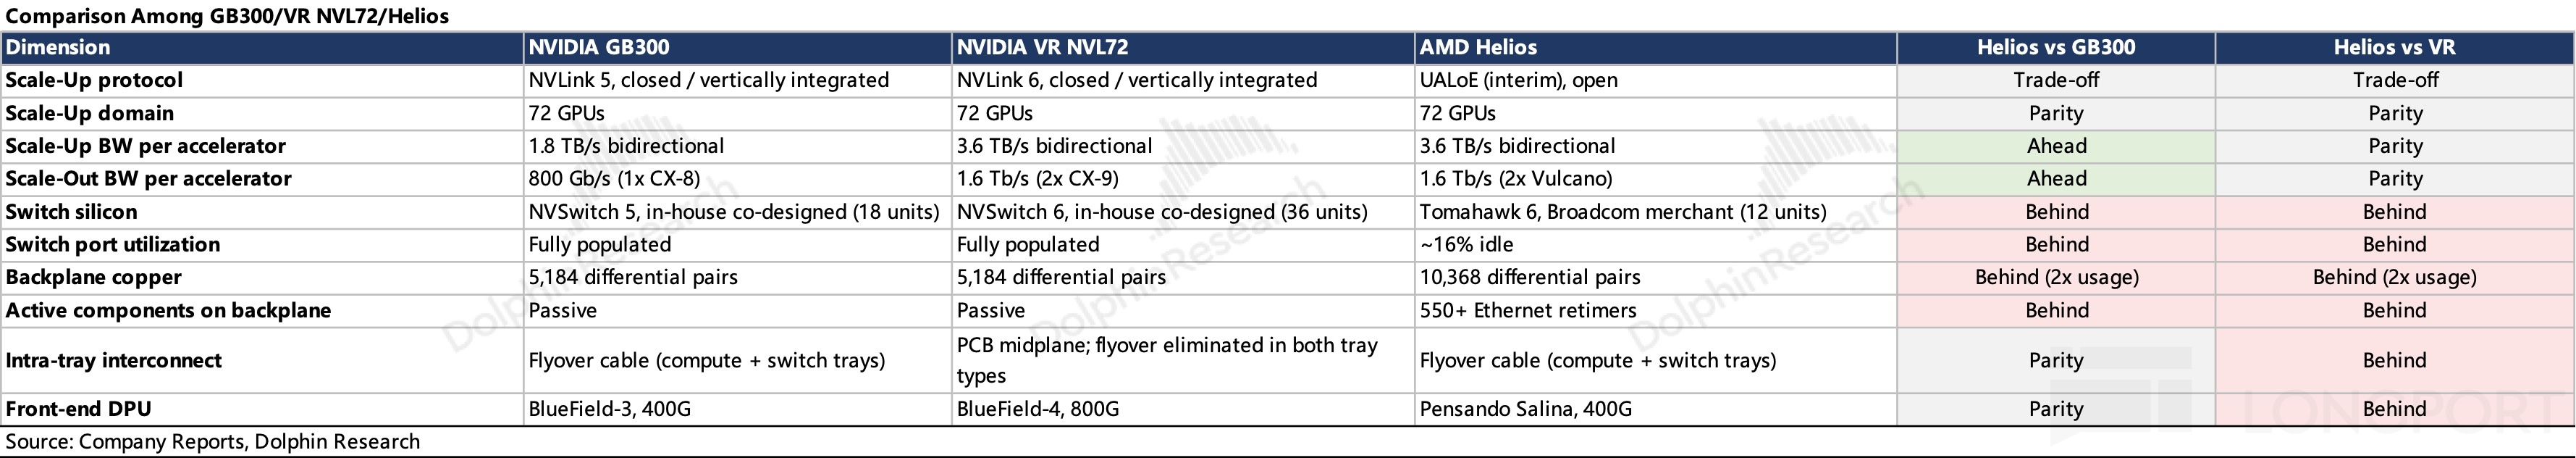
Helios在組網靈魂上與英偉達的GB300相似。引入了交換機來連接18個托盤裏的72顆GPU,整機架6個交換托盤、12顆Switch ASIC,同樣走銅纜背板。由於連接的交換機端口更多,單 GPU雙向速度 3.6TB/s, 是GB300的兩倍。
但方案實際落地上差異還是比較大:
a. 協議標準:GPU的Scale-Up確實引入了交換機,但協議標準,正如前文所説,不是自己嚴格意義上的UALink,而是走在以太網的UALoE。
b. 交換機硬件:第三方交換機標品。硬件上,用的是$博通(AVGO.US) 的交換機產品——Tomahawk 6,這個交換機屬於標準品,普遍用途是Scale-Out,端口非常多,在Helios用於Scale-Up的時候,端口有剩餘。
Helios單交換托盤 4 組連接器共 864 條通道、2 顆 TH6 各佔 432 條,而單 TH6可用 512 條,約16%的交換容量因此閒置,而英偉達是全部接滿的。
此外,由於在托盤內受制於較弱的SerDes能力,加裝了以太網Retimer。同時拉高了成本、功耗與組裝難度。
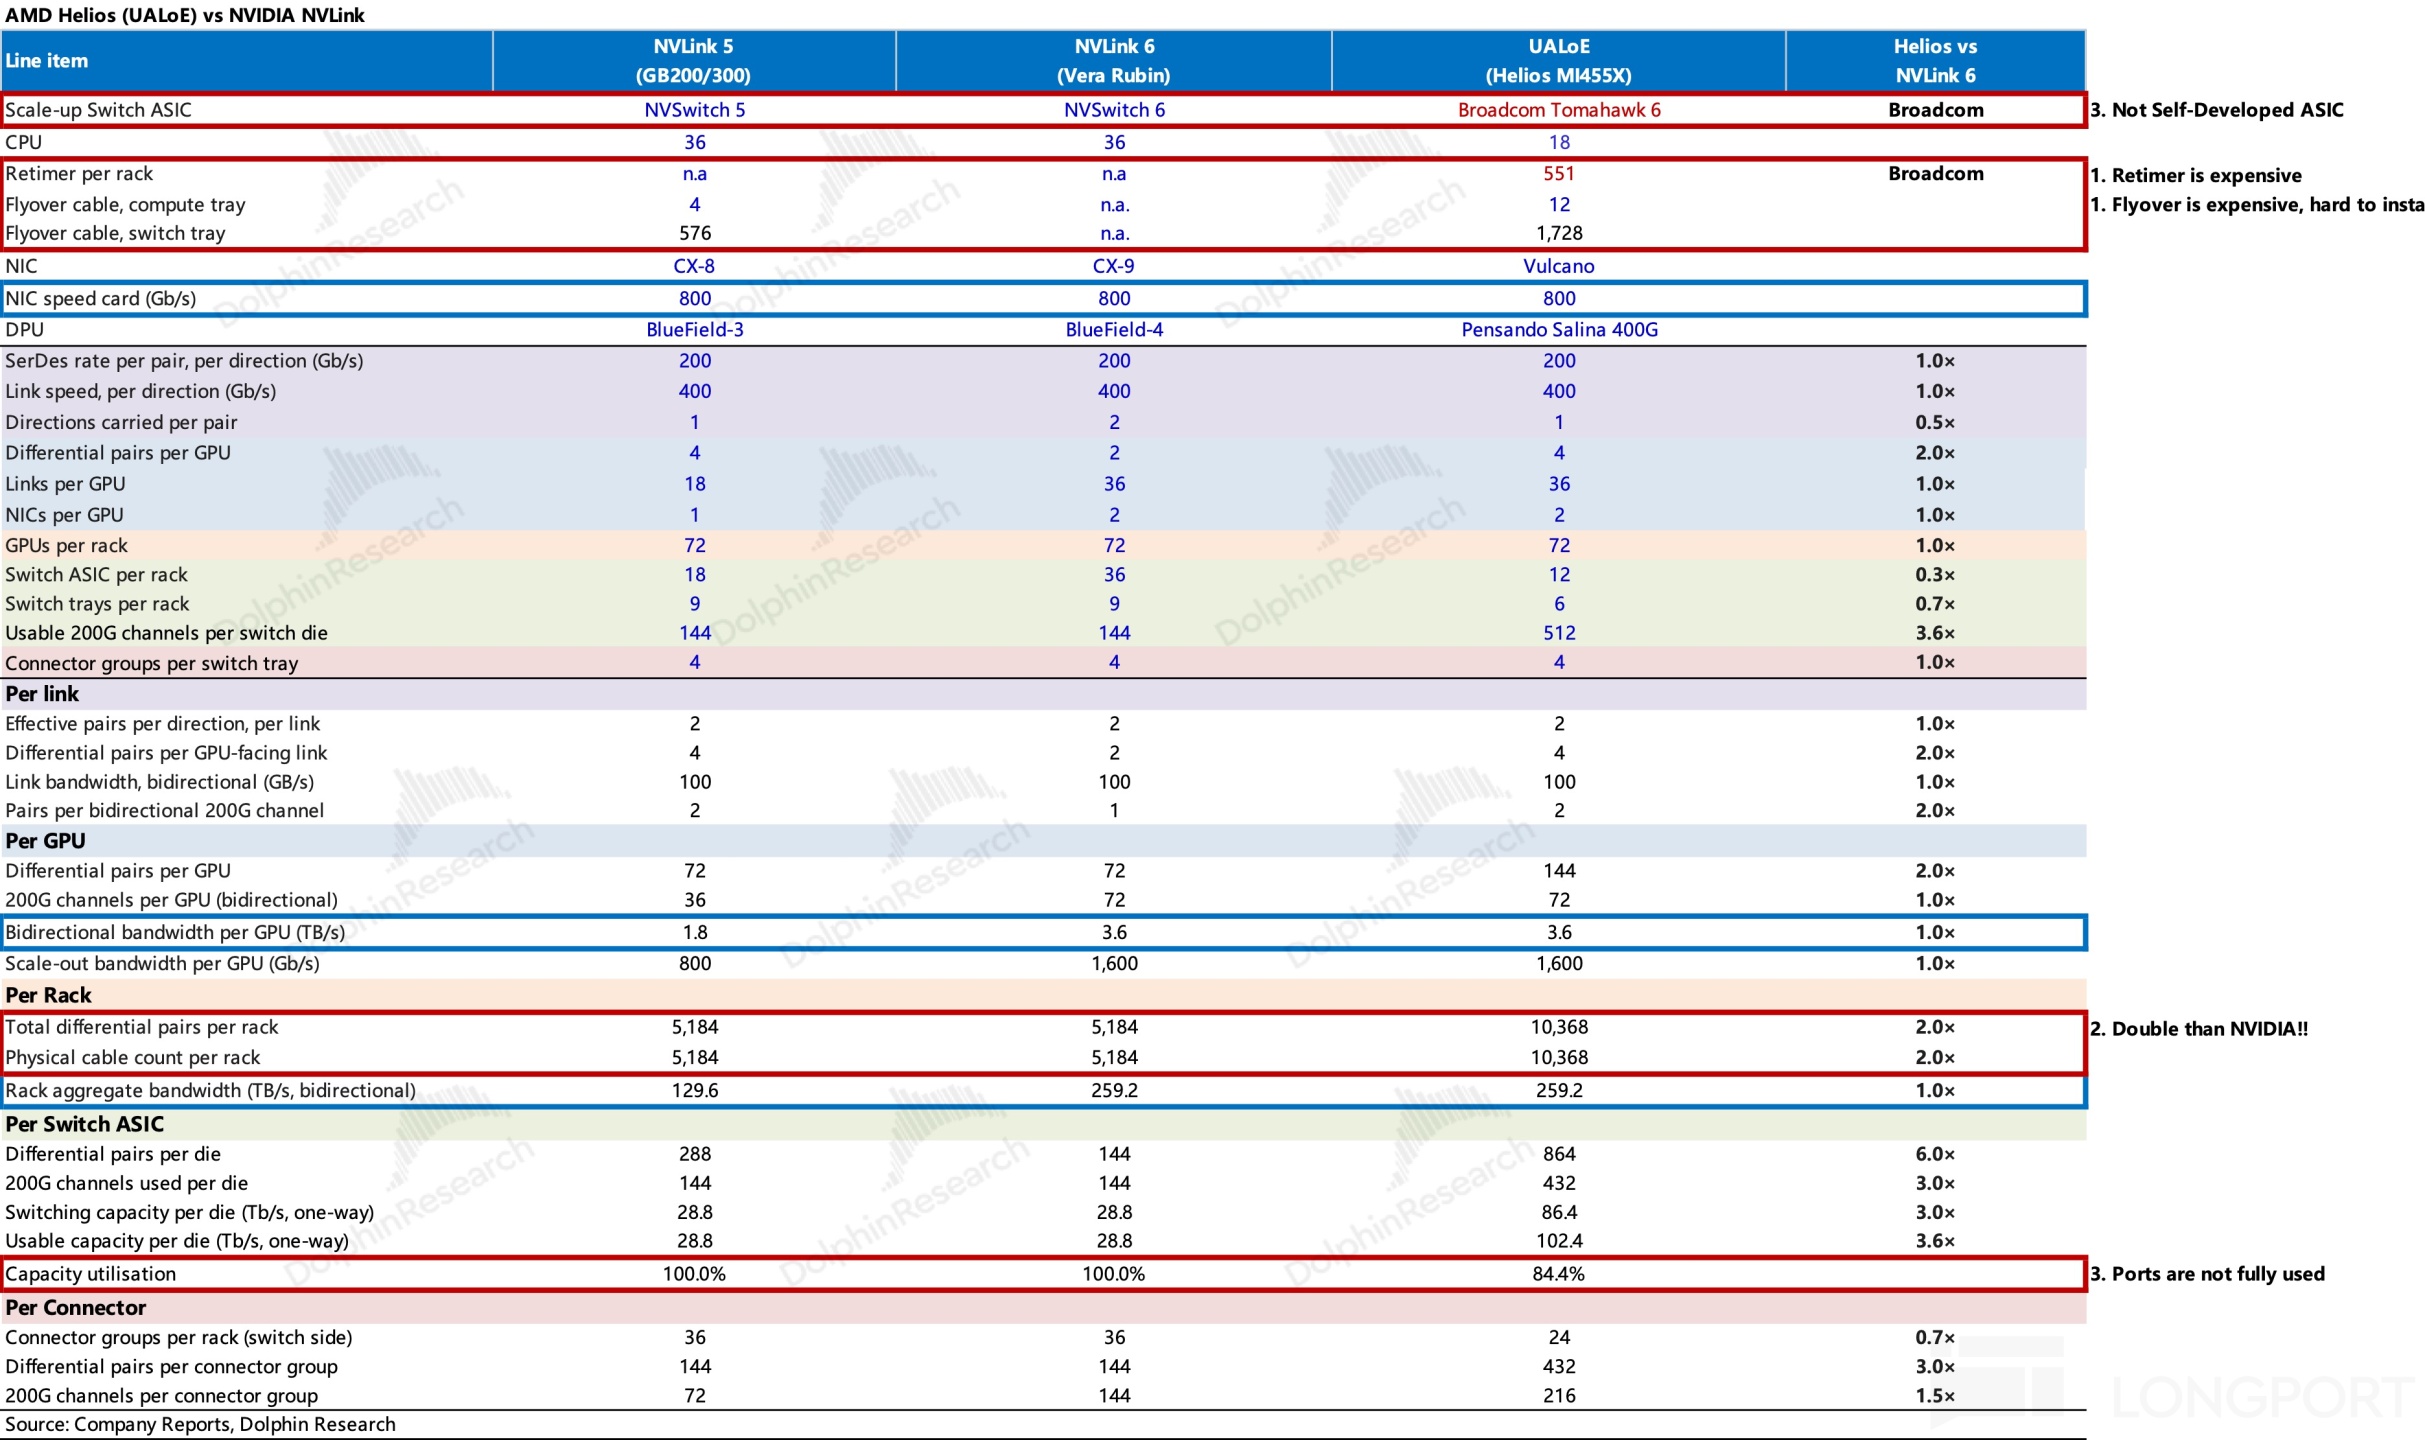
c. 2倍的銅纜用量:一共是10,368根銅纜,足足為英偉達兩倍。差異來自於英偉達SerDes可以在同一對DP上同時收發。
d. 交換介質:銅飛線還在。連接器-Switch段保留了GB300設計中的飛線,增加了成本與維護風險。
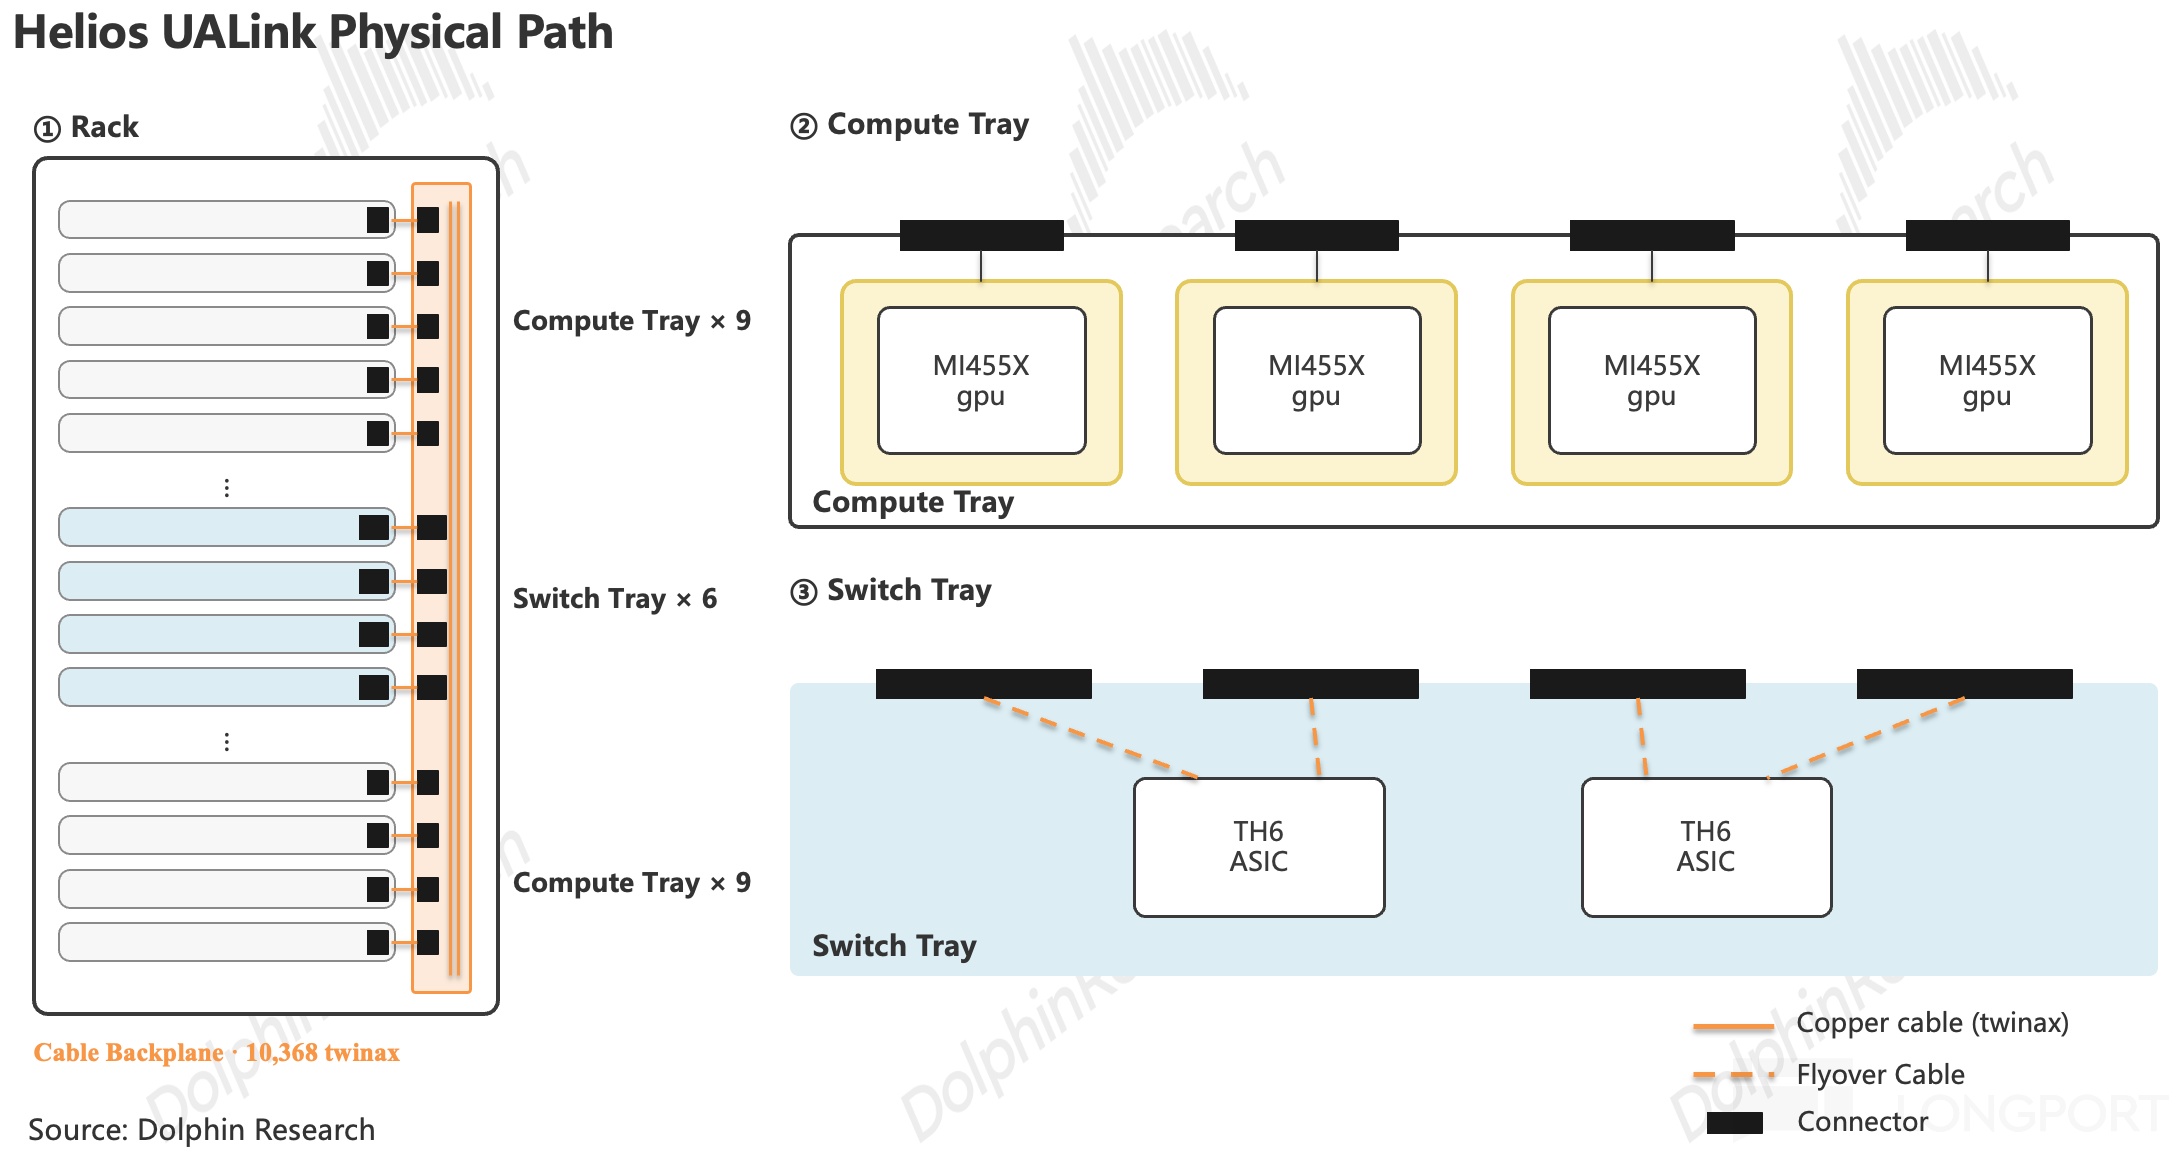
e. CPU配比低,CPU與GPU再次引入飛線連接:每個計算托盤配1顆Venice CPU、4顆MI455X GPU。CPU與GPU 配比由英偉達的 1:2 降為 1:4(核數比也是更低的)。
GPU因為距離CPU比較遠,是通過飛線連接Venice CPU與Vulcano網卡,而不是英偉達的NVLink C2C的連接方式。
從下圖的協議帶寬看,海豚君推測AMD中CPU配比下降是因英偉達自研了NVLink C2C (1.8TB/s),CPU以及它所帶的內存被納入 GPU 一致性訪問域,需要更高的配比支撐傳輸;而AMD的CPU-GPU走IF(僅256GB/s),CPU 可能只負責控制與調度,一顆即可覆蓋4顆GPU。
2.4 Helios真正的同台競品:Vera Rubin到底迭代了什麼?
飛線是易耗品,容易壞,修起來比較麻煩。Vera Rubin主要的更新就是取消了飛線,交換芯片升級到了36顆NVLink6,把GPU之間的傳輸帶寬拉到了3.6 TB/s;此外把CPU-GPU間NVLink C2C帶寬翻倍至1.8TB/s。
關鍵是飛線是如何取消的呢?
GB300方案中,計算托盤以一塊高度集成的PCB板為核心,GPU、CPU、LPDDR同板。信號出櫃的路徑是CPU→GPU→NIC網卡→OSFP(出櫃接口)→Leaf交換機。其中,從NIC網卡到OSFP這一段走飛線(左圖中藍色虛線),是最容易故障的線路。
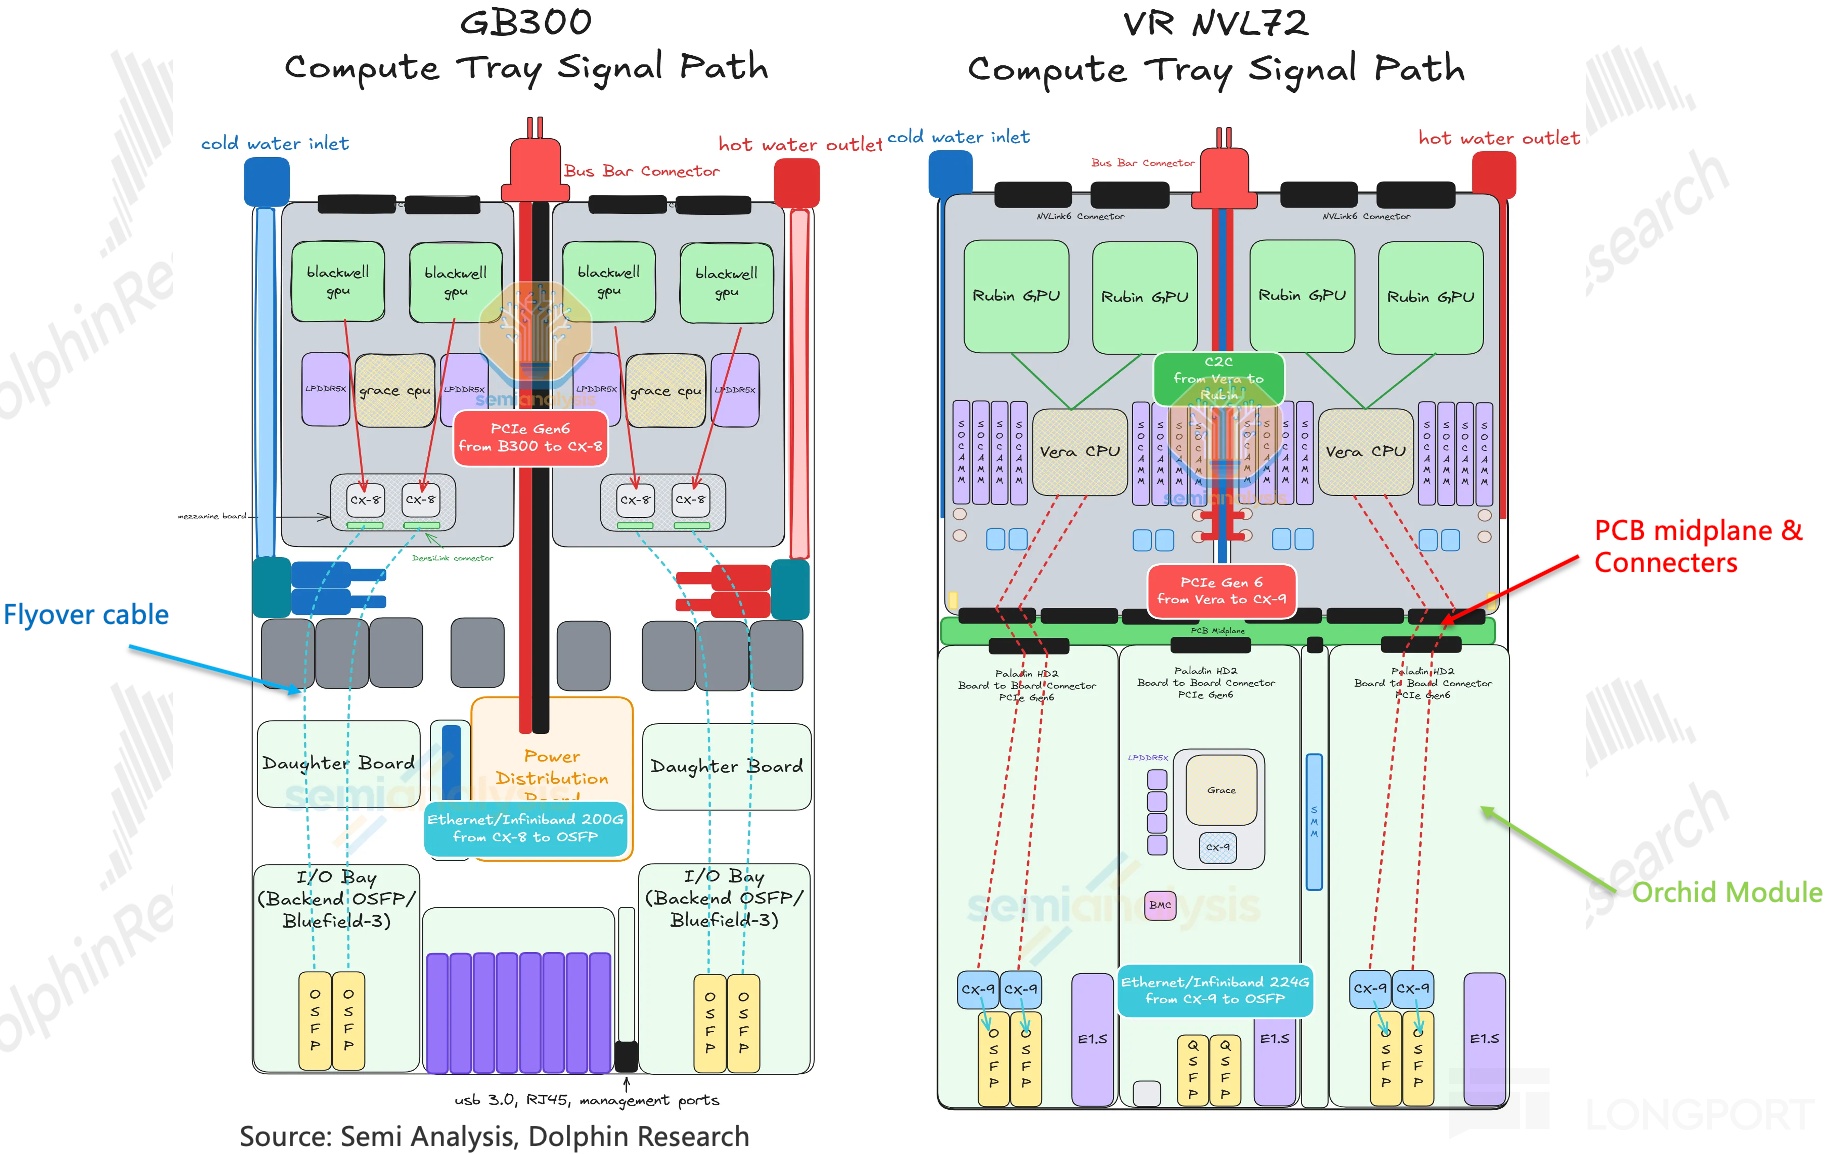
Vera Rubin的解法是將板卡模塊化,如CPU和GPU組成計算模塊,CX-9緊挨OSFP出口排列,一起做成獨立網絡通信模塊Orchid。
幾個獨立功能的模塊加上一塊豎在中間的 PCB 中板,模塊之間不再用線纜,而靠板與板連接器盲插對接(右圖紅色箭頭)。易於維護、便於組裝。
這樣經過盲插對接後,全程是PCB走線。
PCB 上的長距離傳輸比飛線更易衰減,英偉達因此在配備高速 SerDes 之外,同步升級了 PCB 的材料、層數與面積。
可以看到,英偉達NVL72從GB系列到Vera Rubin,GPU連接方式不變,主要是模塊化+PCB板+連接器,來取代飛線,降低組裝時間,且容易維護。
而Helios是抄英偉達上一代的設計,通過高成本堆料的方式,拉高了可比參數值,但由於組件非定製、設計等各方面問題,實際成本更高。而同台競技的是英偉達改良後的Vera Rubin產品。
2.5 Scale-Out:沒核心差異
該層級的組網方式較為簡單,主要是硬件數量以及帶寬的升級。我們結合前文Scale-Up的比較分析整理了方案的整體差異比對錶。淺紅底色的是AMD相較於英偉達落後的部分。
2.6 英偉達的下一代:Rubin Ultra又是一次大變革?
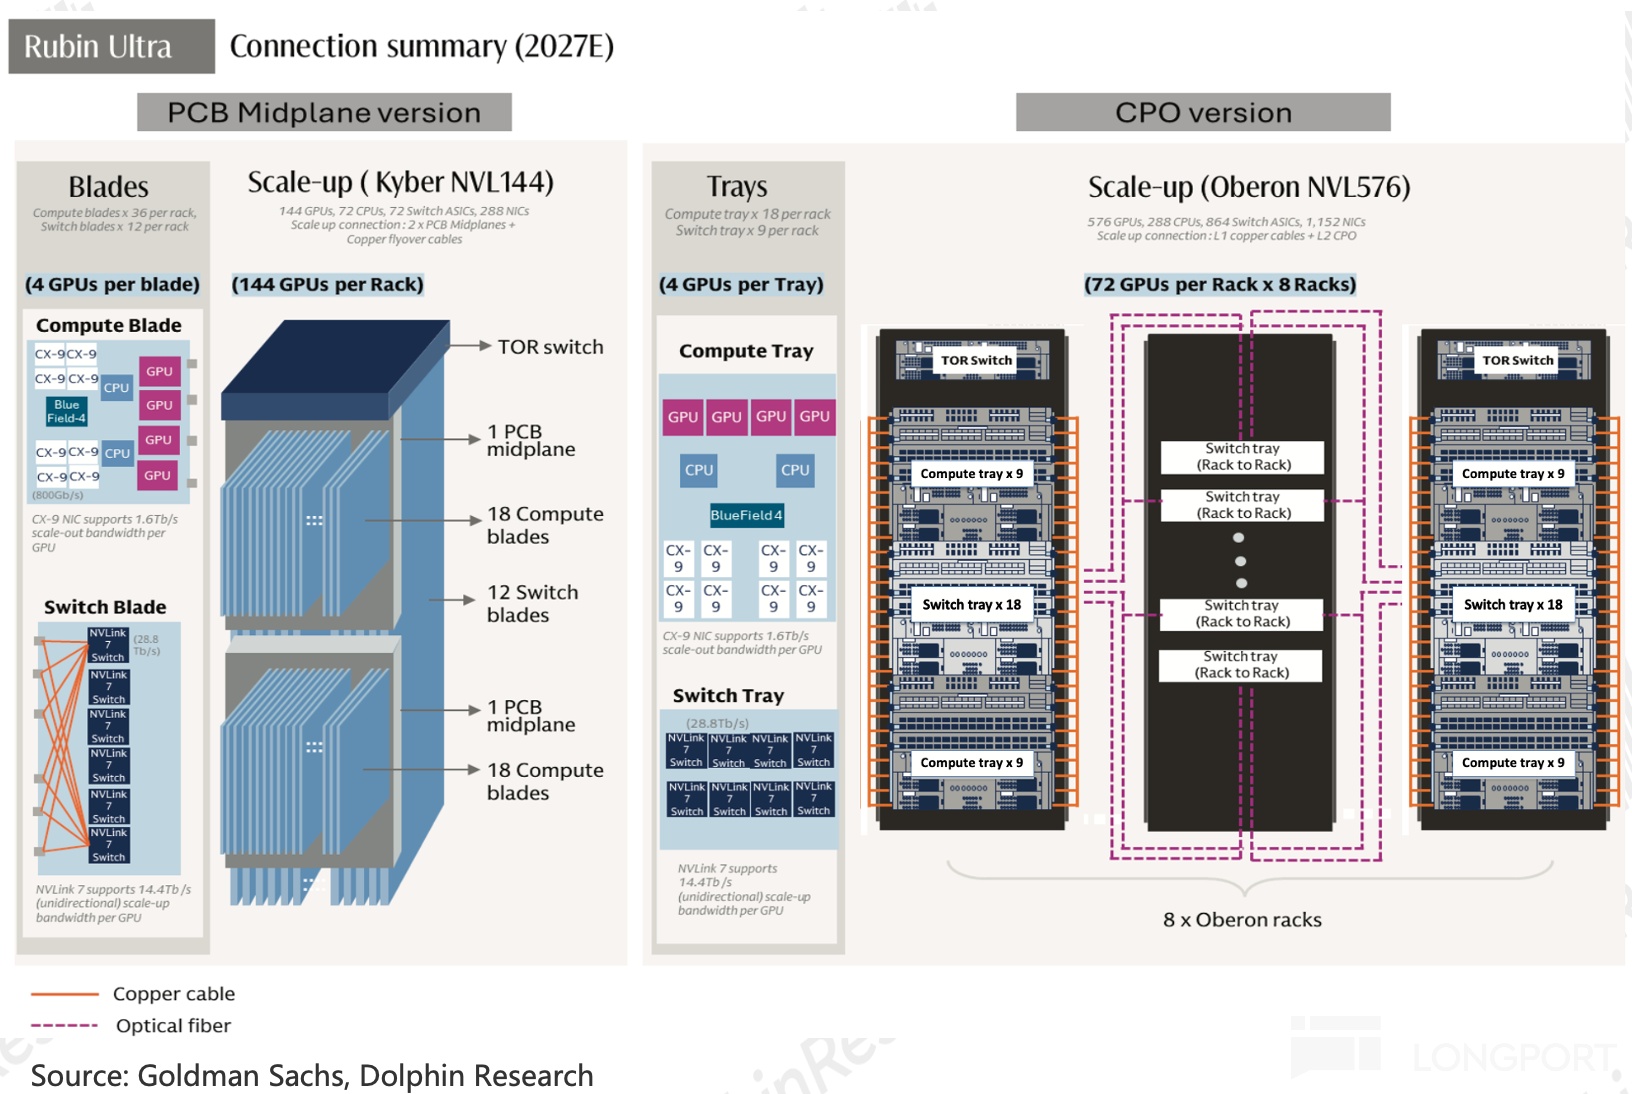
英偉達這邊,Vera Rubin的下一代——Rubin Ultra 代際已經醖釀中,可能首次用光跨櫃做Scale-Up。
目前,有兩種機架形態——Kyber機架 vs傳統Oberon機架,在同時考慮中。
a. Kyber 機架(NVL144,見下圖左側):形態重構
計算托盤改為刀片狀(Blade),垂直安裝在上下兩塊大型PCB中板的一側。單刀片集成 4 顆 Rubin Ultra GPU 與 2 顆 Vera CPU,整機櫃分 2 個 全功能模塊(Canister),各含 18 塊刀片,合計 36 塊刀片、144 顆 GPU。
PCB中板另一側交換芯片同步加量:每塊交換刀片含 6 顆 NV Link 7 交換芯片,每機架 12 塊,合計 72 顆。GPU 經 2 塊 PCB 中板(每個 Canister一塊)以全互連方式連至各交換刀片。這側中板另插入管理模塊。
b. Oberon 機架(上圖右側):沿用橫置托盤
①機架內:佈局由 Vera Rubin時,9個交換托盤在中間,上面放10個GPU托盤,下面放8個GPU托盤的10+9+8。
新方案改為 9+18+9。18 個計算托盤等分兩組分佈於機櫃頂部與底部,NVLink 交換托盤翻倍至 18 個、單托盤高度壓縮至 0.75U。目的是縮短最遠計算托盤與最遠交換托盤的間距,以保證銅背板上 NVLink 信號的鏈路驅動能力。
② 跨機架,用光互聯拉高Scale-Up上限:8 個各裝 72 顆GPU 的機架,首次引入Scale-Up CPO,做到8個機櫃之間Load/Store內存語義的全互聯,而非RDMA消息語義的Scale-Out。
三、小結:理論上了牌桌,實際萬年備胎
整體而言,在最核心的帶寬指標上,Helios無論Scale-Up還是Scale-Out都已基本追平英偉達的機架方案,單 GPU 雙向 3.6TB/s 的 Scale-Up 帶寬與 Vera Rubin 相當,Scale-Out 側同樣是 800G 網卡。對於下游客户而言,AMD已具備成為替代方案的基本資格。
但理論帶寬追平並非全部。AMD 的差距集中在工程實現與自研全棧,沿用GB機架的落後設計直接推高了單機架的物料成本。
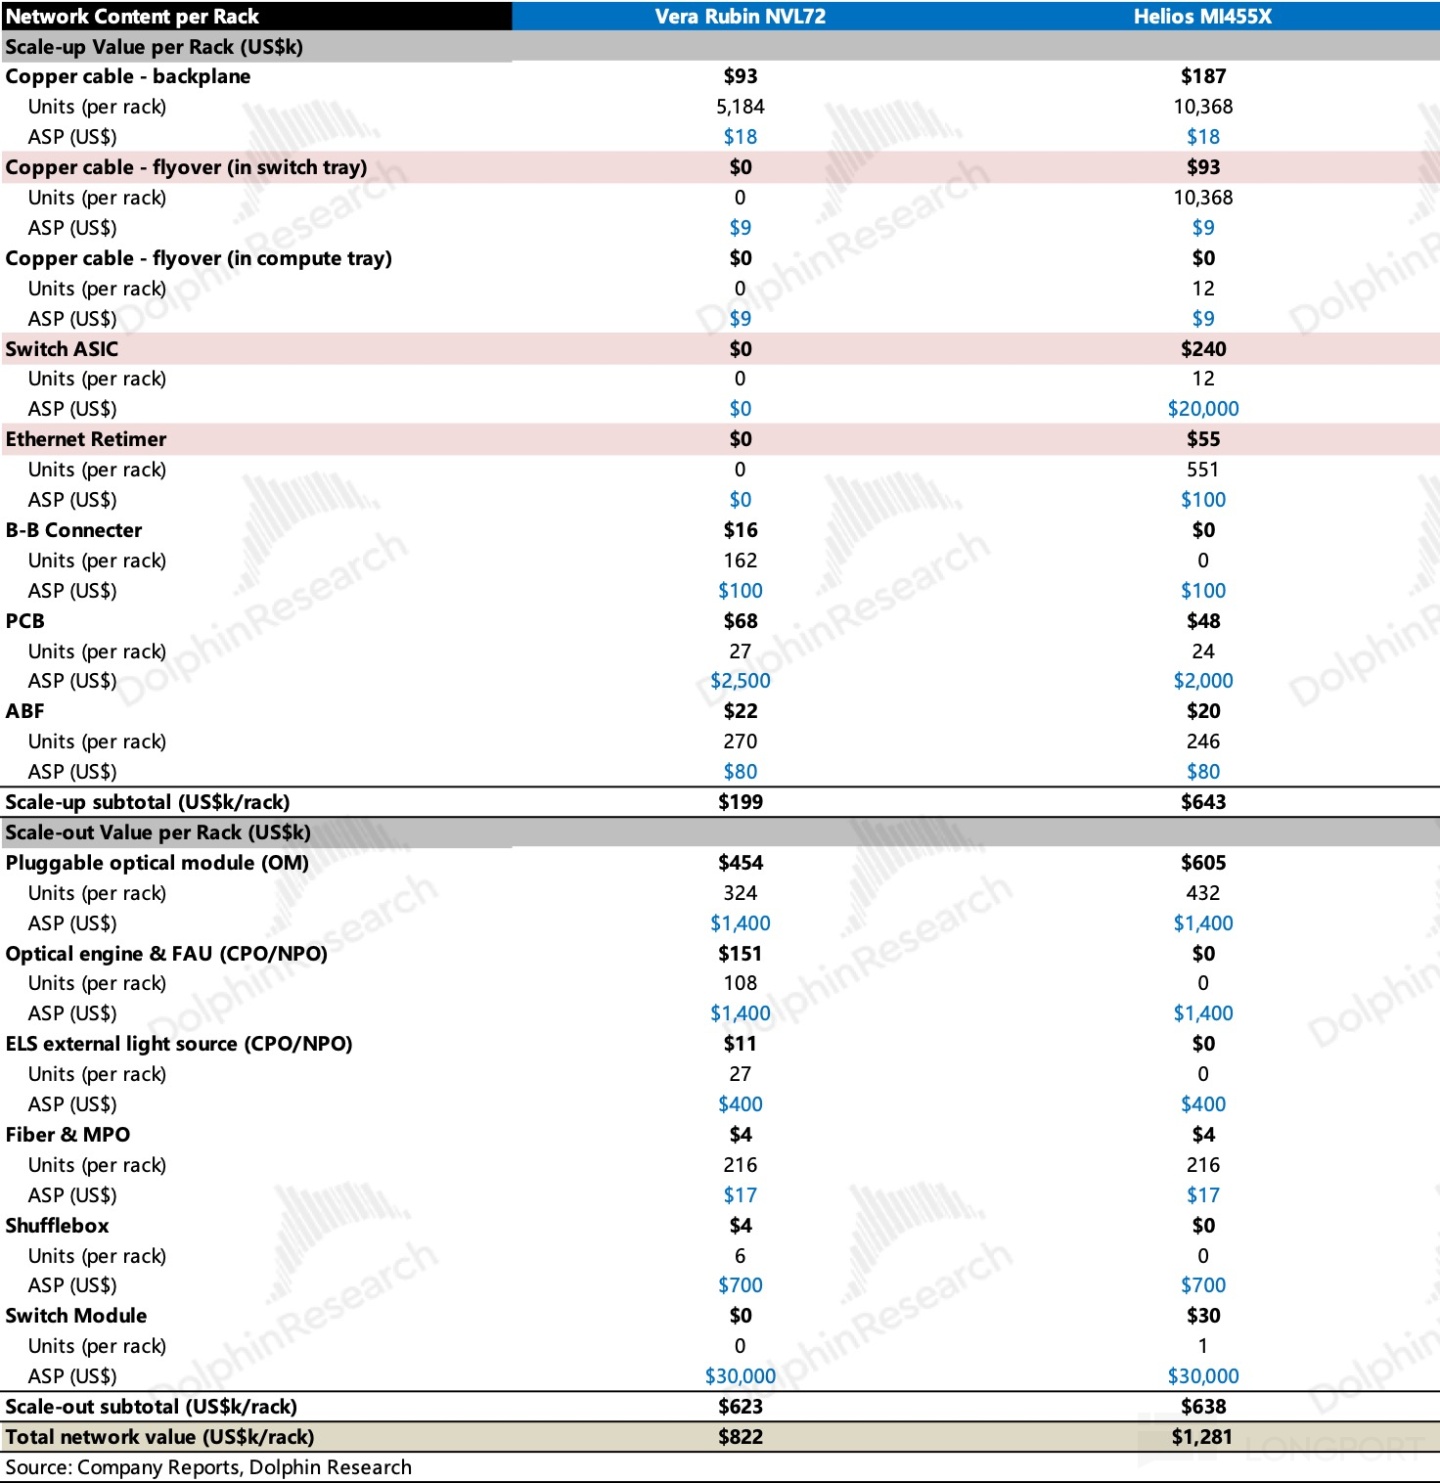
基於海豚君測算,兩家廠商的單機架網絡物理層的成本(外採口徑),即便在英偉達 Scale-Out 側計入了較為激進的 CPO 預期、從而抬高其成本的前提下,AMD 方案仍接近英偉達的兩倍。
這一差距主要來自 Scale-Up 側:翻倍的銅纜數、外採的交換芯片與Retimer佔到了Helios Scale-Up網絡成本的60%。
作為追趕者,AMD 面向客户顯然會採取相對更低的定價(不考慮存儲容量差異),而上文分析的差距將完全反映在其組網方案的毛利上。
Helios由於第三方組件使用較多,即使同樣賣機架,它真正留存體內的收入是GPU(Instinct MI455X)+CPU(EPYC Venice)+網卡(Pensando Vulcano)的收入,其他多是低毛利轉售業務。
回到機櫃級組網競爭,AMD受制於原生UALink道阻且長以及組網上的跟進者策略,而英偉達的機架方案仍在快速迭代,其下一代機架方案物理形態或將發生變化。
AMD的方案與英偉達差距仍然明顯。但在目前算力供給緊缺的情形下,這仍是AMD向上的出貨週期,公司公開表示 2027 年的需求量已超出最初預期,將繼續擴產。
四、產業鏈梳理:櫃內模塊化——板代線;櫃外GPU加量——光代銅
從目前在部署以及拿到訂單的下游來看,Vera Rubin 規模發貨8 月啓動,且已拿到所有主要超大規模客户、AI 雲廠商和系統 OEM 的採購訂單,市場普遍預期4Q26放量。
Helios 7月下旬量產,首批發貨在9月末。規模商業化落後約一個季度,大規模放量或要等到27上半年。
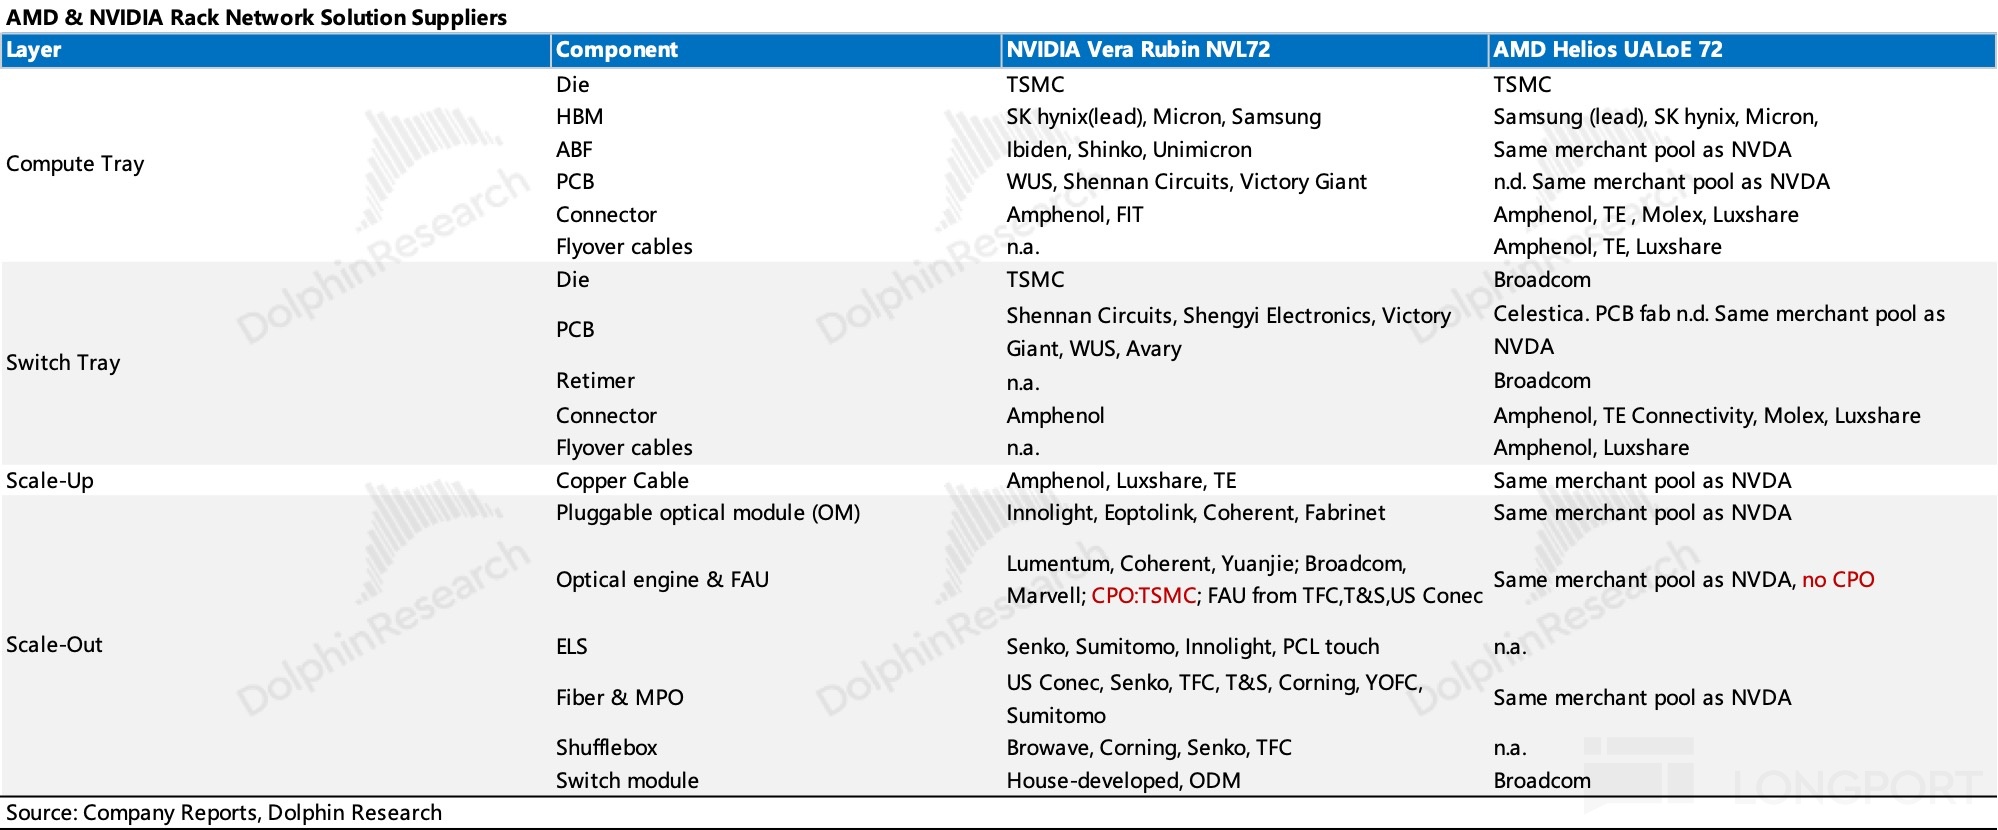
產業鏈上,AMD的公開信息較少,但前文可見兩家機架的硬件規格已經接近(同為3.6TB/s、200G SerDes、銅纜背板加多層PCB),而後文將看到相關環節的競爭格局相對集中。
在基板、PCB、液冷、電源環節,供應鏈重合度高;差距主要是:①在交換芯片上AMD用的博通交換芯片;②整機組裝環節,英偉達用鴻海、廣達等,而AMD用Sanmina、Celestica與HPE等偏美鏈組裝廠。
以下,海豚君主要從機架方案對比、迭代中,梳理網絡互聯供應商的價值變化。
4.1 方案迭代幾家歡喜幾家愁?
a. AMD鏈:Helios使AMD從單板8卡推到跨板72卡,交換托盤和Scale-Up層是最直接的增量。
博通供應交換托盤的以太網Retimer、交換芯片;$安費諾(APH.US) 提供從連接器到銅纜的整體方案,兩者是直接受益標的。
長期來看,UALink原生芯片將由$邁威爾科技(MRVL.US) 、$Astera Labs(ALAB.US) 供應,是對博通交換芯片的替代邏輯。另外,海豚君後續要看的谷歌方案,OCS交換機在設計初衷上就是博通脊交換機的一種替代。
b. 英偉達鏈:銅退,PCB & 光進,連接結構升級
英偉達的機櫃連接方案發生了以下兩點關鍵變動:
一是取消了計算托盤與交換托盤的飛線;
二是PCB板的面積、強度都得到了提升。
物理成本測算參考下表,Vera Rubin方案的整體網絡連接成本達到了GB方案的1.8倍左右,但同期單卡帶寬翻倍,折算下來,單位帶寬的網絡成本反而下降約10%。
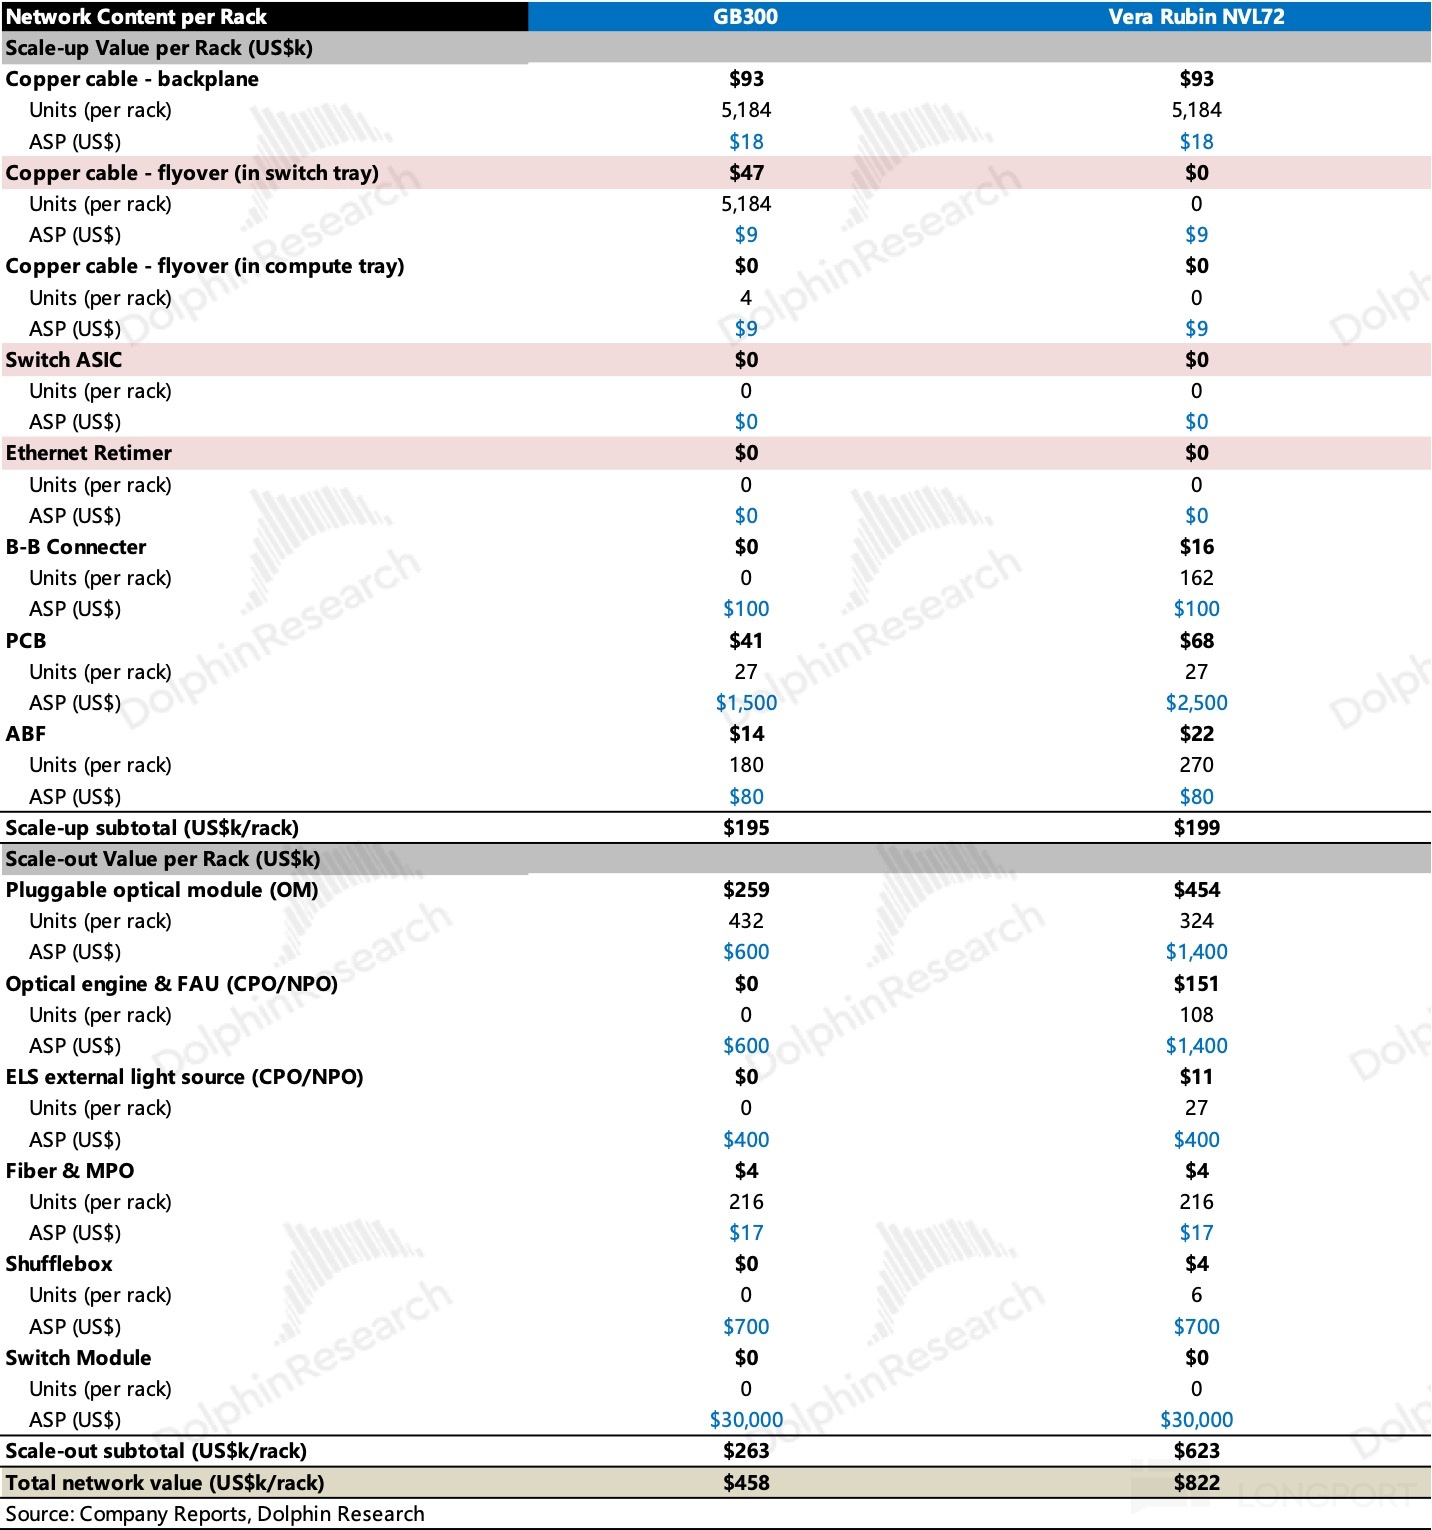
連接:安費諾Amphenol多空交錯。飛線(無源銅纜)取消顯然對Amphenol利空。但利好是:計算托盤內連接器的ASP相對更高,且接口數增量明顯,一定程度上實現了對沖。背板銅纜方案(含連接器)仍然是Amphenol主供,整體安費諾偏中性。
PCB板存在量價齊升的邏輯。量上由更大的組網規模推動機架數量,價上是PCB板的技術升級迭代帶來的層數與材料升級。在更長期視角下,Kyber機架將用PCB中板替代機櫃內銅纜連接,繼續利好PCB廠商,利空機櫃銅連接。
4.2 連接產業鏈價值分配,誰高誰低?
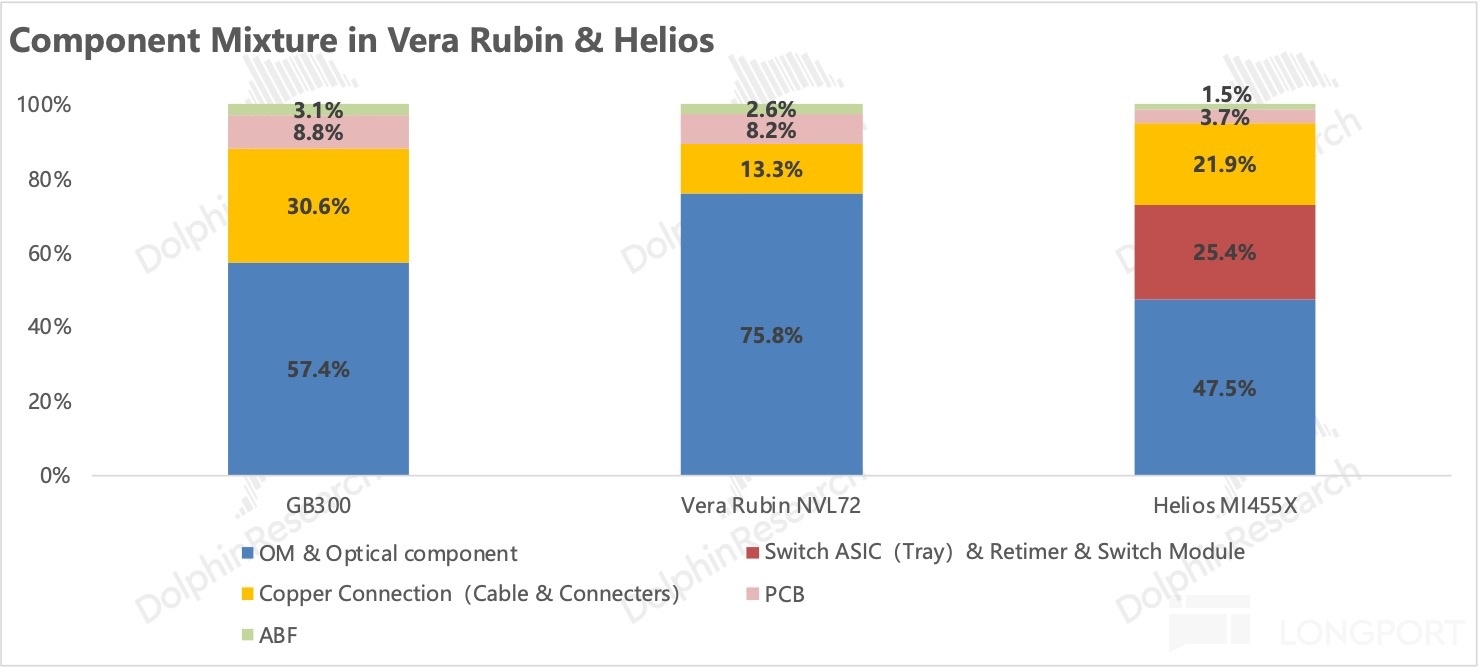
我們按單機架物料測算,把全部網絡物料歸併為四個環節,價值量由高到低為:光連接(光模塊以及光器件)>交換>銅連接(銅纜以及連接器)>PCB & ABF。
1) 光連接:非技術主導的供需錯配漲價,持續性存疑
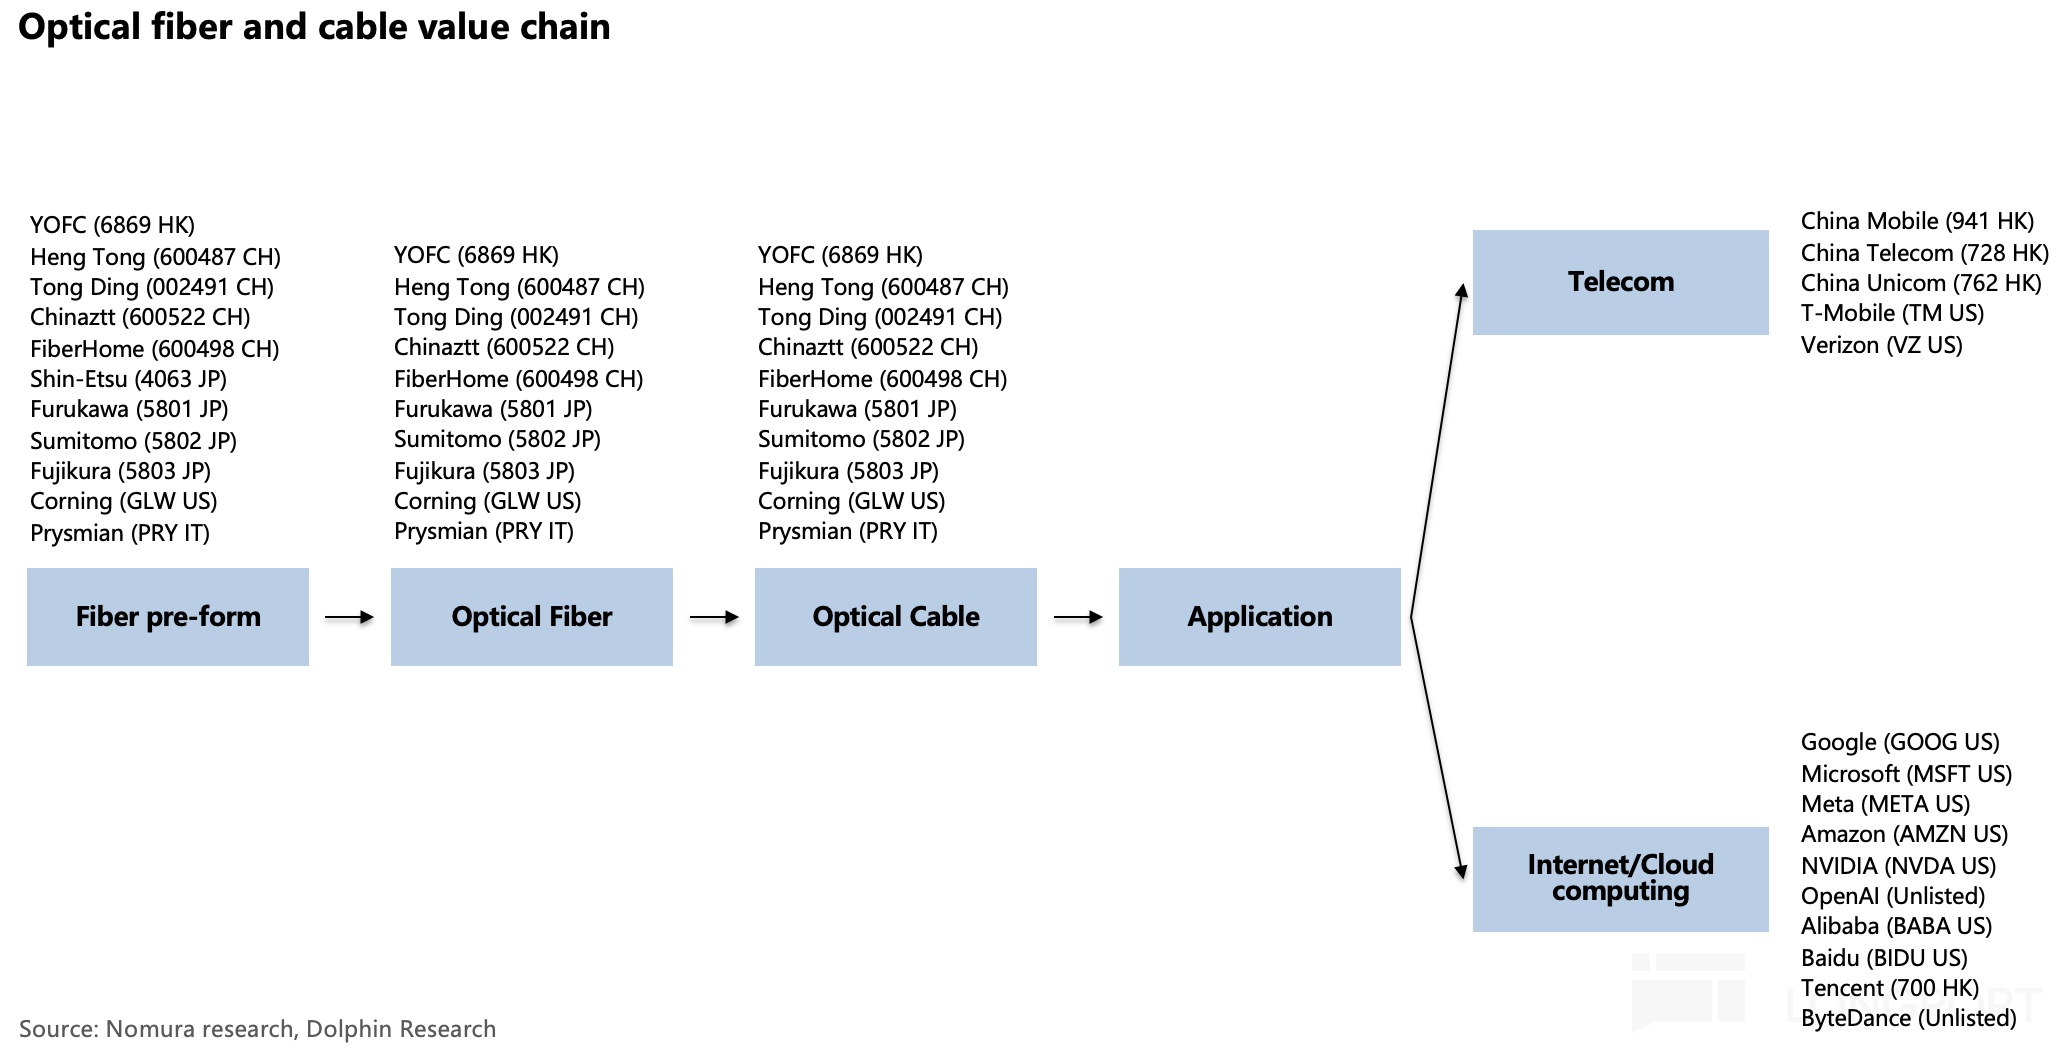
我們已經對單機櫃價值量最高的光連接板塊進行了深度覆蓋,具體內容請參見技術演進、產業鏈梳理。此處補充光纖光纜產業鏈。
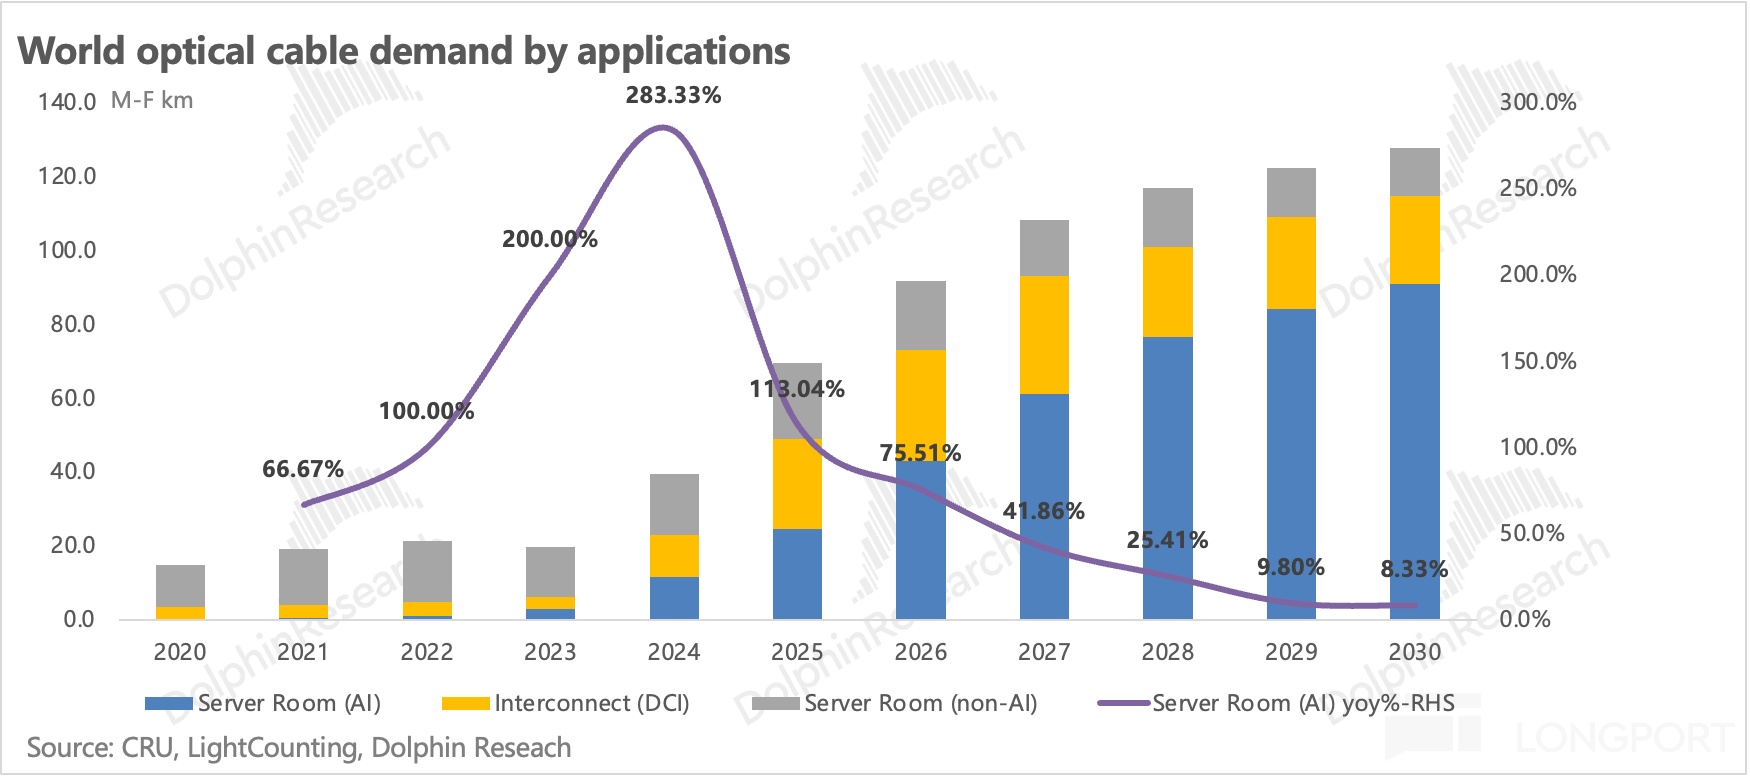
漲價來自供需錯配。需求側是AI集羣規模擴張驅動的結構性量升;供給側瓶頸在最上游的光纖預製棒——超高純石英玻璃實心棒,決定光纖的光學DNA,用來拉制裸纖,再給裸纖套上“外衣”,就變成大家熟悉的光纖。
光纖預製棒,價值量最大、貢獻了產業鏈近70%利潤,對設備與工藝要求最高。
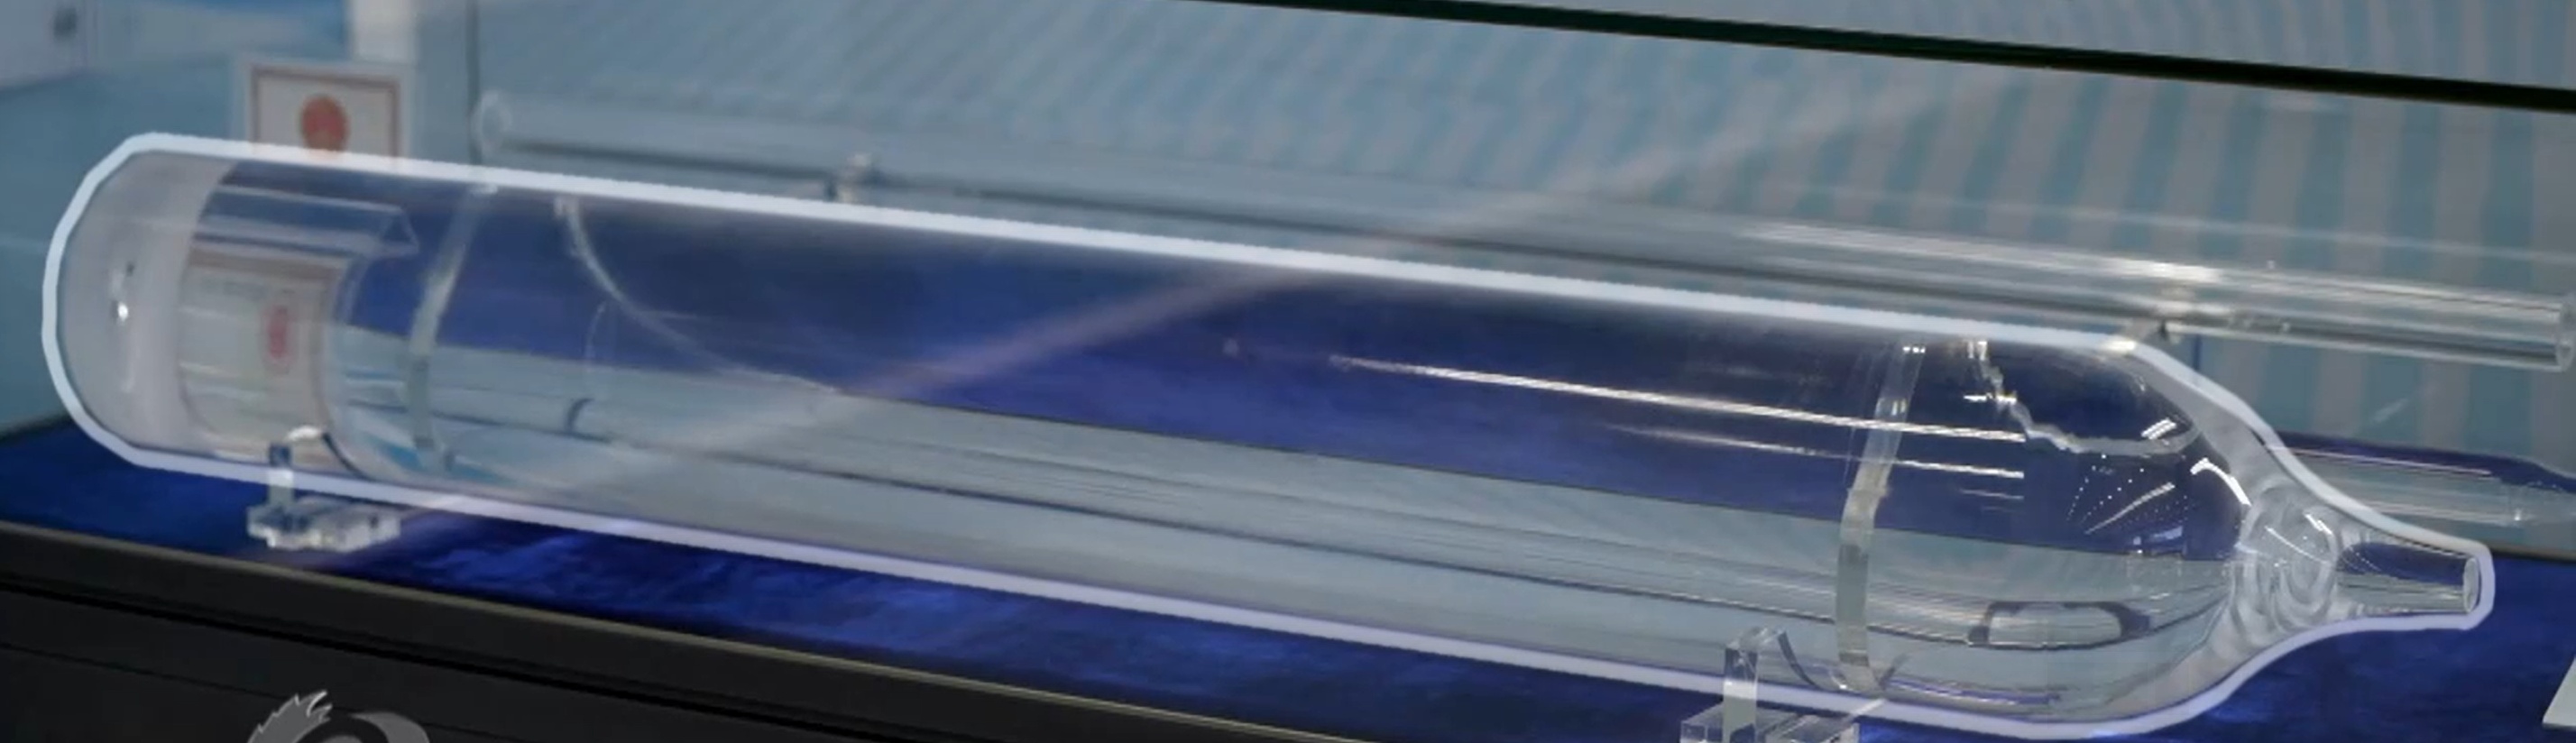
成熟產能由$康寧(GLW.US) 、藤倉、$長飛光纖光纜(06869.HK) 等頭部廠商主導,產能大部分不外售;存量玩家擴產謹慎,疊加18–24個月的擴產週期,供給較為剛性,缺口沿鏈向下傳導,推動近一年的整體漲價。
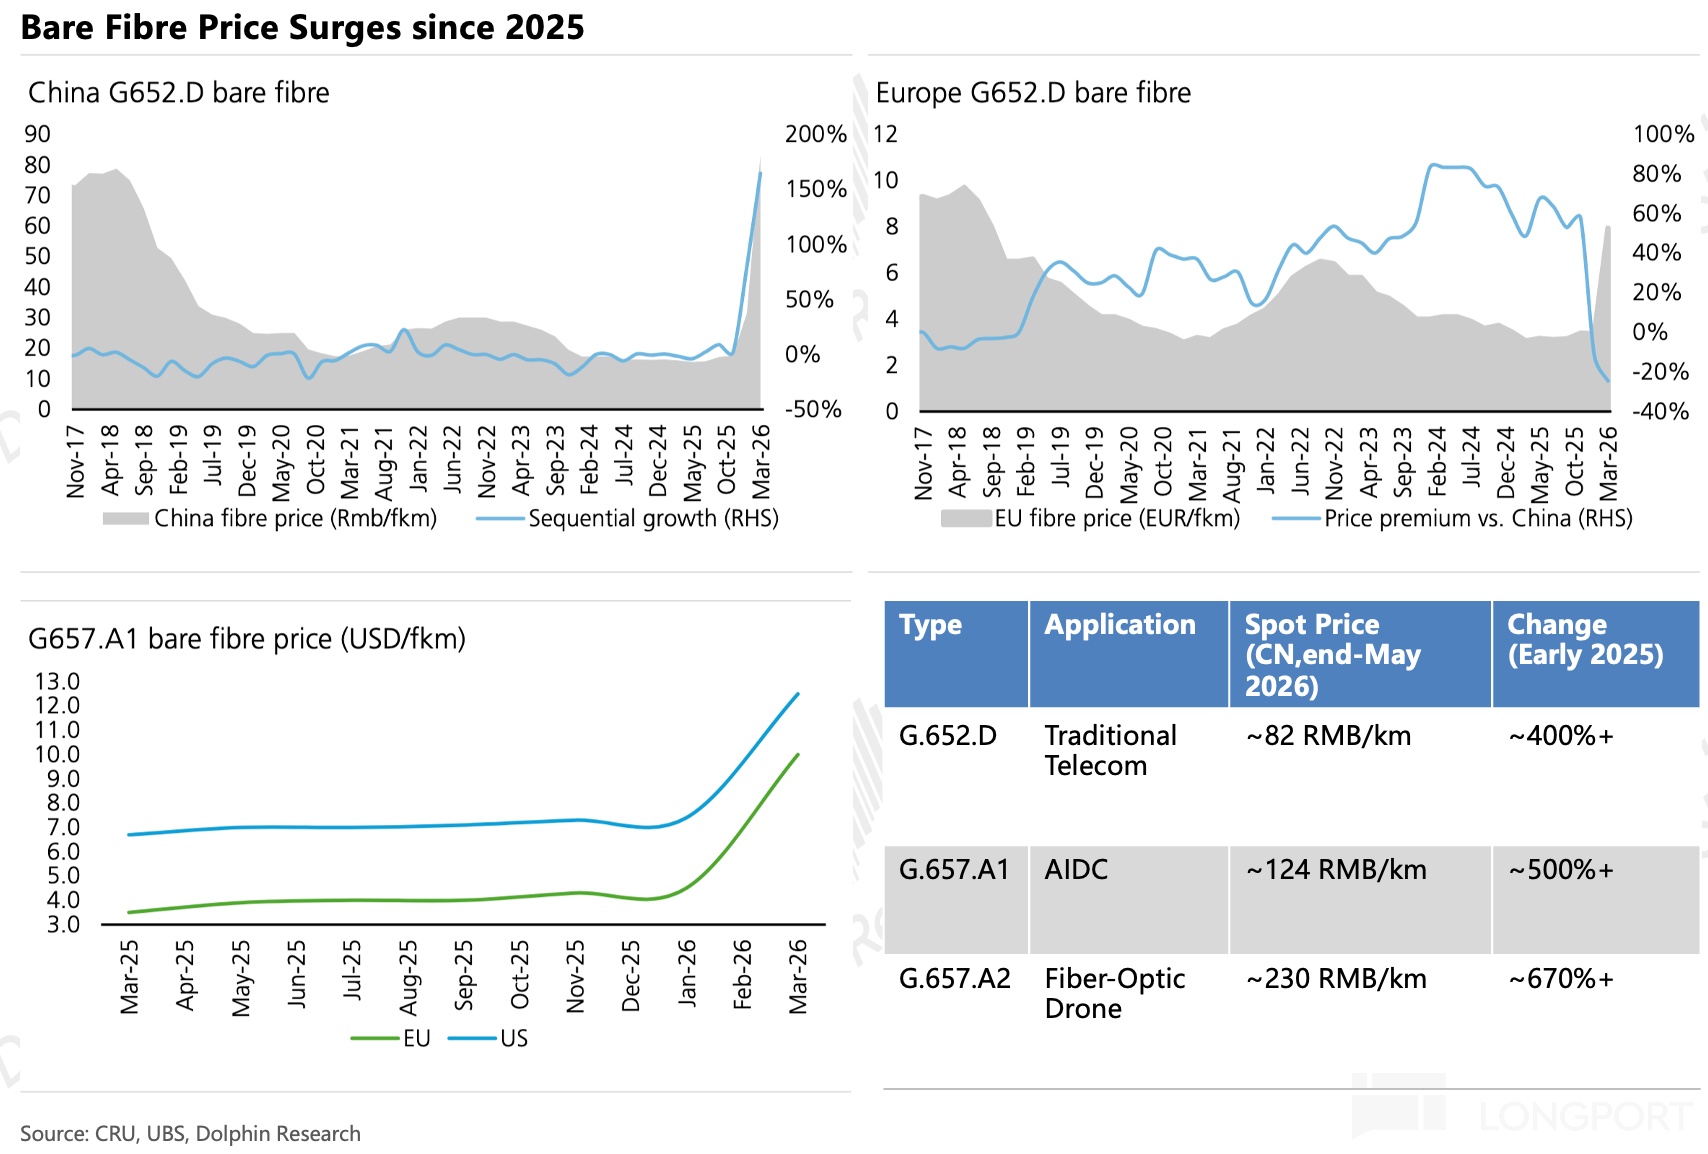
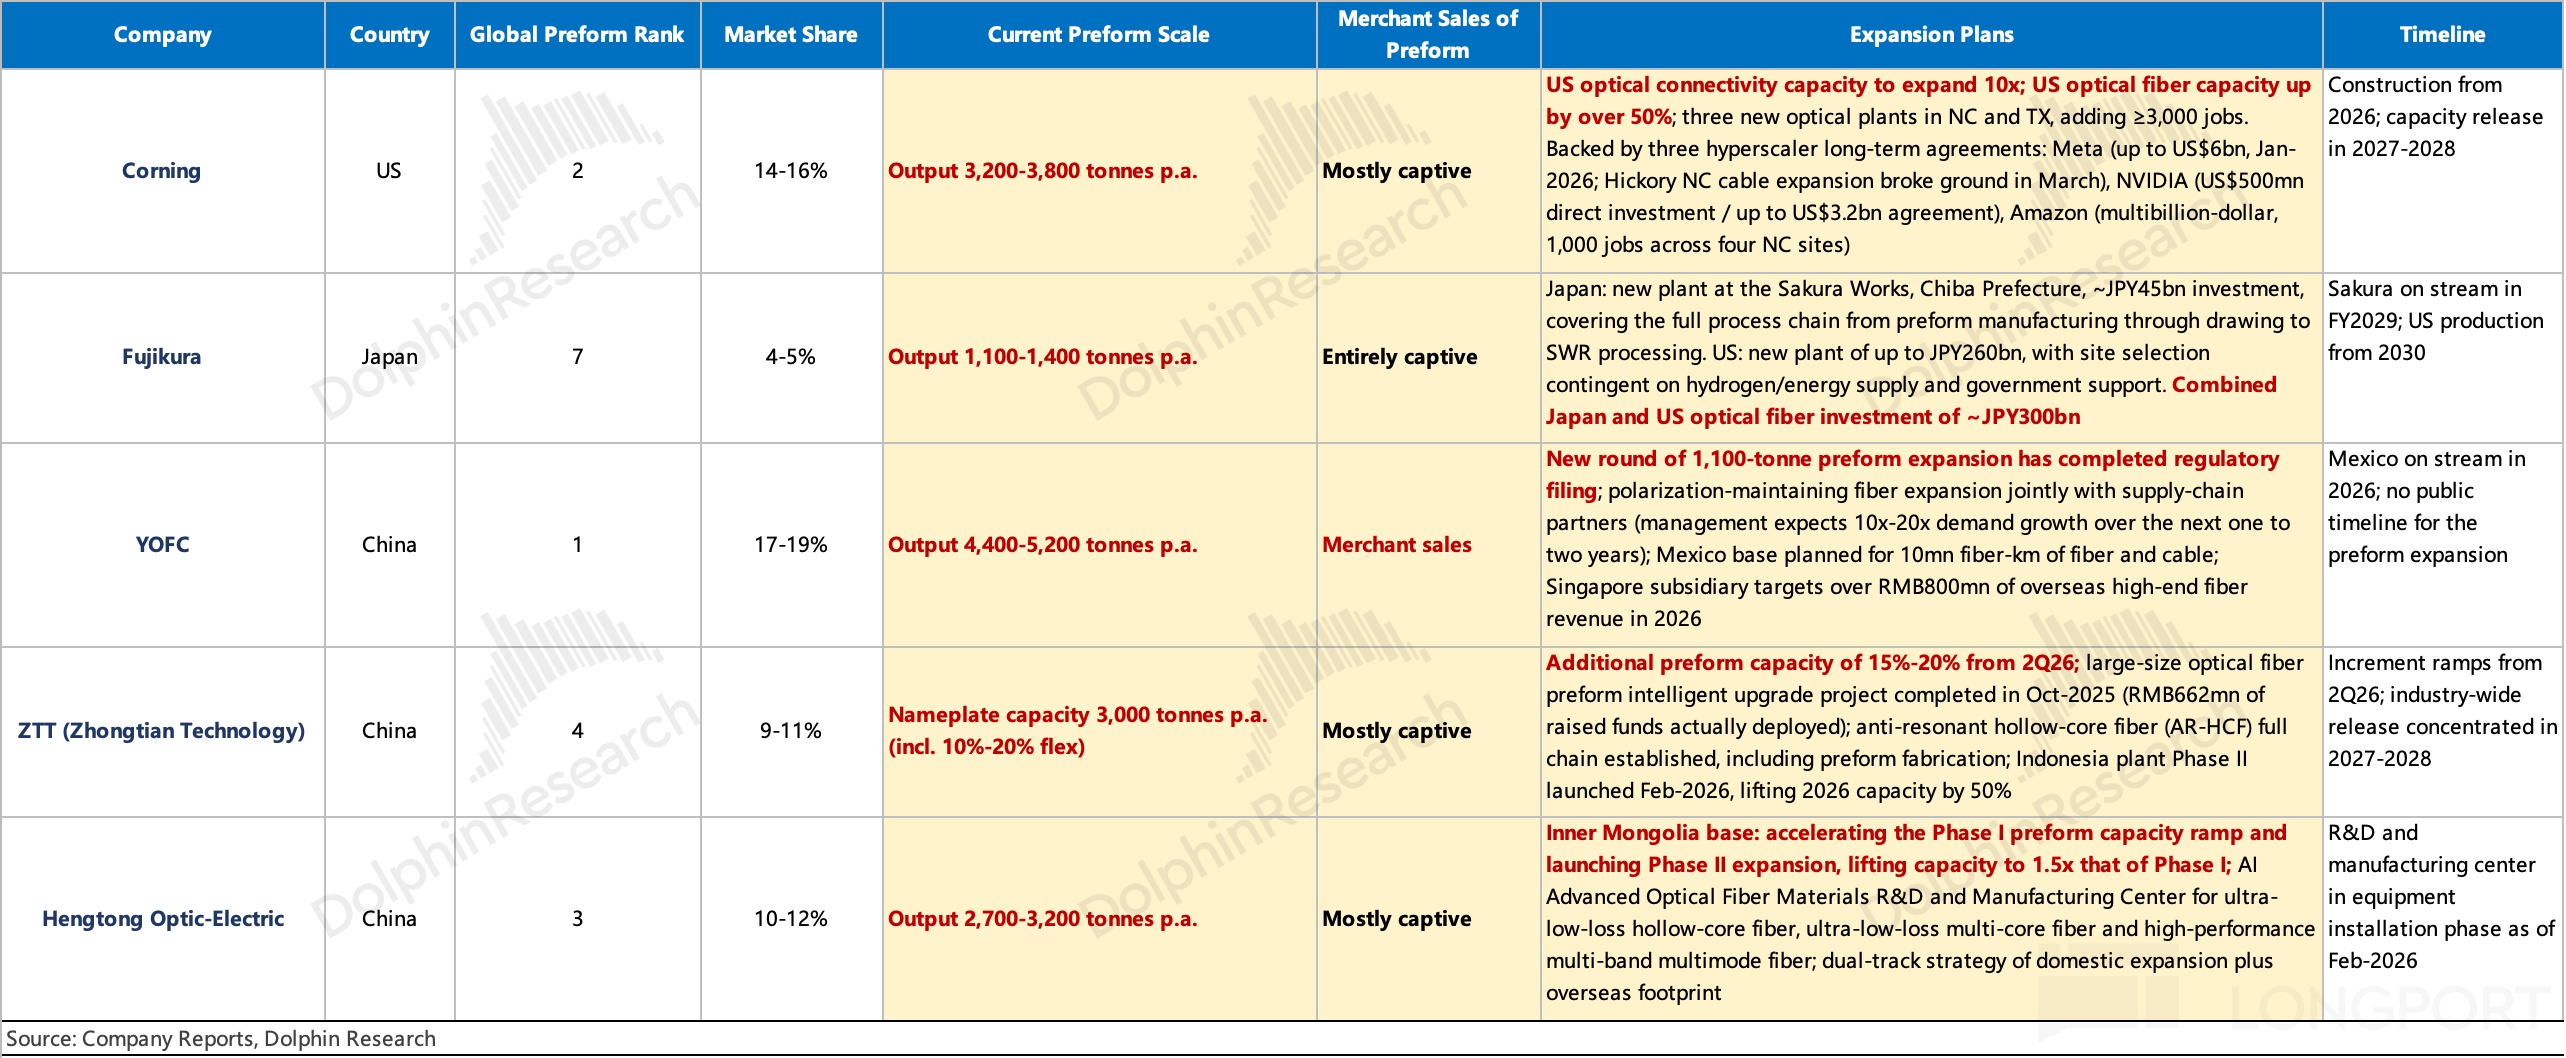
漲價持續性存疑。儘管此前普遍認為預製棒存在製造壁壘,但從新進玩家的擴產情況來看,大族激光(擴產2000噸)、合盛硅業(擴產3200噸)等已開始激進佈局預製棒產能,預計27年下半年的產能落地。另一方面,調研指出國內競爭已經加劇,截至6月數據,G.657.A現貨價環比微升,G.652.D環比持平。新技術HCF(空心光纖,長飛光纖領先)目前仍處於商業化早期階段(累計交付約佔全年光纖需求的0.02%),相較CPO這類確定性極強的技術,其推動產業更新的邏輯更弱、涉及環節也更少。
這種技術壁壘有一些但不強的行業,需要考察垂直一體化能力。海豚君建議關注具備預製棒自有產能或全鏈條垂直整合的龍頭企業,如長飛光纖,康寧,$亨通光電(600487.SH) 等,有望在產能出清階段以議價能力與成本優勢勝出。
2) 交換:Scale-Up 走向自研,Scale-Out仍以採購為主
- Scale-Up層面,行業整體趨勢是自研交換托盤內的交換芯片。這是為了與對應自研協議協同的理想解決方案,採取通用交換芯片的劣勢已在前文方案對比中體現。
- Scale-Out層面則多采購。在我們下一篇對CSP連接方案的行業深度中會看到,儘管CSP在各個環節開啓自研,但是高端交換芯片上仍以博通、Marvell、英偉達方案為主,可見SerDes IP、協議協同設計與軟件棧形成的壁壘較為穩固。
交換芯片是交換機產業鏈中技術壁壘與價值量最高的環節。根據Bernstein測算,交換芯片在整個交換機模組中的價值量高達30%,也因此形成了高度集中的競爭格局。市場約70%的份額由博通主導,Marvell與英偉達分別佔據約15%與10%。
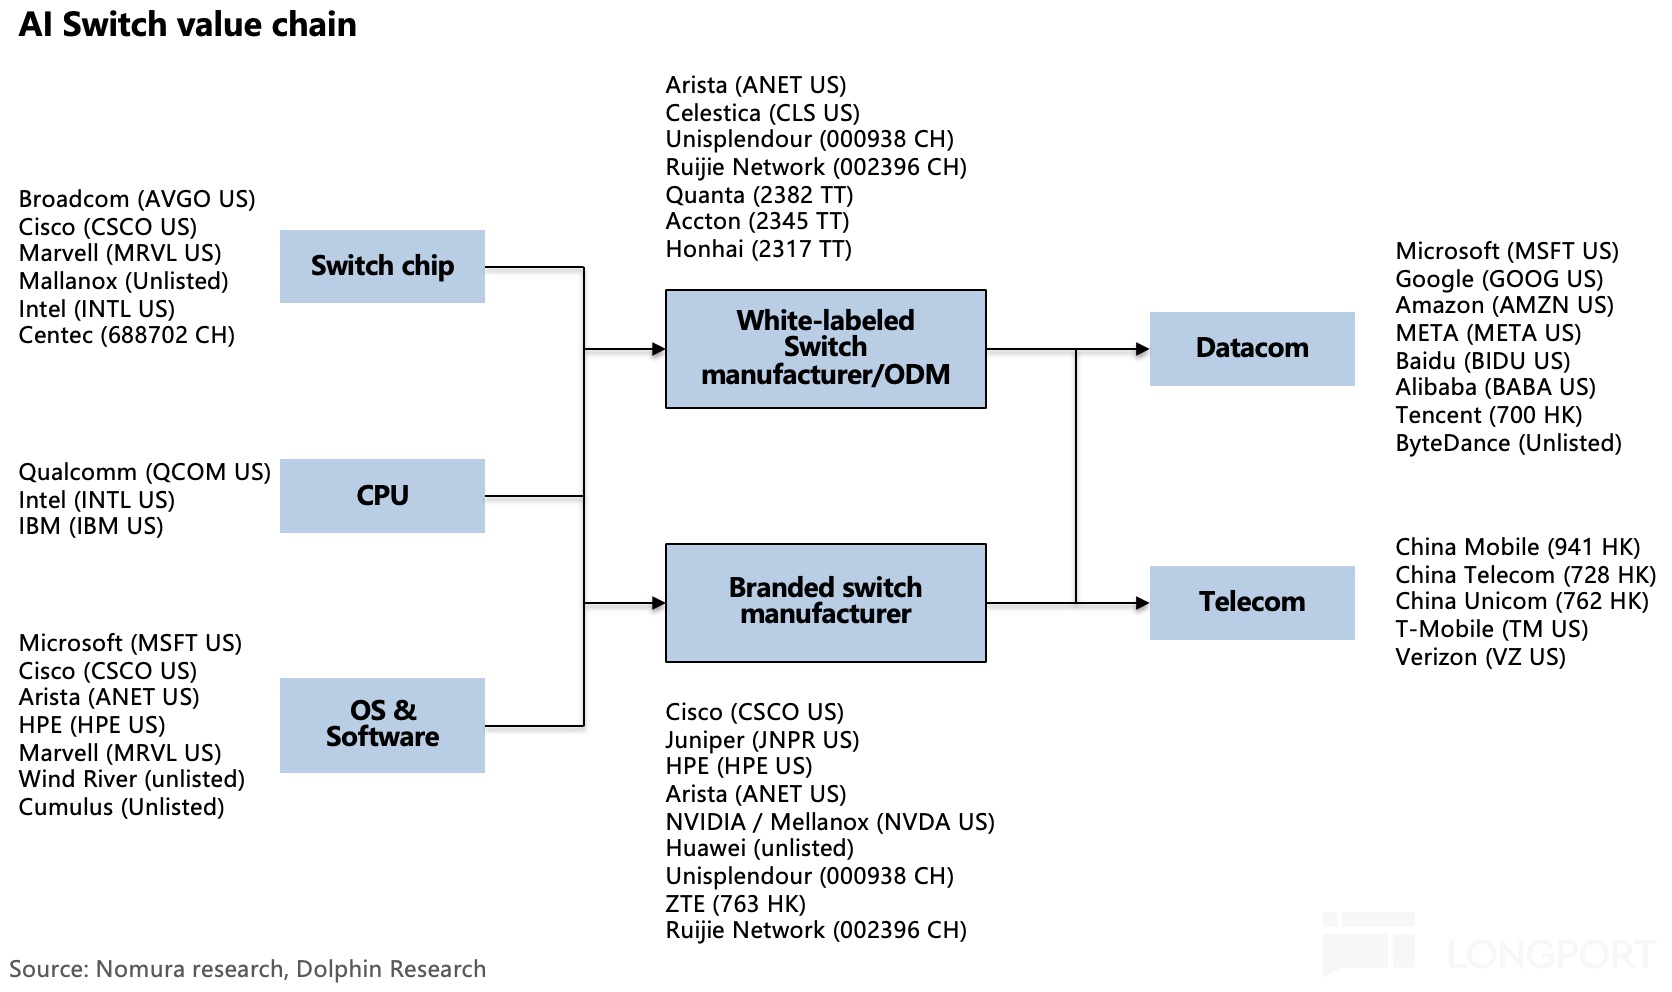
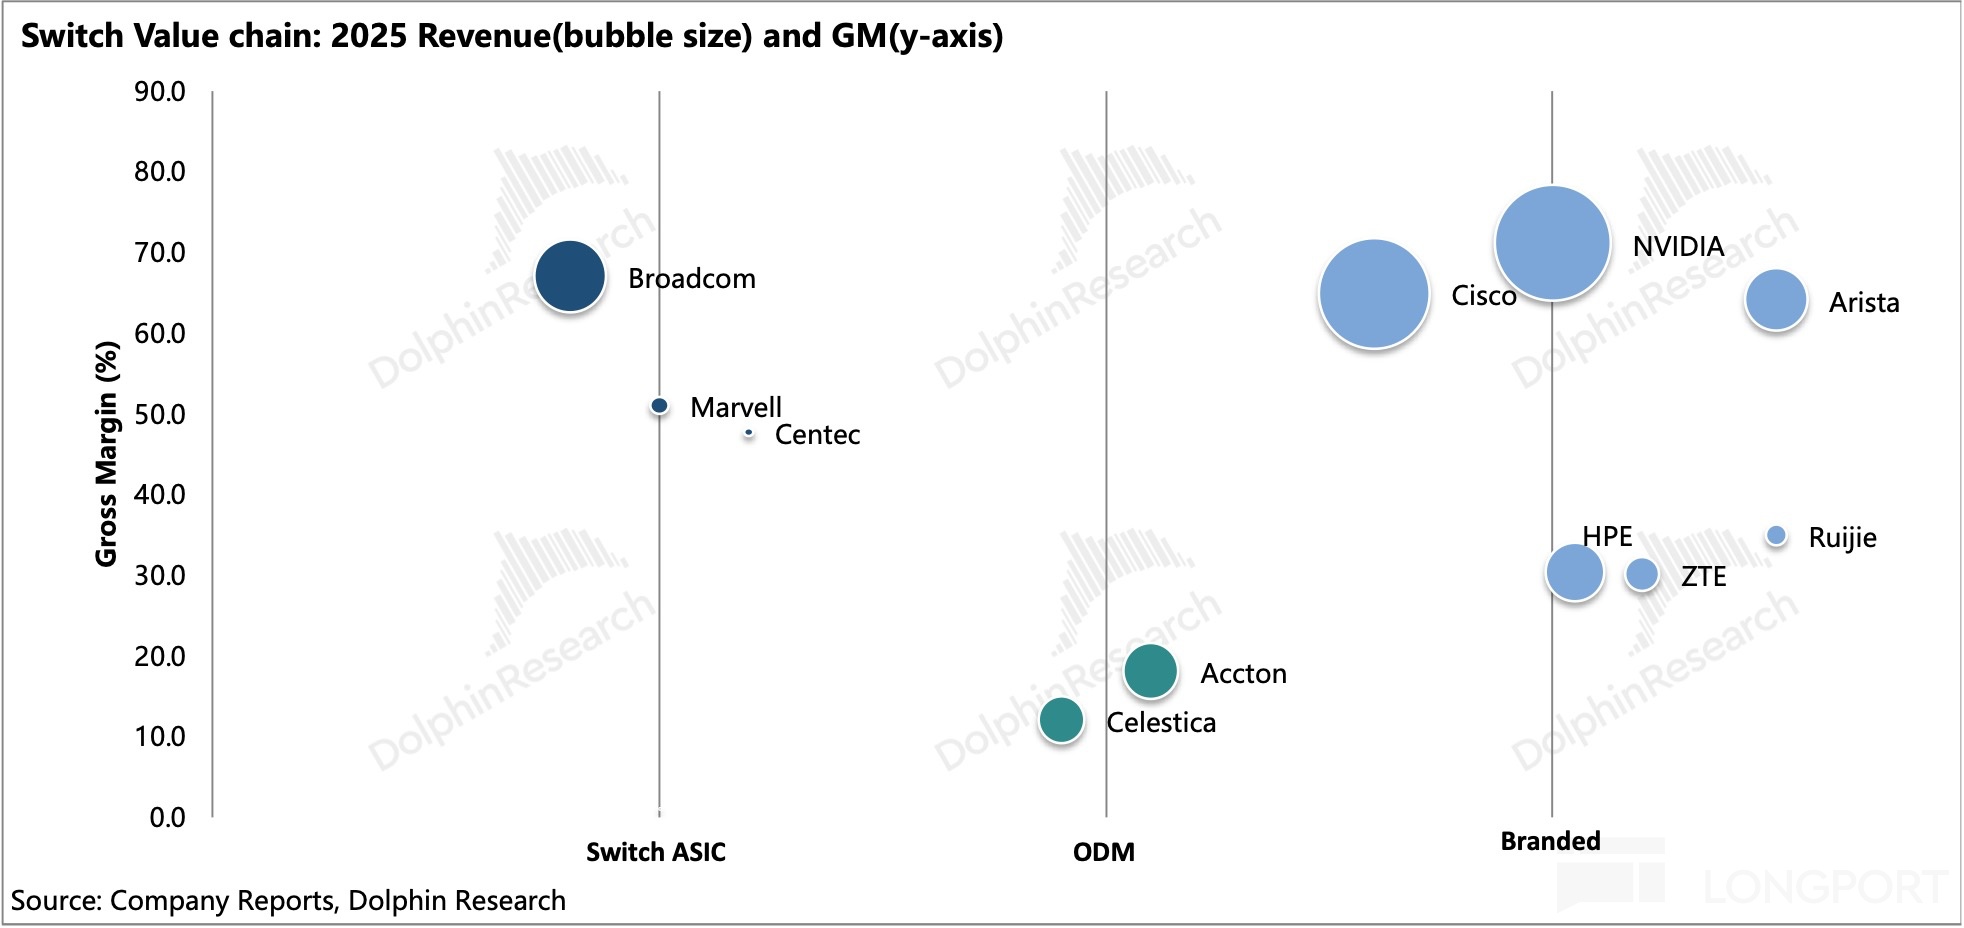
交換芯片的毛利率約50-70%,領先地位的品牌交換機廠商(Arista、Cisco、英偉達)毛利水平超60%,顯著高於白牌ODM交換機的10%-20%。因此建議選擇高端芯片與品牌交換機享受定價權的廠商:博通、Marvell、$思科(CSCO.US) 、NVIDIA、$Arista Networks(ANET.US) 。
3) 銅連接
英偉達與AMD的背板銅連接以DAC為主,其受限的物理距離極限並不適用於跨機架的Scale-Up連接方案。而AEC或將延長銅纜的生命週期,我們將在AWS(AEC的主要採用方)的產業鏈中討論這一部分。
4) PCB & ABF
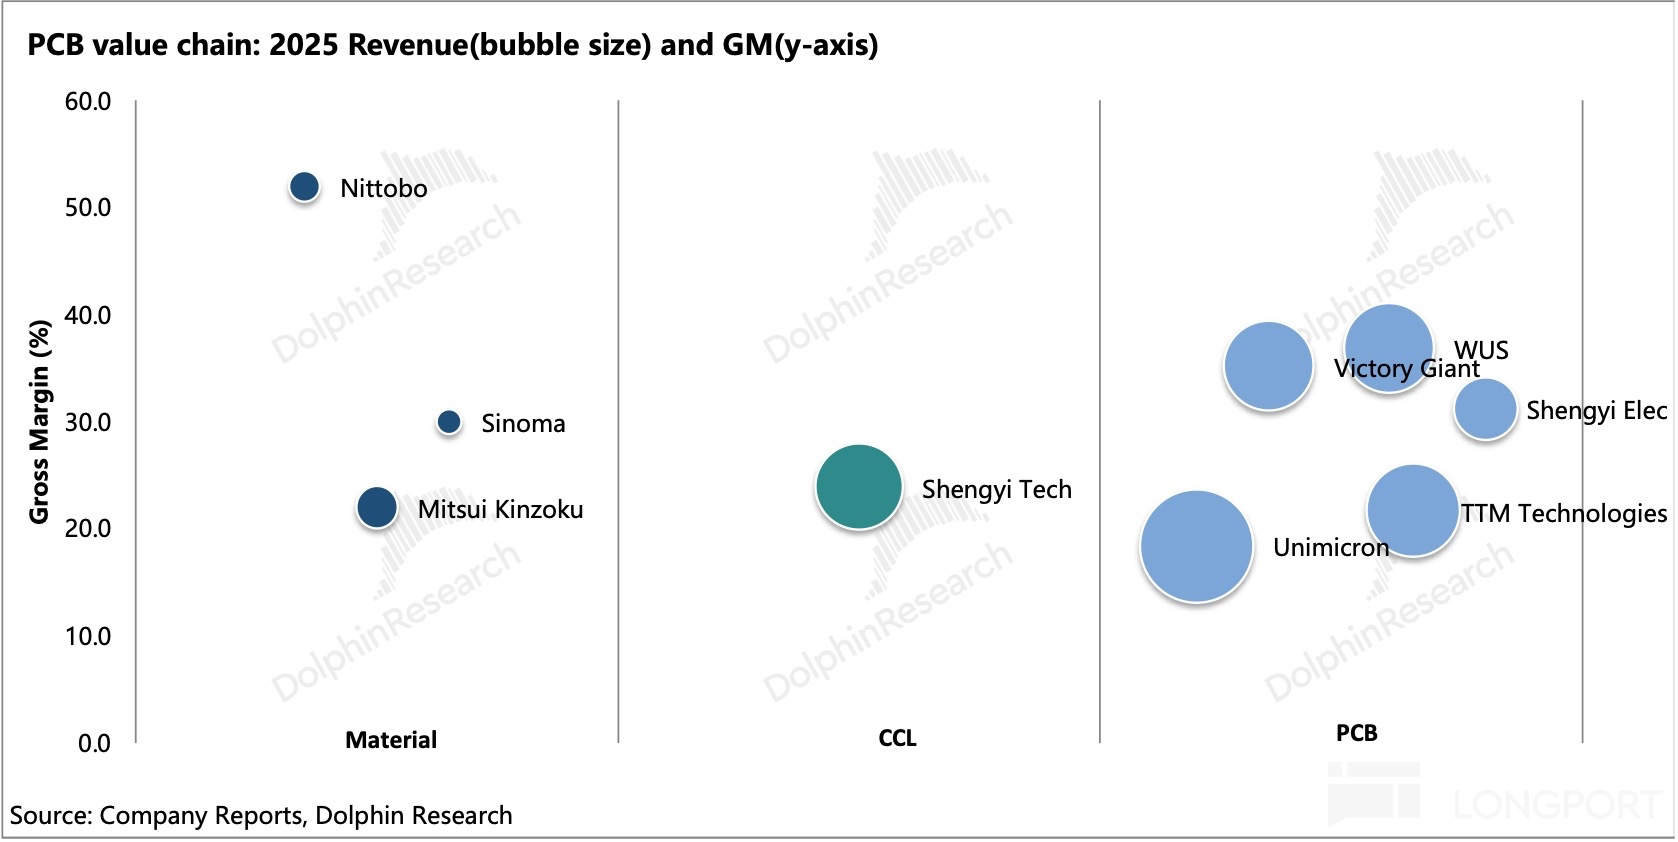
a. PCB/HDI:材料卡在日系,價值落在高層板
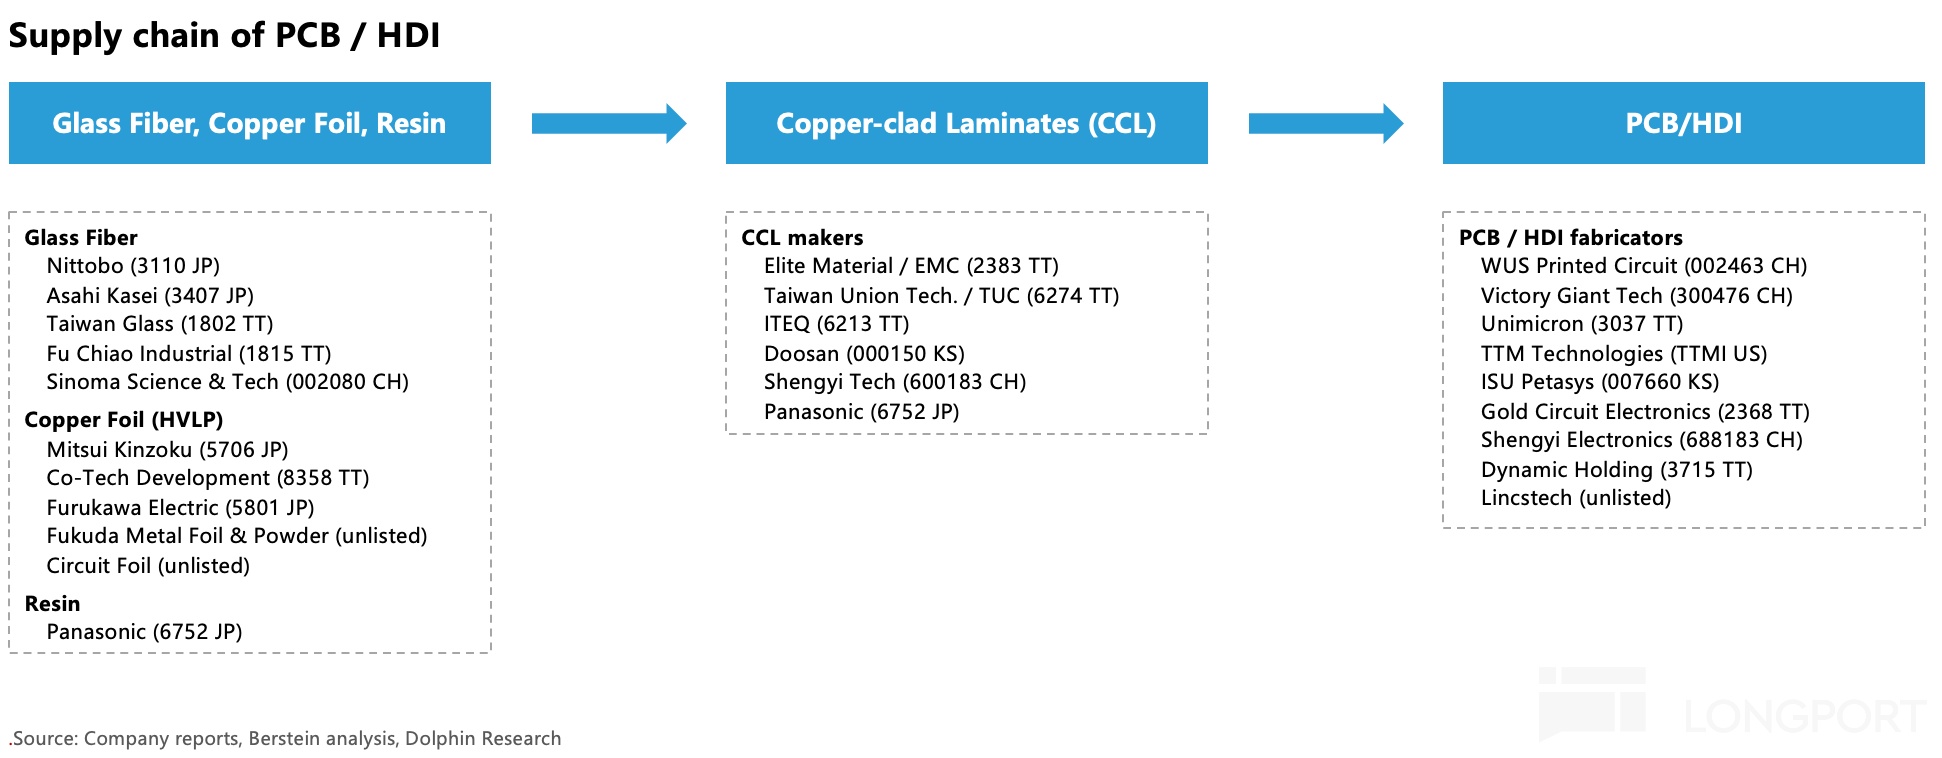
PCB/HDI 的核心是覆銅板(CCL):CCL 約佔 PCB 成本的 30%,而 CCL 自身成本又高度集中在三種上遊材料——銅箔約 40%、樹脂與玻纖布各約 25%。
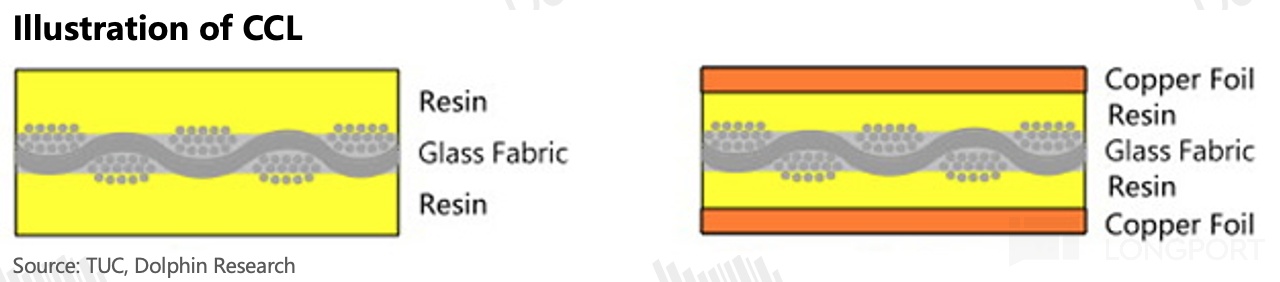
PCB 廠商的成本與議價能力,由上游兩種高端材料決定:玻纖布與銅箔。
VR 代際把 NVLink 飛線全部換成 PCB 走線,板上長距離傳輸要求極低的介電損耗(Dk 決定時延、Df 決定損耗)與極光滑的銅箔表面。因此這一代必須採用 Low Dk/Df 玻纖布與 HVLP(高頻超低粗糙度)銅箔。這兩種材料的供應較為集中:
- 三代低介電玻纖布由日東紡與 AGC 壟斷;二代布(性能次於三代布)國產替代進行中,但主要出貨仍依賴日東紡、AGC、台玻;
- HVLP4/5 級別(級別越高,性能愈佳)銅箔中,三井金屬份額超過 80%。
製造端,市場普遍預期Rubin Ultra 背板達 78 層或以上,其供應商勝宏科技已具備 70 層以上量產能力、100 層以上技術儲備,深南電路量產 68 層、儲備 120 層。
上游雖緊,但產業鏈各環節的毛利基本穩定在30–40%,説明漲價或許能夠沿鏈傳導,上游並未獨佔增量。
建議關注具備高層板量產能力的龍頭:$勝宏科技(02476.HK) 、$深南電路(002916.SZ) 。
b. ABF載板:日台壟斷
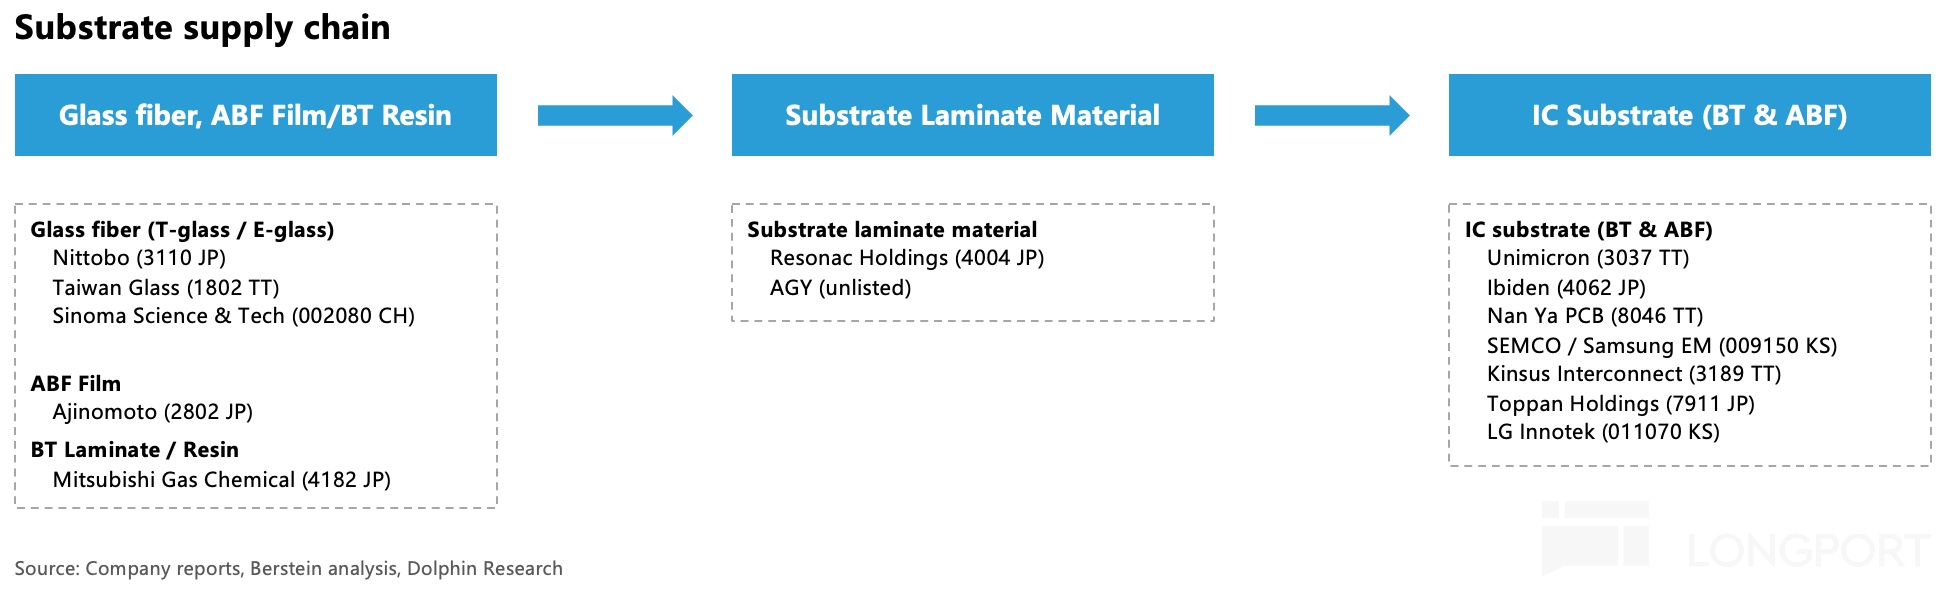
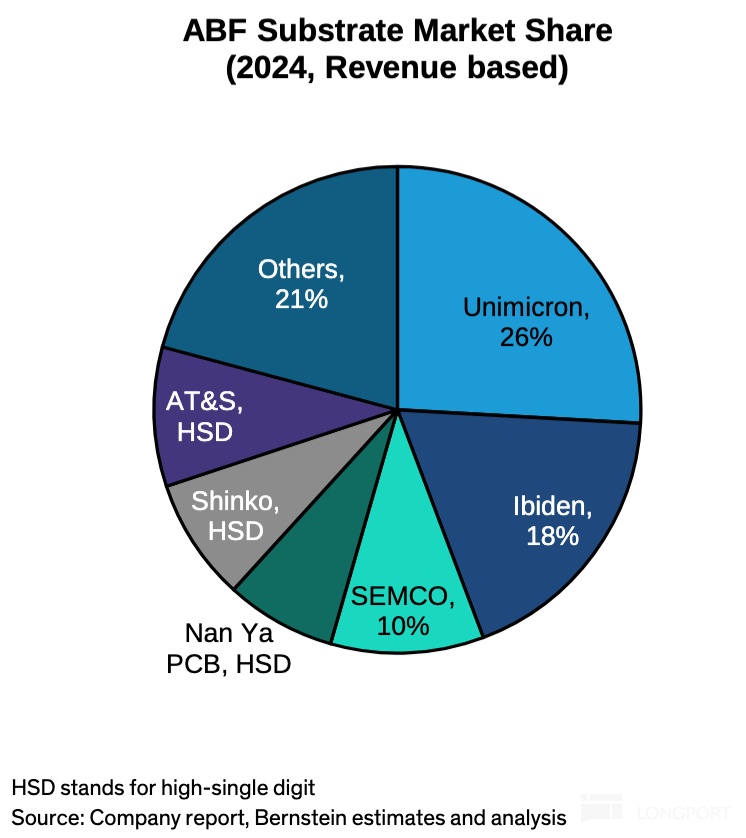
AI加速器所用ABF (中文:味之素堆積膜) 載板層數更少,但由於其需要在高温環境下保持穩定性,製造工藝要求更為苛刻。
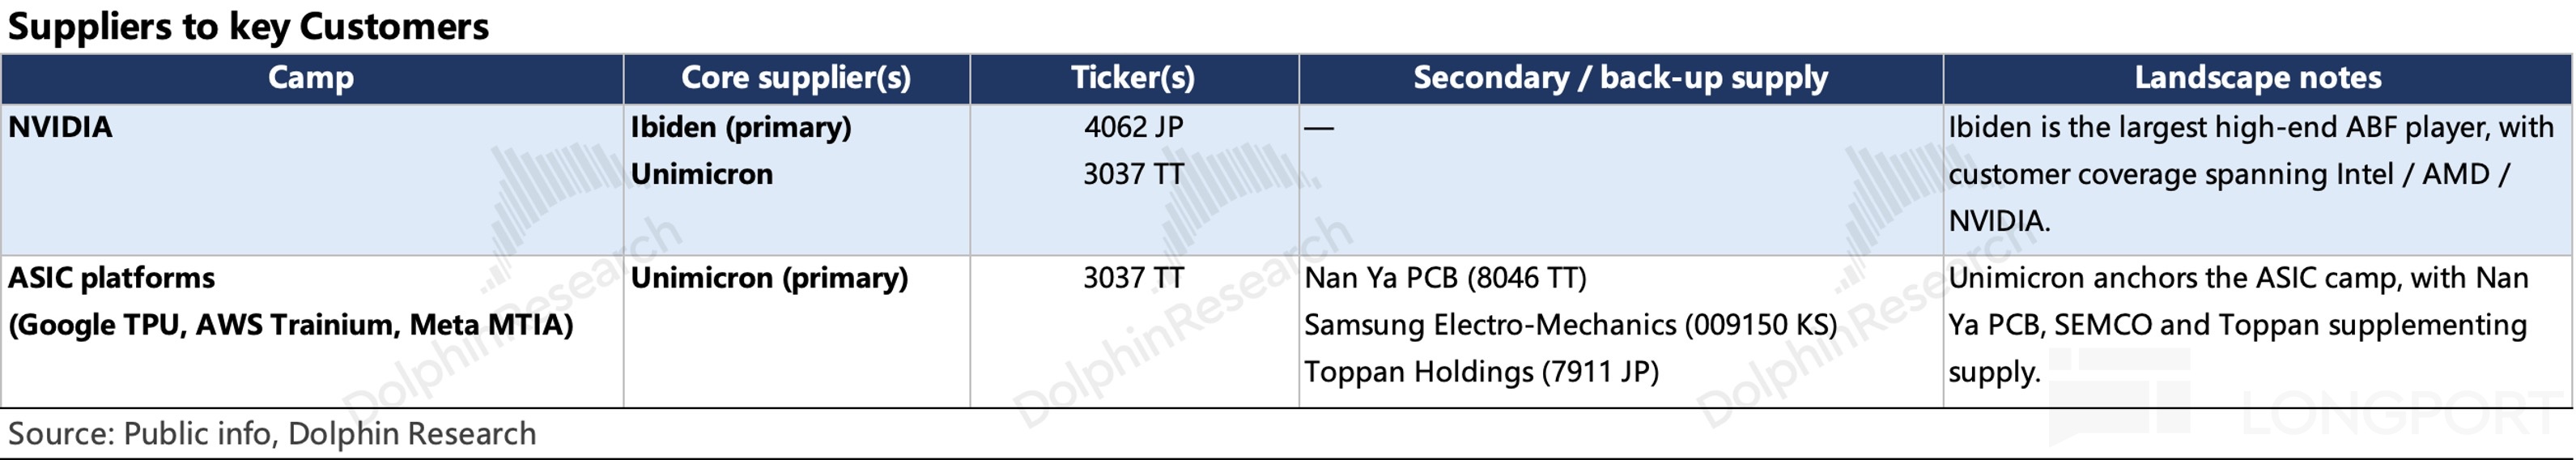
目前,該市場集中度較高,前三大玩家 (Ibiden揖斐電, Unimicron欣興電子, SEMCO三星電機) 佔據超50%的市場份額。
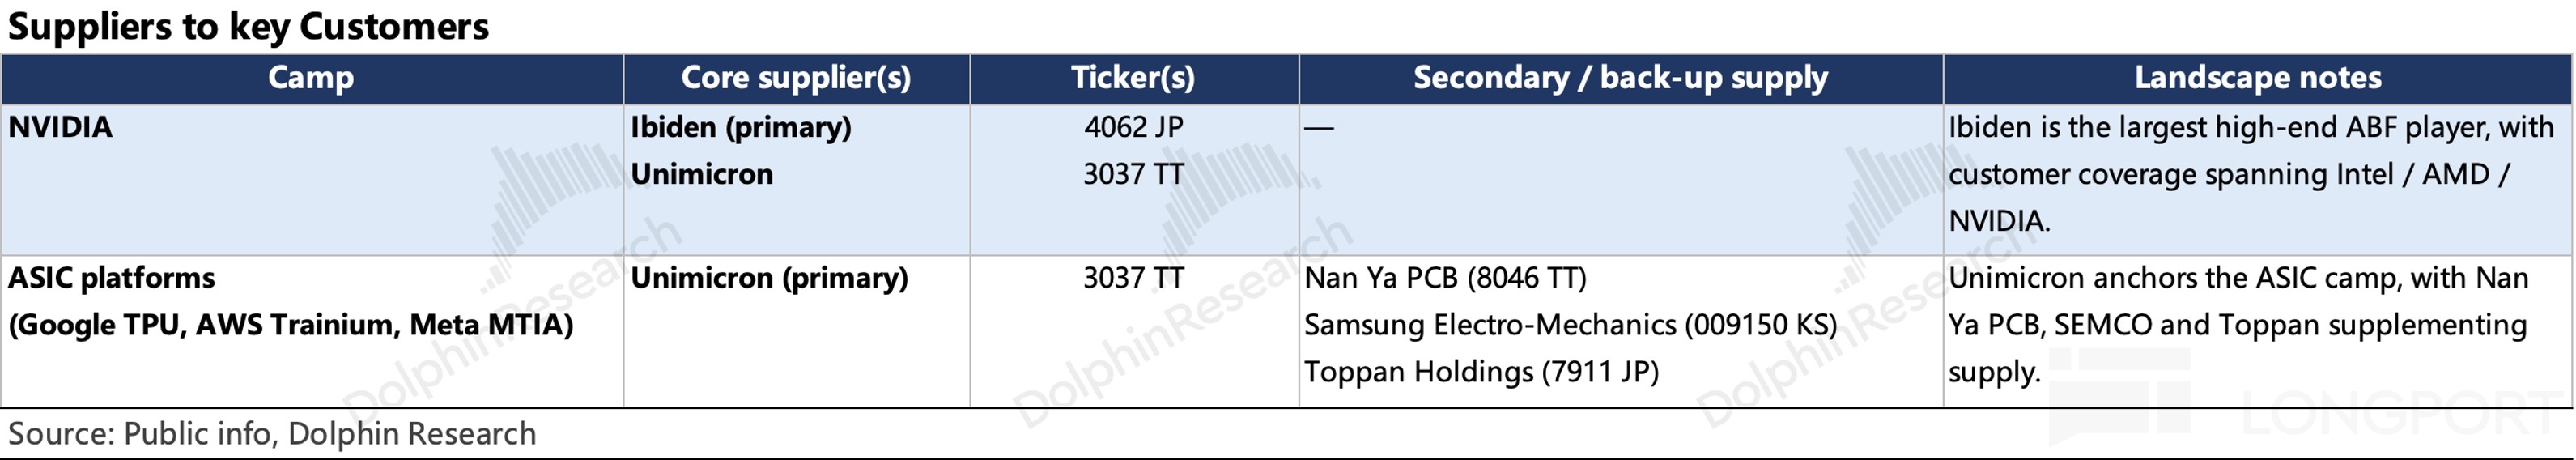
上游材料方面基本被日本廠商壟斷。
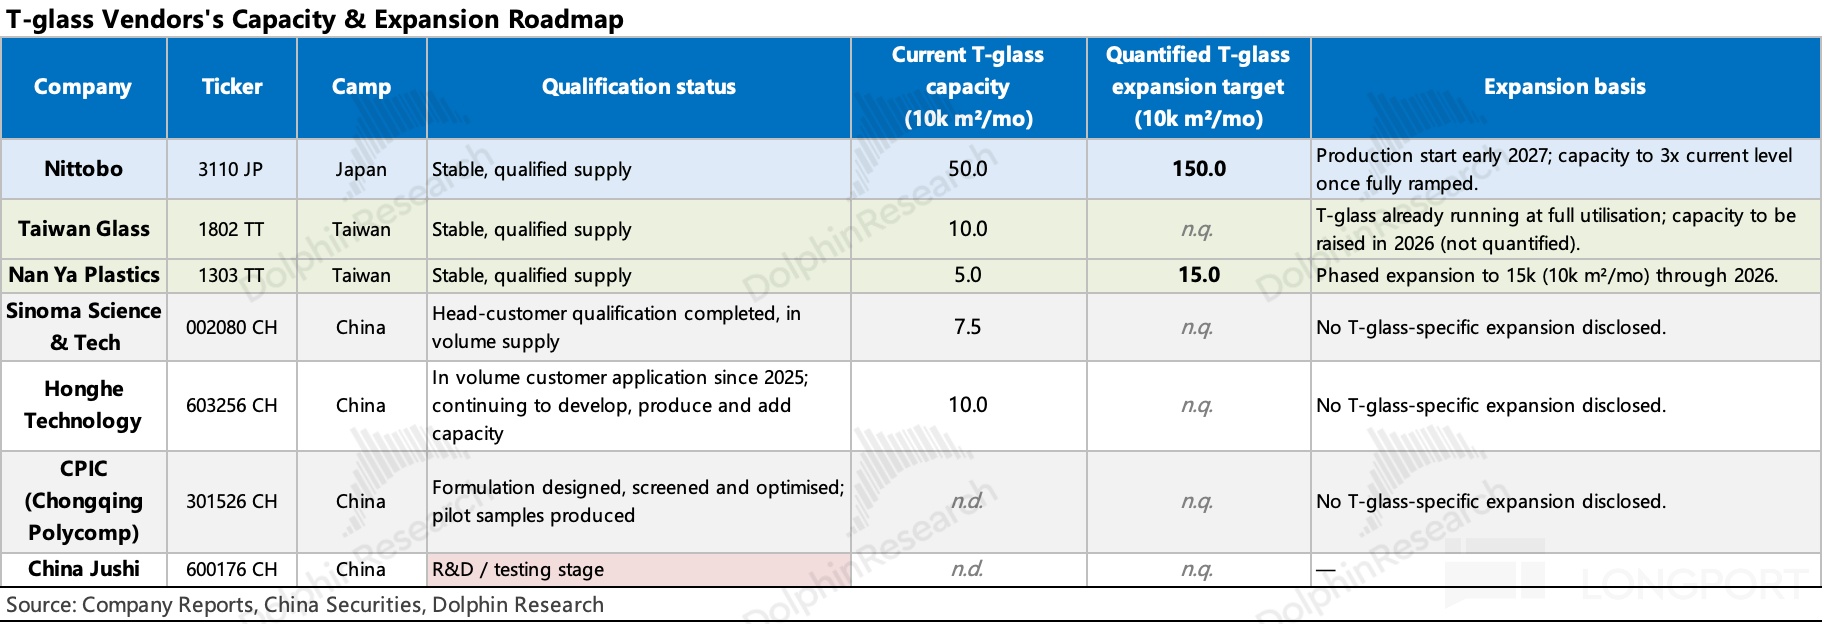
- T-glass(低CTE玻璃纖維):日東紡以近90%的全球份額基本壟斷。
- ABF增層膜:味之素市佔率95–98%,月產能超200萬平方米,2026年二季度已滿產,新產能要到2030–2032年才逐步落地,短期供給剛性。
AI DC互聯上的核心資產,海豚君整理如下:
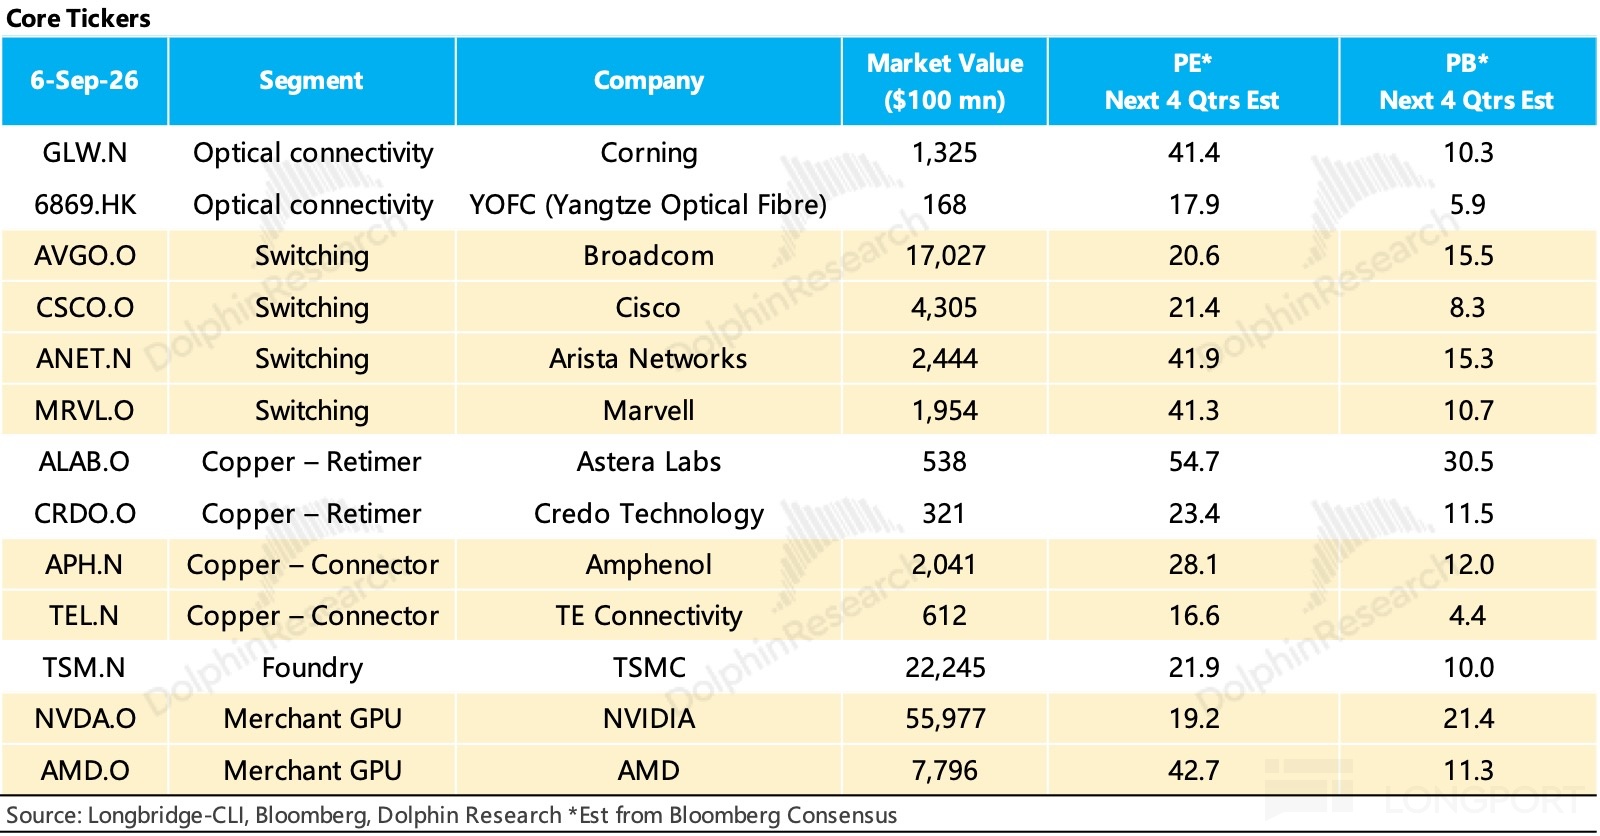
後續對比谷歌、AWS與華為等大廠的組網方案差異後,海豚君會挑出產業鏈上的核心資產,逐一跟蹤,敬請關注!
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
海豚君AI DC互聯繫列文章:


本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。