深度

D
Dolphin Research

AWS 图省事,组装式组网能打吗?

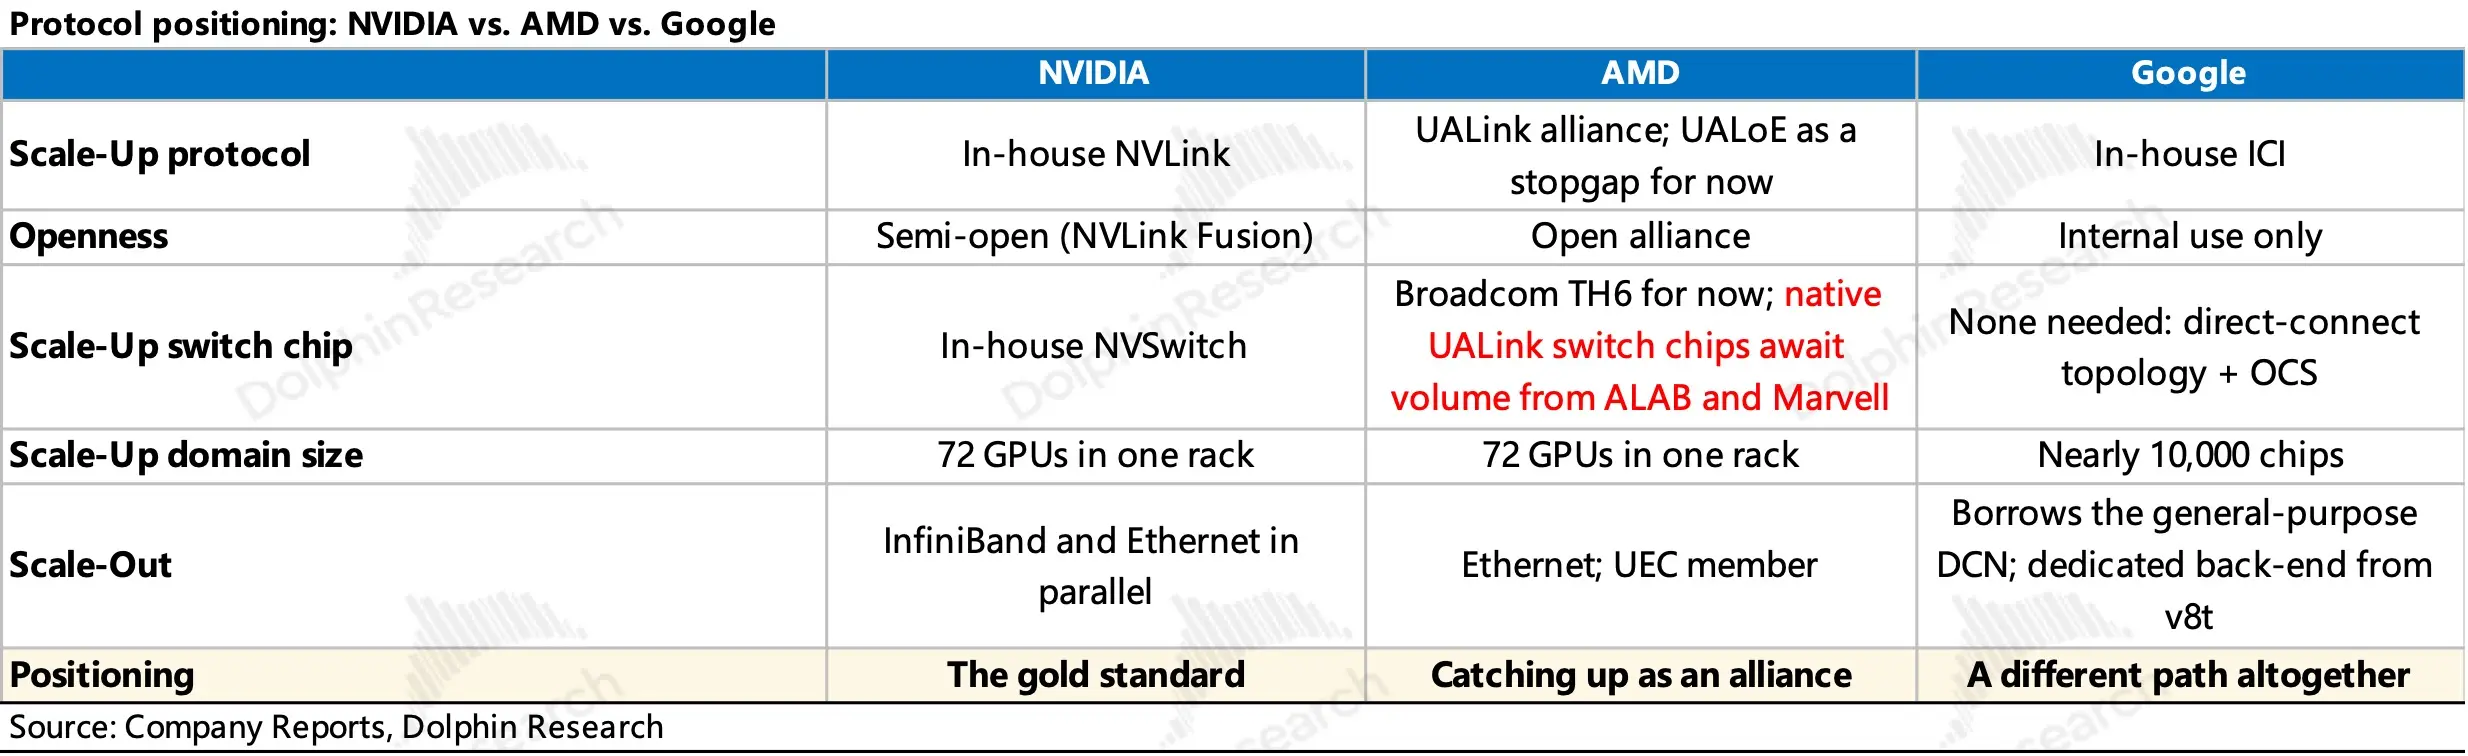
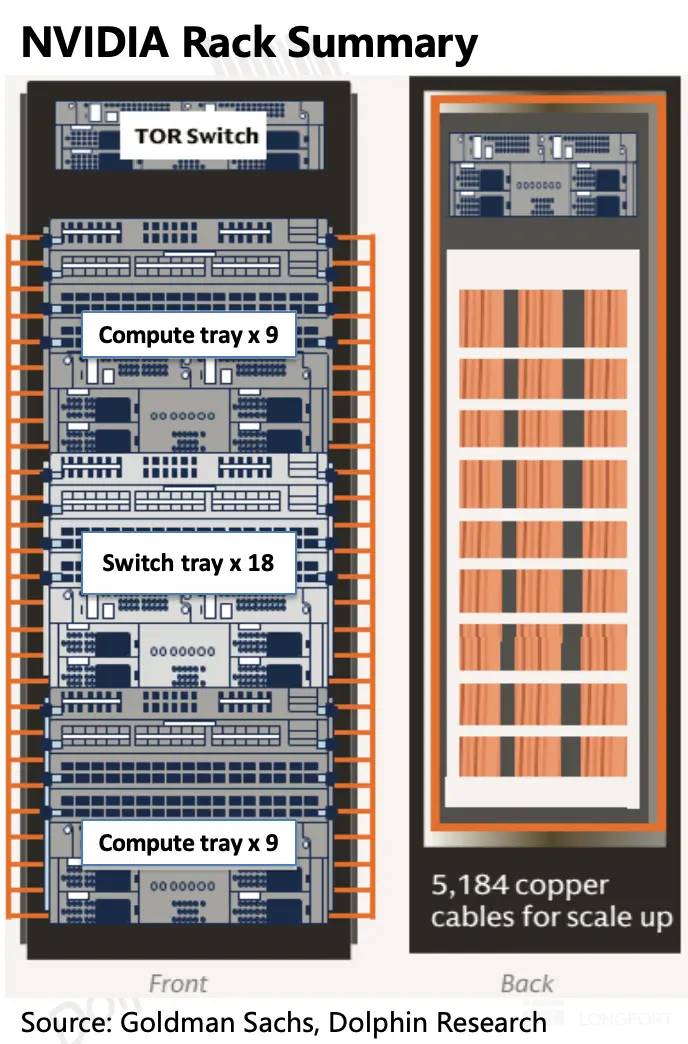
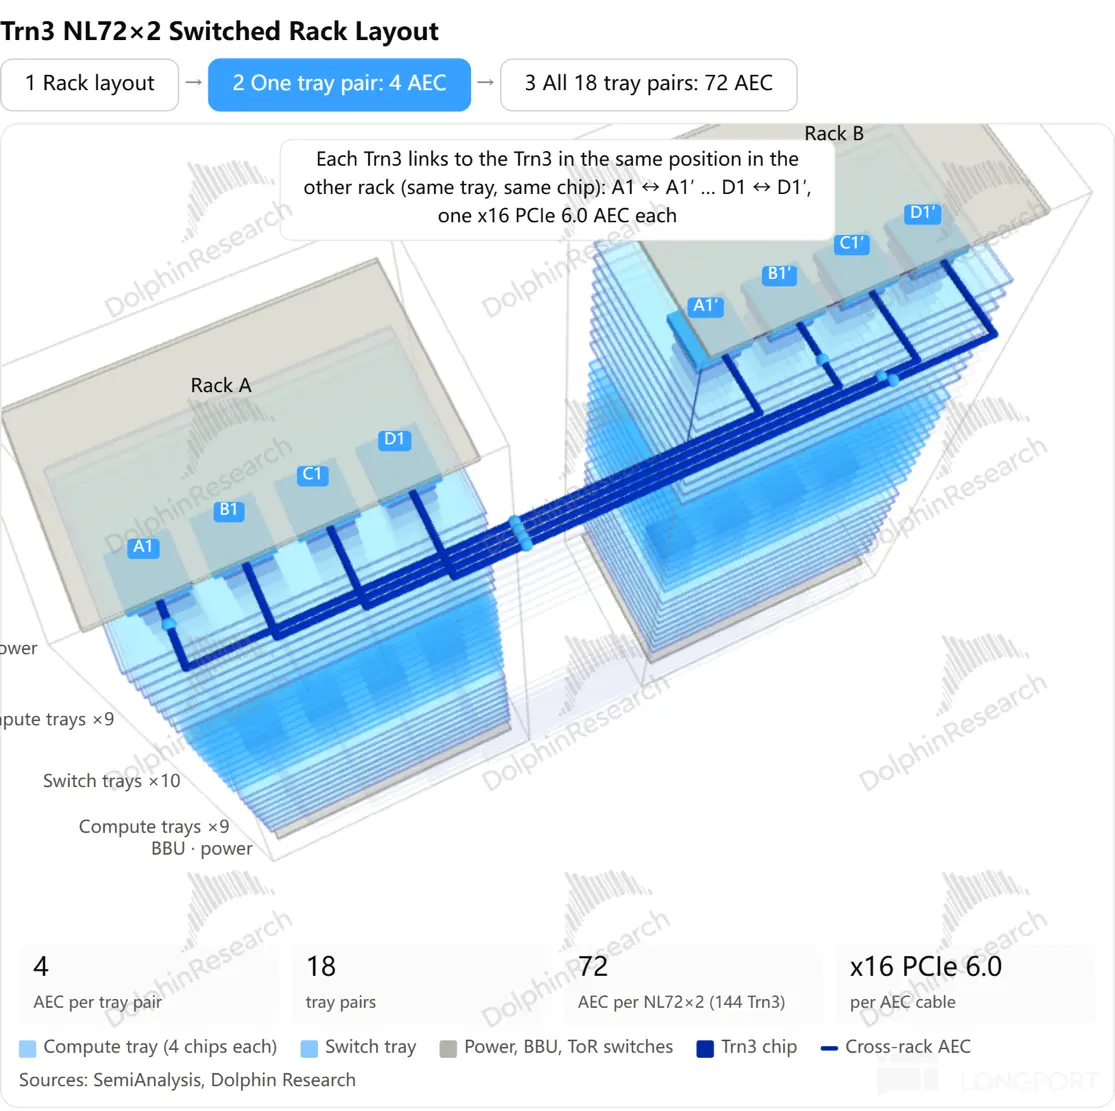
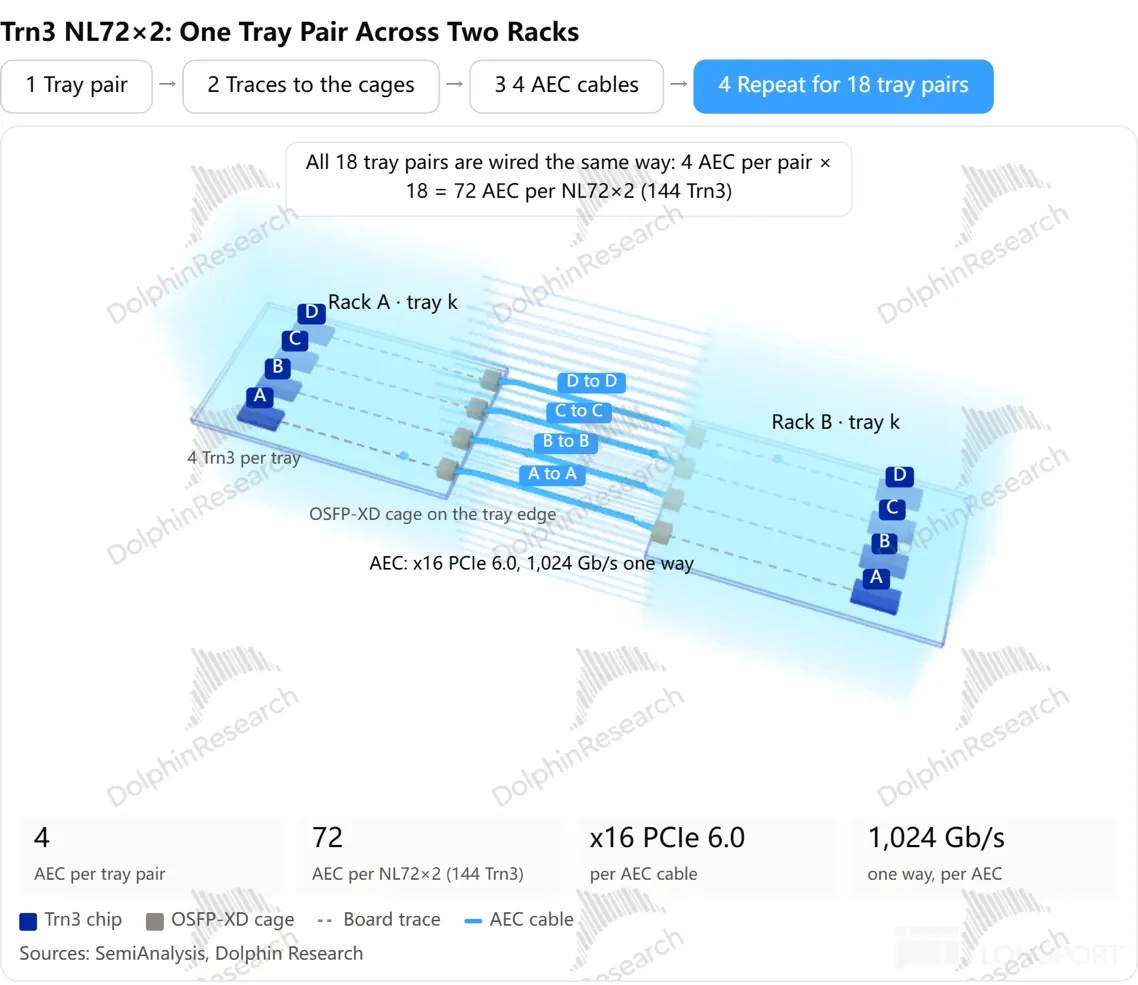
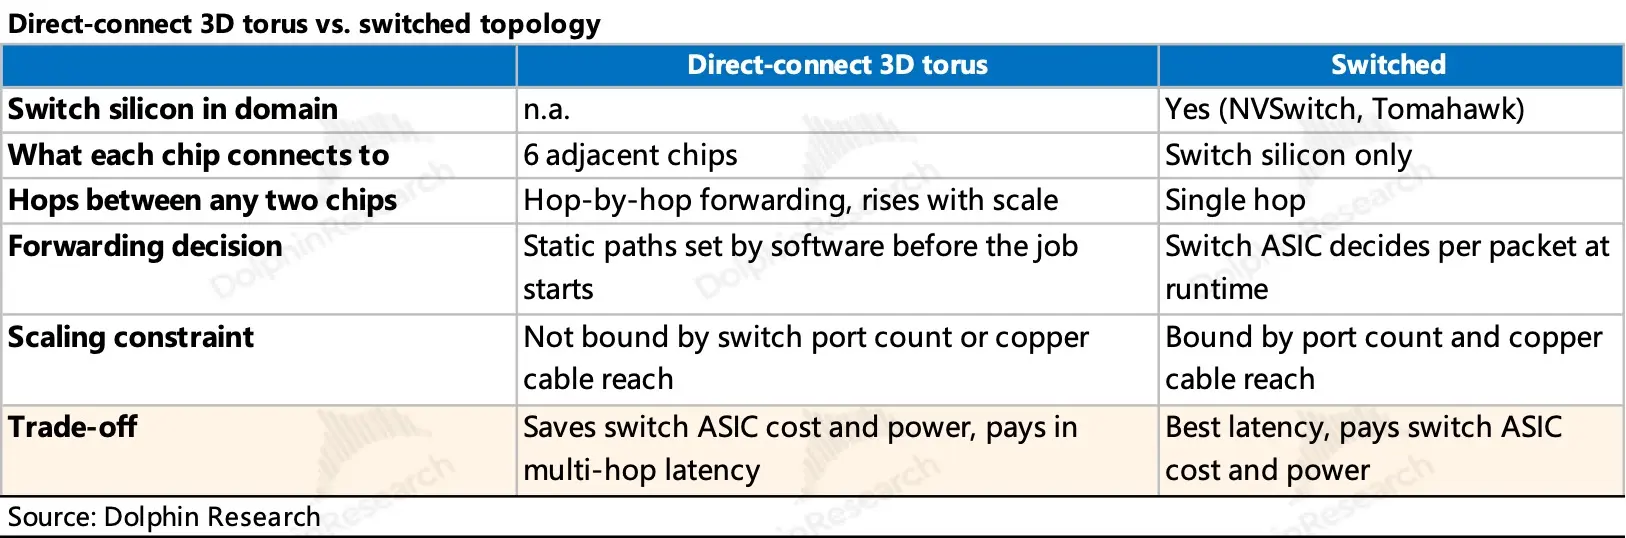
在近期的组网系列分析中,海豚君已梳理了了英伟达&AMD 为代表的 2D 胖树交换式组网,以及谷歌为代表的 3D torus 直连式组网。$英伟达(NVDA.US) 是行业基准。硬件、协议、软件全栈自研,软硬协同带来了最佳性能;方案迭代节奏快、跨度大,产业链逻辑也随之快速切换。$AMD(AMD.US) 效仿英伟达,但隔代竞争。Helios 照搬 GB300 NVL72 的组网架构...
aws 2.
Direct-connect 3D torus vs. switched topology Direct-connect 3D torus Switched S
Protocol positioning: NVIDIA vs. AMD vs. Google NVIDIA AMD Google UALink allianc
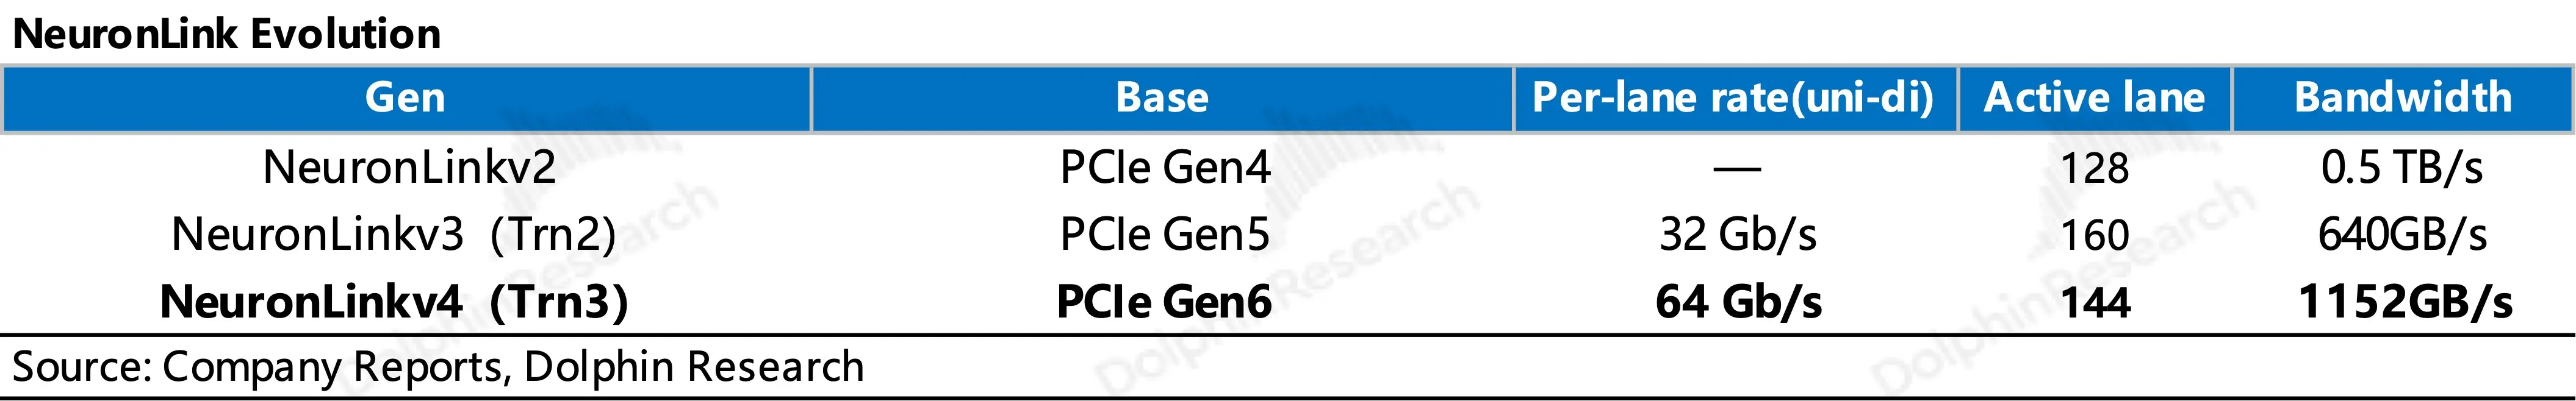
NeuronLink Evolution Gen Base Per-lane rate(uni-di) Activelane Bandwidth NeuronL+5
D
Dolphin Research

Cerebras:不切晶圆的芯片 “怪兽”,有希望挑战英伟达?

英伟达等绝对多数芯片设计公司都是把一块大硅片做好线路后,切成小芯片,小芯片再互联起来做 AI 加速器,避免因为制造瑕疵而报废整块硅片,而有一家公司却 “头铁” 地偏偏不走这条路。它直接把整块硅片当成一个芯片,大小如同 21.5cm x 21.5cm 的正方形果盘(面积与 12 寸晶圆所能截取的最大矩形面积相近),塞进了 4 万亿个晶体管和 90 万个核心,那就是 “Cerebras”。GPU 推理瓶颈是 “内存墙”...

ESE EiiW18823 cerebras 5 The World's Largest Chip 日 H 舒 点 WSE-3 器 Cerebras Wafer
CIv GIG A
WSE-3 Die Core 10.7k Cores 84 Die 900k Cores Source: Cerebras: ICerebras ONGPORT
Processing element Waveletin Input queues 8colors, task triggers Router Compute +27
D
Dolphin Research

SK 海力士:长协能熨平周期?估值到哪一步

HBM 价格暴涨,海力士股价半年最高暴涨 10 倍,但三星、美光正在快速抢占供应链份额。上篇我们完整推演了 DRAM、HBM 行业供需缺口变化,分析了周期拐点,详见上篇。 但行业景气不等于公司稳稳赚钱。本篇继续聚焦海力士,解析它和英伟达、各大 ASIC 客户的合作格局,对比三大厂商长协策略差异,测算未来业绩,并评估当下估值性价比。AI 时代,内存增量需求更集中于少数 XPU 厂商和云厂商手中...

SANDISK 951 SandiskDr.
HBM demand breakdown 120% NVDA AMD & other GPUs ASIC (TPU, AWS,etc) 100% aRes e
HBM in market share within NVDA (sales) 120% NVDA: SK Hynix 100% Researc Resear
Figure 40: HBM wallet share within ASIC % 100% U70 U70 7% 10% 12% 90% 80% 70% 50+12
D
Dolphin Research

海力士:超级 AI 加持,存储神话还能牛多久?

前两篇海豚君从技术角度梳理了 “存力” 行情的底层逻辑和发展方向,本篇把视角拉回公司,聚焦本轮最具代表性的 HBM 龙头——$SK海力士(SKHY.US) 。海力士当下的处境颇为微妙:一边是内存价格飙涨、HBM 持续紧缺,业绩大涨,股价一度在半年内涨了约 10 倍;另一边,三星和美光正快速切入英伟达等核心客户的供应链,海力士的优势正从 “独占” 走向 “领先”。作为制造业企业...

SKhynix N Nasdaq SKhynix SK hynix KRX 000660 Now Listed on Nasdaq 321,000 +1.000
DDR Demand -- Conventional DDR Demand Growth--Conventional bn Gb Computer (PC+La
Figure 3: DRAM/NAND as % of flagship smartphone Figure 4: DRAM/NAND as % of mid/
Products Shipment Growth DDR Used per Unit mn unit IohinResearch GB PC Laptop Mo+38
D
Dolphin Research

从 HBM 限高到 NAND 加量,英伟达 vs 存力到底谁拿捏谁?

在上篇的探讨中,海豚君从底层技术出发,回答了 AI 对存力的需求为何"突然"爆发,以及 HBM 凭什么成为高性能 GPU 的首选内存,并介绍了 HBM 内存技术的核心概念与逻辑。那么随着 AI 技术的发展,内存技术又将如何演变,以实现更大的容量和更快的带宽?恰巧,近期业内也出现了两个看似矛盾的信号:一边是 HBM 路线图继续加码,堆叠层数从 12 层走向 16 层、20 层;另一边据 SemiAnalysis...

High Bandwidth Memory HBM
Evolution Route 1: more Layers 720um- 口 一 口口 一 一 口 口 C 口口 口 一 一 口口口 口口口 C 高品 C 一
More Complicated Cooling for more Layers Next-Generation HBM Roadmap : Thermal M
Evolution Route 2: uncoventional layout Raised interposer for taller stack heigh+18