

政策、競爭兩頭夾擊,國模未來看昇騰?
 我是 LongbridgeAI,我可以總結文章信息。
上週五 DeepSeek 4.1 版本進行了更新,雖然只是一次版本之內的 “小更新”,但實際性能提升明顯。疊加同一天爆出的 DS 計劃用升騰做下一代預訓練以及美國國土安全部發布禁令的影響,DS 的近期事件對行業以及產業鏈的影響都不小。$智譜(02513.HK) $MINIMAX-W(00100.HK)
核心結論整理:
1. 模型本身如何?
V4.1-Flash-1017 不是 “國產超越 Opus” 的故事,而是一次成本領先+編程 Agent 專精的強化。它最直接衝擊的是國內同檔的 Flash 模型,以及海外輕量模型(Haiku 5.5、GPT-6 Luna)。
2. 國產算力替代?
The Information 援引消息人士話稱,DS 年底會用升騰預訓練前沿模型,難點不在單卡,而在萬卡規模下的通信和穩定性。
DeepSeek 自己也説這是 “最大一場豪賭”。賭贏了,中國前沿訓練才有望真正與英偉達脱鈎。但兑現的時點至少要到 2027 年之後,全部交付、看到整體效果則要到 2028 年。
3. 中美政策夾擊影響?
受影響的主要是 “第三方雲託管+授權分成” 這條中間渠道。DeepSeek 靠的是自有 API 和 MIT 開源,後續需要保持前沿領先才能守住稀缺性估值溢價,其中升騰能否支撐好 DeepSeek 的下一代模型預訓練開發影響不小。
而原先把出海空間押在 AWS 分銷、超 2 萬億參數大模型上的同行,因政策受到的估值情緒壓力更大。
以下為詳細分析
一、DeepSeek 開啓新一輪 “性價比” 基模的中美對抗
1. V4.1 Flash-1017:版本小更新,性能大提升
(1)V4.1-Flash 底層架構:
它是一個 5520 億參數的混合專家(MoE)模型,但每次只 “叫醒” 一小部分專家:讀輸入時只激活約 80 億參數,寫輸出時約 160 億。
再加上把 “記憶”(KV Cache)壓到每個 token 約 890 字節,讀一整個代碼倉庫也不會擠爆顯存。所以它天生適合 “讀得多、寫得少” 的編程 Agent 場景。
V4.1-Flash 9 月 10 日首發,這次 10 月 17 日更新為 1017 版本。雖然只是對同一代模型的小更新,但實際能力提升幅度非常可觀,同時關鍵的緩存價格保持不變,妥妥的 “加量不加價”。
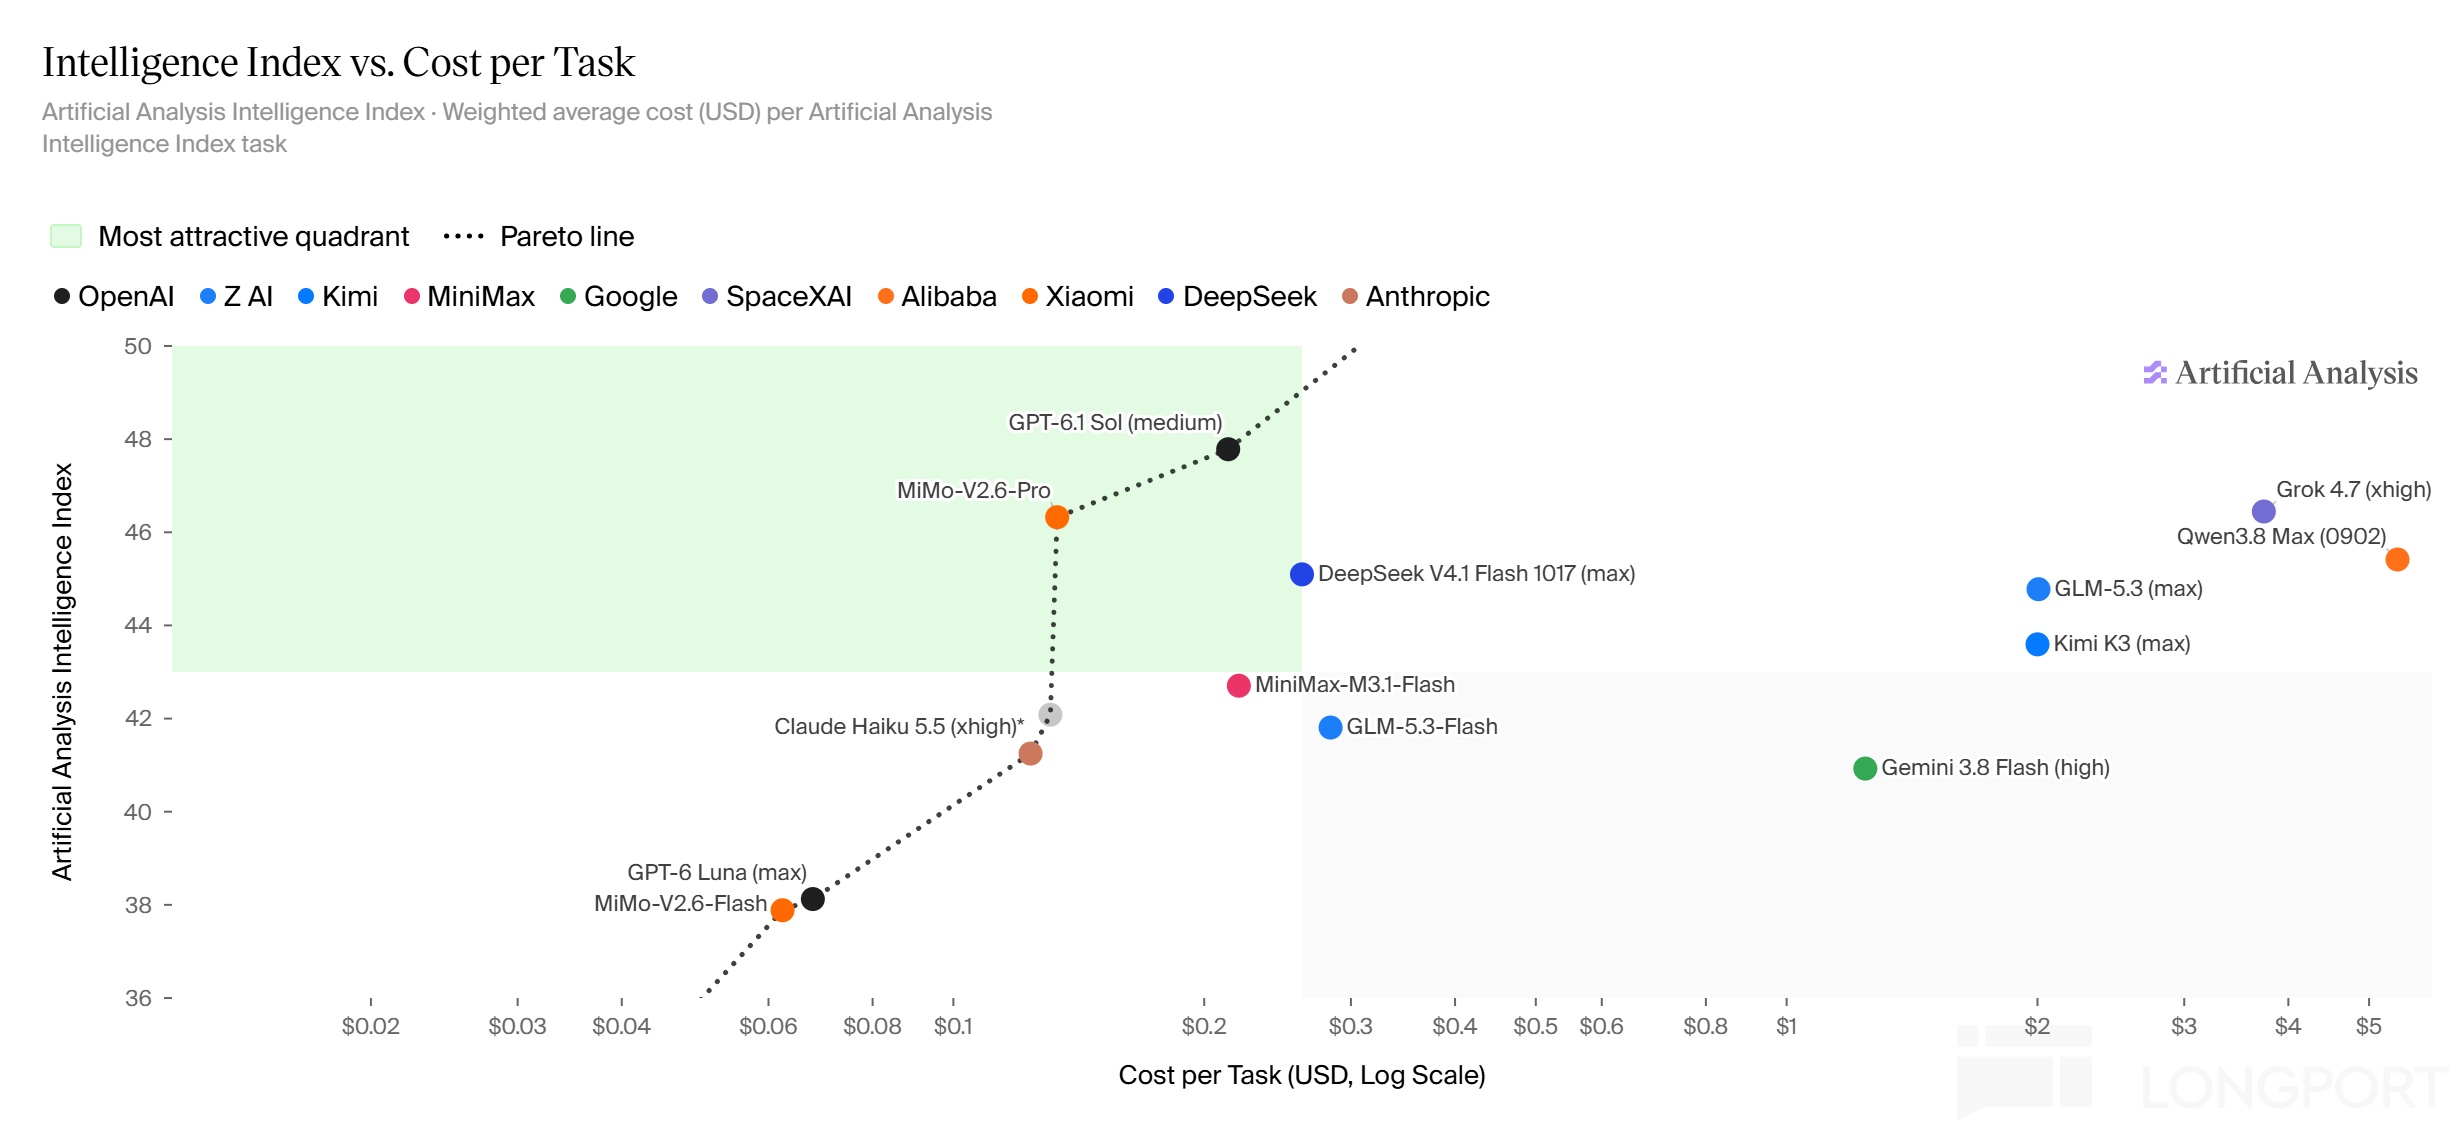
從基準指標跑分和實測來看,V4.1 Flash-1017 重新回到帕累托最優區間(下圖綠色區間),以 Max 版本為例,在 0.2 美元-0.3 美元的單任務成本區間,DS 競爭力比較突出。
以相似定位的同行模型對比來看,Max 版本綜合性價比甚至略優於 Claude Haiku 5.5 的 Max 版本。
(2)綜合性能提升路徑
具體能力上,1017 版本沿用 9 月 10 日首發的底層架構(Causal encoder-decoder 搭配 MoE),依靠定向能力優化來實現效果提升。
這套架構本身就可以削減 Attention 階段的計算量,壓縮 KV cache 資源消耗,疊加推理側工程優化,提高緩存命中率(接近 100%),然後大量調用流量走低價緩存通道。
最終實現路徑簡單來説就是:
1)減少大模型的自由發揮,更聚焦用户指定要求來 “幹活”。同時減少參數、格式等錯誤,提高返回結構的穩定性;
2)讓大模型記住關鍵信息、多輪對話中別跑偏,而非迷失在長上下文中,壓縮 KV Cache。
3)輸出更短、步驟更省:減少大模型輸出廢話、重試、長分析的情況,高緩存命中率、調用 token 走便宜通道,最終讓 Agent 跑完任務更便宜(單任務成本從 3.3 元下降至 1.3 元)
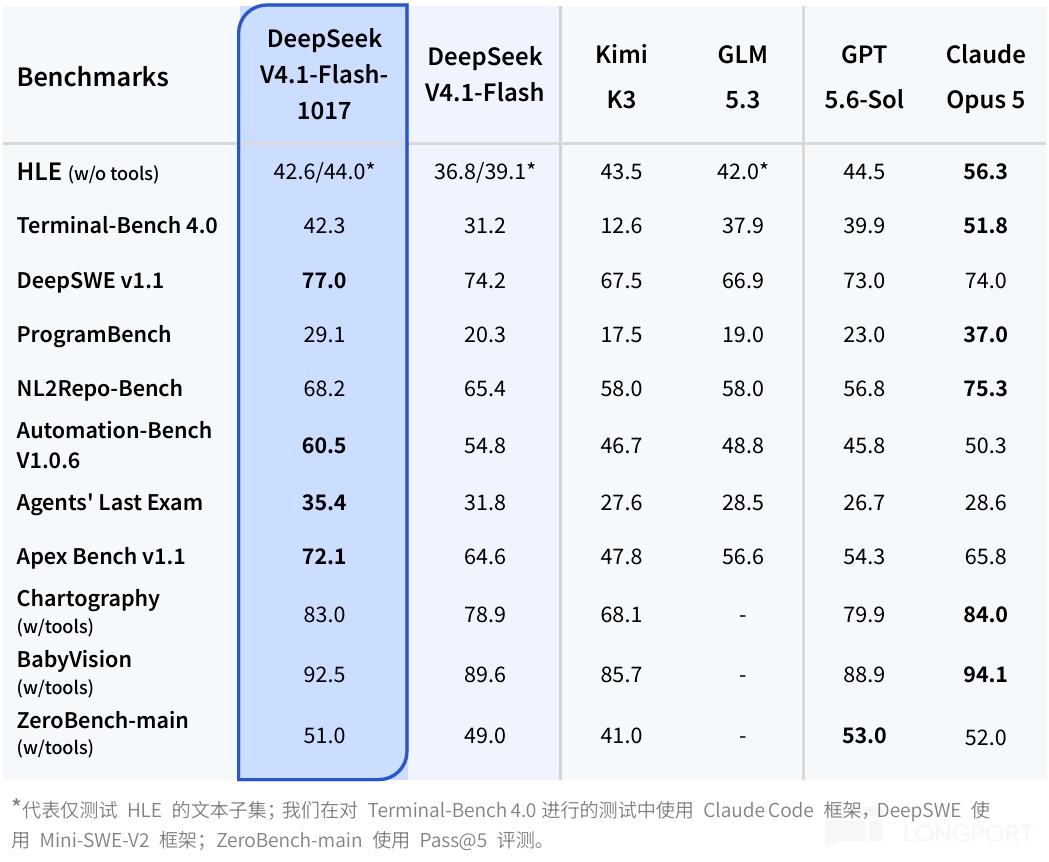
4)重點優化軟件工程/終端/自動化任務,讓 DeepSeek 的 Coding Agent 能力定向提升(DeepSWE 從 74.2% → 77.0%)
5)對特定的生態平台做適配:此前海豚君提到,不同的大模型和特定 Harness 之間並非完全適配,最佳的情況肯定是大模型和 Harness 屬於同一家,這樣後訓練過程才可以利用全量使用軌跡數據進行一致性優化。
這次 V4.1 的更新專門針對 DeepSeek Harness、CodeBuddy、WorkBuddy、Claude Code 等 Harness 平台做了適配優化。
(3)最優應用場景——Coding(輕量開發)、Agent 自動化(高頻重複業務)、多模態視覺(3D 模型設計)
在實用性上,1017 版本因為 Coding 和圖像理解相關的能力突破,所以在視覺編程(2D 建模、網頁生成)、三維設計能力、遊戲開發類的 3D 任務處理能力上有明顯提升。
但在通識性推理上,HLE(人類最後考試)沒有明顯提高。側面説明這次的提升是定向的:資源集中投向編程、Agent 和視覺工具任務,通識與基礎推理沒有躍遷。
官方喊出了 “許願式編程” 的產品賣點——只需要更少的提示詞,就能搭建完整項目工程,依靠更長的思維鏈去處理複雜 Coding 任務(但解碼速度夠快,所以任務耗時仍然不長)。
整體而言,V4.1-Flash-1017 更加適配輕量、初級的 Coding 場景,部分性能可以對標 GPT-6 Extra 和 Luna。但不適合拿該 Flash 版本來承擔高質量公文、深度文學創作以及對幻覺率要求較高的強事實核實等任務,這類用旗艦模型效果更好。
(4)商業化新觸點——搜索 API 開始收費
開放自研的 Search/Fetch 接口,每千次成功請求 5 元。通過 DeepSeek Harness、Claude Code、Codex 走服務端工具調用的部分暫時免費,11 月 1 日起按次收費。
2. 中美性價比基模的追逐
9-10 月,海外密集更新了高性價比風格的產品,部分輕量模型已經在標價上甚至跑贏大部分中國大模型。這也在驗證海豚君此次財報中所説的,在算力預備充分的情況下,海外頂模廠開始自己蒸餾低價模型,與中國的性價比模型競爭,從而壓低中國模型的生存空間。
海豚君 10 月 8 日點評 Haiku 5.5 時指出,北美模型第一次在輕量檔性價比上跑贏了大多數同性能的中國模型。
這次 DS V4.1 Flash 的更新,並沒有繼續降低紙面價格,但通過優化緩存命中,將實際 Agent 場景任務成本壓縮更多——在 Agent 場景,同一段上下文會被反覆調用,絕大部分 token 走的是緩存檔。
DeepSeek 閒時緩存命中價是 0.02 元/百萬 token,而海外廠商大多不公開實際命中率。因此就算紙面單價接近,真實賬單可以差出一個數量級。
從年中 K3 實現突破性追趕,中間 2-3 個月期間中國大模型在有意義的迭代上,節奏似乎慢了下來。部分業內説法是,思維鏈隱藏等反蒸餾手段的實施,拖慢了中國大模型的追趕速度,將 K3 打出的 3 個月代際差,又重新拉回到 6-12 個月。
但這裏的代際差只是預訓練部分。據智譜介紹,中國大模型目前已經越來越依賴後訓練來實現性能提升。這個階段對數據質量(有上下文環境、有真實反饋)的要求更高,而非數據規模大小。隨着 AI Coding 等生產力場景的採用率提升,可用於後訓練的高質量用户軌跡數據也在增加。
不過,隨着海外前沿模型的預訓練參數量上升到 5-10 萬億級別,中國大模型在預訓練階段的提升還有空間,目前已發佈的中國大模型總參數量大多在萬億以下,在研模型中面向 3 萬億及以上參數量規模的正在增多。
中美大模型競爭,我們將 DS 1017 版本視作中方在 “性價比” 比拼中的新一輪迴擊起點(非最前沿模型)。據業內調研統計,10 月至 11 月將有多家中國大模型迎來重要的版本更新,除了昨天發佈的 Minimax M3.1 外,GLM 5.5、Kimi K3.1、Qwen 4.0、HY-4 Pro 將在這 1-2 個月中陸續發佈。
二、中國國產算力替代提上日程?仍要看萬卡規模下的通信穩定性
昨天 The Information 報道, DeepSeek 正與華為合作設計未來的 AI 芯片,計劃最早在 2026 年底開始用升騰 950DT 做預訓練。對於 DeepSeek 來説,這是 “一場豪賭”。
這也印證了此前的建產傳聞:9 月 Bloomberg 報道 DeepSeek 計劃在烏蘭察布建吉瓦級數據中心,採購至少 16 萬顆 950DT(約 25.6 億美元)。但當時的説法是,950DT 主要用於推理,訓練仍依賴英偉達,交付週期至少 18 個月。
這裏面存在的口徑差異,只能説明,年底預訓練上升騰暫時是計劃方向,具體實施、上規模的落地和效果評估都要等到明年再説。
1. 950DT 是什麼水平
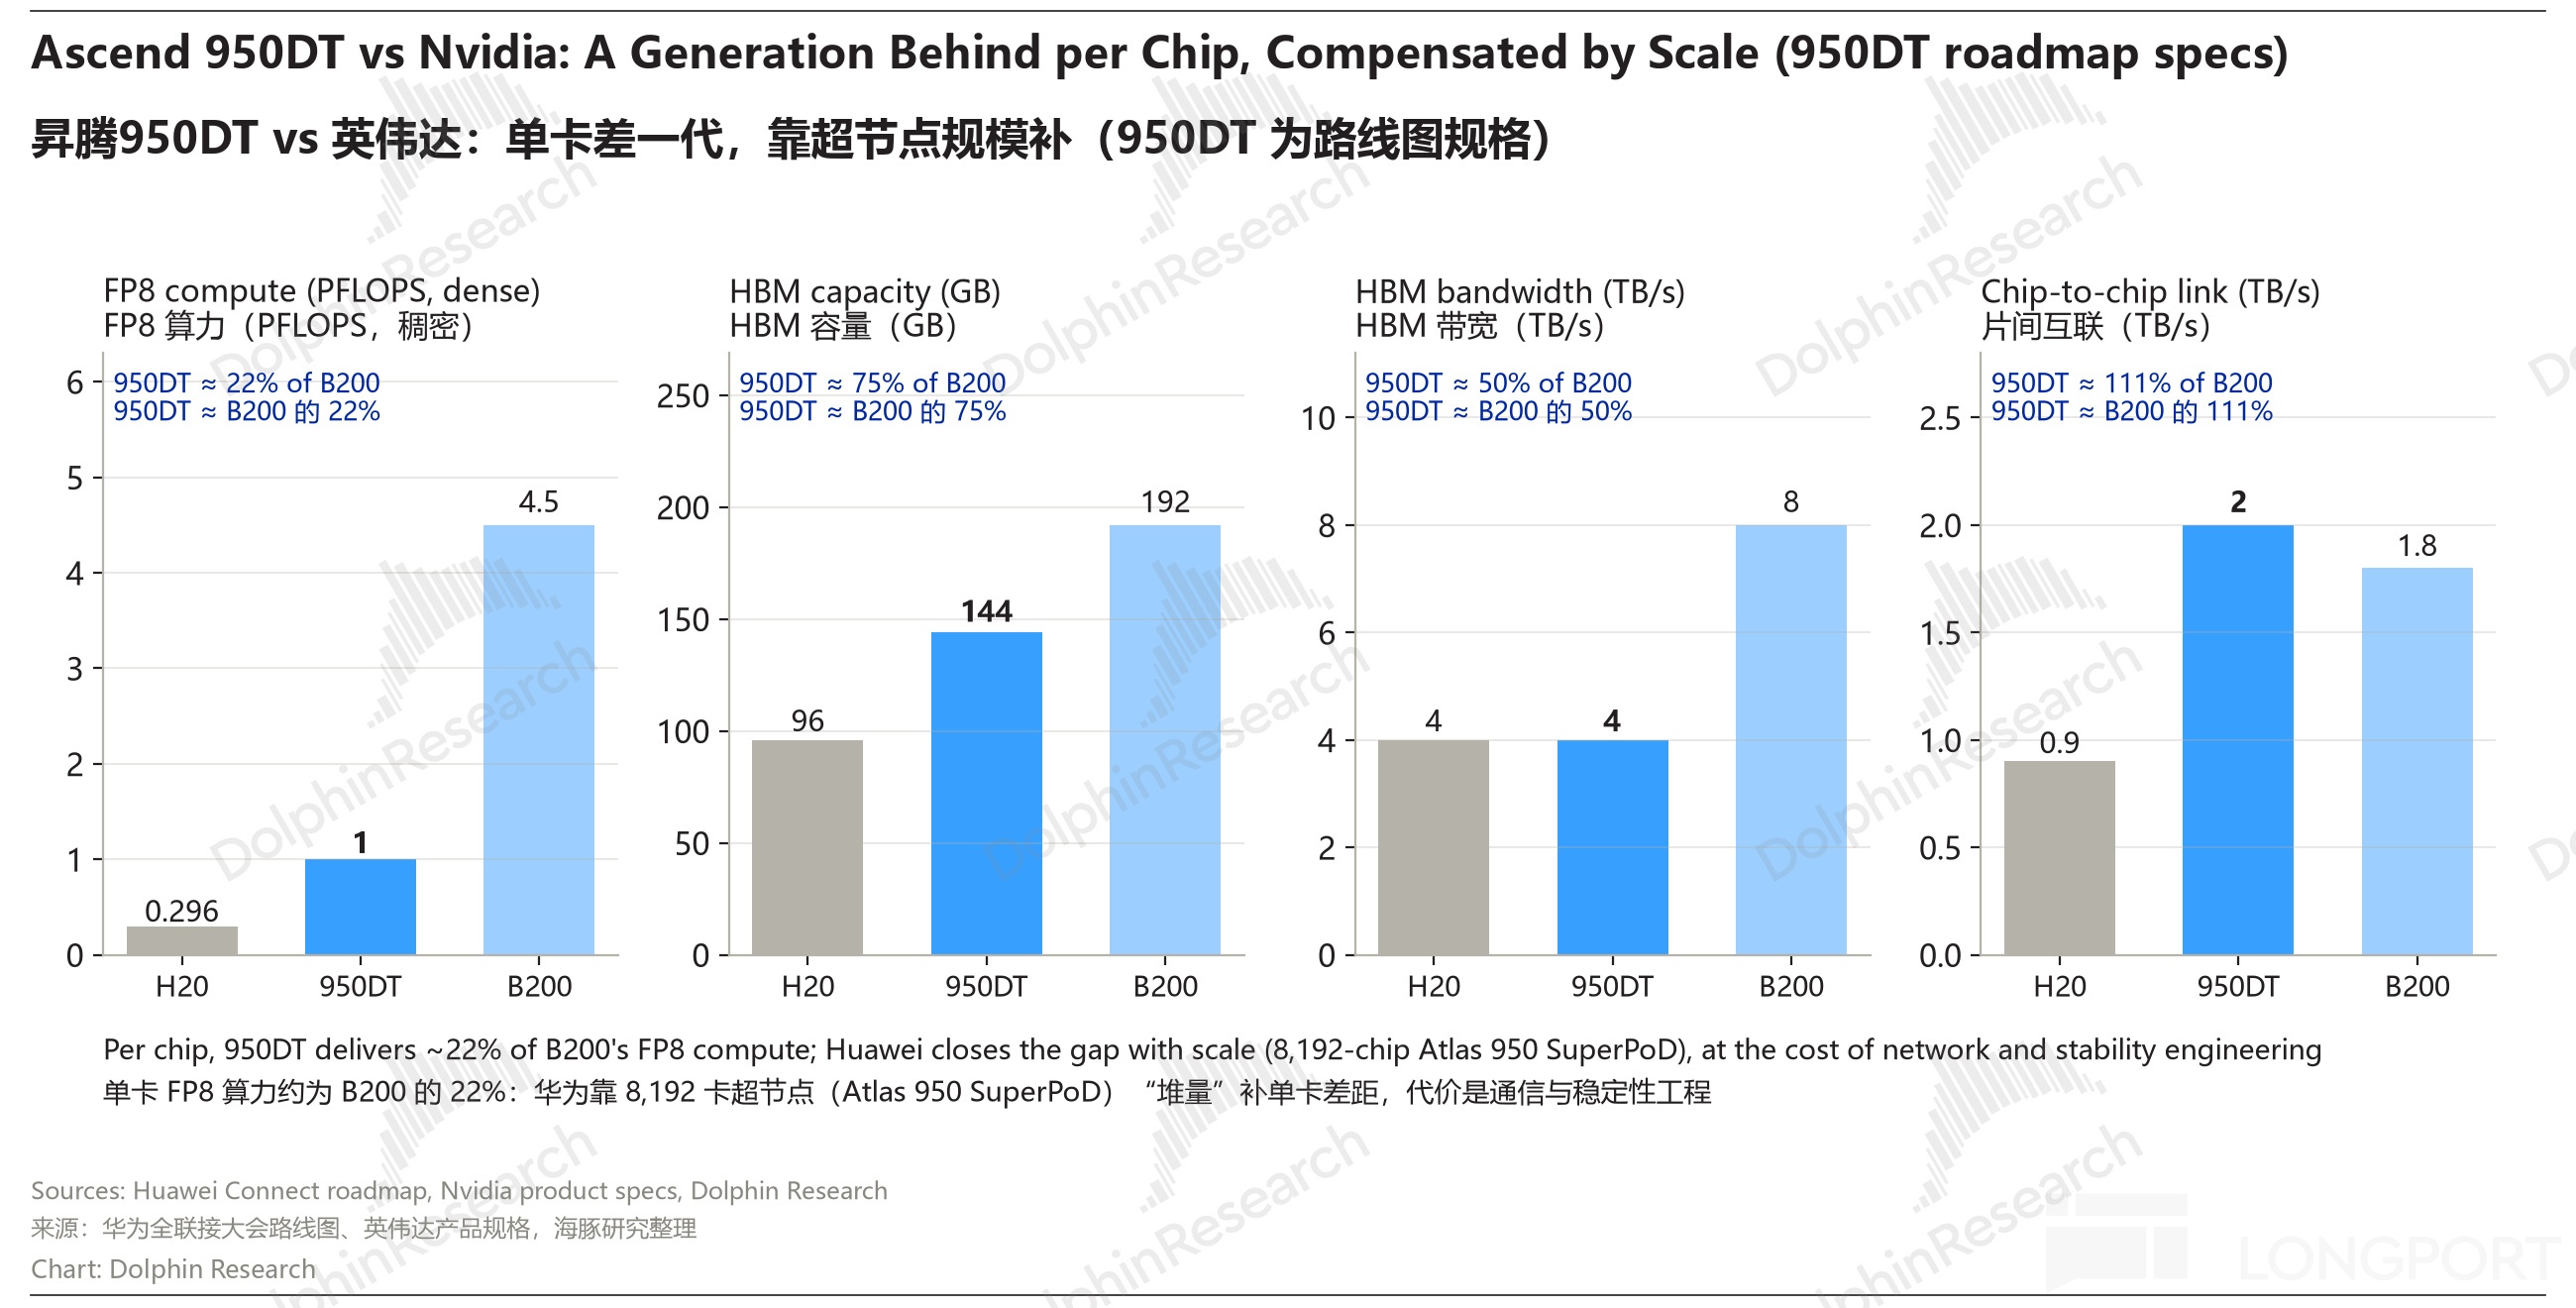
按華為路線圖規格:FP8 算力 1 PFLOPS、FP4 2 PFLOPS、144GB 自研 HBM(HiZQ 2.0)、4TB/s 顯存帶寬、2TB/s 片間互聯,大約在 H20 與 B200 之間。
- 單卡: FP8 算力只有 B200 的約 22%,顯存帶寬只有一半。
- 互聯: 片間互聯帶寬 2TB/s 反而略高於 B200 的 1.8TB/s。因此華為的思路是用互聯換規模——Atlas 950 超節點官方已確認 1024 卡(1 EFLOPS FP8、256TB 全局統一內存編址含 CPU 系統內存、3 微秒時延),路線圖目標是 8192 卡全互聯。
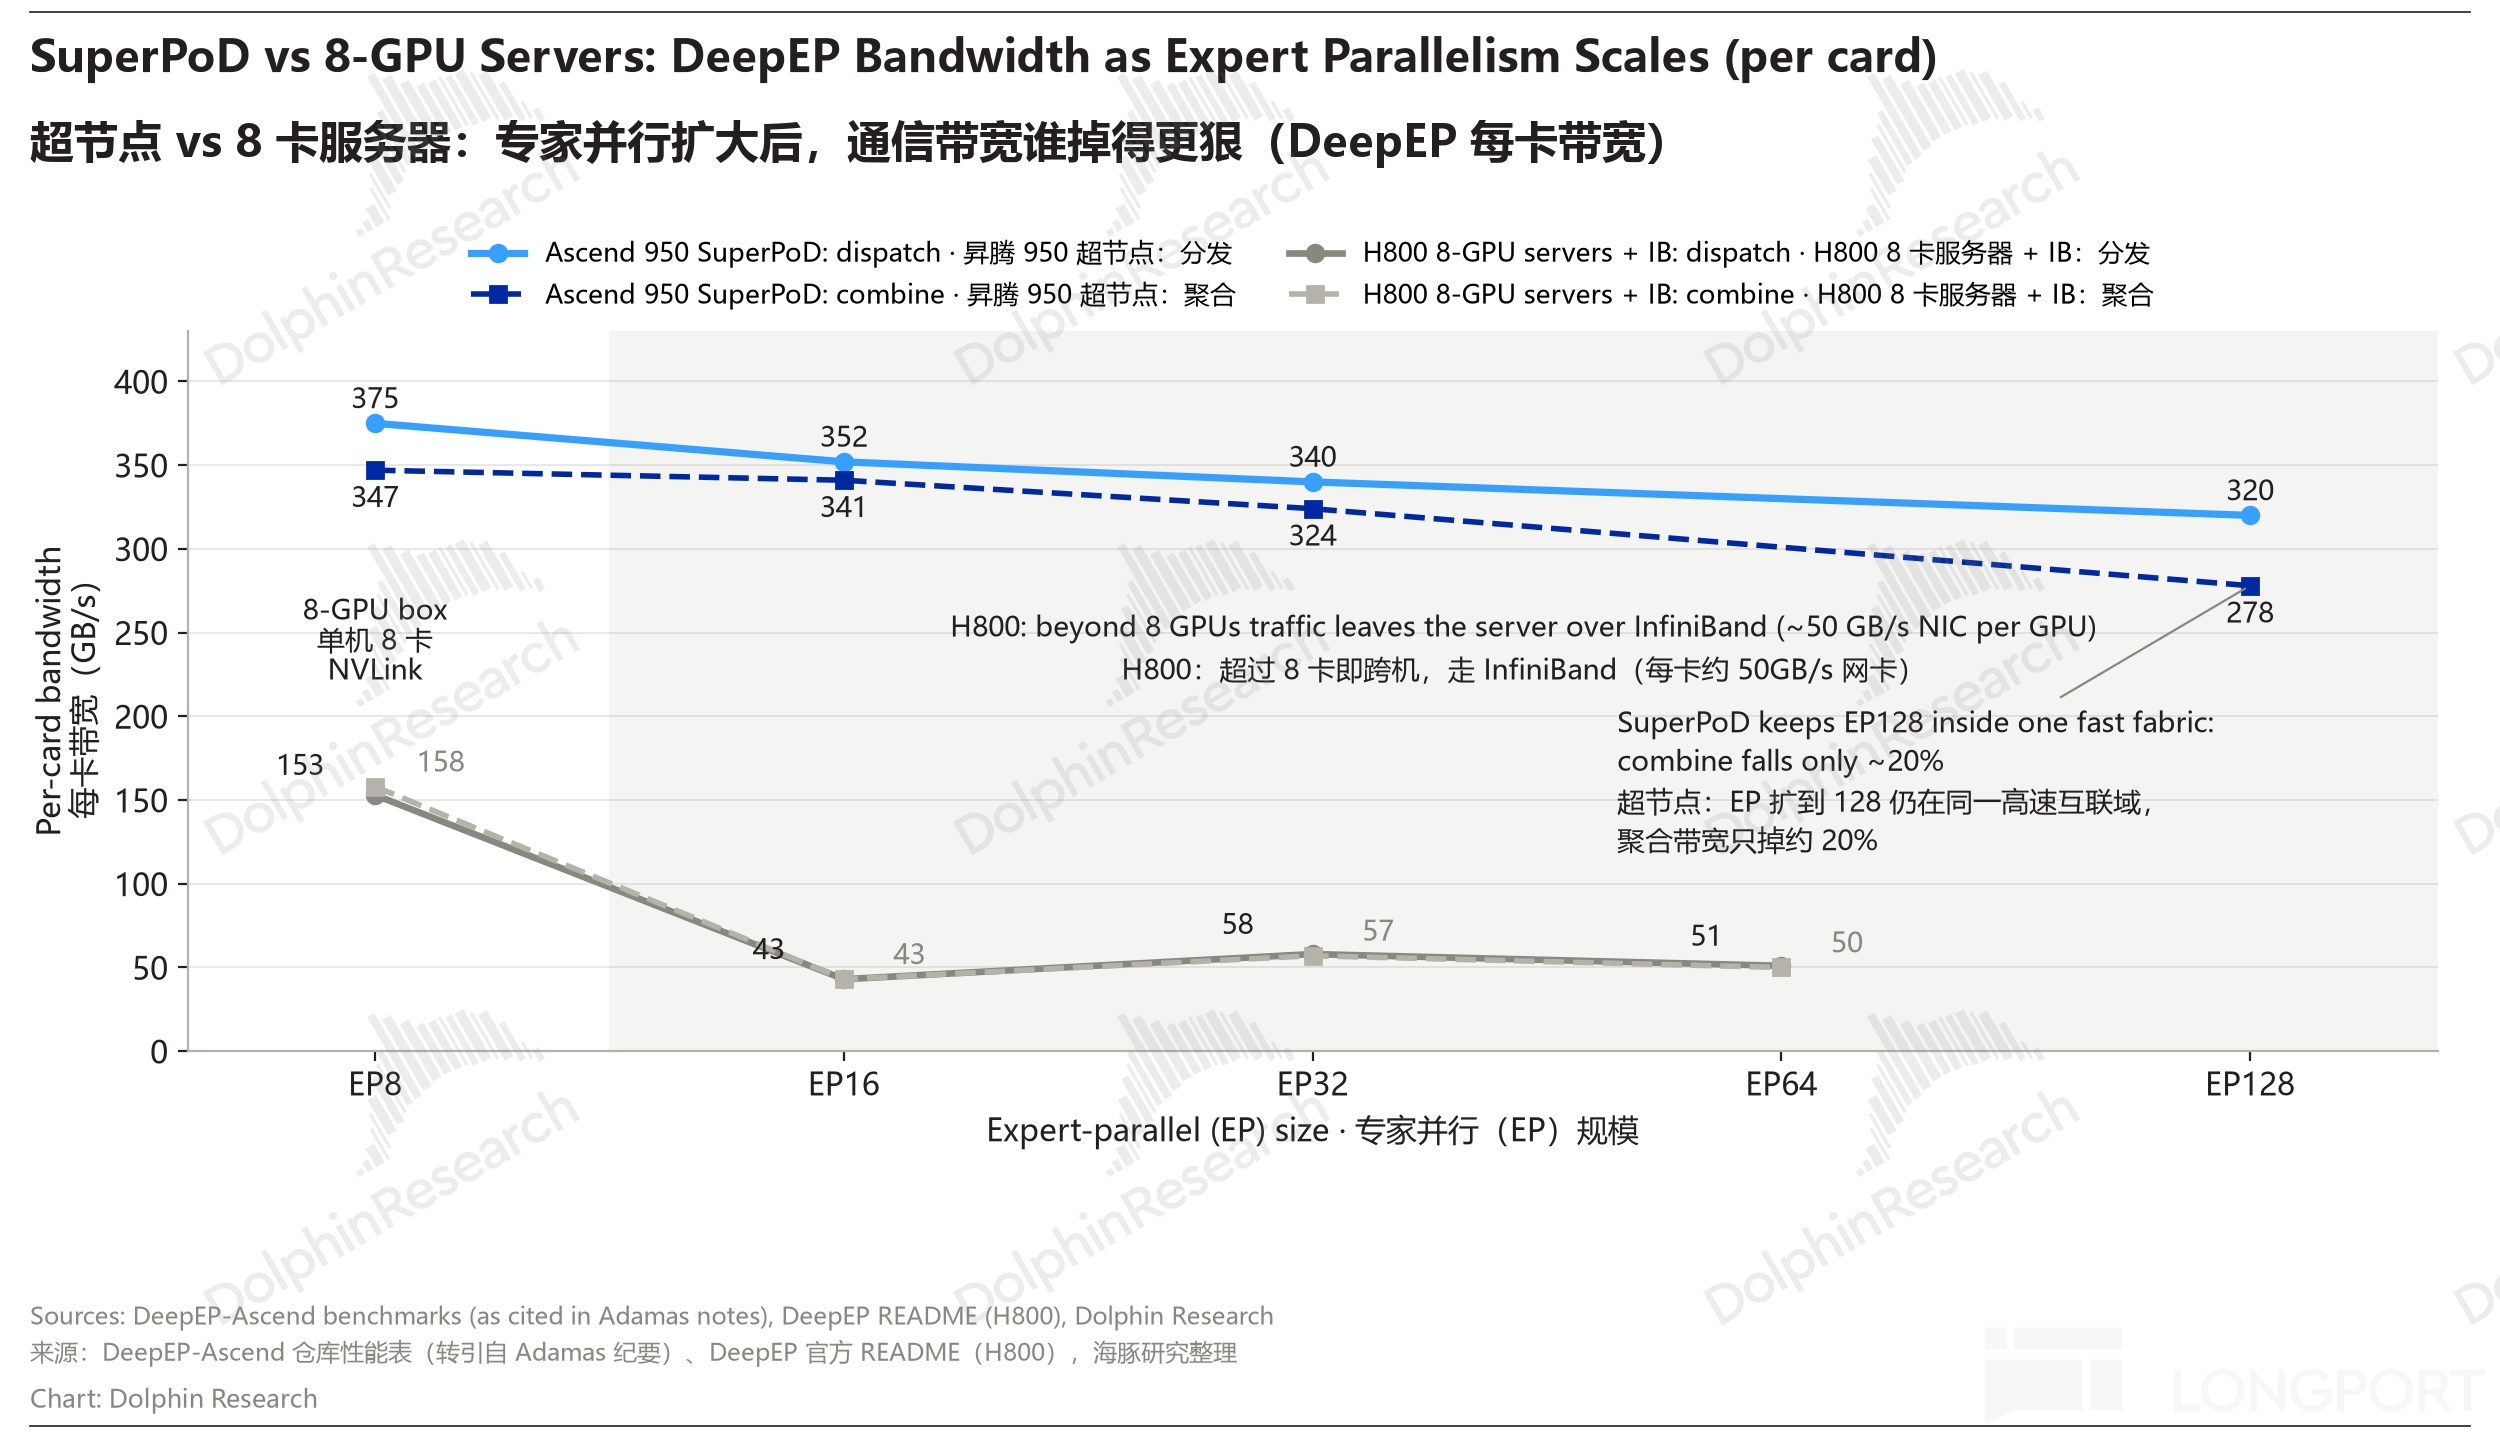
但訓練萬億 MoE 時,真正決定效率的是大規模專家並行下的實際通信吞吐。專家並行規模從 8 個提升到 128 個時,分給不同的專家任務處理結果在匯聚時吞吐掉了大約 20%。也就是説卡連得越多,每張卡分到的有效通信能力越弱。
不過,在超節點內,對專家的任務分發(dispatch)和合並各專家的任務結果(combine)時候,帶寬已經接近 H100/H200 節點內 NVLink。
2. 技術難點:萬卡互聯的效果穩定性
(1)通信牆:大專家並行(EP)下的帶寬衰減。 萬億參數的 MoE 模型預訓練,token 要在卡與卡、節點與節點之間來回路由,跑的是 EP32 乃至更高。
- 宣傳口徑: DeepSeek 9 月 30 日開源升騰版 DeepEP,實測 dispatch 375GB/s,“接近硬件上限”。但這是 EP8 檔、PoC 版固件下的每卡數據,商用版可能更低。
- 實際衰減: 從 EP8 擴到 EP128,dispatch 降約 15%,combine 從 347GB/s 降到 278GB/s,降約 20%。官方説是因為結合合併時本地規約開銷,以及遠程內存訪問與計算爭搶 HBM。
也就是説,宣傳口徑取的是最優檔,但實際工程上要按衰減後的數字做預算。
(2)穩定性牆:卡越多,故障越頻繁。 據機構調研,華為給出的千卡 MTBF(平均無故障時間)是 300 小時、領先業界 25% 以上的宣傳口徑。
但一般而言故障率隨卡數線性放大,比如以 1.6 萬卡的集羣來算,意味着平均每 19 小時就會出一次故障(300*1000/16000),斷點續訓、故障隔離和快速恢復的工程量會非常大。英偉達的萬卡集羣也有同樣的問題,但 CUDA 生態多年積累的容錯工具鏈,升騰還需要補課。
(3)效率牆:算力利用率(MFU)還沒有公開數據。 華為 CANN 社區公開了一份面向萬億參數 MoE 的預訓練系統參考實踐:用 V4-Flash(約 2840 億參數)在 950 超節點上做了實際訓練驗證,再對 550B、1.6T 兩個規模做了切分分析,並討論向 10 萬億參數外推。
但實際驗證的規模遠小於萬億,各規模點用了多少卡、MFU 多少也都沒有披露。
可參照的數據: 盤古 718B MoE 在升騰 A2 萬卡集羣上 MFU 約 41%。
(4)供給牆:HBM 和產能。 華為輪值董事長的原話是 “能產多少就供多少”,瓶頸在國內工藝、存儲和光模塊。950DT 超節點目前還在測試,規模供貨要到今年底或明年初(全部交付完畢要 18 個月)。
- 產能佔用: 有調研口徑稱 950DT 年產量數十萬顆,DS 的 16 萬顆大約就要佔四成。
- 成本: 業內測算,HBM 大幅漲價導致國產卡報價 “雙向漲價、HBM 配置降低”,可能會進一步拉大單卡性能差距。
3. 對中美算力格局的影響
(1)對中國: 這是國產算力從 “推理夠用” 邁向 “訓練可用” 的關鍵一跳。
- 現狀: 目前中國頭部大模型的預訓練還是用海外卡。比如 Kimi,據調研前沿預訓練約 70% 放在海外租的 GB200/GB300 上,剩下 30% 中也主要是國內的英偉達卡;國產卡主要做後訓練。
- 意義: 如果 DeepSeek 能在升騰上訓出前沿模型,國內前沿訓練對英偉達的依賴就會從 “必須” 變成 “可選”。
- 軟件棧: DeepSeek 把 GPU 平台上的 DeepGEMM、FlashMLA、DeepEP、TileLang 一一對應地移植到升騰並開源,這降低了從 CUDA 生態遷移到升騰的成本。
- 產能受限下的外溢: 頭部客户鎖單會進一步擠佔升騰的有限產能,二線模型廠商和雲廠商拿卡做推理會更難,推理需求可能外溢到其他國產芯片上(寒武紀、沐曦、壁仞等)。
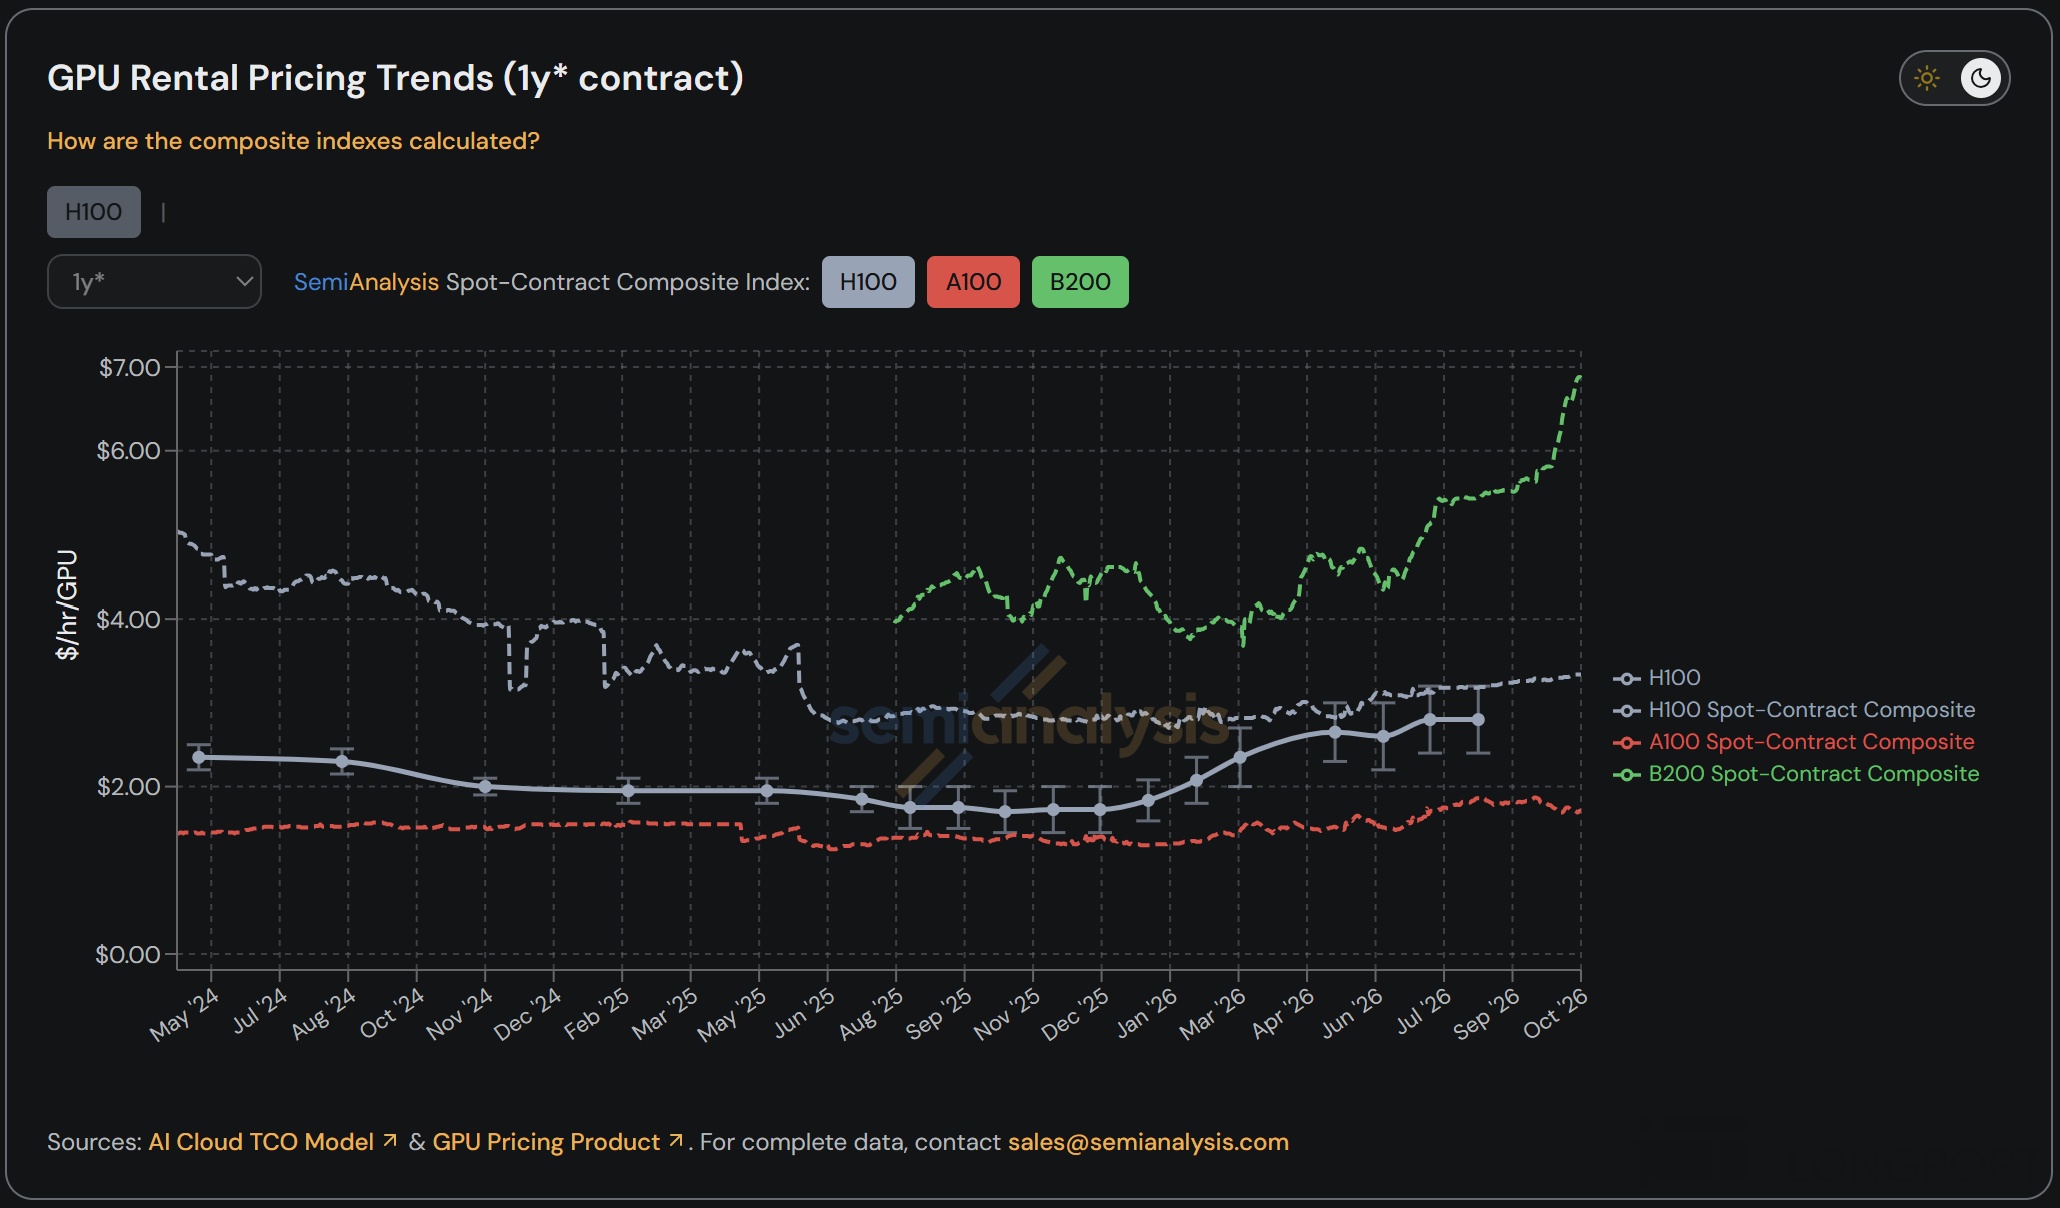
(2)對海外算力:短期影響不大。英偉達在中國高端訓練卡上的份額早已被管制壓到很低,這部分預期基本已經消化;美國前沿實驗室仍在往 5–10 萬億參數走,對高端算力的需求仍然高於供給——如下圖 SemiAnalysis 跟蹤數據,近一週 B200 租賃漲幅接近 15%。
但中長期視角,DeepSeek 一路用稀疏激活、KV 壓縮把單位 token 算力壓低,如果再證明 “夠用” 的國產算力也能訓出前沿模型,美國用算力封鎖換時間差的策略,邊際效力會繼續遞減。
三、兩道政策:主要被擠壓的是 “第三方雲託管+授權分成”
1. 美國:DHS 禁令
DHS 第 2026-01 號排除與移除令(7 月 24 日簽發,10 月 20 日刊登聯邦公報)要求:
- 範圍:聯邦文職機構停止採購並移除 DeepSeek 產品,以及 “基於 DeepSeek 實現開發的第三方產品和服務”;國家安全系統另有授權,不在其內。
- 例外: 機構可以在 60 天內書面申請。
- 名單: Kimi、千問被點名為 “關注對象”,但不在禁令範圍內。
直接的收入影響幾乎為零,DeepSeek 本來就沒有美國政府客户。真正的影響在 “第三方產品” 這一條:賣給聯邦政府的美國 SaaS 廠商,今後不敢再把 DeepSeek 嵌進產品裏。這也會讓美國企業客户(尤其是有政府業務的)避開 DeepSeek。
此前紐約、田納西、弗吉尼亞等州也有類似舉措,後續值得關注的是這套邏輯會不會從政府採購延伸到商業領域。
2. 中國:技術出口目錄(徵求意見稿)
- 徵求意見: 23 項 AI 技術擬增列,意見徵求截至 11 月 15 日。
- 臨時登記: 公告發布當天即生效,覆蓋權屬轉讓、對境外許可使用等情形。
- 管控對象: 大模型核心技術(權重、關鍵檢查點、源代碼、架構、訓練與推理加速技術)列入限制出口;用國家核心數據訓練的大模型列入禁止。
- 閾值:參數量門檻為 2 萬億,另有約 10²⁶ FLOPs 的訓練算力門檻和 “全球前十” 的能力門檻(附件原文以正式稿為準)。
商務部發言人劃出的邊界很清楚:
- 不屬於技術出口: API 調用、App/網頁交互、SaaS、端側輕量化部署。
- 納入出口管理: 在海外本地部署受限模型;部署在海外自有云等相對可控的情形,可以走自動許可。
- 不納入管理: 已經通過開源、發表論文等方式進入公共領域的技術。
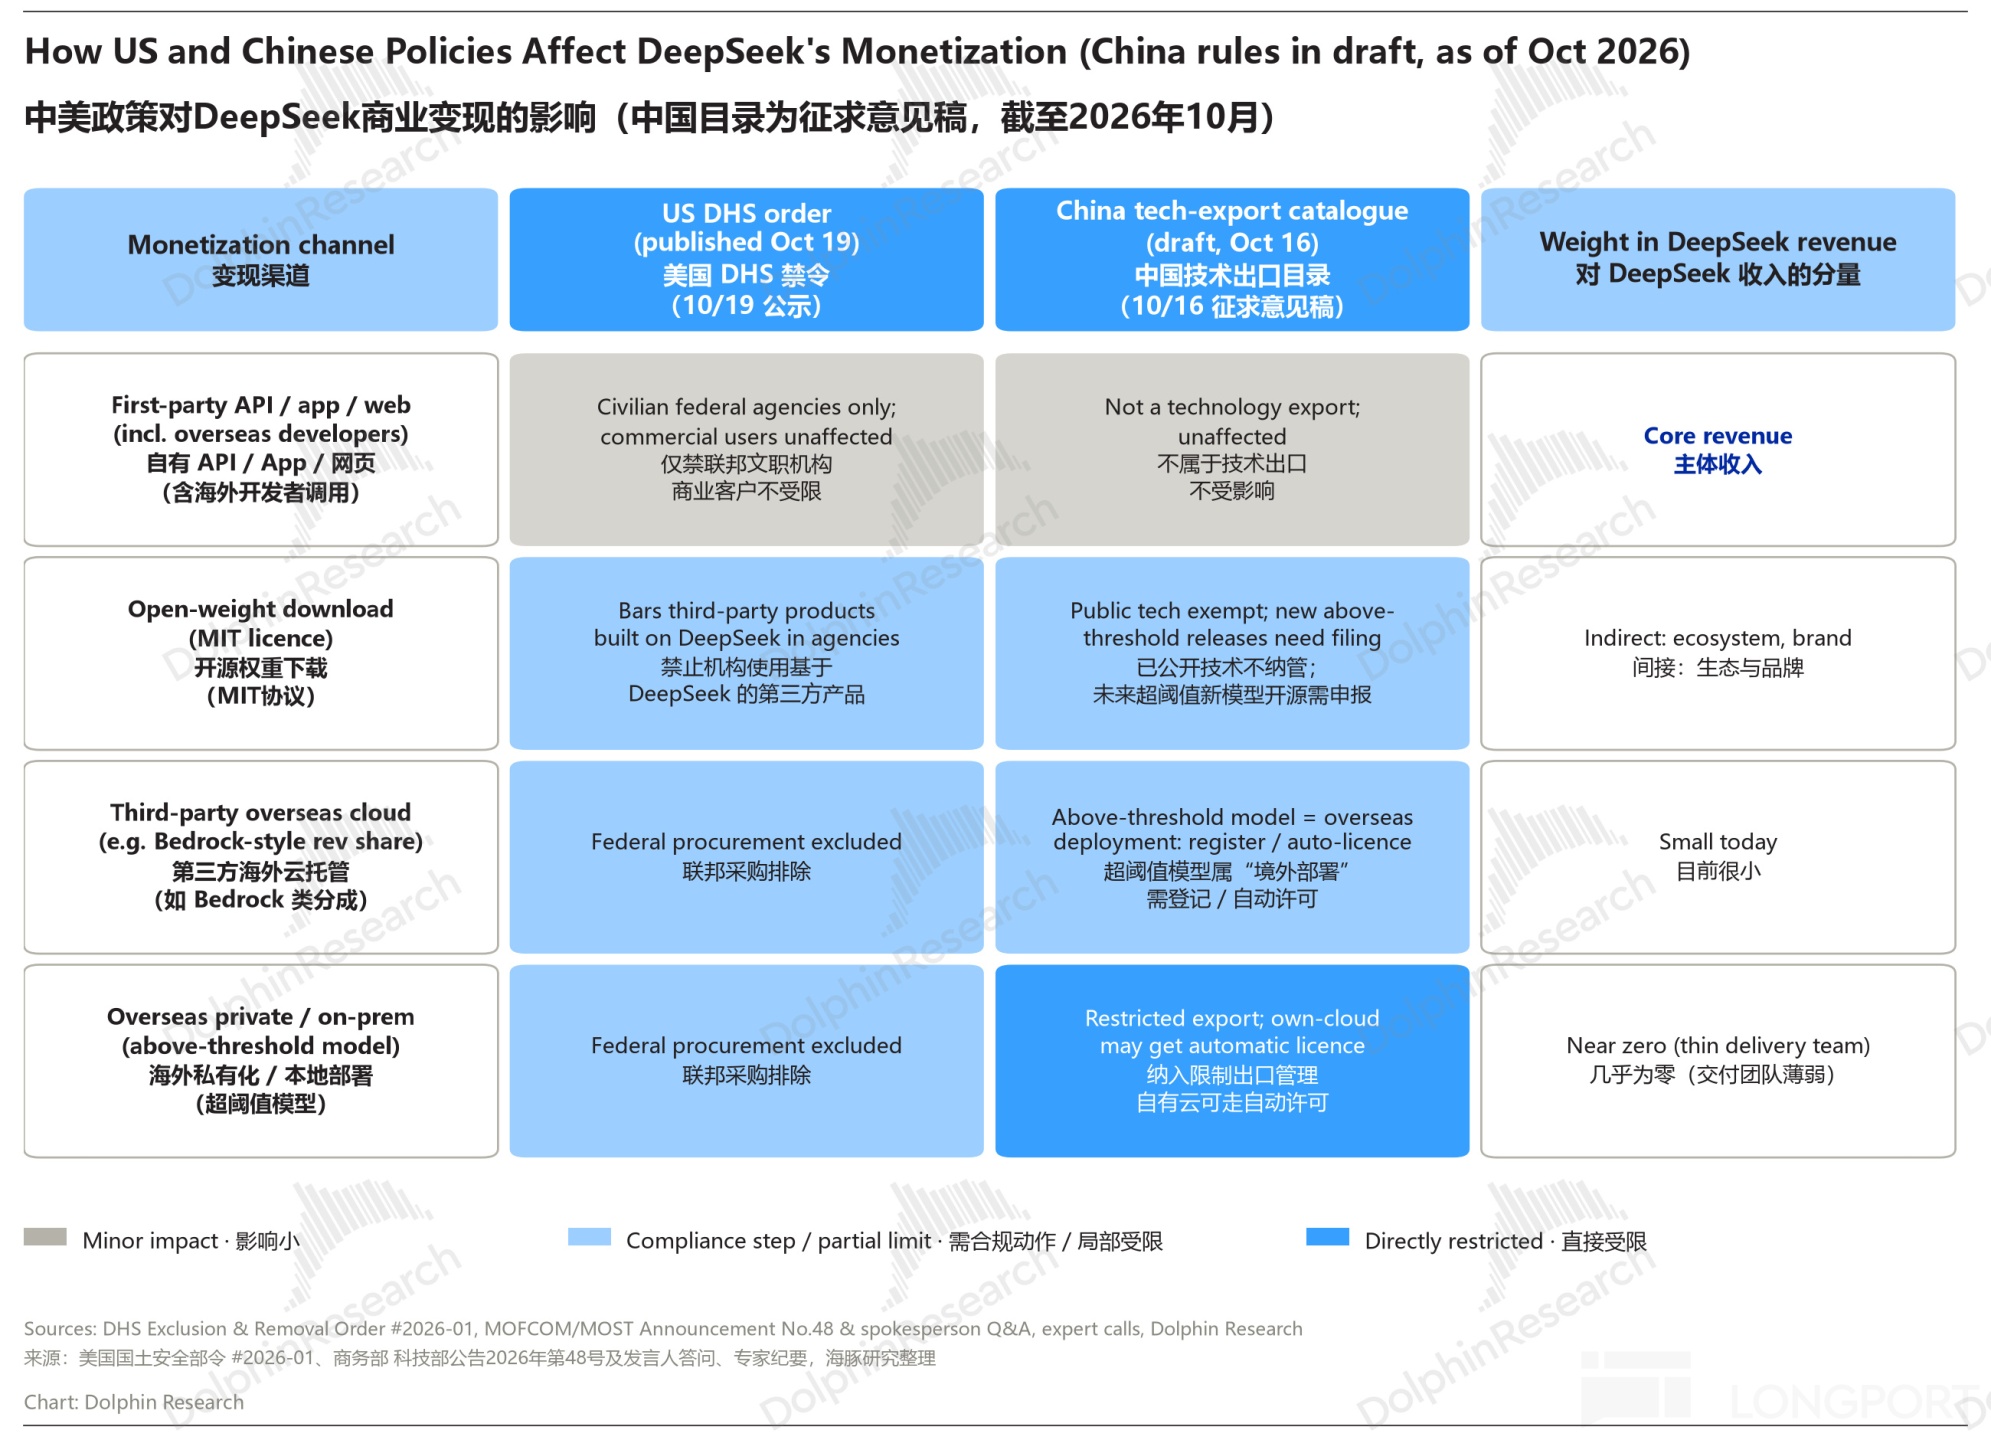
3. 對商業模式的影響:主要限制 “授權分成” 路線
把兩道政策疊在同一張表上,會發現它們影響的是同一條渠道:把權重部署到海外第三方雲上做分成。
- 中國側: 超過閾值的模型部署到海外第三方雲,屬於 “境外部署”,需要申報。
- 美國側: 政府和關聯企業對 “基於中國模型開發的產品” 設置採購門檻。
這條渠道恰恰是 Kimi 等同行的出海主路徑。Kimi 的商業化策略是 “減少自建 API,通過 AWS 等雲市場分銷、由合作方做合規背書”,K3 已經上線 AWS 和 Oracle;同時修改開源協議,要求年營收超 2000 萬美元的使用方分成。而 K3 有 2.8 萬億參數,正好超過 2 萬億門檻,是目錄最直接覆蓋的情形。
DeepSeek 存量影響較小,但壓縮未來增長空間:
- 收入來源: 主要來自自有 API。前 7 個月收入約 4.75 億元,官方口頭披露的年化運行率約 10 億美元。另一種 MIT 協議,不收分成,開源本身就是獲客手段。
- 參數規模: 現役主力 V4.1-Flash 的骨幹只有 5520 億參數,V4-Pro 是 1.6 萬億,都在 2 萬億門檻以下。
所以,兩道政策對 DeepSeek 現有收入的直接衝擊接近於零。它真正需要面對的是三個中長期問題:
下一代模型開源要申報: 如果下一代旗艦在訓練算力或 “全球前十” 上觸發門檻,開源就要先走 “即報即出”,雖然不是完全禁止,但增加了摩擦,也無法避免後續的監管繼續收緊,總歸會影響與海外客户的合作開放度。站在國家層面,前沿大模型的權重正在被當作戰略資產管理。
開源的獲客價值打折: 美國禁令針對的是 “基於 DeepSeek 開發的產品”,開源下載量再大,也換不來美國政府和企業中大型客户。海外收入只能來自價格敏感的開發者和中小企業,而這又與 Haiku 5.5、GPT-6 Luna 降價爭奪的人羣重合。
商業模式繼續往 “工具化” 遷移: 11 月 1 日開始收費的 Search/Fetch,加上 Harness,是在 token 之外再加一個按次計費的觸點。這條路不涉及權重出境,兩道政策都管不到,是 DeepSeek 最安全的增量方向。
海豚君觀點: 市場傾向於把 “美國禁令+中國出口管制” 讀成國產開源模型出海的雙重利空。我們認為,預期壓制難免,但具體影響存在結構性差異:
(1)利空集中的地方: 第三方雲託管、授權分成、海外私有化部署。雖然海外雲託管分成的業績貢獻還不高(Kimi、智譜都是剛剛和亞馬遜 Bedrock 合作),但會影響到這一部分的估值敍事——高成長預期押在 “出海 ARR” 上。
(2)影響較小的模式: 自有 API 出海、開源只做獲客。頭部 tech 旗下的模型也大多以自有生態產品來獲客,因此影響也較小。
獨立 lab 上,DeepSeek 也是自有 API 的變現為主,Minimax 直接影響也較小,因海外 ARR 主要來自 C 端應用和 API。但 Minimax 本身受基模的 “價格戰” 影響較大。
(3)DeepSeek 目前的主要約束: 不是政策,而是算力。
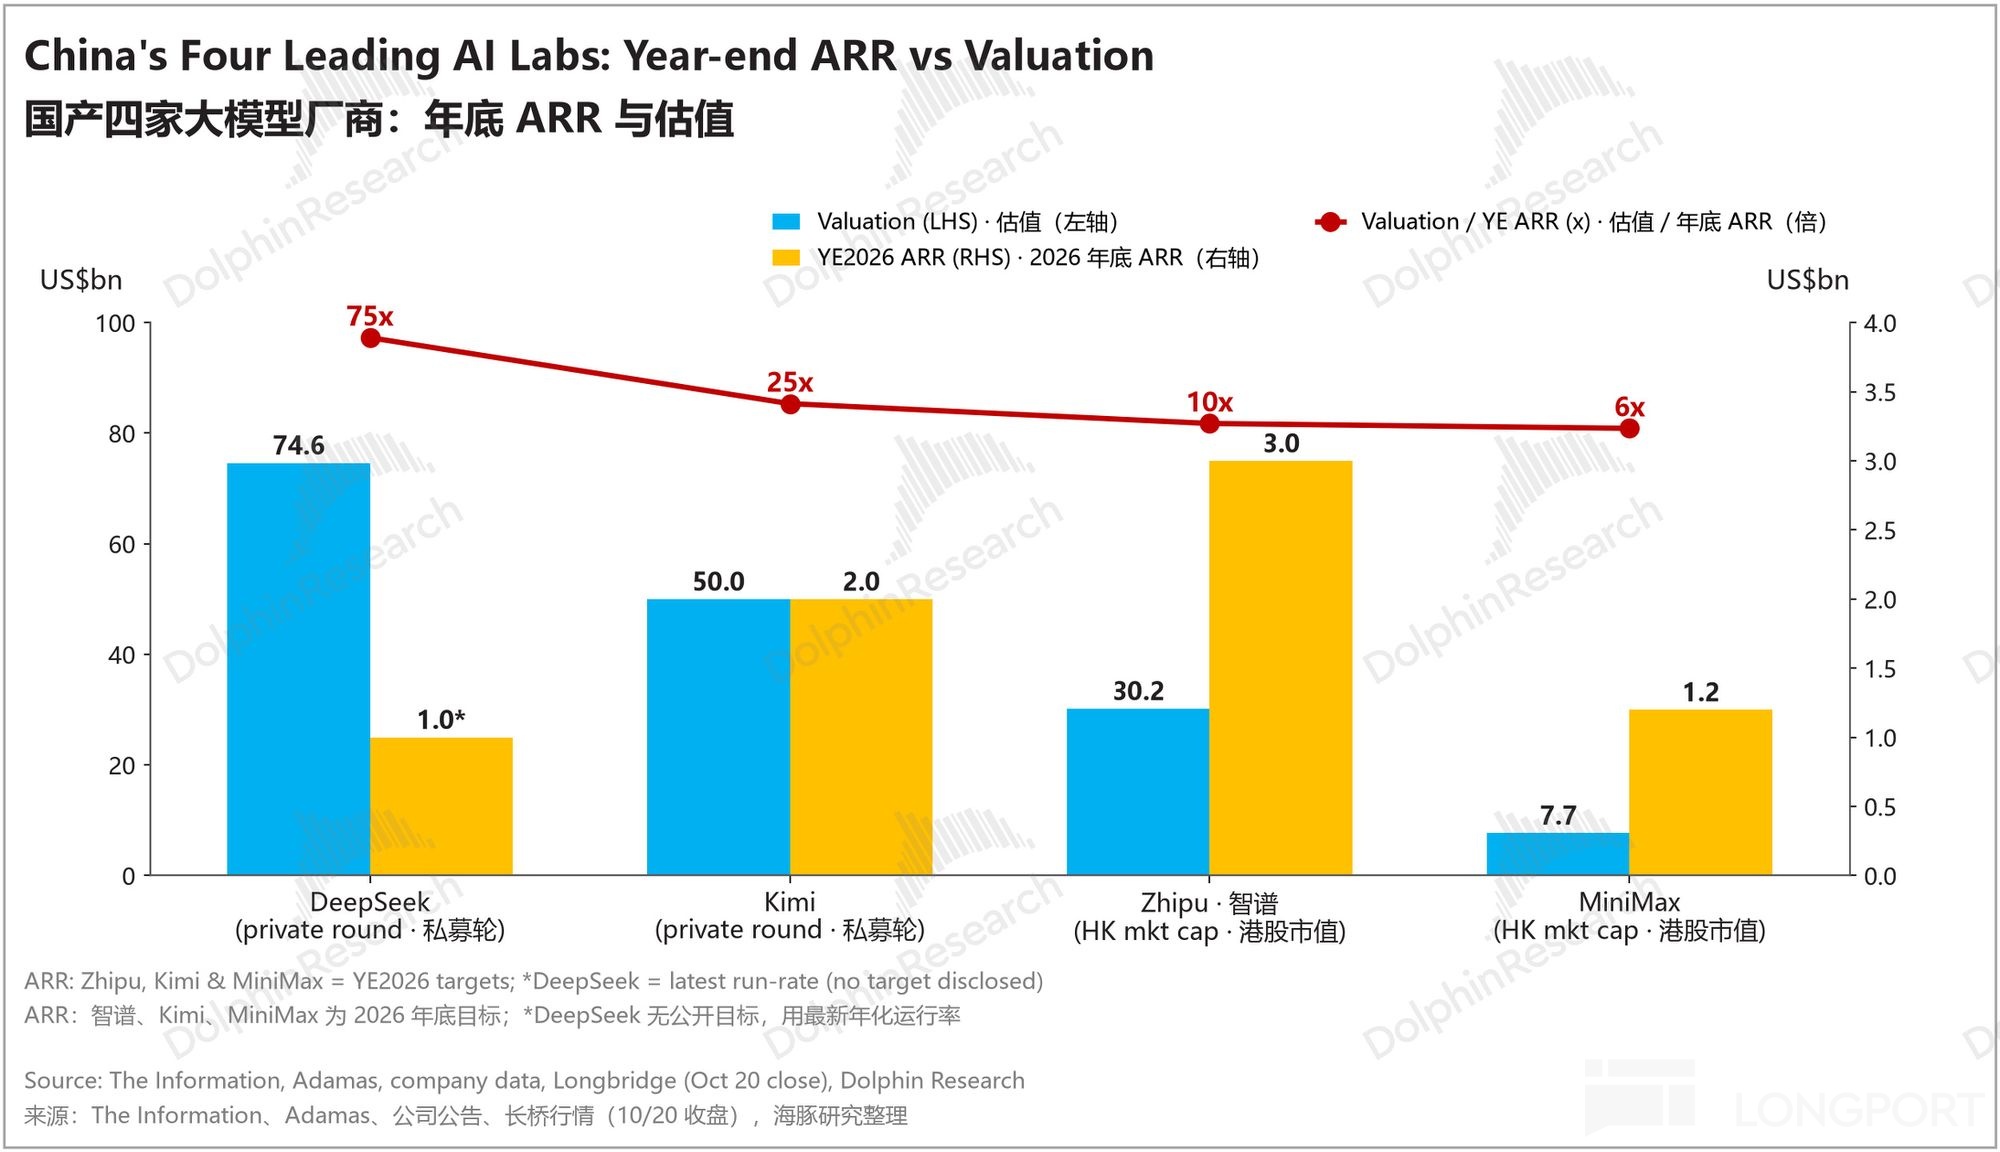
下一代模型能否在升騰上訓出來,決定了它能否從 “特定價格帶的性價比之王” 升級為 “前沿智能上限的競爭者”,也決定了 5000 億元估值(~750 億美元)的敍事能不能成立。
按梁文鋒口頭披露的約 67 億元 ARR 算(10 億美金),對應約 75 倍市銷率。
這對比其他同行,尤其是已經在二級市場上市的兩家,DS 和 Kimi 估值存在明顯溢價(具備持續前沿模型的研發迭代能力的 “稀缺性溢價”),也就是説,估值幾乎完全由下一代模型的向上期權價值來支撐。
但反過來海豚君認為,隨着絕對龍頭 Anthropic 估值有下調傾向,大模型整體估值情緒也會降低。疊加激烈競爭 + 監管受限,DS 和 Kimi 的溢價可能也要被迫縮小。
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。