

從 HBM 限高到 NAND 加量,英偉達 vs 存力到底誰拿捏誰?
 我是 LongbridgeAI,我可以總結文章信息。
在上篇的探討中,海豚君從底層技術出發,回答了AI對存力的需求為何"突然"爆發,以及HBM憑什麼成為高性能GPU的首選內存,並介紹了HBM內存技術的核心概念與邏輯。那麼隨着AI技術的發展,內存技術又將如何演變,以實現更大的容量和更快的帶寬?
恰巧,近期業內也出現了兩個看似矛盾的信號:一邊是HBM路線圖繼續加碼,堆疊層數從12層走向16層、20層;另一邊據SemiAnalysis,英偉達下一代Rubin Ultra的HBM可能從16層一路砍到8層,同時以閃存顆粒為基礎的HBF,也在試圖從HBM手中分走一部分容量需求。
HBM是否會被取代,還是會更加稀缺?HBM究竟該不該繼續堆高?本篇我們就沿着上篇結尾留下的容量、帶寬和成本三條線索,主要討論以下幾個問題:
1)要繼續擴大內存容量,行業有哪幾條路可走?各自的代價是什麼?為什麼HBM的層數反而可能不增反減?
2)為什麼帶寬比容量更難提升?瓶頸卡在哪裏,後續又有哪些突破口?
3)不同的場景下,哪條技術路線更可能被選擇?對產業鏈以及內存廠商的話語權會有何影響?
以下是正文:
一、擴大容量,有哪些途徑?
先從如何繼續加大內存容量的問題出發,目前業內有兩個並行的方向:一是突破工藝上限,把單顆內存做得更強,代價是更復雜的工藝、更高的成本和可能更低的良率;二是更側重性價比,不追求單顆性能,轉而以數量取勝,用不同規格的產品匹配不同層級的需求。
1.1、路徑一:更強的單顆性能
a. 繼續堆更多層
最直接的方法是沿着現有路徑繼續增加堆疊層數:HBM3E為12層,部分HBM4/4E將做到16層,HBM5路線圖則指向20層。
但加層並沒有説起來那麼簡單。HBM與XPU共同封裝、共用底座和頂蓋,因此內存堆的總高度是受限的:HBM3E及之前的規範上限為720um,HBM4放寬到775um。
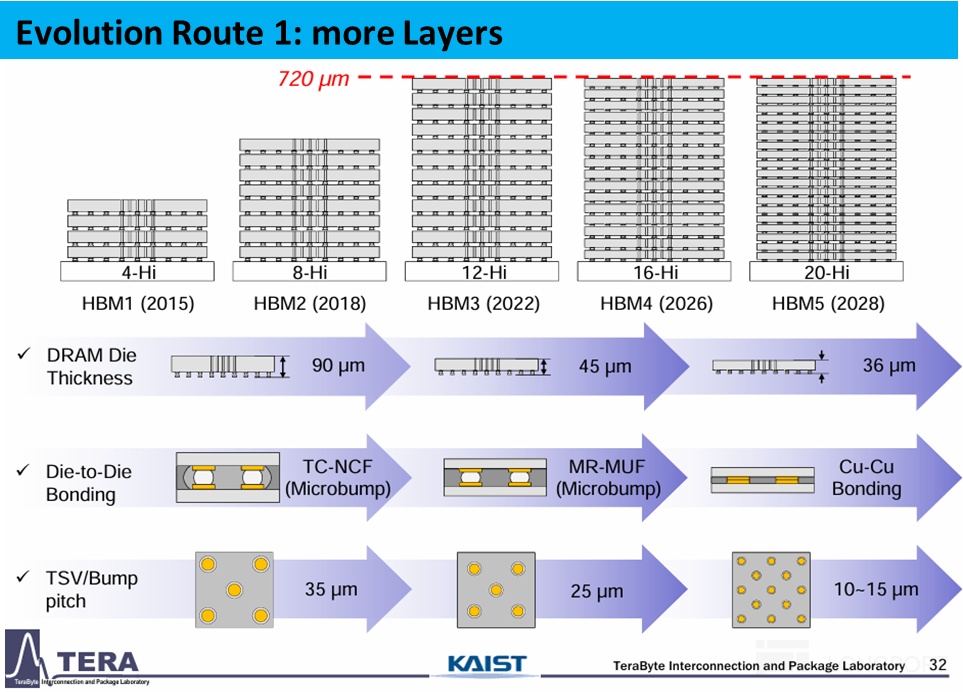
限高之下要塞進更多層,只能:① 把單層DRAM顆粒削薄;② 壓縮層間空隙,把微凸點(micro-bump)做小,甚至去掉微凸點,讓上下兩層的銅觸點直接做銅銅鍵合(Cu-Cu Bonding)。
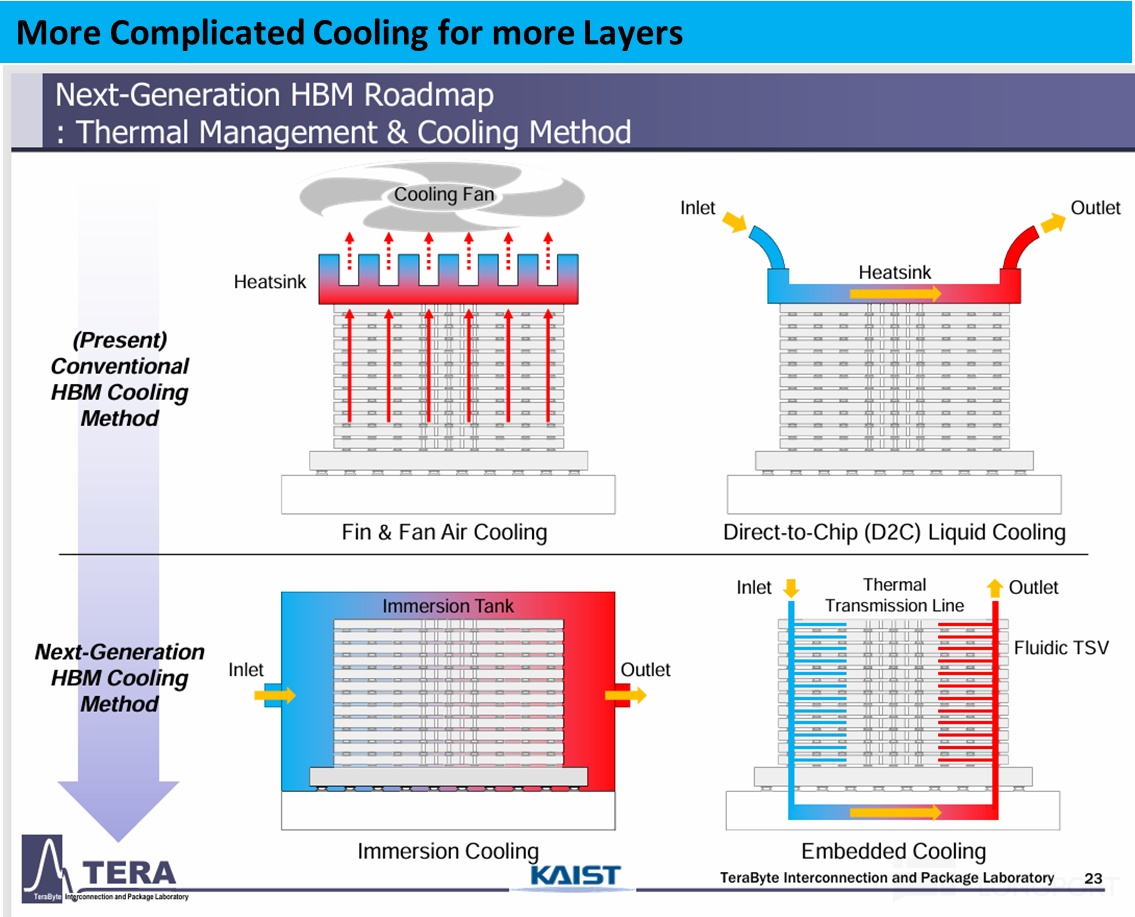
但更精密的工藝意味着更高的成本和更低的良率:① 削薄後的硅片強度下降,更易翹曲或在堆疊中損壞;② 層間空隙縮小,散熱和絕緣填充都更難,熱壓工藝(TC-NCF)已難以勝任,需轉向海力士的回流焊(MR-MUF)或混合鍵合;③ 層數越多,對供電、傳輸和散熱的要求越高,TSV需要做得更密、孔徑更窄。
簡單來説,這條路徑是用更難的工藝和更高的成本換單顆容量,對內存廠的要求更高,好處是新增的容量都能享受首排內存的高帶寬。
b. 繞過限高的偷懶方法
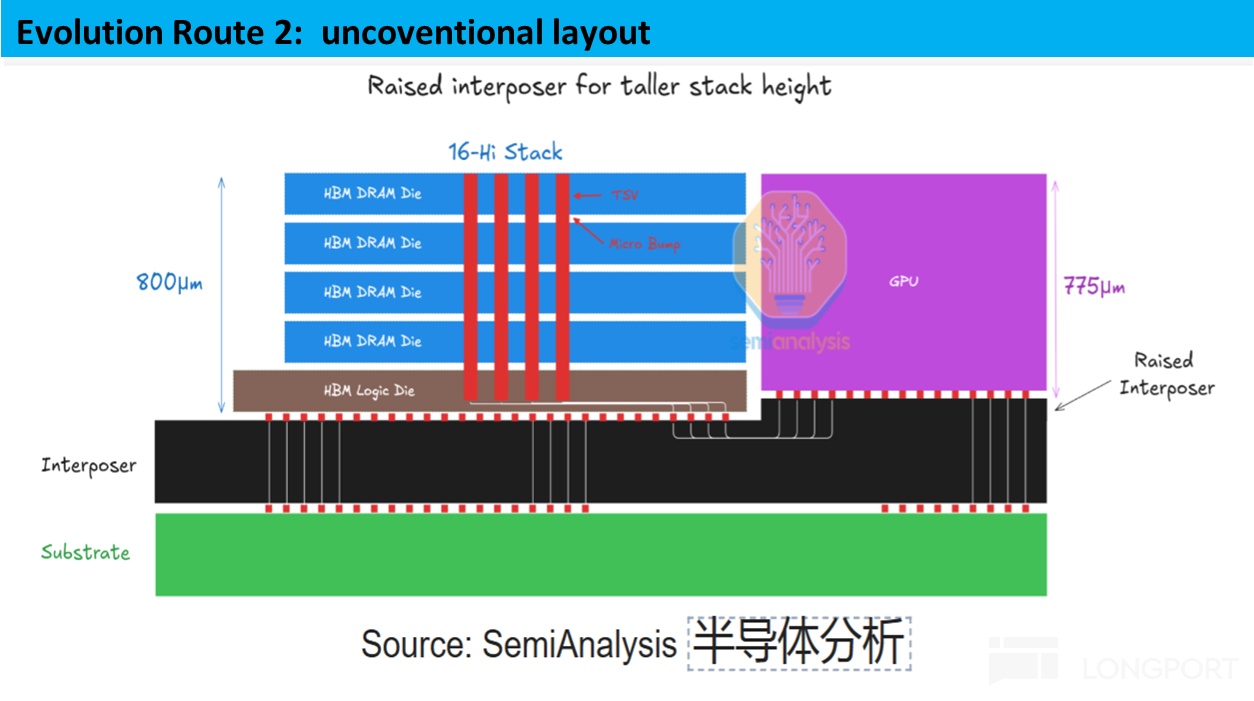
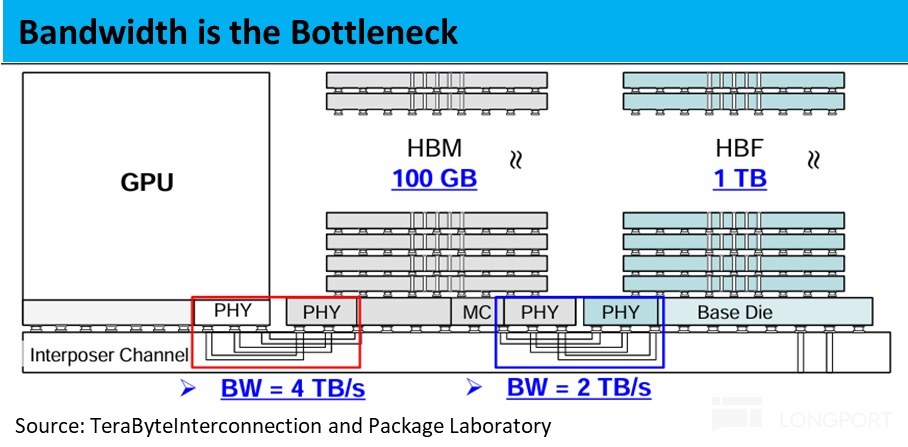
另一個“走捷徑”的辦法是變相加高堆疊高度:如下圖,把GPU下方的中介層墊高,在兩者頂部仍然齊平的前提下,讓內存堆可用的高度提升到約800um。
這樣可以少削薄甚至不削薄顆粒就多塞幾層,省下複雜工藝帶來的成本和良率損失。但能擠出的空間有限:從720um到800um,按每層寬度只比45um略有減少,最多隻能再多放2層。
1.2、路徑二:多放存儲,以量取勝
a. 多排內存:前排保速度,後排給容量
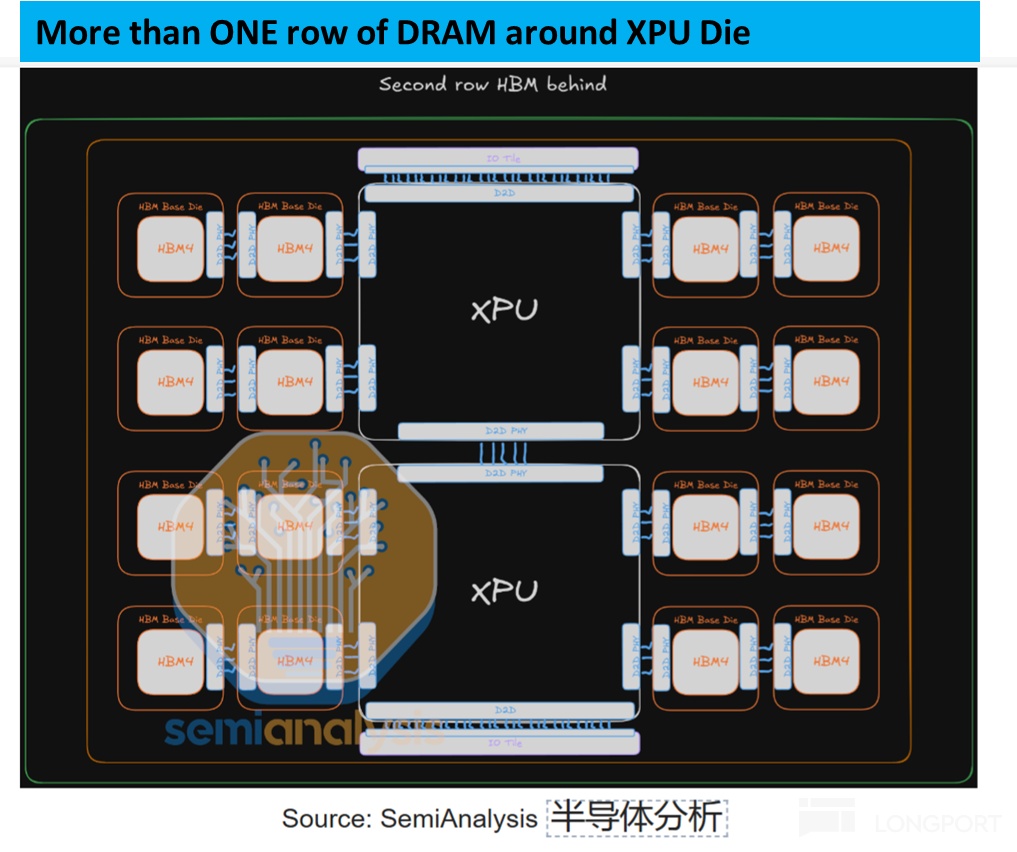
另一條路是增加內存的數量。由於緊貼XPU的位置有限,新增的內存大概率只能放在後排:這省去了加密堆疊的工藝難題,代價是後排內存的帶寬勢必更低。
這裏後排用什麼內存、怎麼封裝都有選擇:① 規格上,除了下圖中的HBM,也可以用普通DDR,乃至基於NAND的HBF(後文展開),單位容量成本更低;
② 封裝上,後排既可以和XPU一起放在硅中介層上(速度快,但貴且中介層面積有限),也可以放到次一級的基板甚至PCB上(速度慢,但便宜、空間充裕)。
③ 但後排不能無限加,帶寬是最大的瓶頸:因後排內存的數據需前排內存中轉,整個多排內存的最大帶寬,受限於首排HBM和XPU間的帶寬。如下圖的示例,若首排HBM與XPU之間的帶寬為4TB/s,在扣除自身需要和XPU通訊佔用的2TB/s帶寬後,能用於替後排內存中轉傳輸的帶寬就只能有2TB/s,若再加第三排內存就依次減少。
b. HBF:更便宜的選擇?
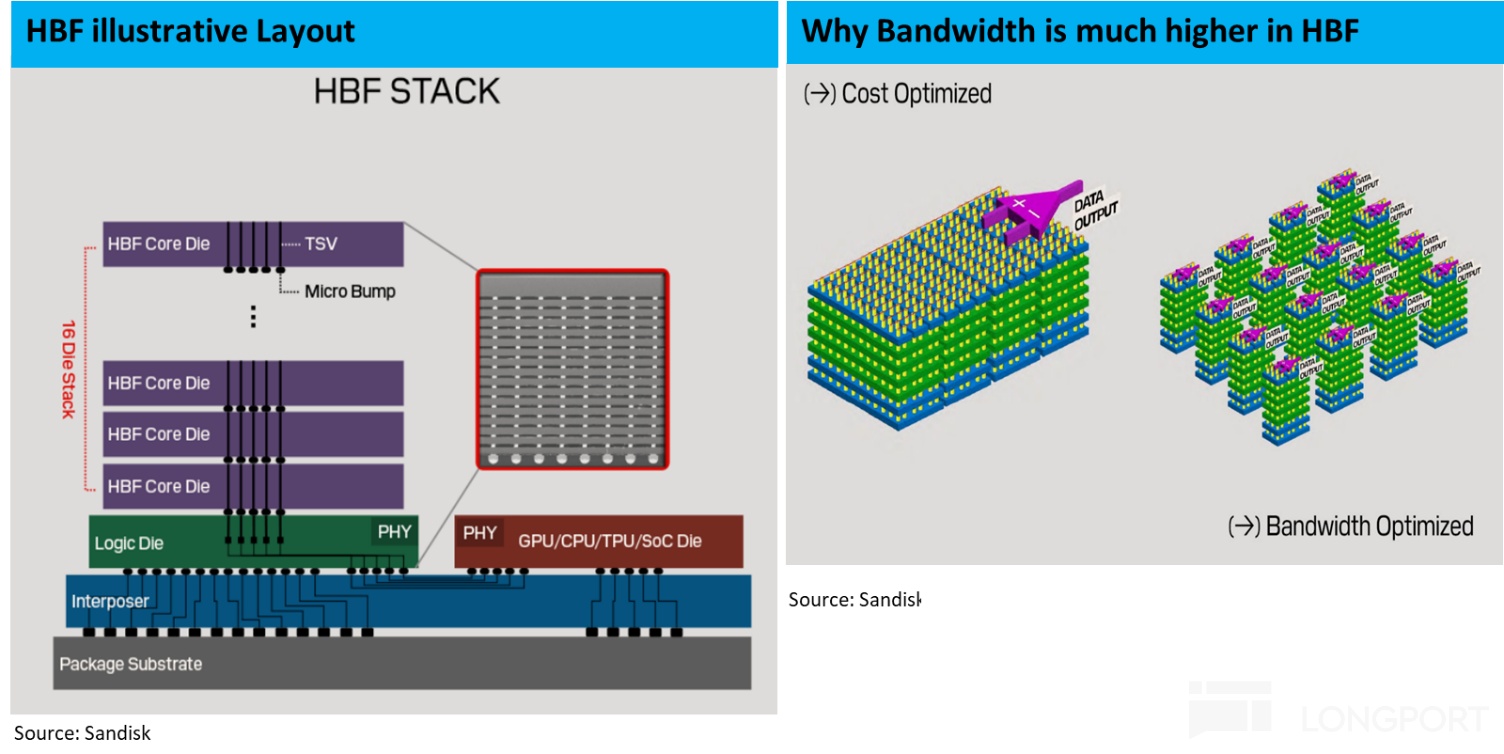
前文已提到,為了降低單位存儲的價格,行業有考慮用其他規格存儲來代替HBM,其中一個重要選項是HBF—即高帶寬閃存(High Bandwidth Flash)。正如其名,它的結構基本是HBM的復刻:多層堆疊、TSV貫通連接上下、與XPU共同封裝,只是把DRAM顆粒換成了NAND顆粒。
值得一提的是,NAND本身就是3D結構,為什麼HBF還要像HBM一樣多片堆疊?
原因在於,NAND的“3D”是存儲單元層的堆疊,只加容量、不加讀出通道:同一串單元共用一套讀出電路,每次只能讀其中一層。
HBF的額外帶寬來自並行:單片die內部劃分成大量小陣列同時讀出(下圖右),再用TSV把16片die堆疊起來同時輸出。普通NAND 3D架構雖然也疊容量,卻掛在同一條總線上輪流傳輸(具體情況請見海豚君對NAND的研究)。
與HBM相比,HBF的優劣勢都很鮮明:
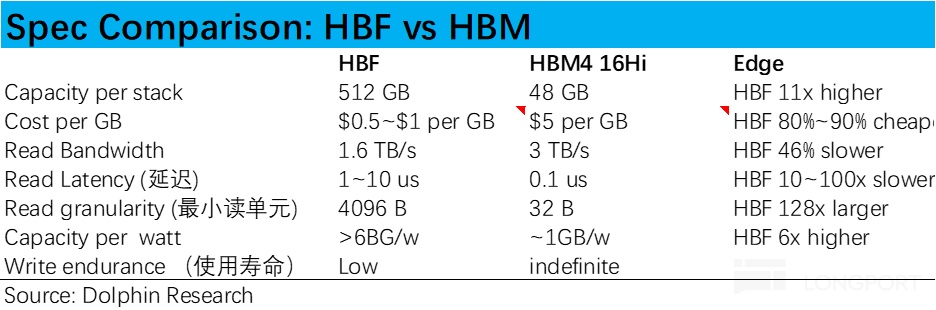
① 優勢--容量大、便宜、省電:計劃於2026年末至27年初推出的HBF Gen1(16層堆疊),單堆容量可達512GB,而16層HBM4只有48GB;HBF單GB價格據調研可能只有HBM的1/5~1/10左右。且NAND顆粒天生功耗和散熱需求相對更低。
② 帶寬做到同一量級:憑藉類似的堆疊和共同封裝工藝,據公司披露HBF Gen1讀取帶寬可達1.6TB/s(寫入慢很多),約為HBM4規範最高帶寬的55%。
③ 但NAND天生延遲高、寫入慢、按塊讀取、擦寫壽命有限,註定無法取代HBM:其讀取延遲約1~10us,DRAM僅約0.1us,寫入還要再慢10~100倍;按塊讀取則意味着每次都會夾帶不需要的數據,實際有效帶寬要打折扣。
因此HBF只適合不需要頻繁讀寫的數據,如全量模型參數(非激活)、壓縮後的上下文緩存、暫未調用的MoE專家參數等。
c. 混合架構,最可能的結局?
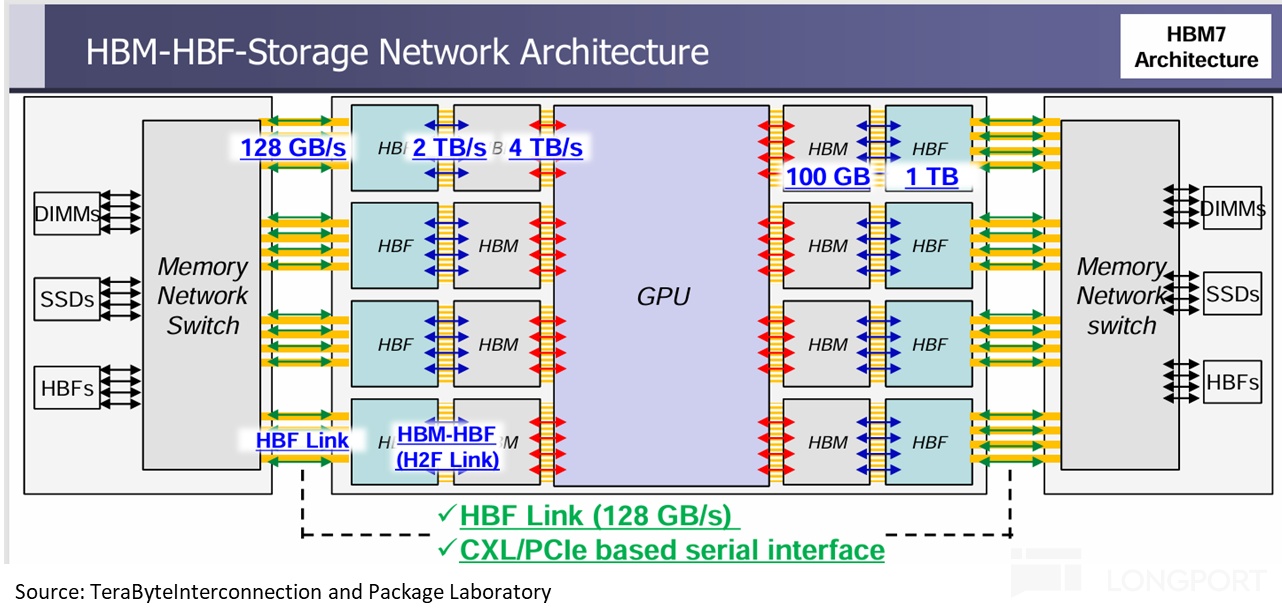
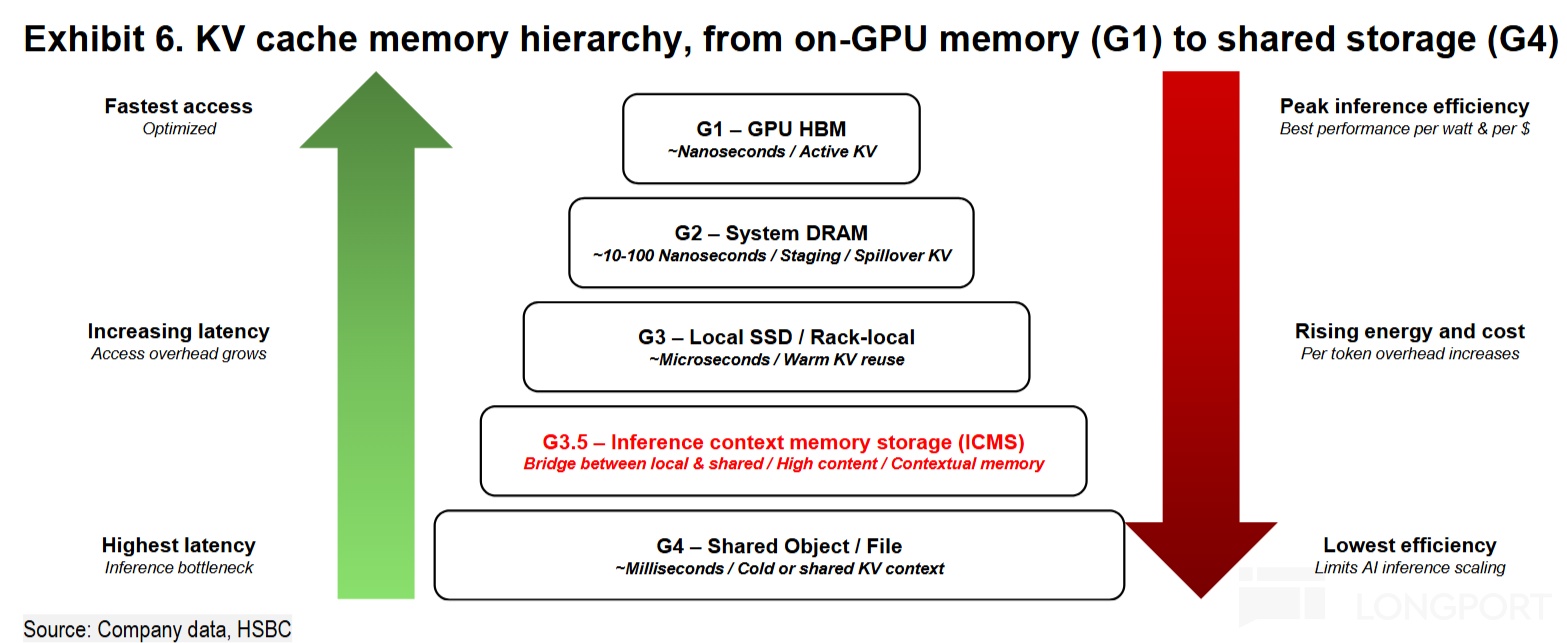
以上討論的各種方法,在傳輸速度、容量、成本這三者上都無法兼備,因而目前業內展望的一個最可能的遠期解是,採取多級、混合的存儲架構。例如在XPU芯片的一側共同封裝HBM提供高傳輸速度,負責需高頻讀寫的數據,另一側封裝HBF提供更大的容量,負責相對更低頻的數據。
更遠期的HBM7設想中,還會再加一層走PCIe協議的池化存儲,讓每顆XPU都能共享調用整個系統的DRAM、SSD和HBF。各級存儲各司其職:HBM放最常用的參數和KV緩存,DDR和HBF次之,SSD等池化存儲存放不太被調用的“冷”數據。
1.3、HBM層數會不增反減?
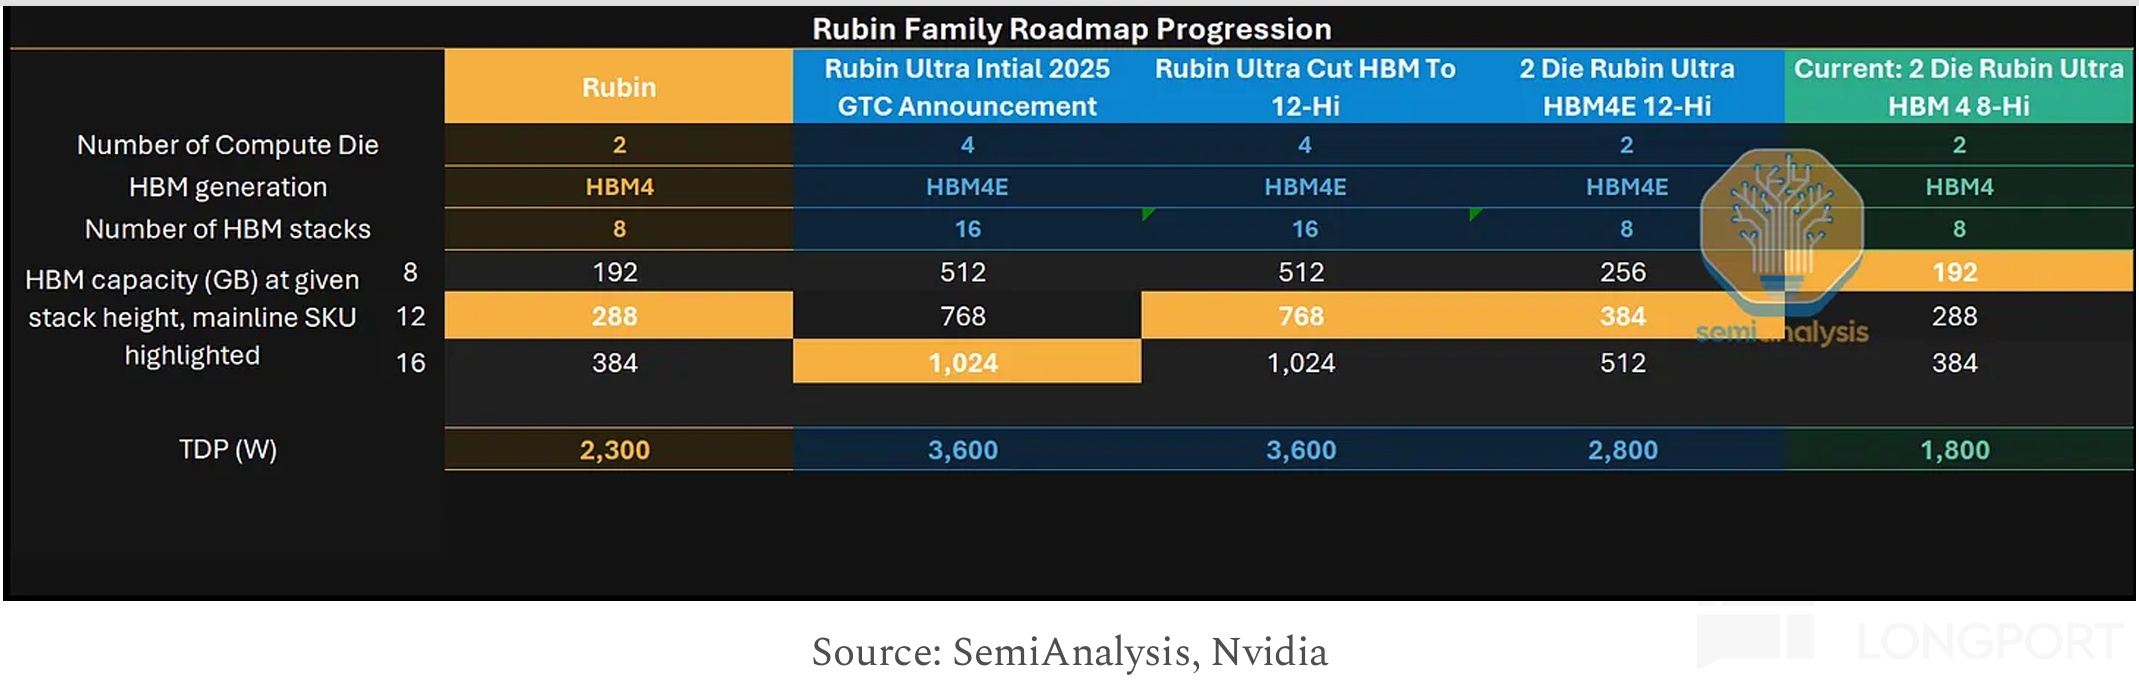
近期另一個熱議的市場觀點:HBM的層數可能不增反減。起因是英偉達下一代Rubin Ultra:每個計算核心配4顆HBM,最初規格為16層,後據供應鏈反饋降為12層,最近又傳出可能改為8層。
每顆GPU的HBM總容量也隨之從768GB砍半再砍半至192GB。需要注意,以上變動均未經英偉達官方確認,只代表其在考慮不同選項。
XPU廠商可能“降級”用更少層數的HBM,除了堆高本身工藝難、成本高,還有三個原因:
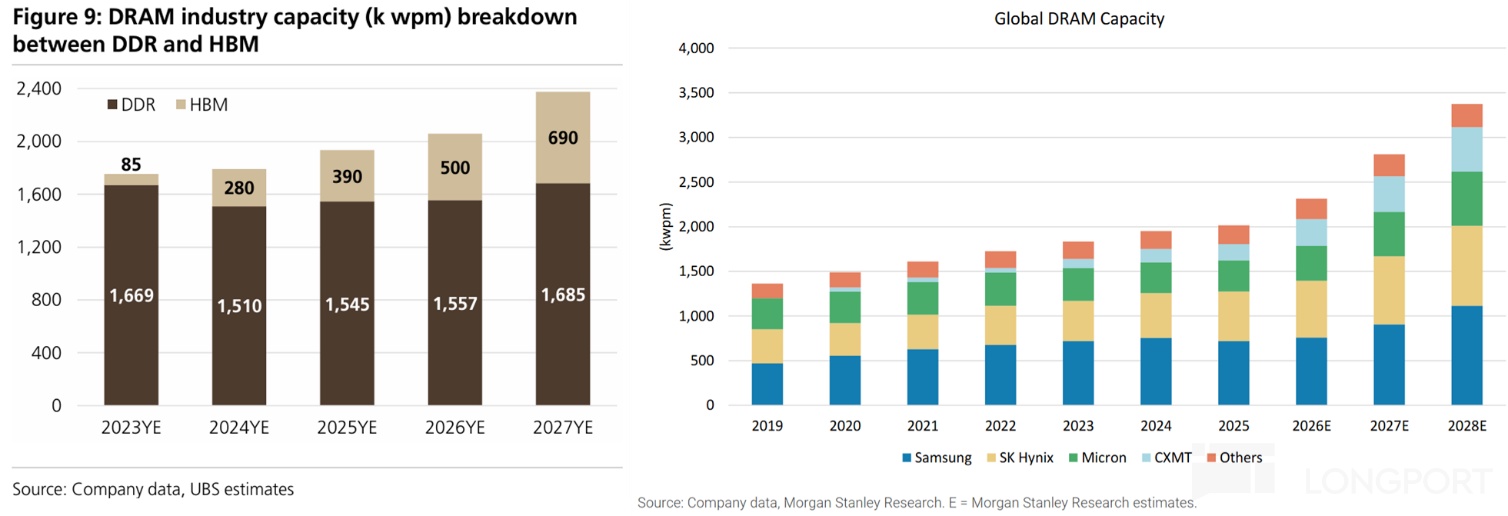
① DRAM晶圓產能有限:目前要產出同等GB容量,HBM消耗的DRAM晶圓本已是常規DRAM的3~4倍。
而若堆疊層數繼續加高,對DRAM晶圓損耗會更大。這樣同樣產線數量(產能)下,能產出的存儲總容量反而會變少。而DRAM新增產能需要時間,據下圖投行預測,24~26年晶圓產能增長有限,27年才會有較多釋放。
因此DRAM圓晶產能有限,應當是HBM層數短期內或許無法繼續堆高的主要卡點。
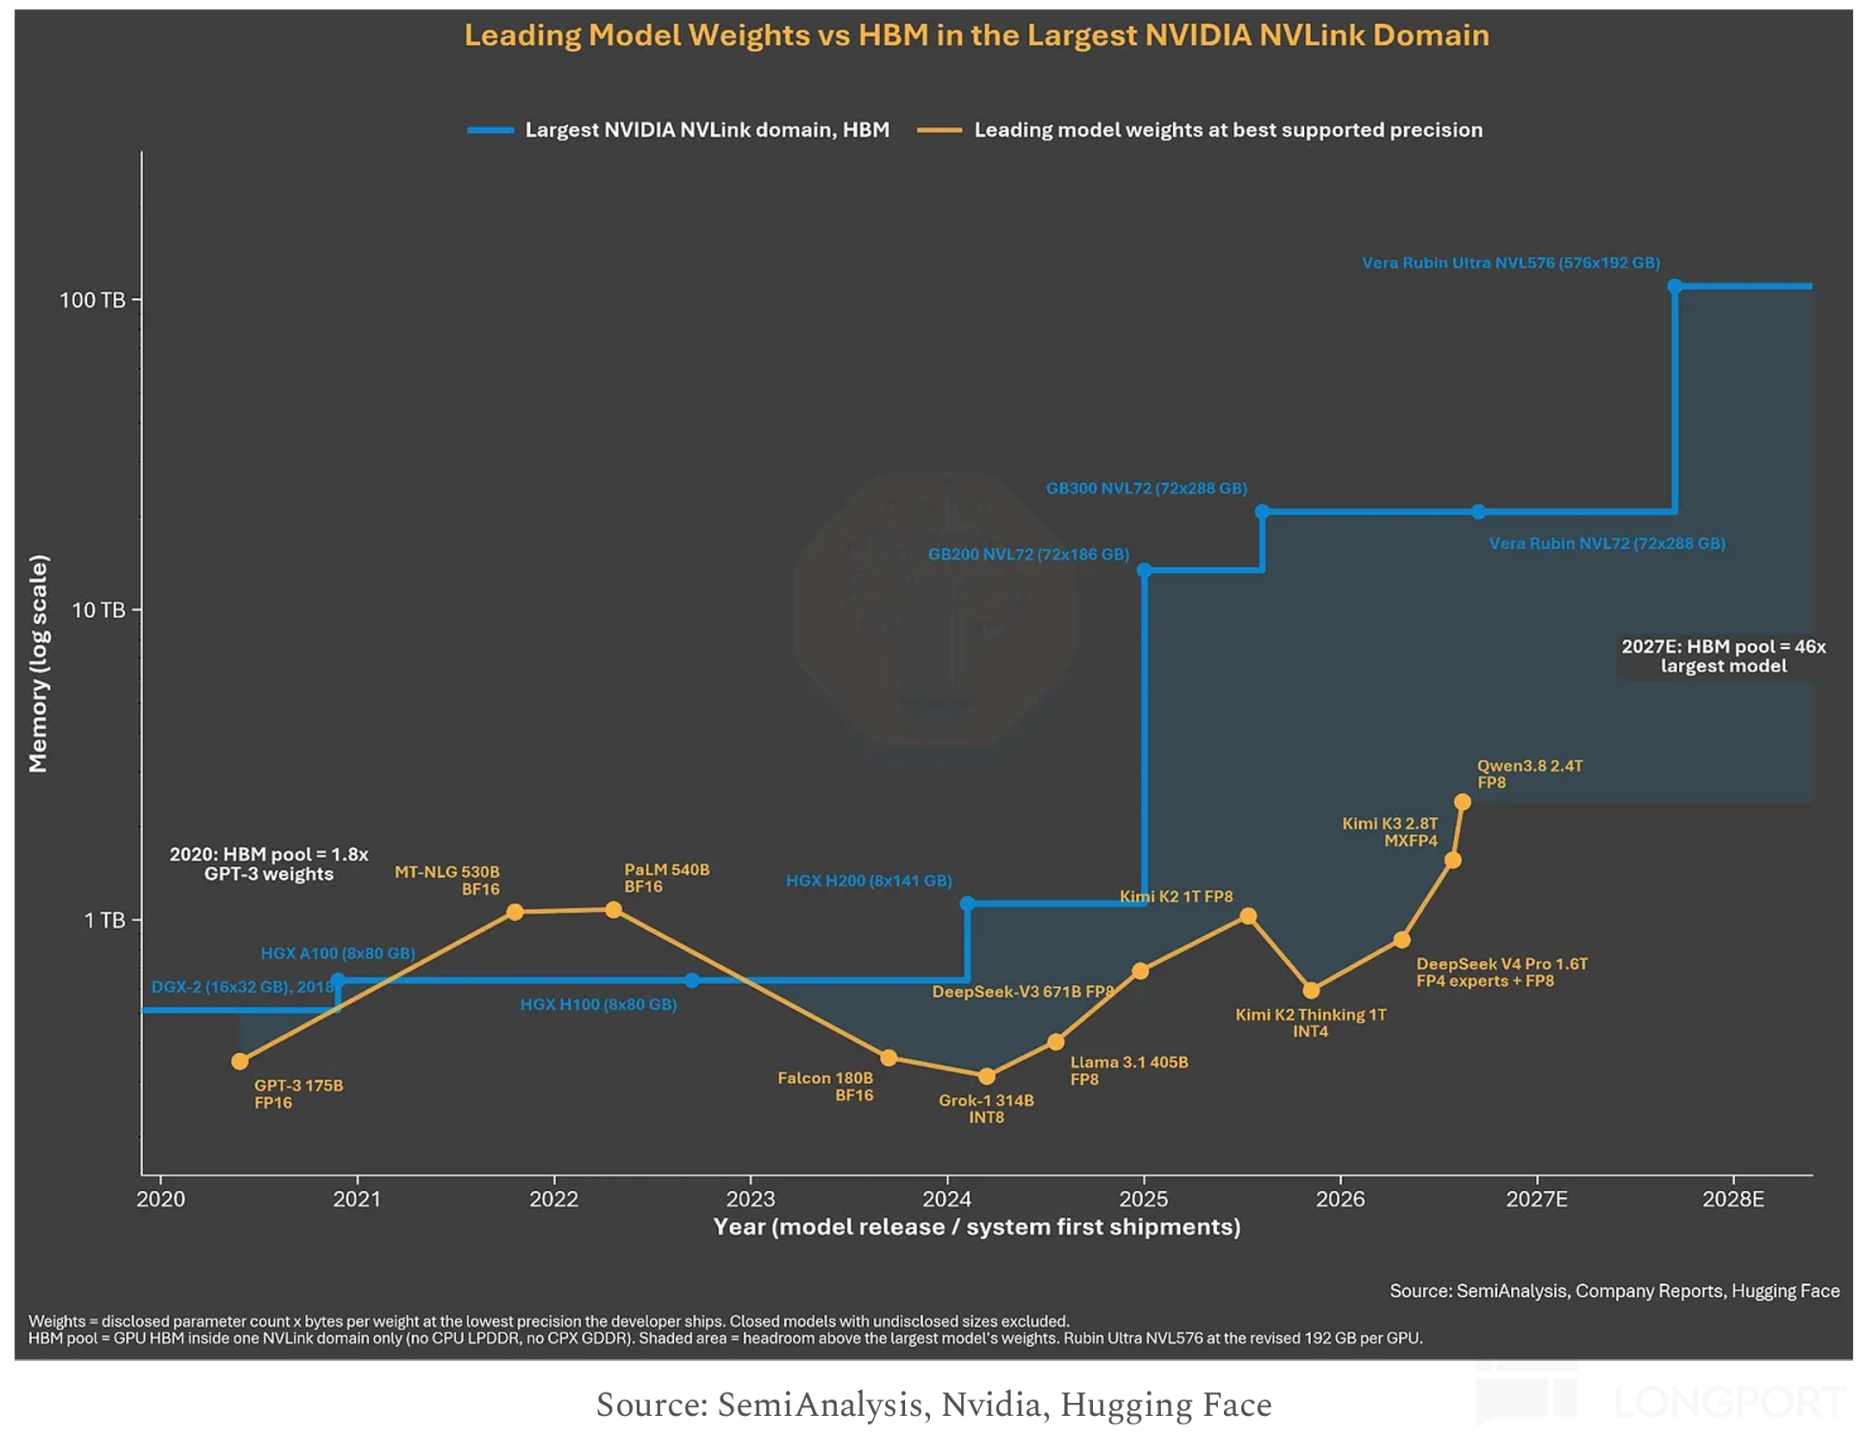
② 互聯規模擴大,系統總容量不降反升:即便單顆GPU的內存變少,Scale-up技術讓單個機櫃內互聯的GPU數量大幅增加,系統總容量反而大增。
如下圖,B300單顆GPU配8顆12層HBM3E、共288GB,一個機櫃最多互聯72顆,總容量約20TB;而Rubin Ultra單顆GPU即便只配8顆8層HBM、共192GB,最多可互聯576顆,系統共享的總容量達110TB。單顆容量少了1/3,系統總容量卻是前者的5倍上下。
可見,降層數本質上也是在產能有限的情況下,壓降工藝難度和成本,以數量取勝。它有合理性,但也帶來兩個新問題:
① 瓶頸轉向Base Die和共同封裝產能:用更多顆低層數HBM,省下了DRAM晶圓,卻要消耗共同封裝產能。關鍵從內存廠自身的擴產速度,變成了能從台積電(以及三星、Intel)鎖定多少產能。
② 拉高對互聯的要求:堆疊層數由高降低低,更大佔地面積要求更多共封產能,節省的產量轉化為DRAM產品,但市場對存儲的需求是不斷增加的。這對內存池化要求自然會拉高。
壓力就傳到了提高內存利用率的連接技術上:
a.超量GPU互聯下的HBM存儲共享:Rubin Ultra就是在降低了HBM層數的情況下,從原本的72個GPU互聯,拉高到櫃內144個、跨櫃576個GPU Scale-up,這樣這個羣組內,每個GPU上配的HBM也在同一地址上互聯,從而實現更大的共享HBM存儲池,用來承載圍繞GPU運算和存模型參數的存儲需求。
b. DRAM內存池化:是用CXL交換芯片做普通DRAM的內存池化,用這種交換芯片把一個個DRAM芯片組成一個大的內存池(類似用NVLINK把多個GPU連在一起),主要用來承載長對話和Agent模式所產生大量上下文數據。
此外,英偉達還通過CMX產品,也做一個NAND池化平台,來承載上下文記憶中使用頻率不如DRAM的那部分。
二、封裝與帶寬,另兩個關鍵要素
從層數之爭可以看到兩個關鍵變量:① 帶寬能否繼續顯著提升,只有帶寬跟得上,堆高層數才有價值;② 共同封裝和Base Die產能是否充足,只有產能跟得上,降層數、多顆數的路才走得通。這就引出本部分的討論:封裝與帶寬。
2.1、CoWoS封裝
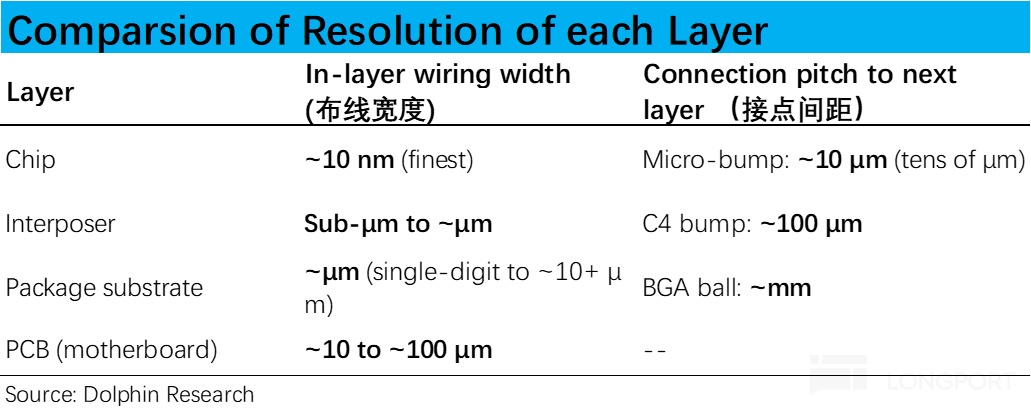
上篇已提到,HBM的高帶寬離不開與XPU共同封裝在硅中介層上。這一環節目前主要依賴台積電的CoWoS工藝(Chip-on-Wafer-on-Substrate),該技術顧名思義分為三層:最頂層的芯片(Chip),中層的中介層(Wafer),和最底層的基板(Substrate)。
其主要作用類似一個沙漏,把納米級精度的芯片線路逐層放大,最終接到毫米級精度的主板上。(下圖可見,芯片和中介層間由微凸點連接,中介層和基板之間是C4凸點,基板和PCB板之間是BGA焊球,每層連接精度逐步變低)
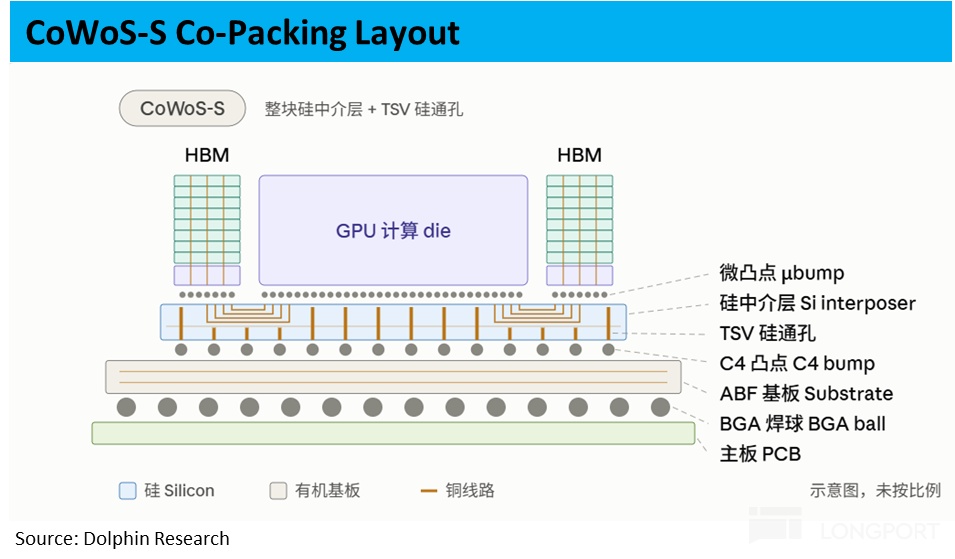
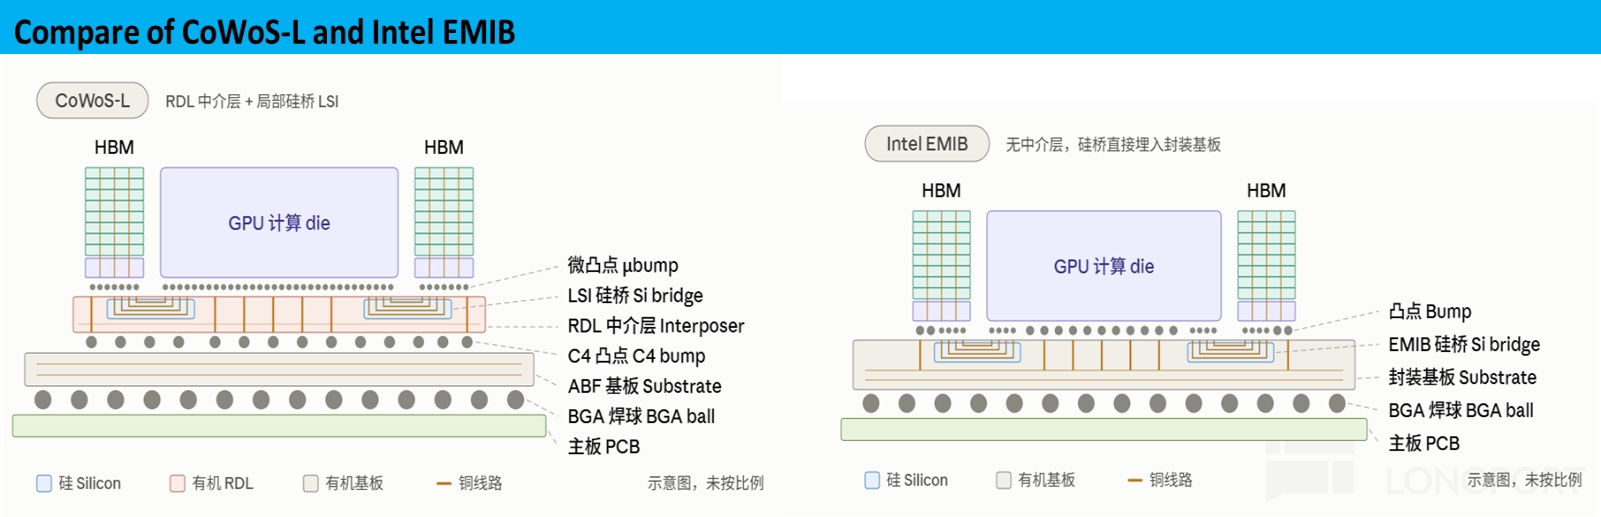
CoWoS有S、R、L三個變種,差別在中介層:S(Silicon)是整塊硅中介層;R(RDL)用類似PCB的銅線加絕緣層複合結構;L(LSI,局部硅互聯)則是兩者的結合。
① CoWoS-S的問題除了貴,更在於面積受限:硅中介層全部用硅基裸芯,光刻單次曝光的最大面積約858mm²,更大就要多次拼接,拼得越多良率越低,目前最大隻能做到單次曝光面積的約3.3倍。
② CoWoS-R即中介層的材質由硅片換為RDL,後者製作方式和PCB類似,由銅、絕緣層、塑封等堆疊而成。無需半導體工藝製造,因而成本更低、面積可以更大,但支持的線路精度也低,不適用於HBM場景,就不過多討論。
③ CoWoS-L則以RDL為主體,只在HBM與XPU連接處等需要高精度的位置嵌入小塊硅橋。依靠該技術,單片中介層的面積已能做到單次曝光的5.5倍,英偉達從B200系列起就已採用。
④ Intel和三星等公司也都有類似的共同封裝工藝,其中Intel的EMIB工藝更加簡單,去掉了中介層只有基板層。對需要高精度連接的部分,直接在基板內嵌入硅片層。不過目前EMIB技術基本僅用於Intel內部產品,外部客户如TPU和Trainium芯片,據報道仍在接觸並測試該技術。
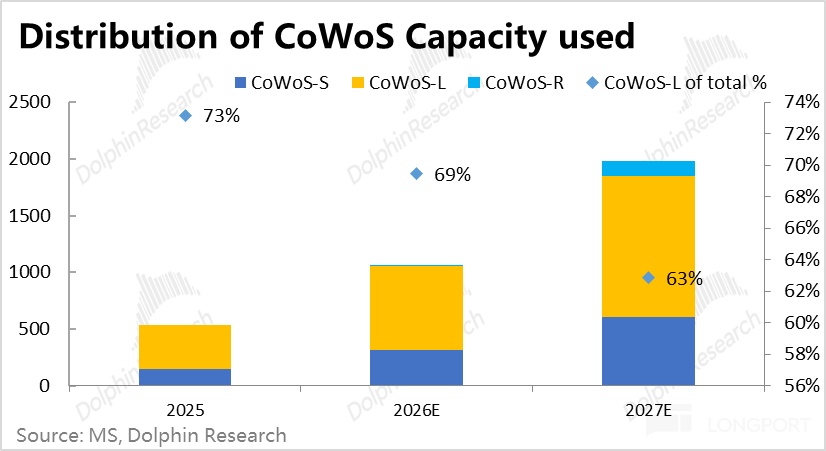
⑤ 從投行們統計預測的CoWoS產能數據,我們能看到:CoWoS-L確實已是主流方案,使用佔比在60%以上。且相比DRAM晶圓的產能直到27年才會有一定釋放(增長15%~20%),CoWoS的產能增長確實更快,27年就相比26年翻倍。
因此,選擇用更多數量的低堆疊層數的HBM,而非數量更少但層數更高的HBM,從產能角度有其合理性。
⑥ 小結來看,CoWoS-L和EMIB工藝,都幫助降低封裝的成本,並增加了芯片的最大封裝面積,讓單顆GPU芯片內能裝配更多數量的內存,也是前文提到的GPU內封裝多排內存的技術前提。
2.2、位寬和速率無法兼得?帶寬還能如何提升?
單個內存的帶寬 = 位寬(並行的道路條數) × 速率(每條路上數據跑的速度)。一顆GPU的整體內存帶寬 = 單個內存帶寬 × 內存個數。靠增加內存個數來提升系統總帶寬很簡單直白,最大的限制就是XPU四周有沒有足夠的空間安裝更多數量的HBM。因此我們把重點縮窄到如何提升單個內存的帶寬上。
而單個內存帶寬的高低,取決於內部帶寬和外部帶寬兩個部分。內部帶寬,是數據經內存塊(Bank)匯總到其所在的內存層(Layer),再經TSV把整個堆棧(Stack)的信息匯總到基底層(Base Die),這一串流程的速度;外部帶寬則是指Base Die把數據經中介層送到XPU的速度。
因此,內存帶寬想要提升,需內部和外部共同提速。
這裏直接給個結論,目前瓶頸和難度更多在外部帶寬,難點更多在基底層和中介層的設計和製造。內部傳輸,畢竟傳輸的距離更短,且可以靠加密TSV通路的數量來提升。技術可行且實現路徑比較清晰。
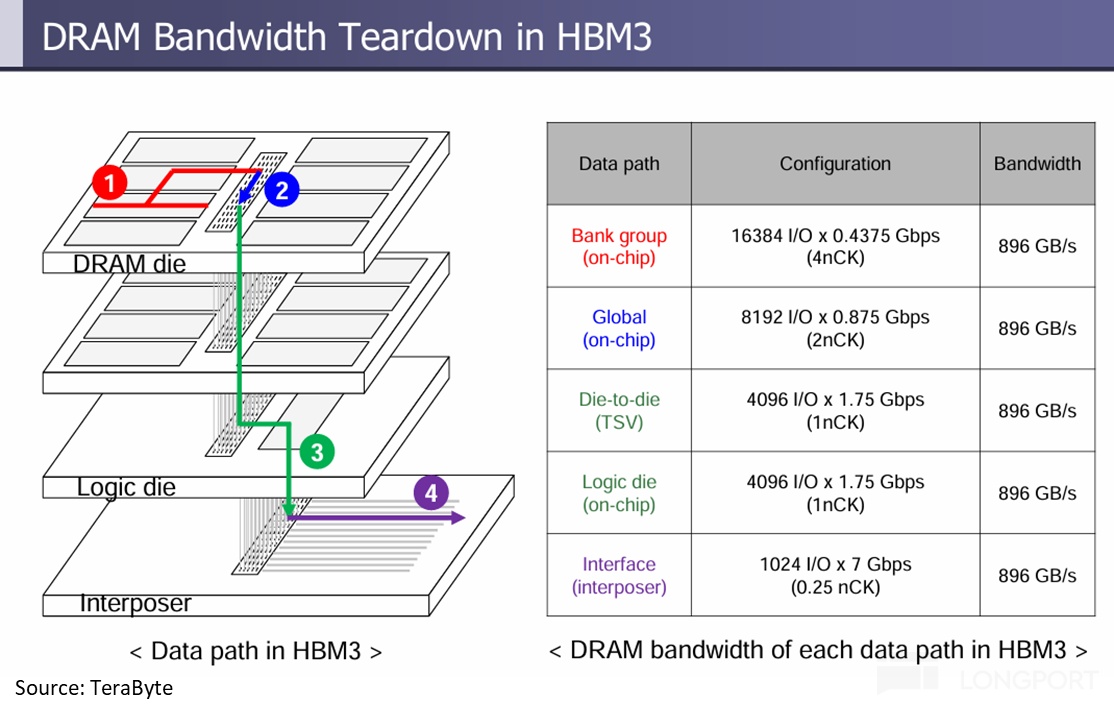
這裏再給一個結論,位寬和速率看似是攜手幫助提升帶寬的“合作伙伴”,但實際兩者更像是相互制約、相互競爭資源的“對手”。
從歷代HBM看:HBM1到HBM3E,位寬一直是1024位,帶寬提升幾乎全靠速率(增長了8~10倍),但速率的提升也在放緩,從每代翻倍降到每代提升1/4~1/2;而到了位寬翻倍的HBM4,一開始標準速率是原地踏步都為8TB/s,後續才有所提升,可見兩者不易同時提升。
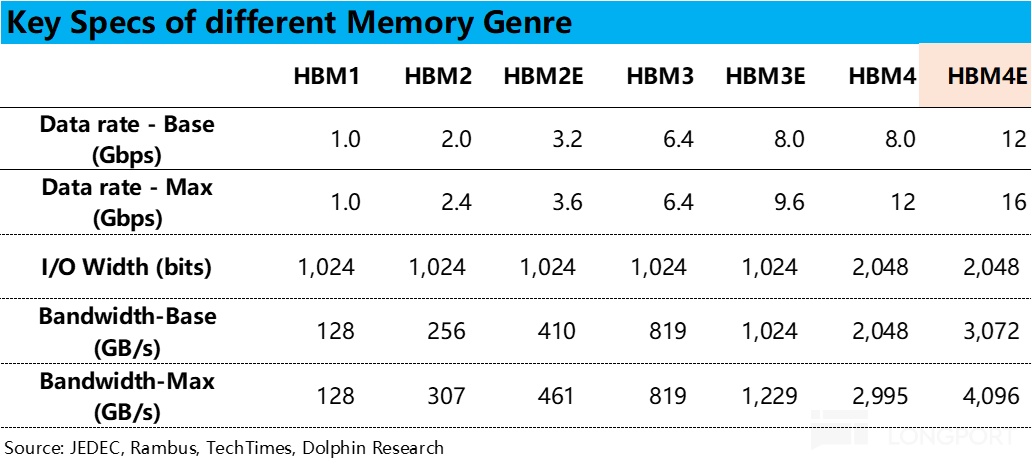
那麼制約位寬、速率提升各自的決定因素有哪些?為何位寬和速率是相互競爭關係?後續帶寬還能不能繼續大幅提升?這裏涉及較多晦澀的術語,海豚君會嘗試以更通俗易懂的類比方式來解釋。
① 位寬比較容易理解,即內存和XPU間的通訊線路數量,其決定公式大致是:位寬 = 線路佔用的總面積 / (線寬+線間距)。因此要提高位寬,要麼需要線路的寬度和間距更窄(對應更高精度的刻蝕工藝);要麼就需要在中介層上有更多的面積用於刻蝕通訊線路,同時HBM Base Die和XPU內的PHY面積也需要增大。
② 速率是指單條線路每秒能傳多少比特數據,好比水管裏的水流速度:源頭水壓越大、水管越短越粗,水流越快。
對應到芯片,一是類似於水龍頭的Base Die ,需要以更高的頻率和電壓來發送信號,功耗和散熱壓力隨之上升。這也是Base Die要交給台積電等以先進工藝代工的原因之一;
二是線路要短、要粗,線與線之間還要留足間距以防串擾。矛盾就在這裏:位寬要求線細、排密,速率要求線粗、間距大,兩者在同一塊有限的面積裏互相爭搶。
③ 因此,要繼續顯著提升帶寬,大致有三條路:一是改進Base Die的設計和工藝,讓信號發得更快、更準;二是改進中介層,如加強線路屏蔽、增加布線層數;三是縮短線路,位寬和速率在線寬上衝突,在線長上卻不衝突,例如未來把HBM直接疊在XPU上方或下方的3D封裝。
三、做強單顆,還是以量取勝?抉擇在哪?
以上分別討論了提升容量和帶寬的路徑:提升容量的路多且方向各異,本質都是在成本、容量、帶寬三者間取捨;提升帶寬則殊途同歸,需要在Base Die、中介層和封裝上死磕。
接下來的問題是:行業會優先解決容量還是帶寬?這又會如何影響內存廠的地位?我們先從最直接的成本入手。
3.1、HBM比其他內存貴多少?
雖然HBF尚未正式量產,無從得知其最終的實際成本。但由於HBF的結構和製作方法和HBM基本無異,區別僅在前者用NAND顆粒而後者用DRAM顆粒。那麼從兩種顆粒間的定價差異能窺得一二。
那麼根據TrendForce統計的最新合約價格可見,DRAM和NAND相同容量的售價差超8x,DRAM(DDR5規格)的單GB售價約為$16,而NAND(MLC規格)的單GB售價僅$1.9。
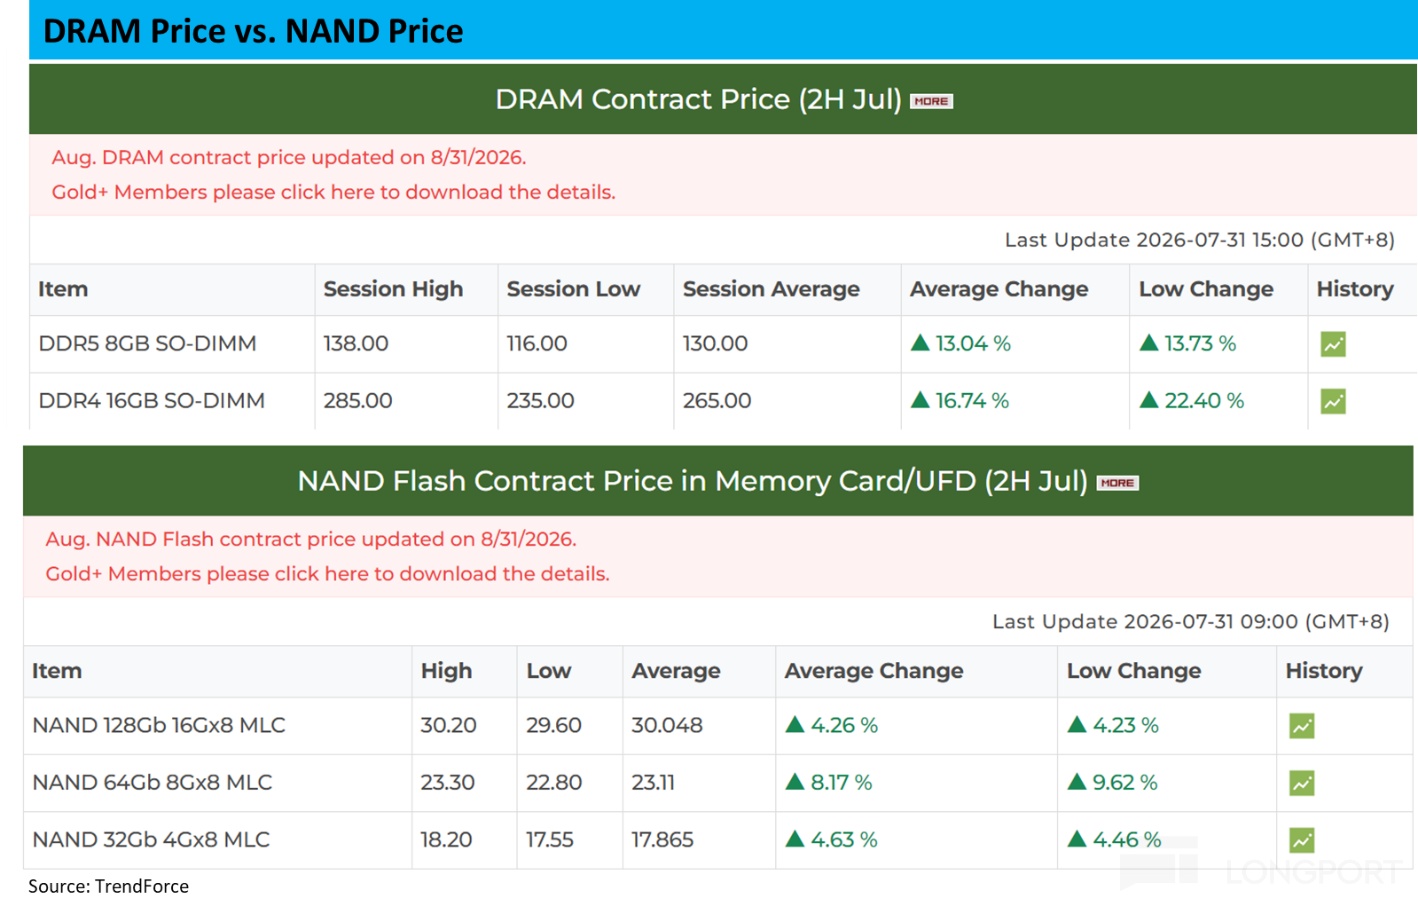
更重要的製造成本上,根據外行測算,HBM的單GB製造成本近期接近$5,且隨着規格提升有進一步走高趨勢。而常規DRAM的單GB成本不到$1.2,且因工藝成熟還在繼續走低。這和HBM的晶圓損耗約是傳統DRAM 3~4x的説法大體一致。
至於HBF,雖NAND顆粒相比DRAM便宜很多,但複雜的堆疊和封裝成本是相近的。根據不同的信息源,有説HBF的成本是HBM的1/8,有説HBF的成本是傳統NAND的10x,則對應HBF每GB成本約$0.5~$1,相當於HBM的1/5~1/10。
也就是説,按容量算HBF相當便宜,對大量存儲無需高頻讀寫的數據很實惠。但也犧牲了帶寬換高容量,
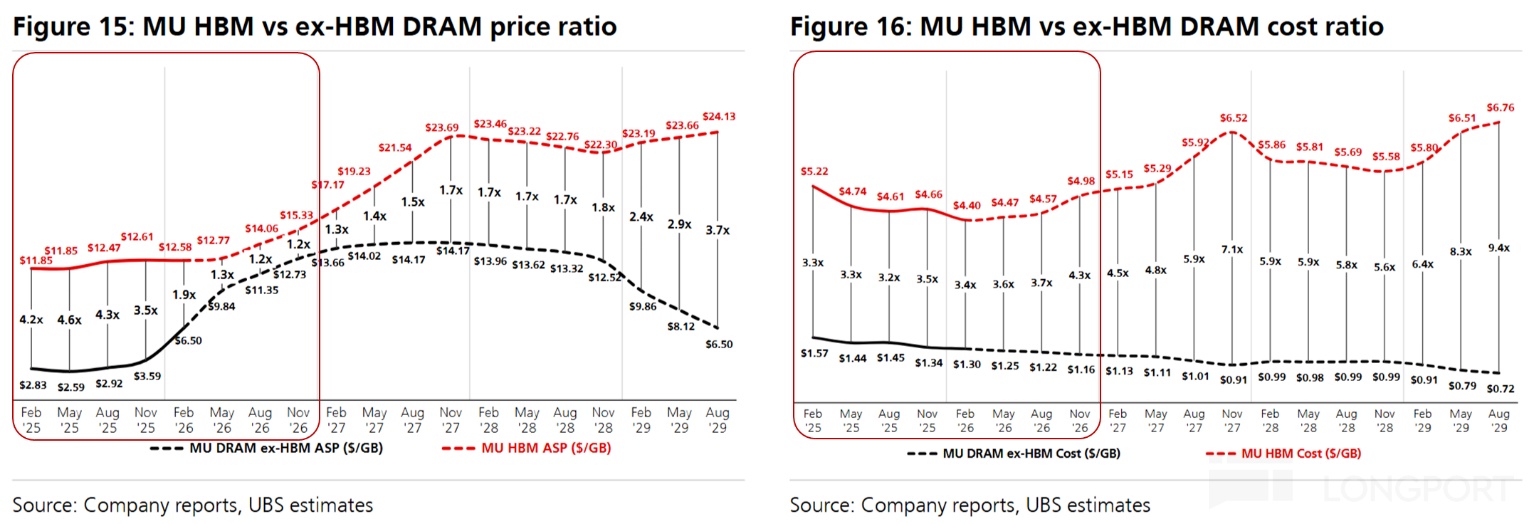
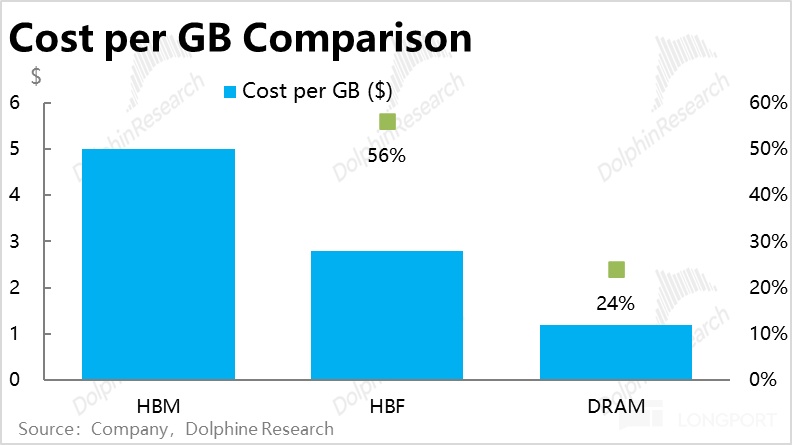
另一個值得關注的現象是:HBM成本約為常規DRAM的4倍,售價差距卻在迅速縮小,近幾個月常規DRAM售價已達HBM的80%以上。海力士管理層年初曾表示,HBM毛利率僅約60%,常規DRAM則可達80%以上,成本低、工藝簡單的常規DRAM反而更賺錢。
原因在於,HBM只供少數大客户、以長約鎖價,無法靈活調整;常規DRAM客户分散,可以隨行就市提價。這也印證了上篇的觀點:HBM工藝雖複雜,但因綁定少數大客户,內存廠的議價權和價值量佔比反而更低。不過據報道,新一輪HBM合約價有望從$15~17/GB上調至$20~30/GB,毛利率劣勢將有所緩解。
3.2、容量和帶寬,哪個更重要?
回到HBF與HBM的對比:若容量更重要,HBF更具性價比;若更看重帶寬,HBM反而便宜一個數量級。這也印證了海豚君的判斷:技術路線的選擇,很大程度上取決於未來的卡點更多在容量還是在帶寬。
卡在容量,後排內存、HBF替代等路徑更可行;卡在帶寬,就只能死磕首排內存的性能,或靠互聯增加系統內的GPU和內存數量,代價也更高。
那麼,哪些情形會讓卡點更多落在容量或帶寬上?
① 容量需求增長更快的情形:模型參數不再大跨步提升(如從10T量級邁向100T量級),增長主要來自用户滲透率提升、上下文變長,或更多無需推理的執行場景。
② 帶寬要求更高的情形:模型總參數和激活參數繼續大幅提升,推理的思維鏈和上下文更長,用户對Token生成速度的要求也更高。
3.3、三種情形:誰是卡點,誰贏得更多
我們分情境假設來看:
① 情境一,模型參數平穩,增長主要來自用户數、上下文長度和Agent執行場景的擴張,對應前文"容量需求增長更快"的情形。
技術上,單顆HBM的層數和帶寬都無需大幅提升,新增容量更多由後排內存、常規DDR和HBF來承接,分層混合的存儲架構會更快落地。
此時工藝難度不再是主要矛盾,問題變成純粹的供需匹配。存儲更像回到傳統的大宗商品邏輯:價格主要由供需決定,隨着27年後新增產能釋放和工藝成熟,單位成本和價格會逐步下行。
受益更多的是產能規模大、成本控制好的廠商,以及承接新增容量需求的NAND產業鏈(HBF、企業級SSD)。但這也是三種情境中最"週期"的一種:一旦各家(包括長鑫等新進入者)產能集中釋放,價格下行壓力最大,內存廠的超額利潤也最難維持。
② 情境二:帶寬成為主要瓶頸——價值向封裝和代工外溢
這對應"帶寬要求更高"的情形:模型總參數和激活參數繼續大跨步提升,推理的思維鏈更長,用户對生成速度的要求也更高。
技術上,層數未必繼續走高,甚至可能像SemiAnalysis所説的"降層多顆"。競爭焦點從堆疊轉向Base Die的信號速率、中介層佈線和3D封裝,卡點因此落在台積電的CoWoS和先進製程Base Die產能上。
存儲系統的總成本和稀缺性大概率繼續走高,但稀缺溢價更多被封裝和代工環節拿走。Base Die越來越多由客户主導設計、交由台積電製造,HBM進一步定製化,內存廠的角色更接近"顆粒供應商",對少數大客户的依賴也更深。
受益最多的是台積電。內存廠之間,能自行提供Base Die和封裝"一條龍"方案的主要是三星。
③ 情境三:容量和帶寬雙雙告急——內存的"超級週期"
即參數規模再上台階(如從10T量級邁向100T量級),同時用户和上下文也在持續擴張。
技術上,所有路徑都要同時推進:單顆層數大概率要繼續堆高,同時帶寬也要提升,這時內存的稀缺性和價格大概率會有最大的提升。DRAM晶圓和封裝產能雙雙告急。其中DRAM晶圓擴產更慢,可能成為最硬的卡點。
這時內存廠和封裝廠的價值都會提升,且相比情境二,內存廠的議價權相對更高。因為高層數堆疊的良率和鍵合工藝等是由內存廠把控的。
需要注意,三種情境並非互斥。訓練和前沿推理更吃帶寬,大規模Agent推理更吃容量;英偉達、AMD和各家ASIC也可能選擇不同的HBM配置。現實更可能是幾種情境並存,對應前文的分層混合架構,區別只在於哪一種佔主導。
3.4、尾聲
回顧全篇,容量上,往高處堆(更多層、更薄的顆粒、更先進的鍵合),能讓新增的每一GB都掛在首排HBM的全速通道上,代價是工藝難度、良率和DRAM晶圓消耗的全面走高。用更多佔地面積往多處擺(多排內存、HBF、少層多顆),雖然工藝要求和單位成本更低,但要麼犧牲帶寬,要麼把壓力轉嫁給Base Die和CoWoS產能。
帶寬上則幾乎沒有捷徑。位寬和速率相互掣肘,要繼續大幅提速,只能在Base Die、中介層和3D封裝幾個方向上死磕,而這些環節恰恰大多不在內存廠自己手裏。
至於最終走哪條路,在於AI接下來的需求更多卡在容量還是卡在帶寬。卡在容量,存儲迴歸走量邏輯,產能和成本是勝負手;卡在帶寬,封裝和代工環節的話語權上升,內存廠的議價權反而可能被稀釋。
而若兩者同時告急,內存自身的工藝和產能會成為最硬的卡點,內存廠在產業鏈中的分量也最重。
目前海豚君認為,容量需求提升是最高確定性,用户、用量和Agent場景滲透率大概率是持續走高的。後續的關鍵就是看大模型參數規模提升斜率,來確認帶寬的提升速度要求。
後續判斷落在哪種情境,可以重點跟蹤幾個信號:
① 英偉達、AMD及各家ASIC新品最終採用的HBM層數和顆數;
② HBM4E的實際運行速率,以及HBM5位寬翻倍的落地節奏;
③ CoWoS與DRAM晶圓產能的相對擴張速度;
④ HBF在27年前後的首批導入情況等等。
至此,海豚君已完成了對存儲技術的梳理,且技術路線的分歧,最終都會落到每一家廠商身上。
在下一篇中,海豚君將把視角從行業拉回公司,從技術拉回到供需匹配,各廠商與核心客户綁定的深淺,以及後續廠商們具體的業績走勢,看看誰更可能勝出。敬請期待!
<全文結束>
$SK海力士(SKHY.US) $美光科技(MU.US) $閃迪(SNDK.US)
相關文章:
本文的風險披露與聲明:海豚研究免責聲明及一般披露
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。